

 16
 分享
引言Introduction
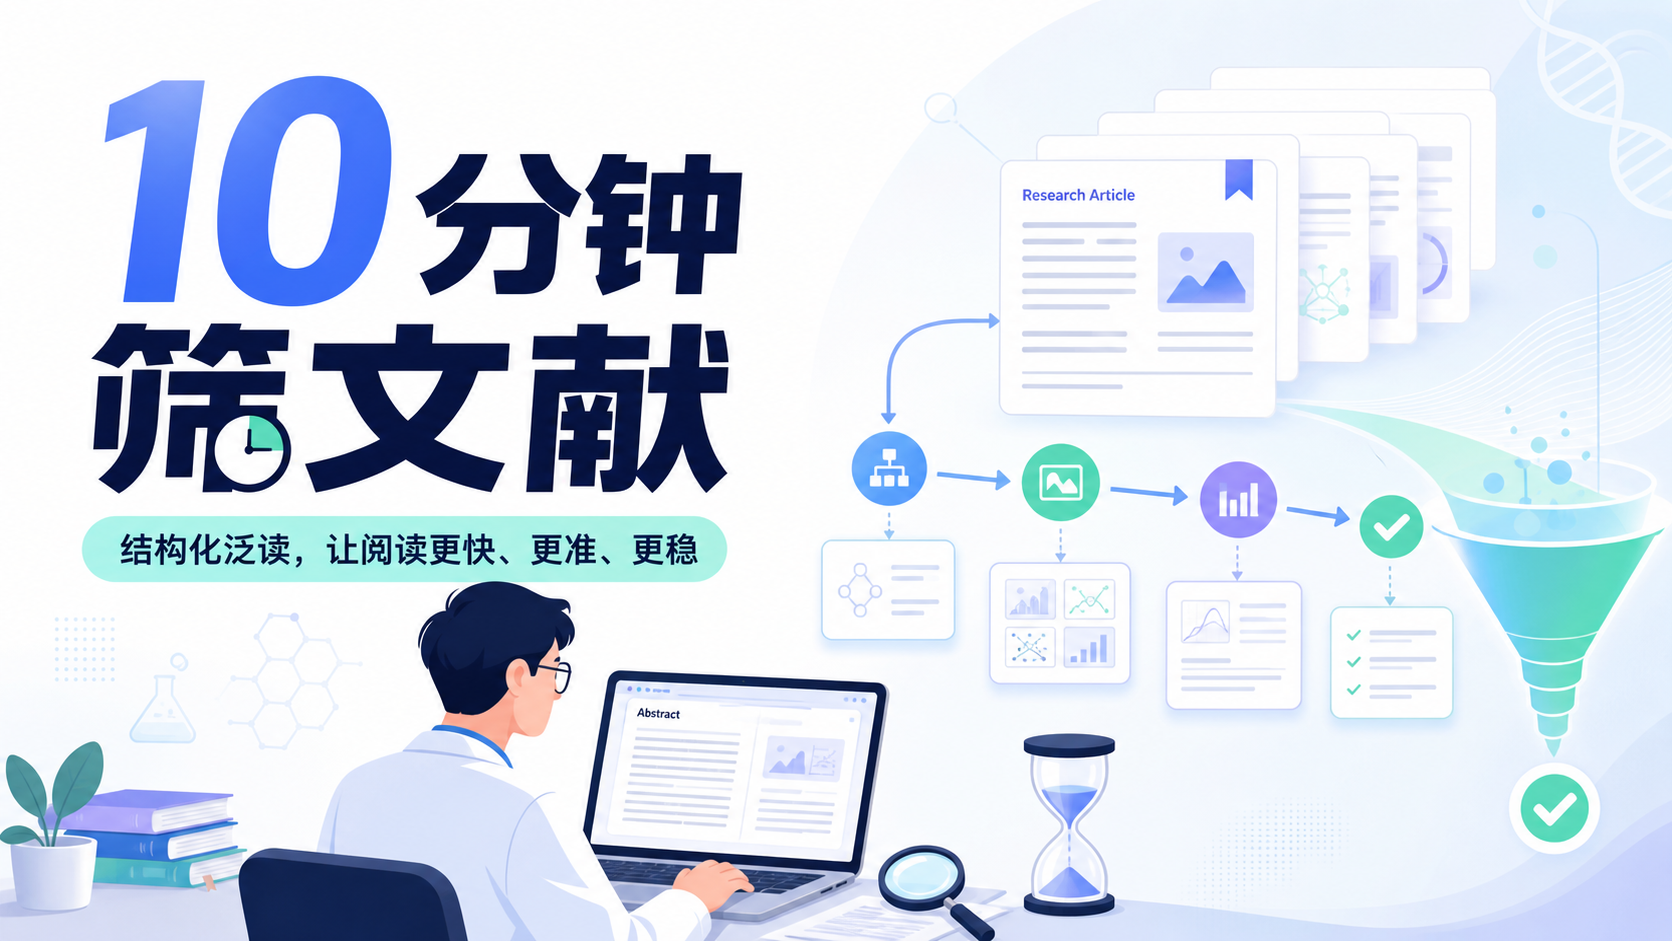
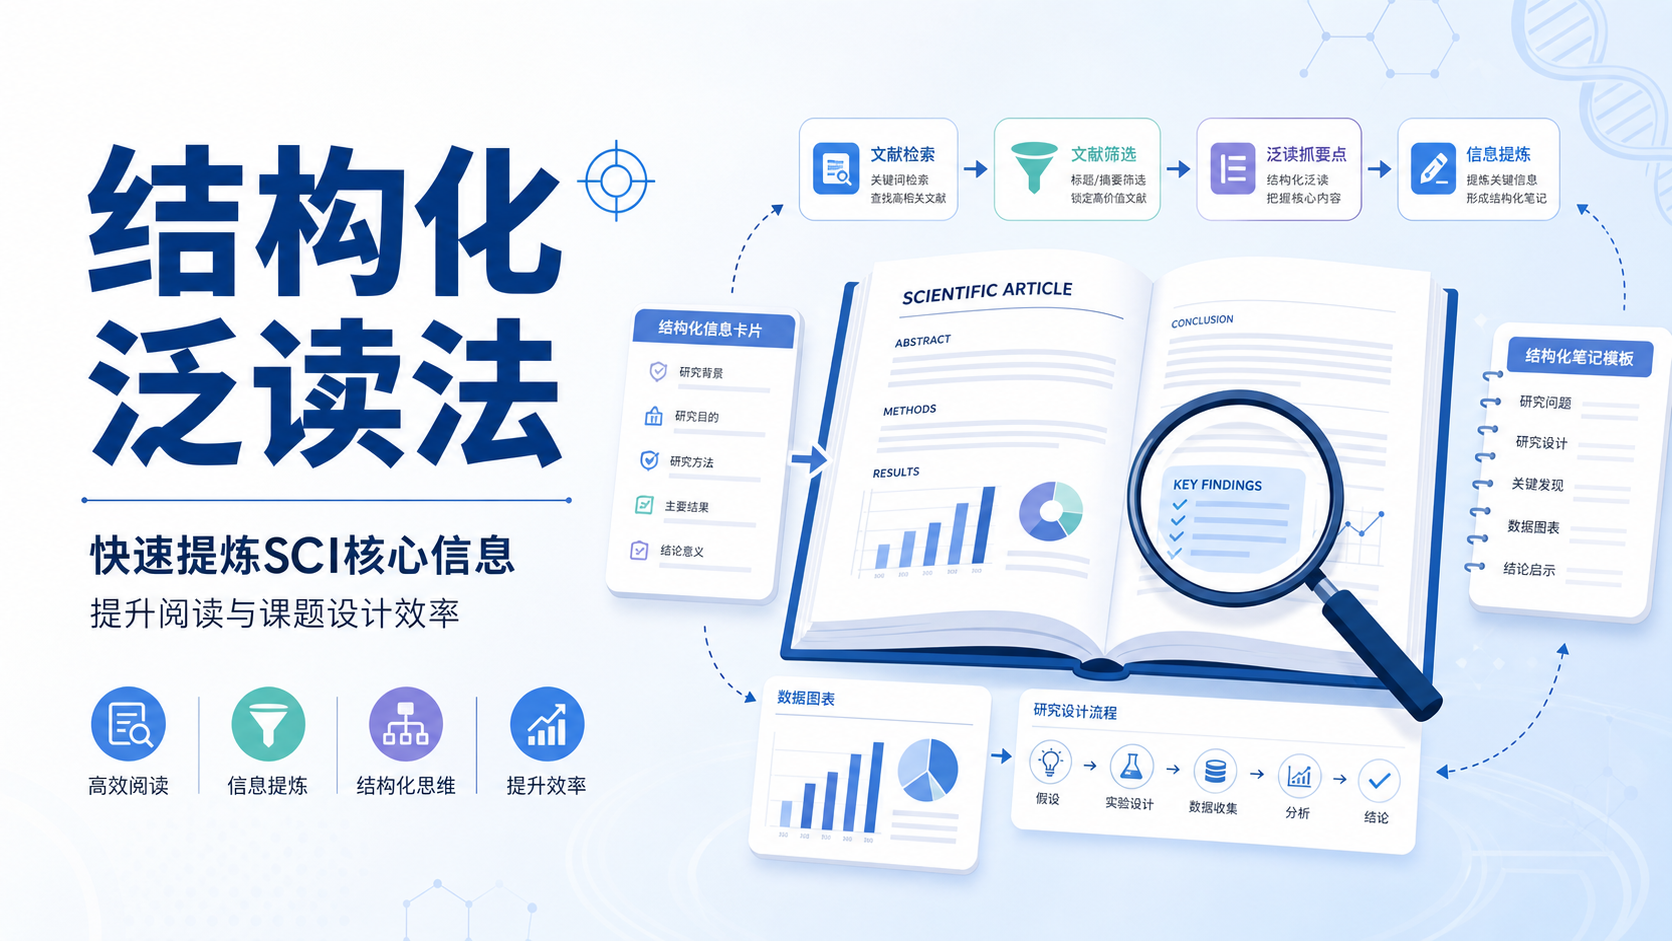
SCI论文越读越多,却总抓不住重点,是很多医生和硕博生的共同痛点。真正高效的办法,不是逐字精读,而是先用固定框架快速提炼研究问题、设计、结果和局限,再决定是否深读。结构化泛读法的价值,在于用更少时间,换取更高的信息密度。
1. 什么是结构化泛读法
1.1 从“读全文”转向“抓骨架”
结构化泛读法,不是跳过论文,而是先抓论文骨架。也就是先看这篇文章回答了什么问题,用了什么设计,得到了什么结论,是否值得继续深读。对临床医生和科研人员来说,这一步决定了阅读效率。
传统精读适合少量核心文献,但不适合高频筛选。尤其在课题设计、开题汇报、基金申报、文献综述时,往往需要在短时间内判断几十篇论文的价值。此时,如果仍按逐字阅读推进,效率会非常低。
1.2 结构化泛读的核心字段
一篇SCI论文,最值得优先提取的信息通常包括:
- 研究问题,作者想解决什么。
- 研究设计,回顾性、前瞻性、随机对照,还是基础实验。
- 样本量,纳入多少例、多少组、是否有验证队列。
- 主要终点,生存、诊断效能、炎症指标、机制链条等。
- 关键结果,是否支持假设,效应量多大。
- 局限性,样本是否偏小,是否单中心,是否缺乏外部验证。
这六项信息,足以支撑大多数第一轮筛文献的决策。
1.3 适合哪些使用场景
结构化泛读法尤其适用于以下场景:
- 课题设计前的文献扫描。
- 临床研究选题和方案比对。
- 硕博阶段的开题、答辩和组会准备。
- SCI写作时的相关研究梳理。
- 综述和Meta分析前的纳入筛选。
如果目标是快速判断“能不能用”,这套方法比从头到尾读全文更高效。先筛,再精读,是科研阅读的基本策略。
2. 结构化泛读法的实操步骤
2.1 第一步,先读标题、摘要和图表
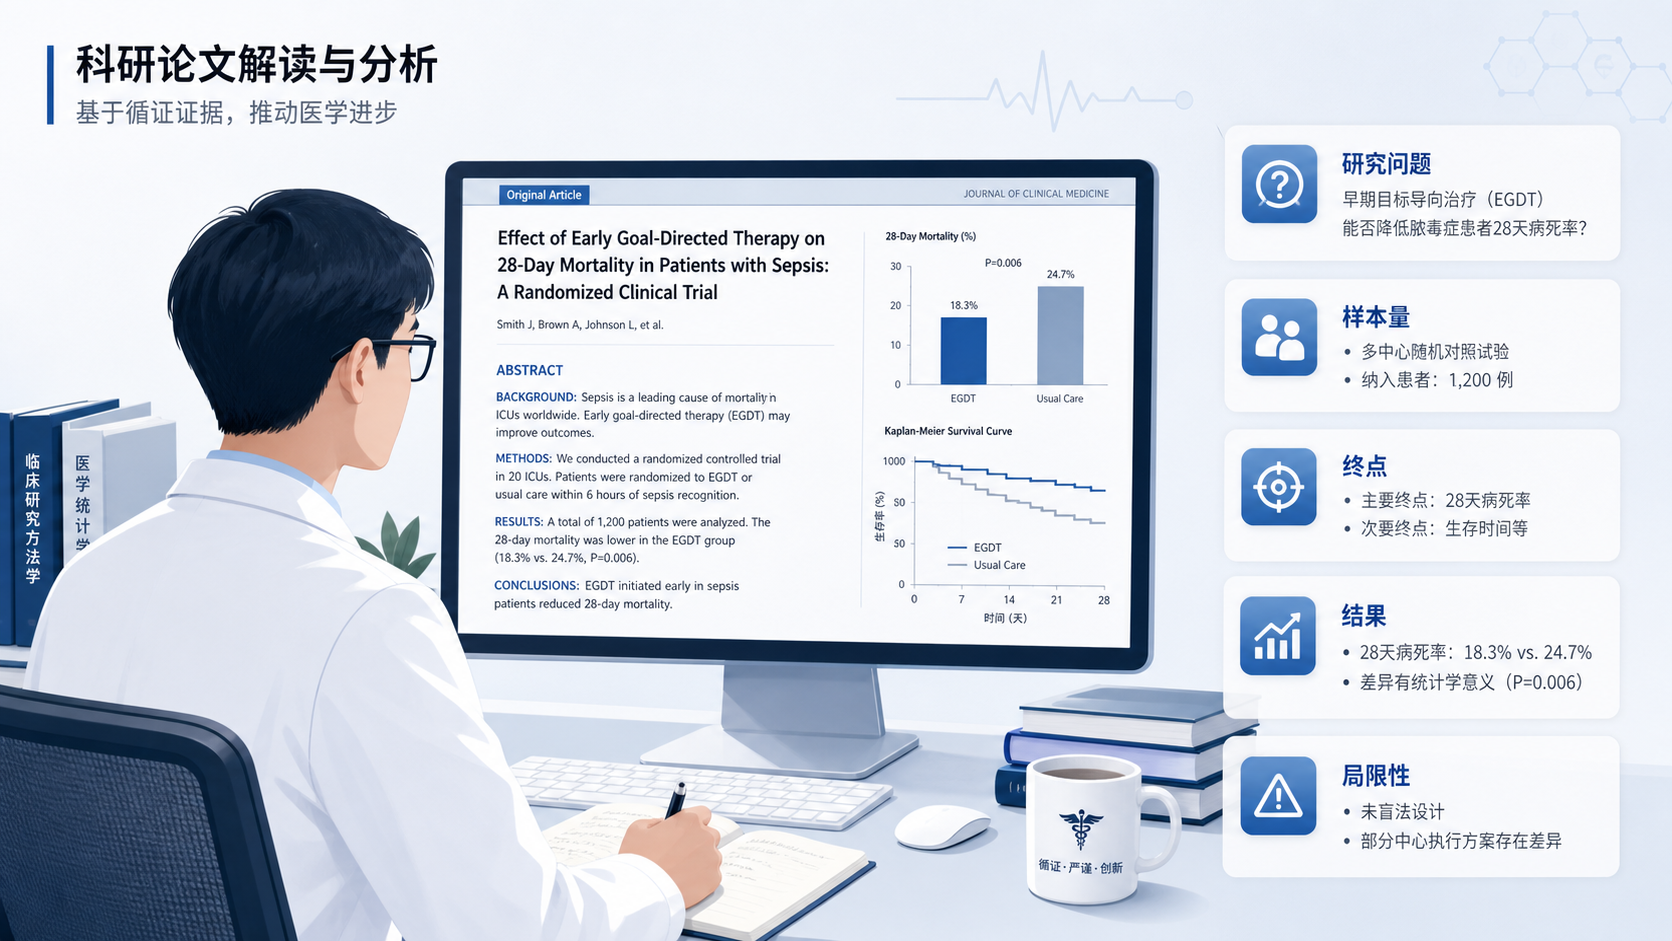
第一轮不建议直接进入正文。先看标题、摘要和图表,通常就能判断80%的研究轮廓。标题决定研究方向,摘要给出研究设计和主要结论,图表则直接展示数据结构。
实操时可以先问自己三个问题:
- 这篇文章研究的是疾病机制,还是临床价值。
- 主要终点是什么,是否与我的问题相关。
- 图表是否支持作者的核心结论。
如果摘要和图表都对不上研究需求,这篇文章大概率不值得继续深读。
2.2 第二步,按固定模板做信息提炼
建议建立统一模板,读完后直接填空。比如:
- 研究对象。
- 分组方式。
- 样本量。
- 终点指标。
- 统计方法。
- 核心结果。
- 研究局限。
这种做法的优势是可比性强。读10篇、20篇之后,你会非常清楚不同文章之间的差异。对于做课题的人来说,这比零散记笔记更有用。统一模板,是结构化泛读法的核心。
2.3 第三步,判断文章属于哪一种证据类型
不同研究问题,对应的证据层级不同。比如:
- 临床回顾性研究,适合探索相关性和预测价值。
- 前瞻性队列研究,更适合验证趋势和风险。
- 随机对照试验,更适合判断干预效果。
- 机制研究,更适合解释生物学路径。
- 生信分析,更适合筛选候选分子和构建模型。
如果不先判断证据类型,很容易把一篇“相关性文章”误当成“因果证据”。这是很多初学者在文献解读中最常见的误区。
3. 如何快速提炼SCI核心信息
3.1 研究问题要提炼成一句话
读文献时,先把研究问题压缩成一句话。比如,作者是在回答“某指标能否预测预后”,还是“某分子是否参与某通路”。一句话提炼越清楚,后续比较就越容易。
很多论文标题写得很长,但本质问题很简单。你要做的是把复杂表达还原为简单命题。研究问题越清楚,越容易判断文章价值。
3.2 样本量和设计决定可信度
样本量不是越大越好,但过小一定要警惕。尤其是单中心、小样本、无外部验证的研究,结论通常只能作为探索性证据。若文章声称有较强临床推广价值,却样本量有限,就需要谨慎解读。
在临床研究中,还要重点看:
- 是否有训练集和验证集。
- 是否做了多变量分析。
- 是否控制混杂因素。
- 是否有外部队列验证。
设计是否严谨,往往比结论是否“漂亮”更重要。
3.3 结果要看效应量,而不只是P值
很多读者只看P值,但这远远不够。更重要的是效应量、置信区间和模型稳定性。比如同样是P<0.05,一个AUC 0.62和一个AUC 0.88,临床意义完全不同。
科研阅读中要养成这个习惯:
- 看趋势,而不只看显著性。
- 看是否稳定,而不只看单次结果。
- 看是否可重复,而不只看图形漂亮。
真正有价值的结果,通常是“统计显著”与“临床有意义”同时成立。
4. 用结构化泛读法提升课题设计能力
4.1 从文献中识别可复制的研究框架
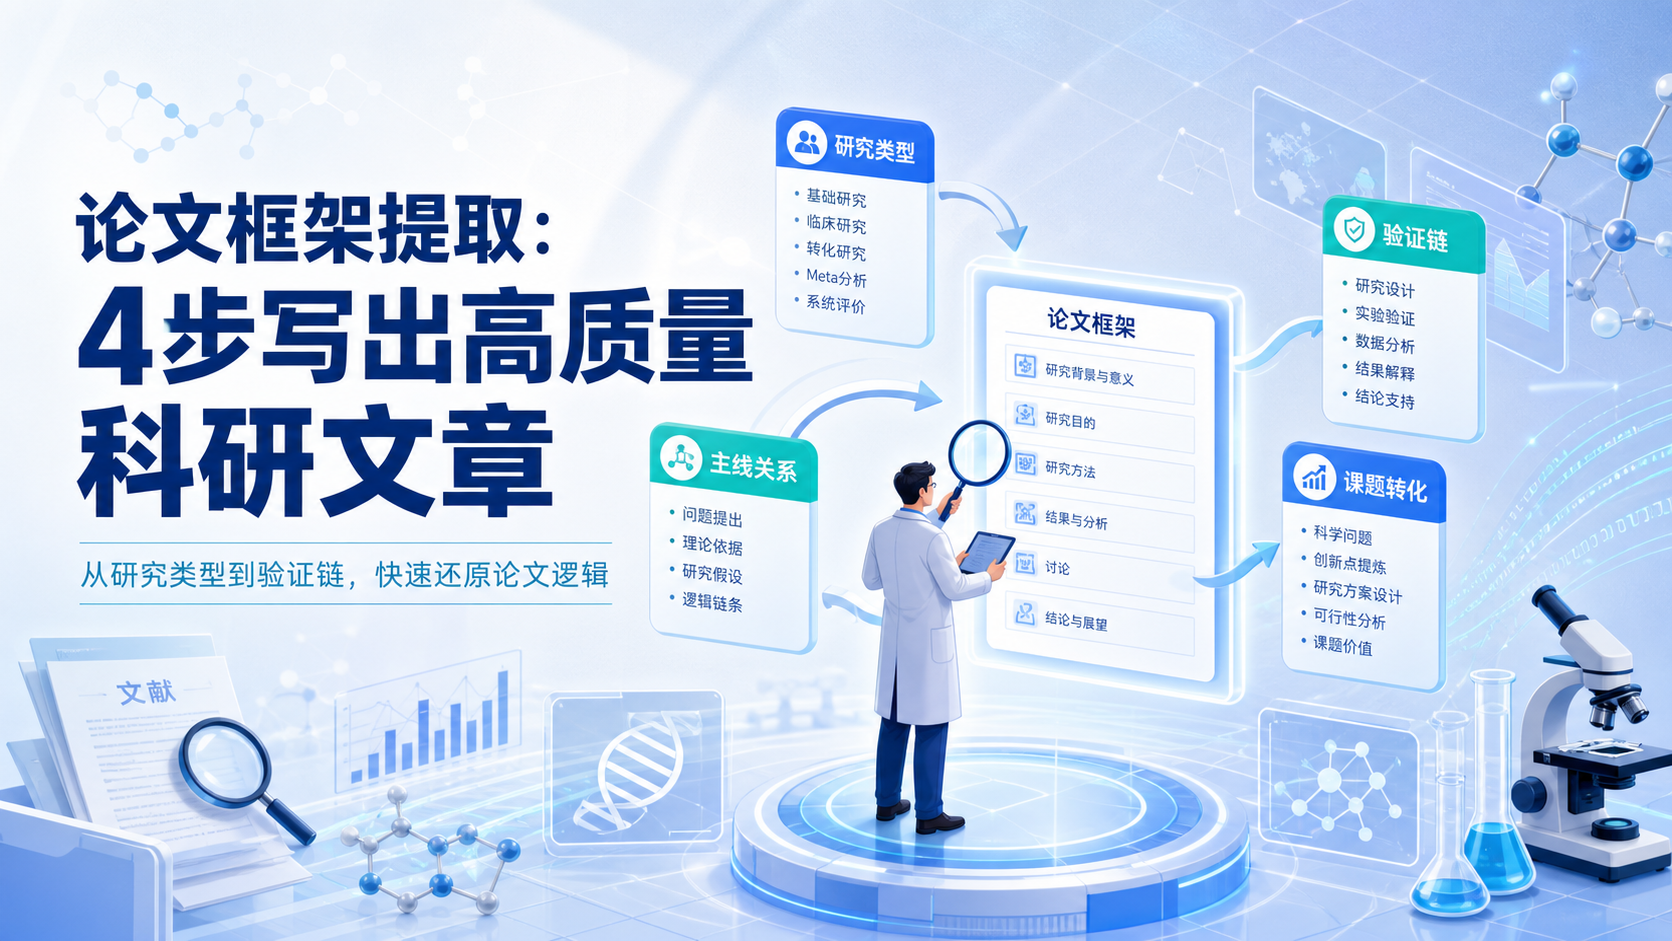
大量SCI论文其实共享相似框架。比如“问题提出,数据获取,分组比较,机制验证,结论延伸”这个链条,在基础和临床研究里都很常见。结构化泛读法的作用,就是快速识别这些套路。
当你读到一篇文章时,要问自己:
- 它的主变量是什么。
- 它的表型是什么。
- 它的机制变量是什么。
- 哪一部分可以替换,形成新课题。
这一步,是从“读懂文章”走向“拆解文章”的关键。
4.2 为课题拆分提供依据
一个项目从构思到发表,通常可拆成四部分:
- 构思设计。
- 实验操作。
- 数据分析。
- 文章写作。
结构化泛读法最直接的价值,就是帮助你在构思阶段少走弯路。你可以快速判断:
- 哪些变量已经被研究过。
- 哪些机制还有空白。
- 哪些终点更容易形成文章。
- 哪些设计适合现有资源。
对于临床医生和硕博生来说,时间和资源都有限。能提前筛掉无效方向,就是最大的节省。
4.3 让泛读结果反哺写作
读完文献后,不只是做笔记,还要沉淀为可复用素材。比如建立表格库,记录不同研究的设计、样本量、终点和局限。这样在写引言、讨论和方法时,就能快速调用。
如果没有结构化整理,文献一多就会变成“看过但找不到”。而规范化的记录,能让你在答辩、投稿和基金写作时快速回溯证据链。这也是SCI论文速读方法真正拉开差距的地方。
5. 结构化泛读法的常见误区
5.1 误区一,只看结论不看方法
结论往往最吸引人,但方法决定结论是否可靠。尤其是回顾性研究、数据库分析和机制文章,如果方法存在偏倚,结果就可能被高估。
5.2 误区二,忽视局限性
局限性不是附录,而是判断文章适用范围的重要依据。常见局限包括:
- 单中心。
- 小样本。
- 缺乏外部验证。
- 统计调整不足。
- 机制链条不完整。
读懂局限性,才能知道这篇文章能不能用,能用到什么程度。
5.3 误区三,笔记散乱,无法复用
很多人读了很多,却很难用于课题和写作,问题就出在记录方式不统一。建议所有文献都按同一模板整理。这样后期做综述、开题、组会和投稿时,才能直接调用。
如果你希望把这种方法更快落地,可以借助解螺旋提供的科研阅读与课题梳理支持,把文献筛选、结构提炼和课题拆解做成标准流程,减少无效阅读,把时间真正用在能产出结果的地方。
总结Conclusion
结构化泛读法的本质,是用统一框架快速提炼SCI论文的核心信息。它适合医生、医学生和科研人员在有限时间内完成高效筛文献、选课题、做汇报和写文章。先抓研究问题、设计、样本量、主要终点、关键结果和局限性,再决定是否深读,是最稳妥的科研阅读路径。
如果你正在提升SCI论文速读方法,建议从今天开始建立自己的结构化模板。先读摘要和图表,再做字段提炼,最后沉淀成可复用数据库。若你希望进一步提高文献筛选效率、课题设计速度和写作转化率,欢迎了解解螺旋,让专业团队帮助你把“会读”真正变成“会做、会写、会发”。
- 引言Introduction
- 1. 什么是结构化泛读法
- 2. 结构化泛读法的实操步骤
- 3. 如何快速提炼SCI核心信息
- 4. 用结构化泛读法提升课题设计能力
- 5. 结构化泛读法的常见误区
- 总结Conclusion