

 11
 分享
引言Introduction
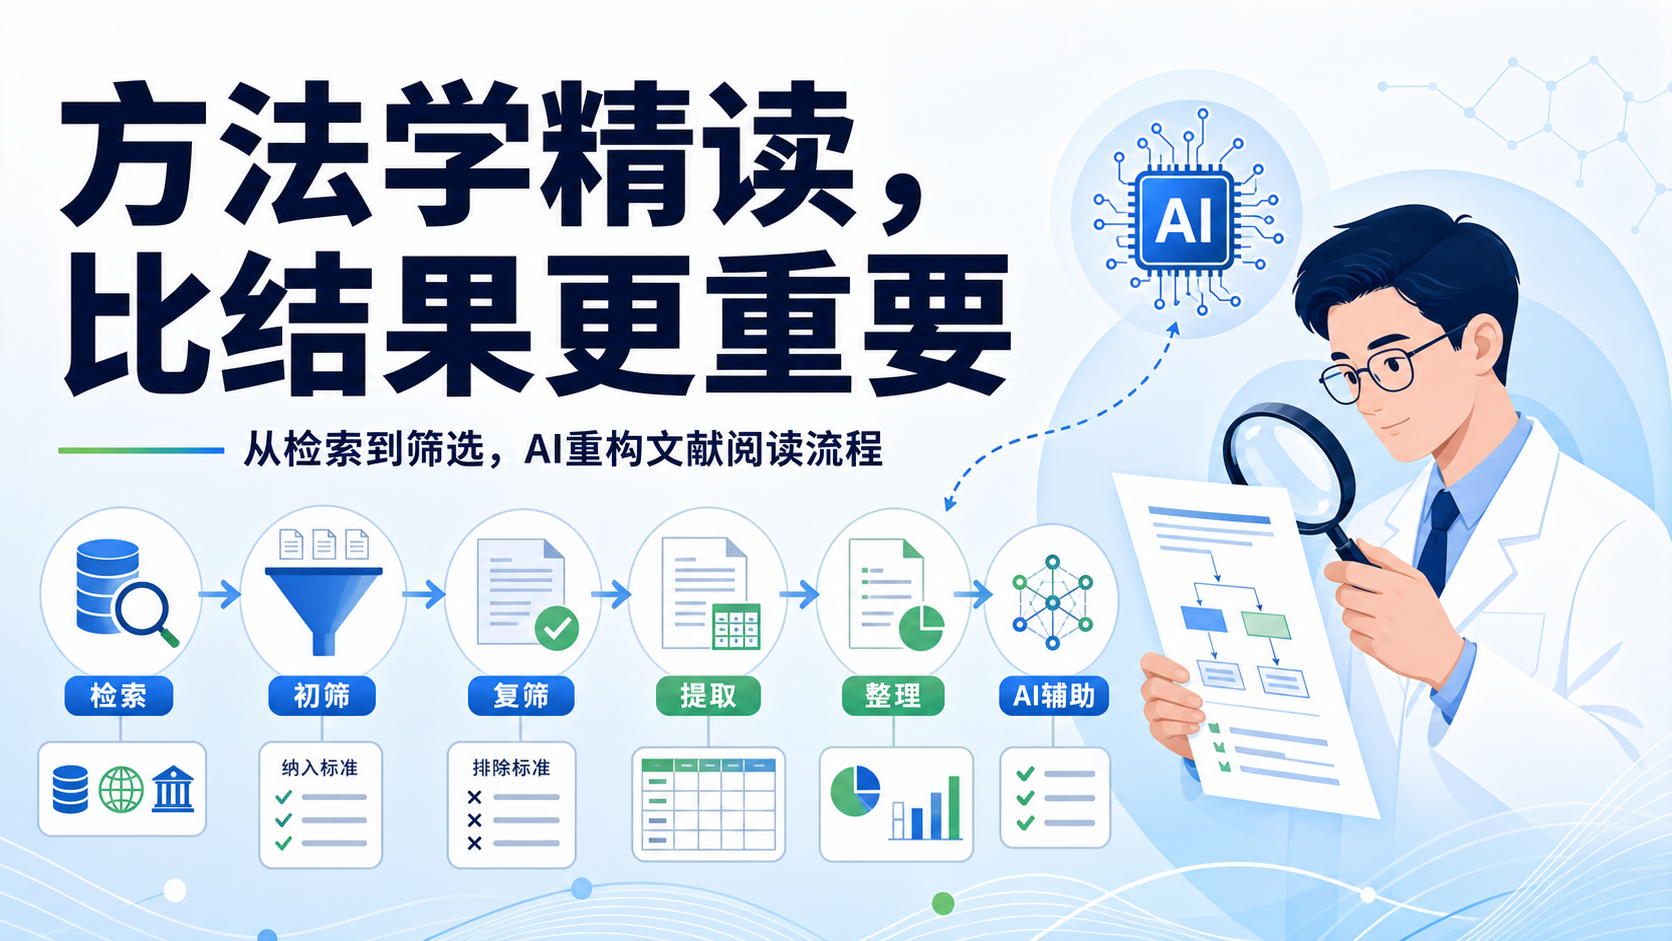
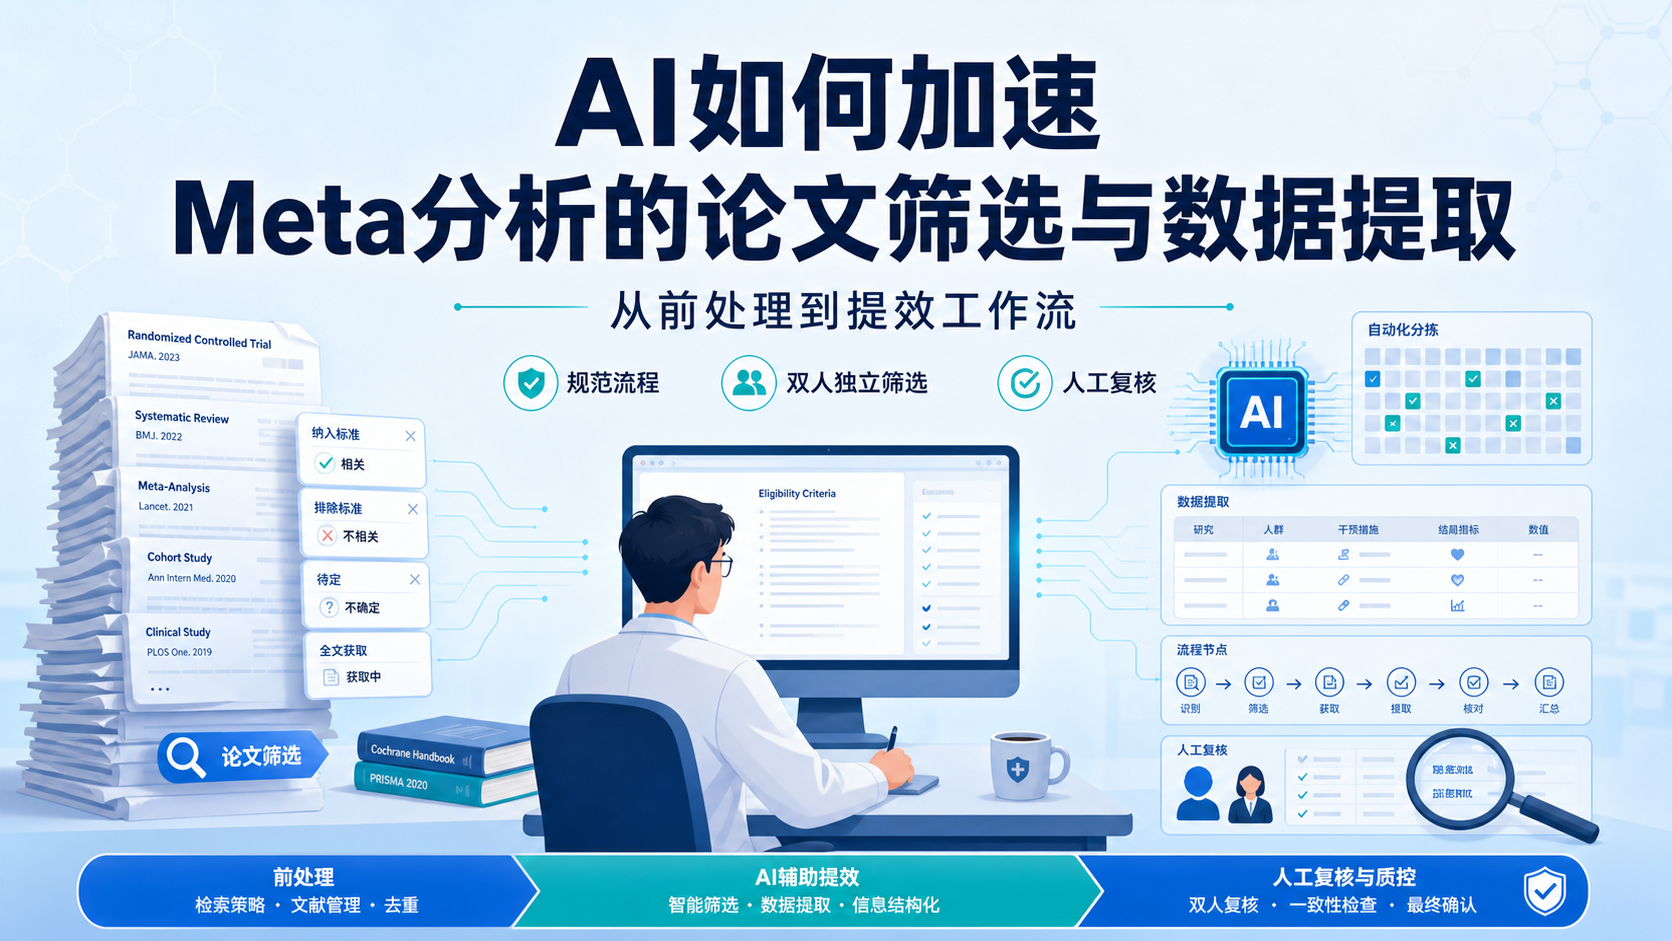
Meta分析最耗时的环节,不是统计建模,而是论文筛选和数据提取。标题摘要要初筛,全文要精筛,数据还要逐项整理。如果流程不规范,后面再强的模型也会被“垃圾输入”拖慢。
1. Meta分析里,最费时间的其实是前处理
1.1 论文筛选为什么最消耗人力
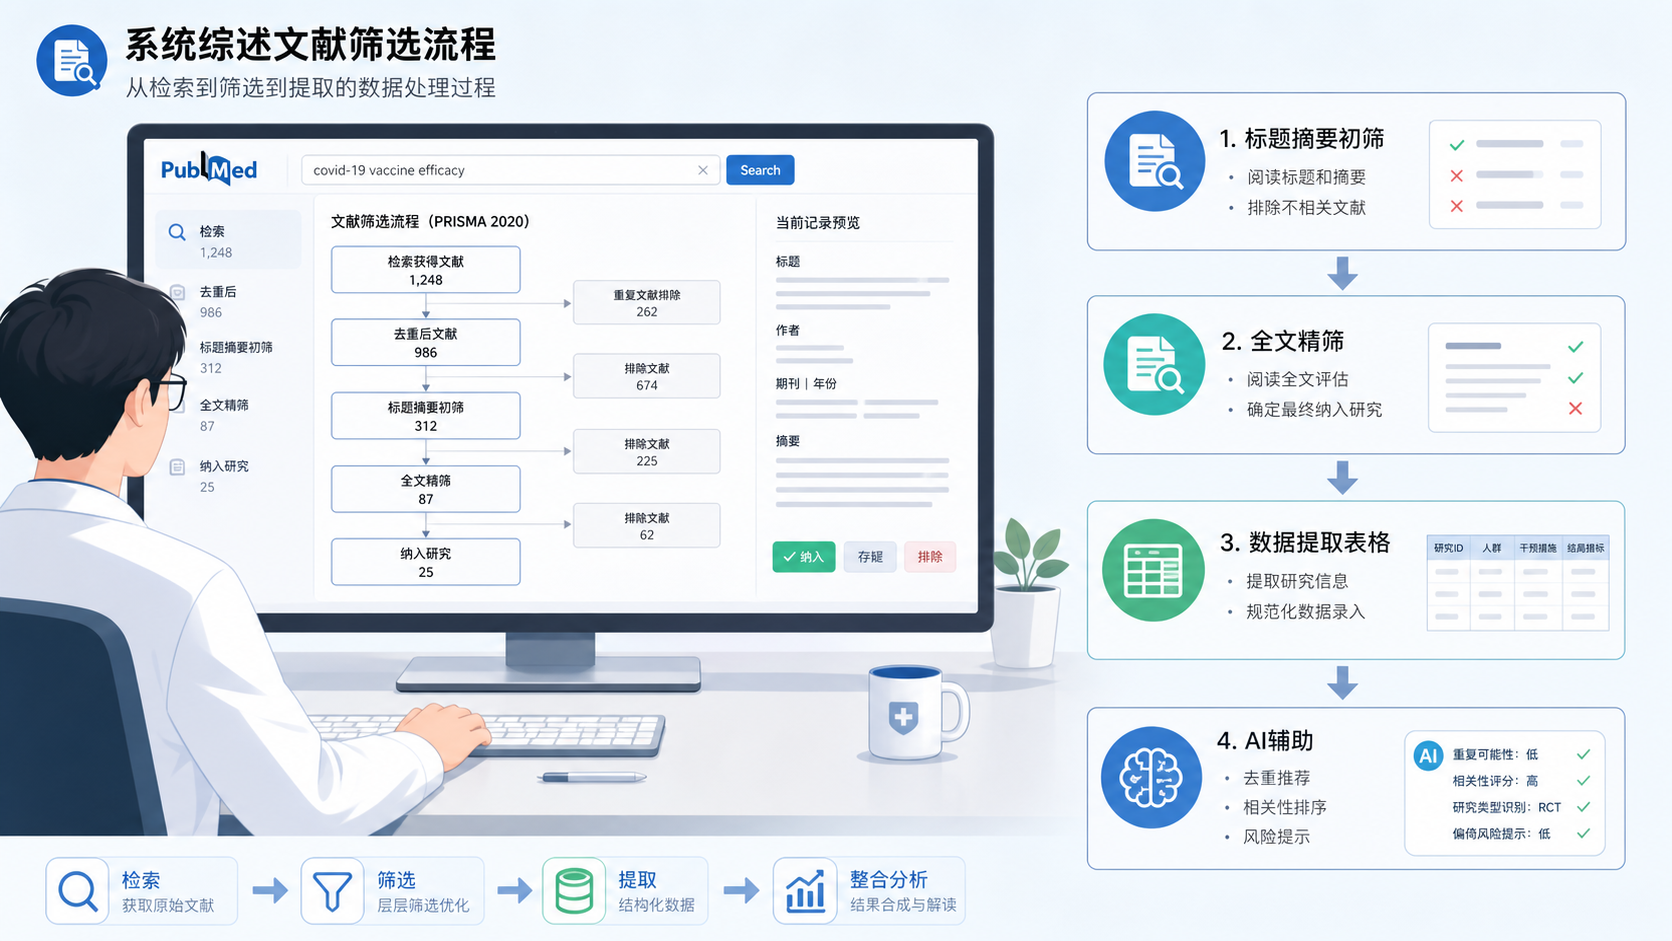
传统Meta分析通常先做标题和摘要初筛,再进入全文精筛。这一步看似简单,实际最耗时间。因为研究者要不断判断,某篇文章是否符合PICO、是否重复、是否存在结局不一致或数据缺失。
更重要的是,论文筛选不能只靠一个人完成。 规范流程通常要求双人独立筛选,并记录冲突如何解决。这样做不是为了形式,而是为了降低漏筛和误纳入风险。
1.2 数据提取为什么更慢
筛选之后,真正的重活才开始。研究者要从全文中提取所有关注的outcomes,整理成表格,再核对效应量、样本量、随访时间、干预方案等信息。
经验丰富的研究者,提取一篇文章可能也要1小时左右。 如果纳入研究数量较多,时间成本会迅速放大。对于医学生、住院医或刚进入科研训练的人来说,这一步往往是最容易卡住的地方。
1.3 规范流程决定结果质量
Meta分析不是简单地“把文章找齐”。它依赖可追溯的筛选记录、明确的排除理由、统一的数据结构。
如果前处理不规范,后面的敏感性分析、亚组分析、发表偏倚评估都会受到影响。所以,效率提升的前提,是流程标准化。
2. AI如何加速论文筛选
2.1 初筛阶段,AI最适合做“分拣”
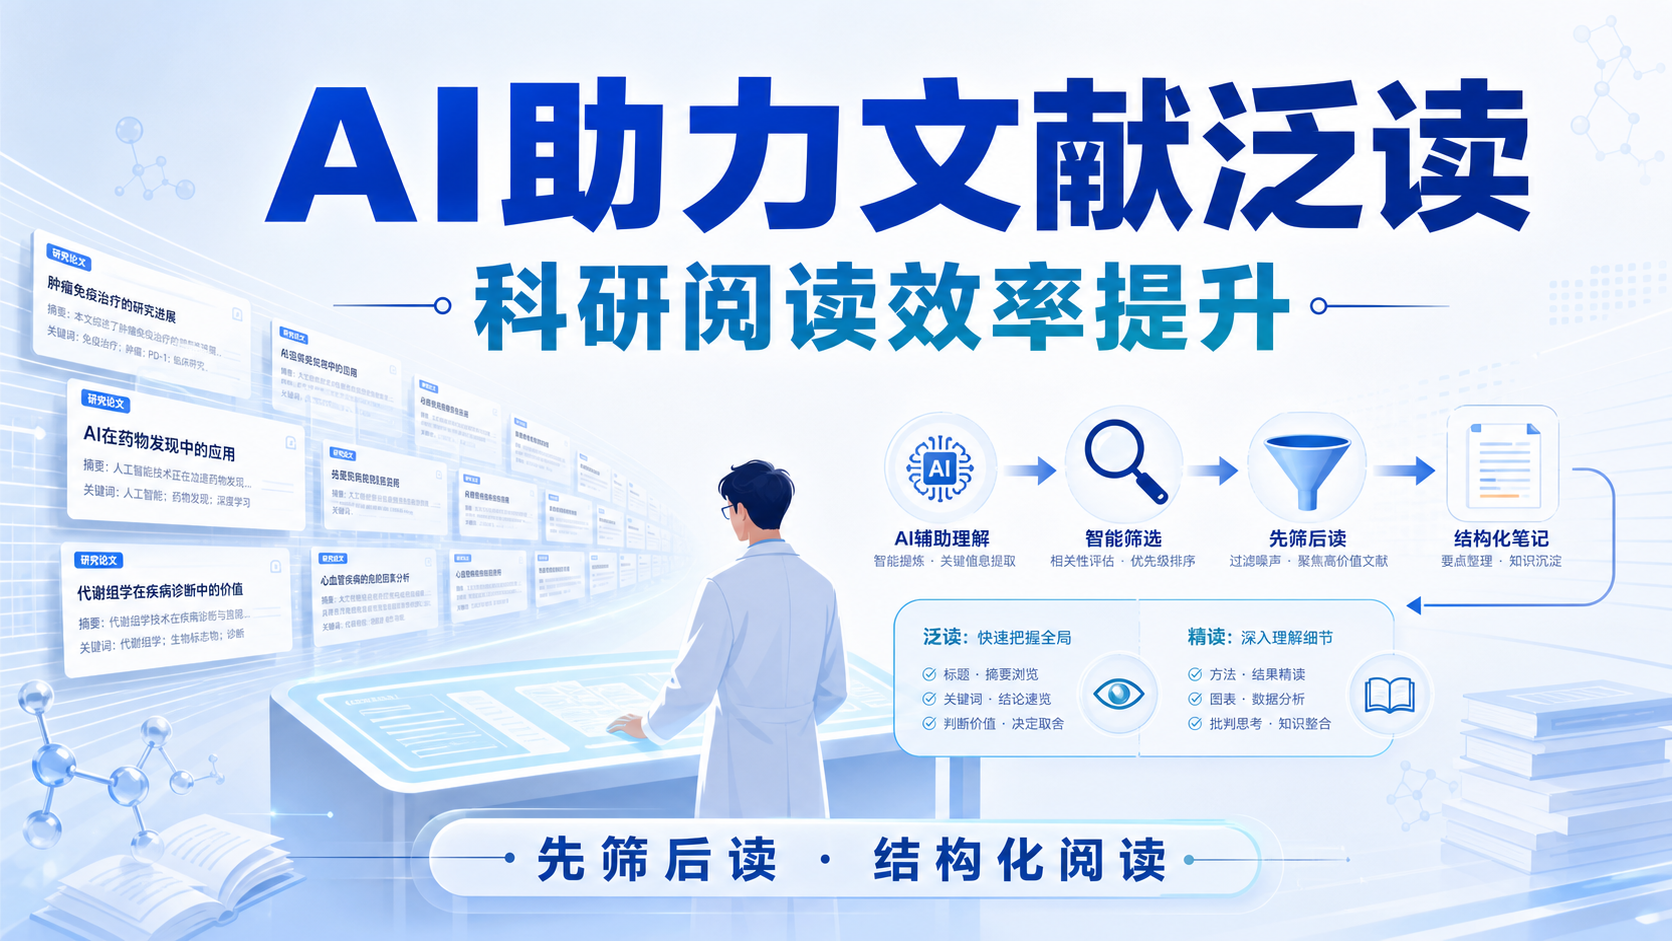
AI在论文筛选中的价值,首先体现在标题摘要初筛。它可以快速识别可能相关的文献,按相关性排序,帮助研究者优先处理高概率纳入的文章。
这并不意味着AI可以替代判断。更准确的说法是,AI负责扩大检索后的第一轮分拣,人负责最终决策。 这种分工可以显著减少人工逐篇阅读的负担。
2.2 精筛阶段,AI可以辅助全文判断
全文精筛比初筛更复杂,因为需要结合研究设计、纳入排除标准和结果报告进行判断。AI可以辅助定位关键段落,例如方法学、结果部分、补充材料中的数据描述。
但在这个阶段,AI不能单独完成结论。原因很简单,全文精筛涉及研究异质性、结局定义差异和临床语境判断。这些都需要人工把关。
2.3 双人独立筛选仍然必要
即便使用AI,双人独立筛选仍应保留。原因有三点:
- AI可能遗漏边界研究。
- 不同数据库的摘要质量不一致。
- 纳入标准解释往往存在主观差异。
更稳妥的做法是,AI先做预筛,研究者再按规则复核。冲突文献仍由第二层人工确认。这样既保留速度,也保留方法学严谨性。
3. AI如何提升论文核心信息提取
3.1 数据提取的本质是结构化阅读
数据提取不是简单复制粘贴,而是把分散在全文中的关键信息转换为统一表格。常见字段包括:
- 研究对象和样本量。
- 干预措施与对照措施。
- 主要和次要结局。
- 统计指标,如RR、OR、HR、MD、SMD。
- 随访时间和不良事件。
这一步的难点在于信息分散、表达不统一、单位不一致。 同一结局可能出现在正文、表格、图中,甚至只在补充材料里出现。
3.2 AI适合批量提取,但必须人工复核
AI可以同时处理多篇文章,快速输出初稿表格,尤其适合做论文核心信息提取。它擅长把长文档转成结构化结果,节省重复劳动。
但必须强调,AI提取结果不能直接用于定稿。 因为研究中常见以下问题:
- 结局名称相似但定义不同。
- 统计口径不一致。
- 多时间点数据混杂。
- 图表数据和正文数据不一致。
因此,最佳实践是AI先提取,人工再逐项复核,尤其核对原文中的数值、时间点和单位。
3.3 双人独立提取更稳妥
和筛选一样,数据提取也建议双人独立完成。一个人负责初提取,另一个人负责核对,最后解决分歧。
这个流程看起来慢,但实际上能减少返工。一旦提取错误进入合并分析,后续修正成本更高。
对于系统综述和Meta分析来说,数据质量直接决定结果可信度。AI能提速,但不能替代方法学控制。
4. AI带来的真实提效点在哪里
4.1 从“两周全职”到“一到两天”
传统手工Meta分析,从检索、筛选、提取到整理,常常需要约两周全职工作量。现在有AI辅助后,文献筛选和数据提取的效率可以明显提升。
在特定选题、明确纳入标准、文献质量较稳定的情况下,原本需要两周的工作,可能压缩到1到2天完成基础流程。 这不是夸张,而是流程优化后的结果。
4.2 十倍提效来自哪里
所谓十倍提效,不是每一步都快10倍,而是整体重复劳动大幅减少。最明显的提升来自三处:
- AI加速初筛,减少人工翻阅量。
- AI批量提取关键信息,减少逐篇抄录。
- 人工只集中处理冲突和高风险文献。
也就是说,AI不是把研究者“替换掉”,而是把人从低价值重复任务中解放出来。人更适合做判断,AI更适合做搬运和整理。
4.3 网络Meta为什么还不能完全自动化
需要客观看待能力边界。传统Meta的部分流程可以被AI显著辅助,但网状Meta仍然更复杂,目前还不适合完全自动化。
原因在于它涉及更多干预节点、间接比较和一致性检验,输入质量要求更高,异常值也更难处理。
所以,科研人员在使用AI时,应把它理解为效率工具,而不是“一键出结果”的替代方案。
5. 研究者该怎么把AI真正用起来
5.1 先标准化,再自动化
想让AI真正帮助Meta分析,第一步不是上工具,而是先统一规则。包括:
- 明确纳入排除标准。
- 统一结局指标定义。
- 设定提取字段模板。
- 规定冲突处理流程。
没有标准化,AI只会放大混乱。 有了标准化,AI才能稳定输出可复核的数据。
5.2 把AI放在最合适的位置
AI最适合插入三个节点:
- 文献初筛前的相关性排序。
- 全文中关键数据定位。
- 结构化表格初稿生成。
而不适合直接替代的节点包括:
- 纳入标准最终判断。
- 异质性解释。
- 统计模型选择。
- 最终结论撰写。
这个边界要清楚。AI负责“快”,研究者负责“准”。
5.3 用工作台思路提高产出效率
如果你正在做系统综述或Meta分析,更现实的做法是借助成熟工作台,把筛选、提取和记录流程尽量规范化。这样能减少低级错误,也能让团队协作更顺畅。
比如,解螺旋的相关工作台思路,就是把文献筛选和数据提取放进可追踪、可复核的流程里,帮助研究者更快完成论文核心信息提取。对需要高频产出综述和Meta分析的团队来说,这种方式更接近真实科研场景。
总结Conclusion
AI已经明显改变了Meta分析的前处理方式。它最有价值的地方,不是“自动完成”整个项目,而是把论文筛选和论文核心信息提取的重复劳动大幅压缩。
但要记住,筛选仍需双人独立,数据提取仍需人工复核,网状Meta也远未到完全自动化阶段。真正高质量的研究,依然建立在标准化流程和严谨判断上。
如果你希望更高效地推进系统综述或Meta分析,建议尽早把AI工具嵌入规范流程。可以了解解螺旋,借助更成熟的科研工作台,把筛选、提取和复核做得更快、更稳。
- 引言Introduction
- 1. Meta分析里,最费时间的其实是前处理
- 2. AI如何加速论文筛选
- 3. AI如何提升论文核心信息提取
- 4. AI带来的真实提效点在哪里
- 5. 研究者该怎么把AI真正用起来
- 总结Conclusion