5
 分享
引言Introduction
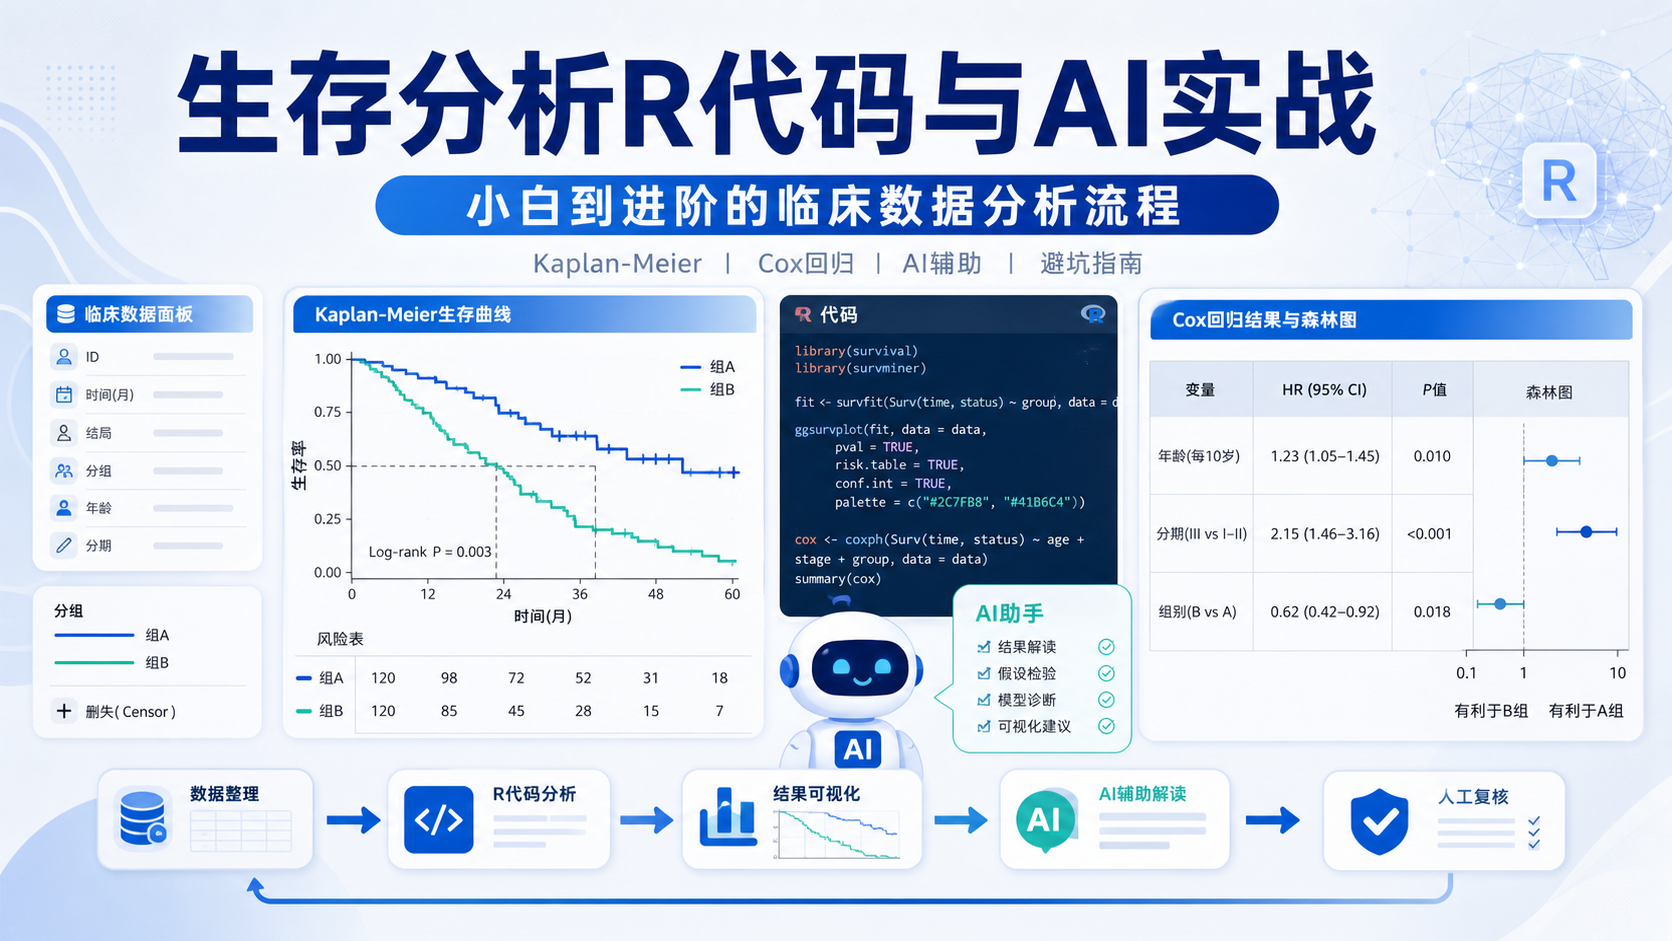
生存分析常卡在三件事上,数据整理、代码报错、模型选择。对医学生、医生和科研人员来说,最耗时的不是统计本身,而是把临床问题翻译成可运行的R代码。如果你希望快速完成Kaplan-Meier曲线、Cox回归和批量生存分析,AI工具可以显著降低入门门槛。 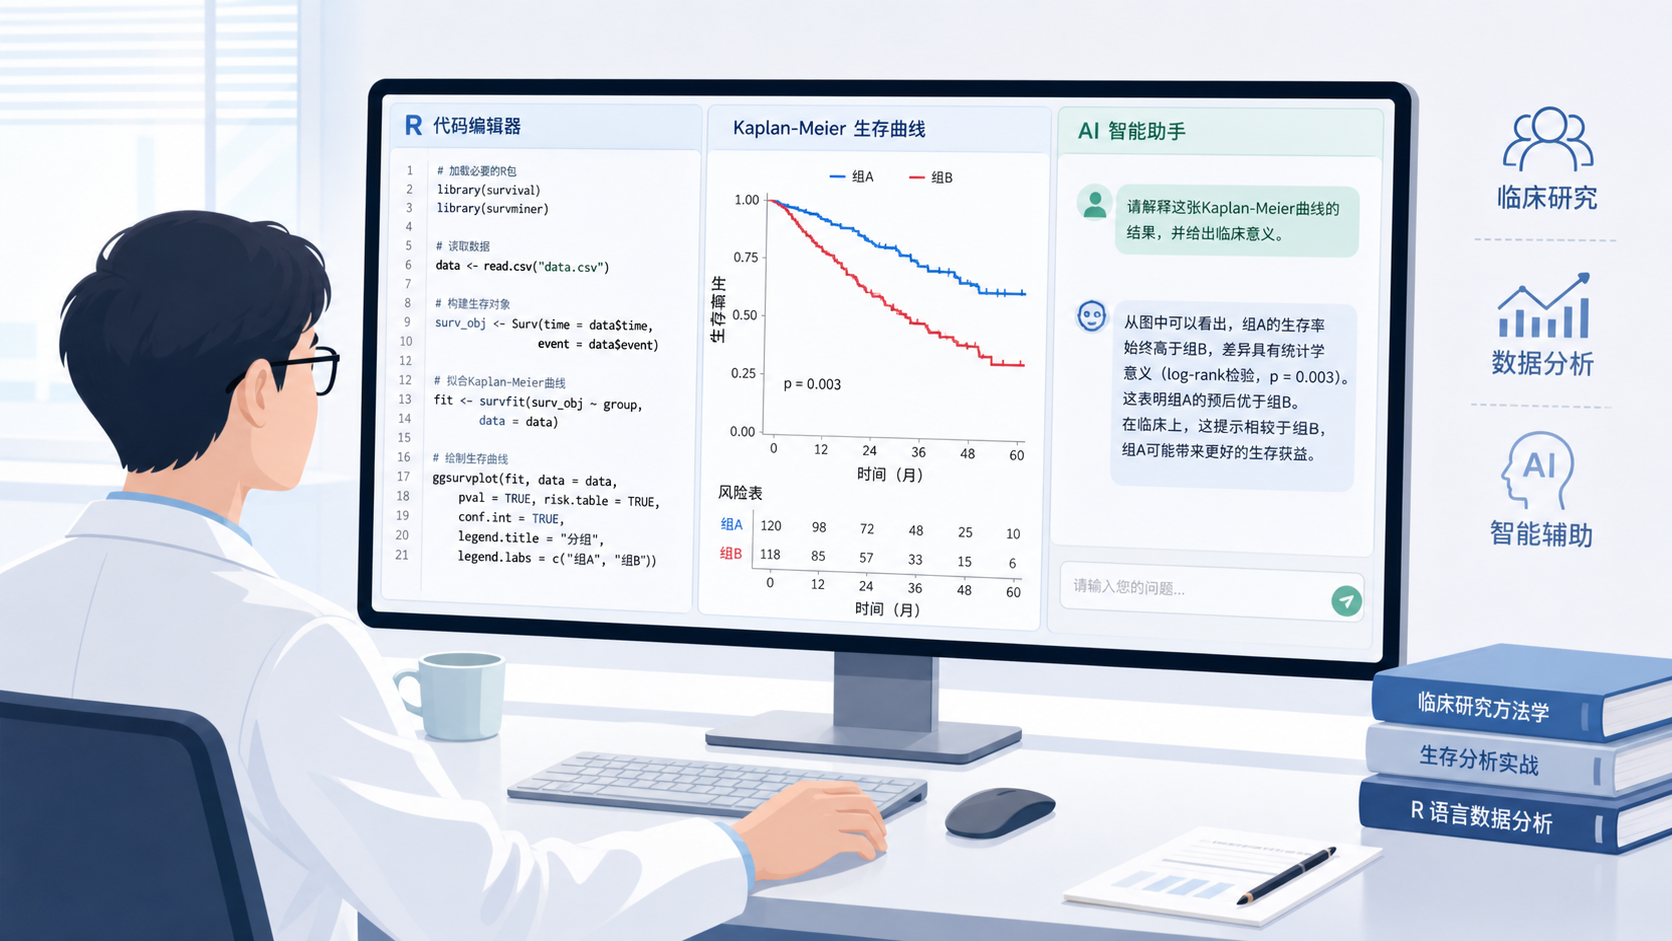
1. 先明确:生存分析到底在解决什么问题
1.1 生存分析不是简单的“有无结局”
生存分析研究的是“时间到事件”的问题。事件可以是死亡、复发、进展,也可以是机械通气脱机、移植失败等。它的核心不是只看最终有没有发生,而是看事件发生用了多久。
这也是它和普通分类模型的区别。分类只回答“是否发生”。生存分析还要回答“何时发生”。因此,随访时间、删失信息、事件状态,都是必须纳入的数据。
1.2 临床研究中最常见的应用场景
在肿瘤、心血管、感染和器官移植研究中,生存分析都很常见。常用问题包括:
- 某个分组是否影响总生存期。
- 某个生物标志物是否与无进展生存期相关。
- 某个影像特征能否预测预后。
- 多个基因中,哪些与生存显著相关。
只要研究终点带有时间维度,生存分析就比普通t检验或卡方检验更合适。
2. 生存分析R代码的基础框架
2.1 先准备好3类数据
做生存分析前,最重要的是数据结构要正确。通常需要三列核心信息:
- 生存时间。
- 结局状态,通常用0和1表示。
- 分组变量,或连续变量。
如果是队列数据,还可能需要年龄、性别、分期、治疗方式等协变量。数据格式不对,后面的R代码再完整也跑不通。
在实际项目里,最常见的问题不是统计方法,而是时间单位混乱。例如,有的表格写的是“天”,有的写的是“月”。建模前必须统一。
2.2 Kaplan-Meier曲线是第一步
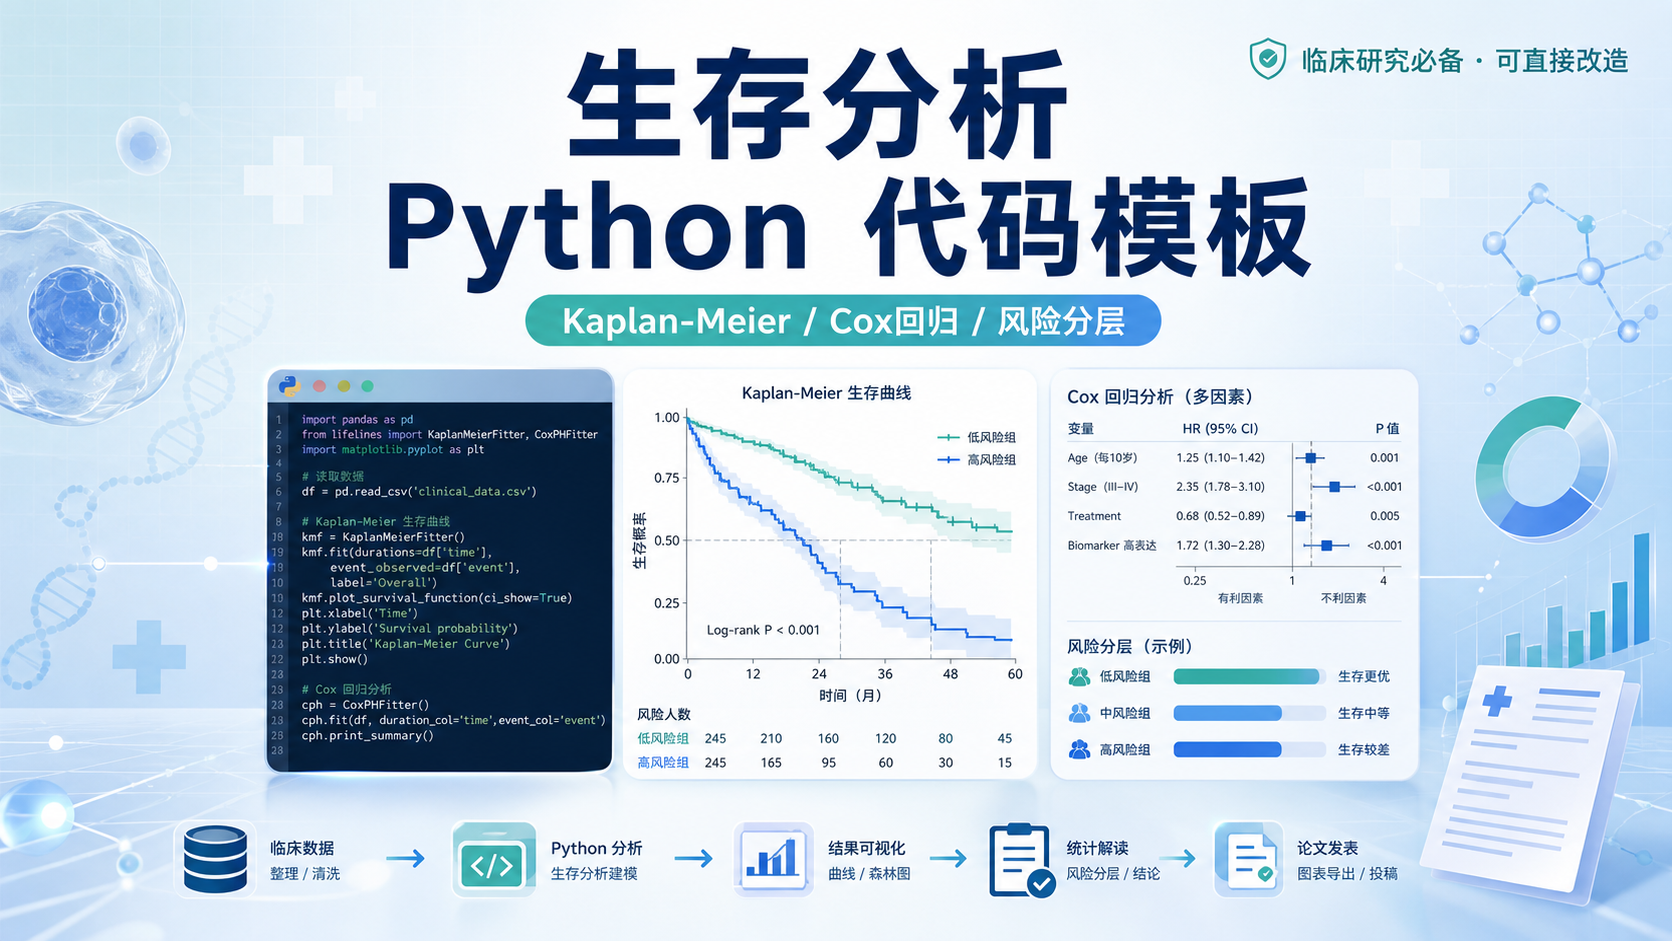
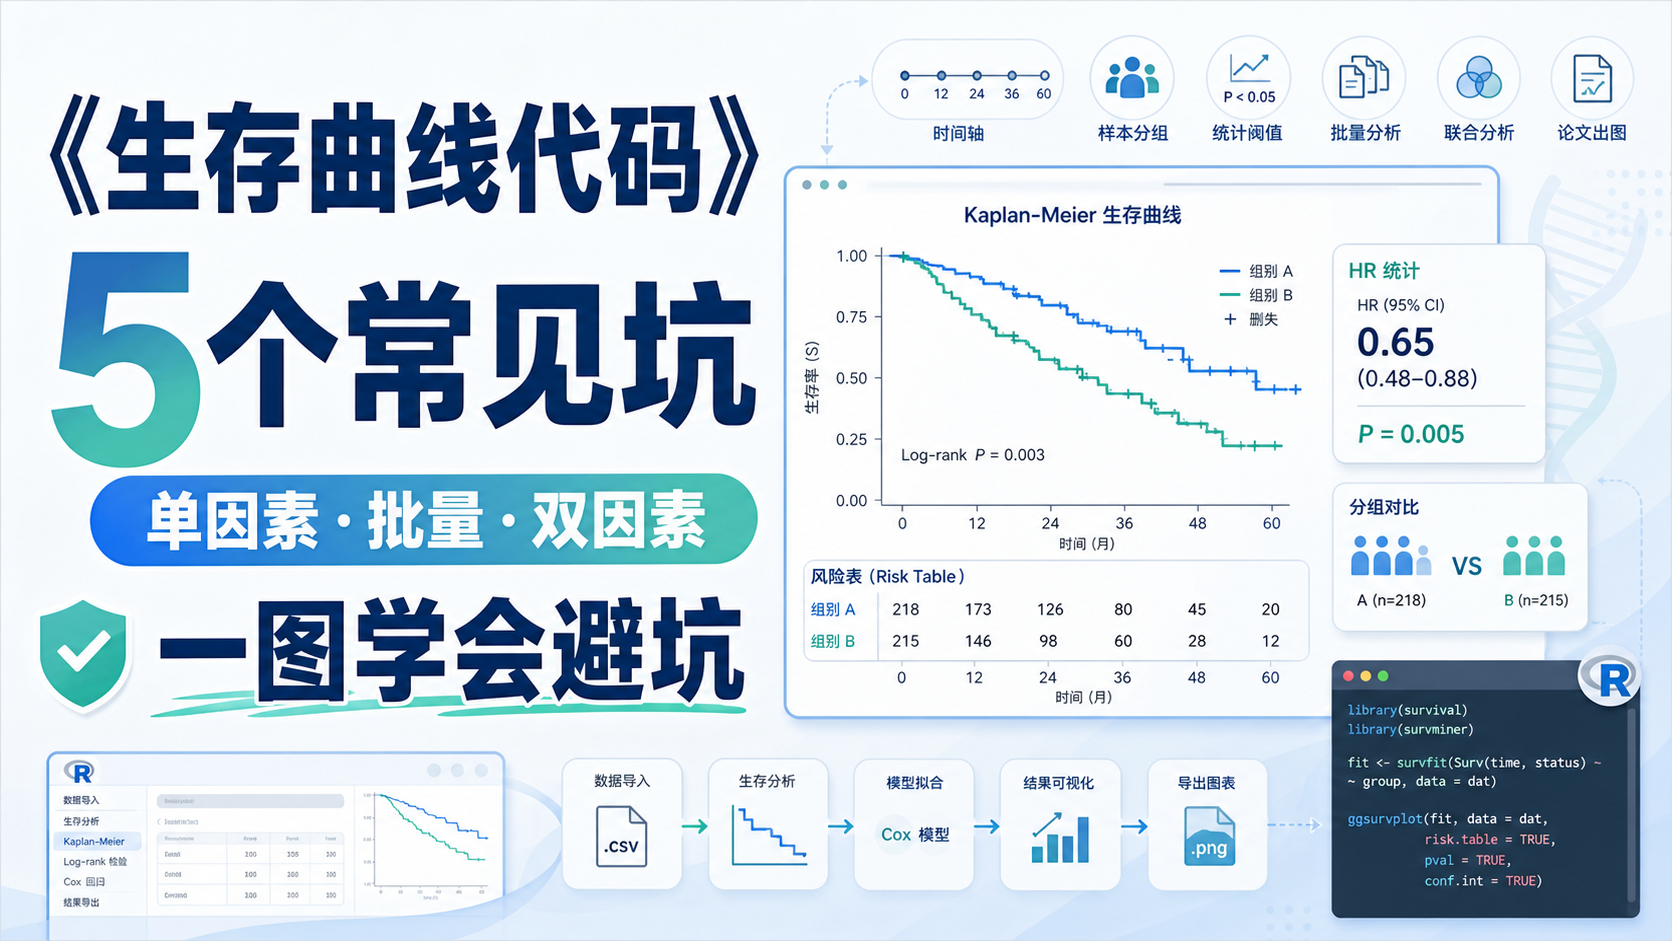
KM曲线适合比较不同组的生存差异。R中最常用的是 survival 和 survminer 包。基础流程通常包括:
- 构建生存对象。
- 拟合生存曲线。
- 绘制曲线。
- 添加P值、风险表和置信区间。
一个简洁的生存分析R代码框架如下:
library(survival)
library(survminer)

# 假设数据框为 df
# time: 生存时间
# status: 结局状态,1=事件发生,0=删失
# group: 分组变量

fit <- survfit(Surv(time, status) ~ group, data = df)

ggsurvplot(
  fit,
  data = df,
  pval = TRUE,
  conf.int = TRUE,
  risk.table = TRUE,
  surv.median.line = "hv"
)
这段代码是生存分析最常见的起点。 它适合快速完成分组生存比较,也适合论文作图初稿。
3. Cox回归:从“组间差异”走向“独立影响因素”
3.1 单因素Cox回归看相关性
KM曲线只能比较组间差异,不能控制混杂因素。若要判断某个变量是否独立影响预后,就要用Cox回归。单因素Cox可用于筛选候选变量。
library(survival)

cox1 <- coxph(Surv(time, status) ~ age, data = df)
summary(cox1)
输出中最关键的是HR、95%CI和P值。HR大于1,表示风险升高。HR小于1,表示风险降低。但前提是变量编码要正确,尤其是分组变量的参考组。
3.2 多因素Cox回归更接近临床结论
多因素模型能同时纳入多个协变量,更适合临床论文。常见写法如下:
cox2 <- coxph(Surv(time, status) ~ age + sex + stage + biomarker, data = df)
summary(cox2)
做多因素分析时,建议重点检查三件事:
- 是否存在缺失值。
- 是否存在共线性。
- 比例风险假设是否成立。
如果比例风险假设不满足,模型结果可能偏倚。这个环节不能跳过。
4. AI工具如何帮你写出生存分析R代码
4.1 让AI先帮你搭框架
对多数非编程背景的研究者来说,最大难点不是统计原理,而是代码组织。AI最适合做的,是先给出可运行框架,再由你根据真实数据修改变量名和路径。
你可以这样提问:
- “请用R写一个Kaplan-Meier生存分析代码,加入详细注释。”
- “请用R写单因素和多因素Cox回归代码,输出HR、95%CI和P值。”
- “请根据我的数据结构,帮我检查Surv对象是否写对。”
高质量提问比盲目复制更重要。 AI能减少试错,但不能替代你对研究设计的判断。
4.2 让AI解释报错,比单纯改代码更有效
很多人卡在报错信息。其实,AI非常适合处理这类问题。你只要把完整报错贴进去,并说明数据结构,通常就能快速定位问题。
常见问题包括:
status不是0/1格式。time被读成字符型。- 分组变量没有转换为因子。
- 包没有安装,或函数冲突。
遇到报错时,不要只问“怎么改”。要把数据列名、变量类型和报错全文一起给AI。 这样得到的答案更准确。
4.3 AI适合批量生存分析,但要人工复核
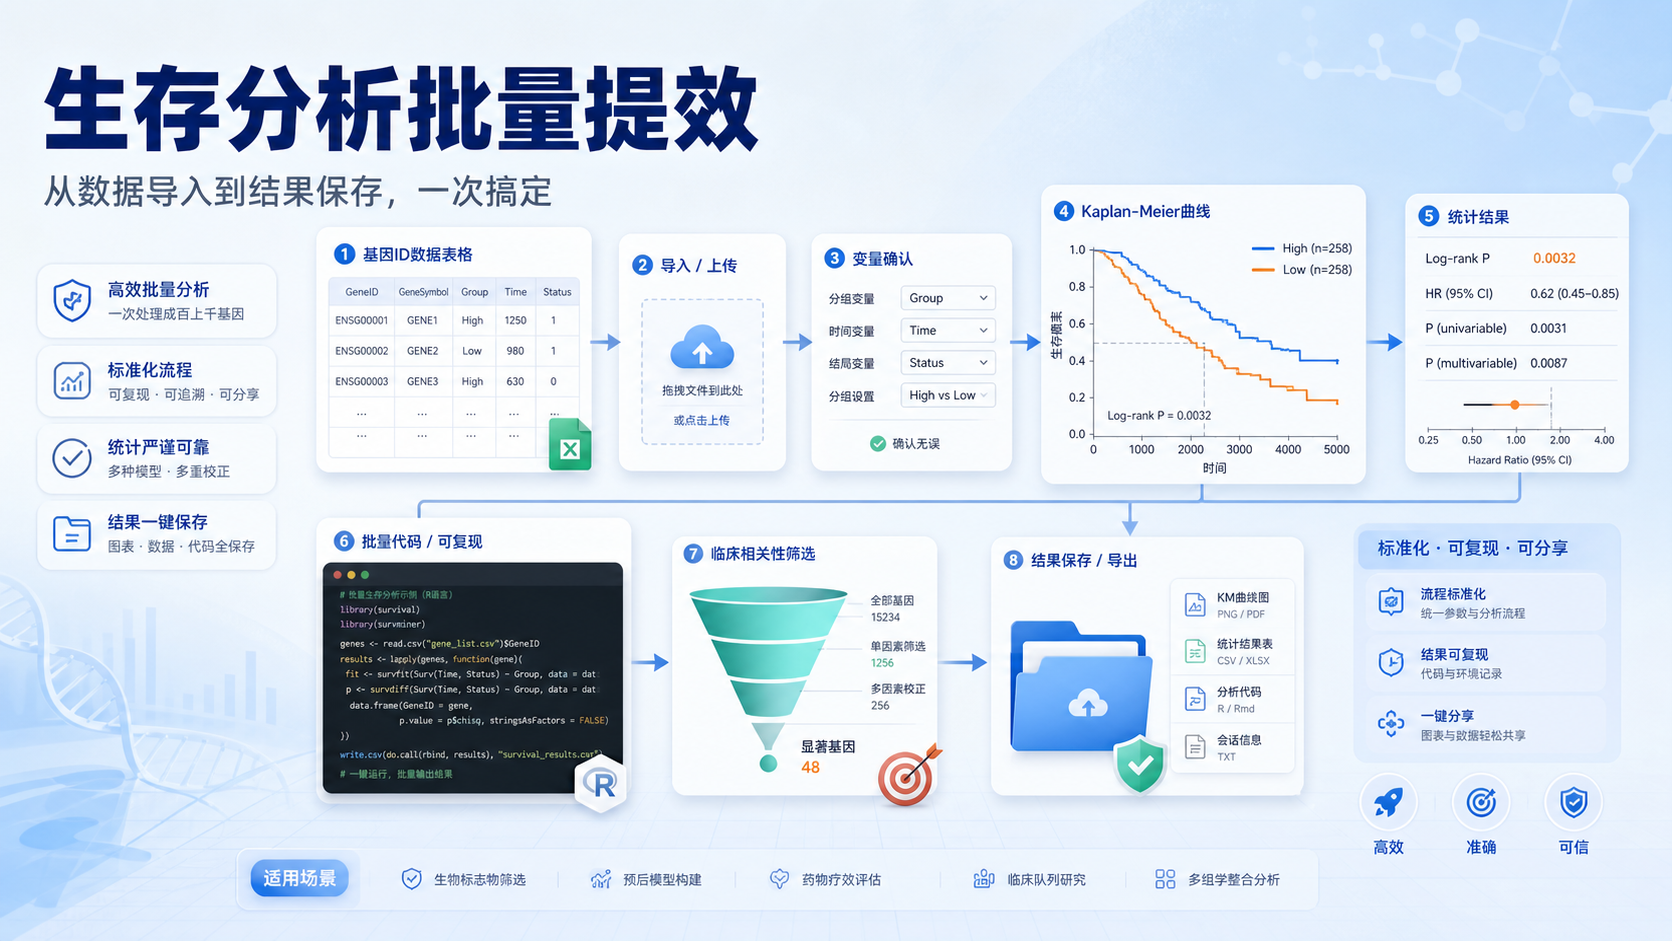
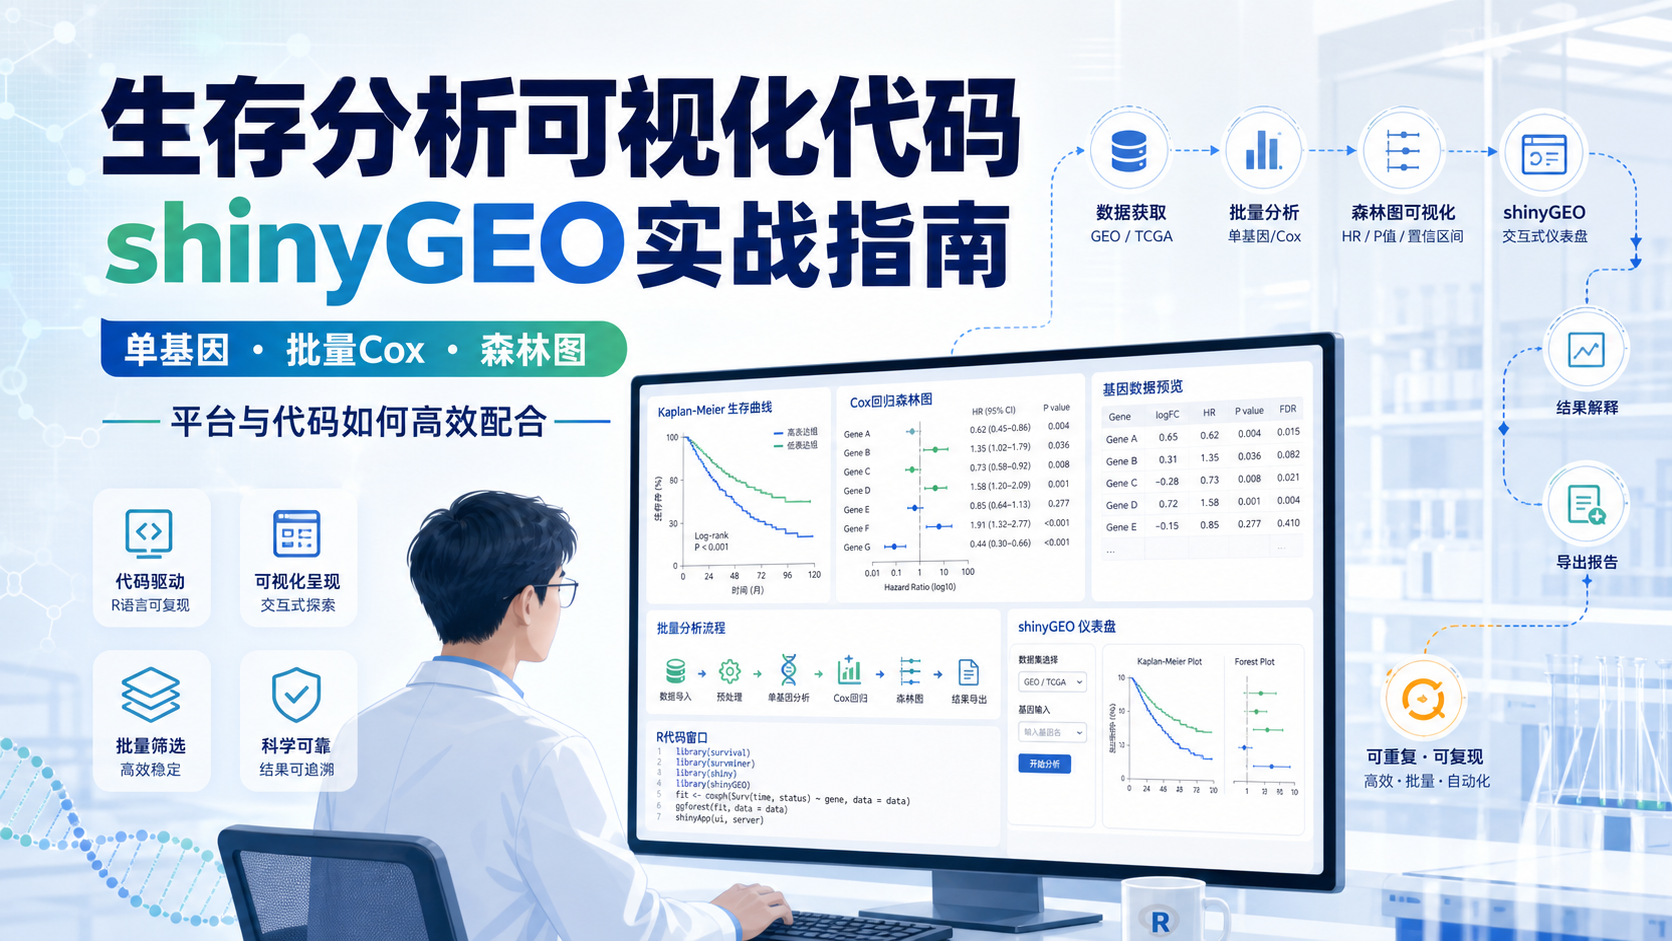
如果你要分析几十个基因、影像特征或标志物,手工逐个跑Cox回归效率很低。AI可以帮助你生成循环代码,自动提取HR和P值,再输出结果表。
但要注意,批量分析最容易出现两类问题:
- 多重比较带来的假阳性。
- 自动筛选阈值设定不合理。
因此,AI适合提高效率,不适合代替统计把关。
5. 生存分析实战中最容易踩的坑
5.1 事件编码方向要统一
这是最常见的错误之一。R中的 Surv(time, status) 默认要求你明确哪个值代表事件发生。若编码方向反了,曲线和HR都可能解释错误。
建议在分析前统一写清楚:
status = 1,事件发生。status = 0,删失。
如果你的原始数据相反,必须先转换。
5.2 分组变量一定要先转因子
如果分组变量是字符型或数值型,R可能不会按你预期建模。尤其在KM曲线中,分组顺序会直接影响参考组和图形展示。
因此,建议先检查:
df$group <- factor(df$group, levels = c("low", "high"))
这一步很小,但非常关键。
5.3 缺失值会悄悄影响样本量
很多临床数据表看起来很完整,但实际上某些变量缺失较多。Cox回归默认会剔除缺失样本,导致最终纳入人数变少。
建议在建模前先统计缺失率,并明确写入方法学部分。样本量变化必须可追溯。
6. 一个更高效的工作流:R代码+AI+人工复核
6.1 推荐的实操顺序
对于初学者,建议按这个顺序推进:
- 先整理数据字典。
- 再让AI生成KM曲线代码。
- 用小样本测试能否跑通。
- 再做单因素和多因素Cox回归。
- 最后再做批量分析和可视化。
这个流程的好处是,错误会尽早暴露。不要一开始就让AI生成大而全的完整脚本。
6.2 结果展示也要规范
论文里常见的生存分析结果,建议至少包括:
- KM曲线。
- Cox回归结果表。
- HR森林图。
- 风险表。
- 终点定义和删失说明。
如果是组学研究,还可以加入时间依赖ROC、列线图或校准曲线。但前提是基础模型要先做稳。
7. 用解螺旋,让生存分析更快落地
如果你正在为生存分析R代码反复报错、变量命名混乱或结果难以复现,解螺旋可以帮助你把“研究思路”快速转成“可执行代码” 。无论是KM曲线、Cox回归,还是批量生存分析,关键都在于数据结构清晰、代码步骤规范、输出结果可复核。通过AI辅助和规范化工具,你可以把时间更多放在研究设计和结果解释上,而不是反复排错。
总结Conclusion
生存分析是临床研究中的高频方法,也是很多医学生和青年研究者的入门难点。它并不神秘,核心就是时间、事件和删失。只要数据结构正确,R代码可以稳定完成KM曲线、Cox回归和批量分析。
AI工具的价值,不在于替你思考,而在于帮你更快写出框架、定位报错、生成注释清晰的代码。真正高效的做法,是“AI生成初稿,人工复核逻辑”。
如果你想更快掌握生存分析R代码,并把结果真正用于论文写作和课题推进,欢迎借助解螺旋,把复杂流程变成可执行的科研步骤。
- 引言Introduction
- 1. 先明确:生存分析到底在解决什么问题
- 2. 生存分析R代码的基础框架
- 3. Cox回归:从“组间差异”走向“独立影响因素”
- 4. AI工具如何帮你写出生存分析R代码
- 5. 生存分析实战中最容易踩的坑
- 6. 一个更高效的工作流:R代码+AI+人工复核
- 7. 用解螺旋,让生存分析更快落地
- 总结Conclusion