1
 分享
引言Introduction
做生存分析时,很多人卡在同一个环节。数据有了,代码也有了,但ROC、KM曲线和p值总是对不上,样本分组也容易出错。如果你需要把TCGA表达矩阵和临床信息快速转成可发表的生存分析结果,这篇文章可以直接作为实操模板。 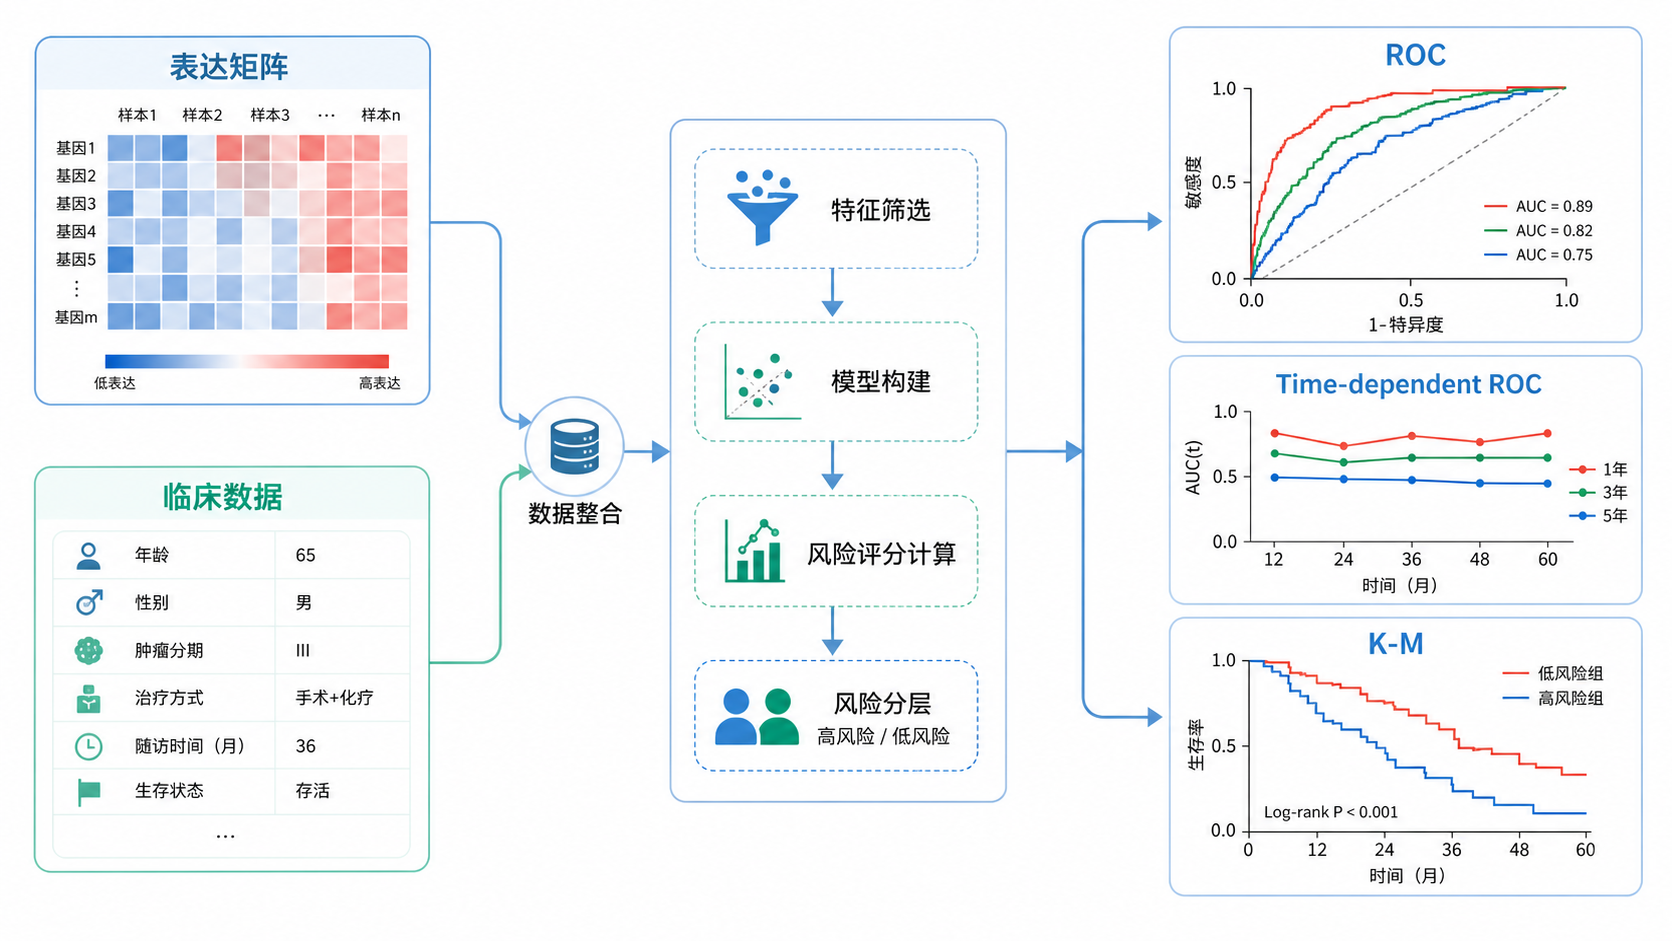
1. 生存分析前的准备工作
1.1 数据和包的准备
生存分析代码的第一步,不是直接画图,而是先保证数据结构正确。TCGA分析通常需要两类数据。一个是表达矩阵,一个是临床随访信息。
常用R包包括:
tidyverse,用于数据整理。pROC,用于诊断ROC。timeROC,用于时间依赖ROC。survival,用于构建生存对象。survminer,用于绘制KM曲线。ggplot2,用于图形美化。
代码示例如下:
rm(list = ls())
library(tidyverse)
library(pROC)
library(timeROC)
library(survival)
library(survminer)
library(ggplot2)

load('TCGA-ESCA_cli_proc.Rda')
load('TCGA-ESCA_tpm_exp.Rda')
这一步的核心不是“加载成功”,而是确认后续分析所需的字段都已存在。 至少要有样本ID、分组信息、状态变量status和生存时间os_time。
1.2 样本匹配和字段清理
TCGA数据最常见的问题,是表达矩阵和临床表并不完全一一对应。若样本ID处理不规范,后面的ROC和KM都会出错。
建议先统一样本粒度。比如把样本ID截取到前12位,去除重复样本,再与临床信息交叉匹配。这样可以避免同一患者多个测序样本造成偏差。
标准做法是先去重,再合并,再分析。 这是保证生存分析可靠性的关键步骤。
2. 诊断ROC分析:先看模型是否有区分能力
2.1 提取基因表达并构建分组
在诊断ROC中,通常用单个基因表达值判断Normal和Tumor两类样本的区分能力。这里以SYNGR2为例。
exp_all <- cbind(exp['SYNGR2', ] %>% t() %>% as.data.frame(),
                 group = group_TCGA$group)
这个对象的结构很简单。左侧是表达量,右侧是分组标签。接下来就可以直接做ROC分析。
2.2 计算AUC并绘图
roc <- roc(
  group ~ SYNGR2,
  data = exp_all,
  auc = T,
  ci = T,
  levels = c('Normal', 'Tumor')
)

ggroc(roc,
      legacy.axes = T,
      col = '#4DBBD5',
      lwd = 1) +
  labs(subtitle = 'SYNGR2',
       x = '1 - Specificities (FPR)',
       y = 'Sensitivities (TPR)') +
  annotate(
    'text',
    label = paste0(
      'AUC = ',
      round(roc$auc, 3),
      ' ( ',
      round(roc[['ci']][1], 3),
      ' - ',
      round(roc[['ci']][3], 3),
      ' )'
    ),
    x = 0.8,
    y = 0
  ) +
  coord_fixed() +
  geom_abline(slope = 1, intercept = 0, lty = 'dashed') +
  theme_bw()
AUC是ROC分析里最重要的指标。 一般来说,AUC越接近1,区分能力越强。0.5接近随机判断,接近1则说明模型或指标更有诊断价值。
这里还要注意一点。ROC分析适合看“分类能力”,但它并不直接回答“这个基因是否影响预后”。如果你研究的是生存结局,还需要时间依赖ROC和KM曲线。
3. 时间依赖ROC:把随访时间纳入分析
3.1 构建生存分析输入数据
时间依赖ROC的优势在于,它不是只看一个静态分类结果,而是把1年、3年、5年这样的时间点纳入评估。
exp_cli <- exp['SYNGR2', ] %>%
  t() %>%
  as.data.frame()

exp_cli$sample_id <- rownames(exp_cli)
exp_cli <- exp_cli[group_SYNGR2$sample_id, ]

exp_cli$sample_id <- substr(exp_cli$sample_id, 1, 12)
exp_cli <- exp_cli[!duplicated(exp_cli$sample_id), ]

rownames(exp_cli) <- exp_cli$sample_id

exp_cli <- cbind(exp_cli, status = cli$status, os_time = cli$os_time)
exp_cli <- exp_cli[, c('status', 'os_time', 'SYNGR2')] %>% na.omit()
这段代码的重点有三个。
- 先把表达数据转成数据框。
- 再和临床生存信息合并。
- 最后去掉缺失值。
status和os_time必须是可用于生存分析的标准字段。 状态变量一般表示事件是否发生,时间变量一般表示随访时间或总生存时间。
3.2 计算1年、3年、5年AUC
time_roc <- timeROC(
  T = exp_cli$os_time,
  delta = exp_cli$status,
  marker = exp_cli$SYNGR2,
  cause = 1,
  weighting = 'marginal',
  times = c(1, 3, 5) * 365.25,
  ROC = T,
  iid = T
)

time_roc$AUC
confint(time_roc, level = 0.95)$CI_AUC
这里的输出会给出不同时间点的AUC及其置信区间。这比单纯ROC更适合预后研究,因为临床上真正关心的是“某个时间点上能否预测结局”。
如果你在论文中报告结果,建议把时间点和95%CI一起写清楚。这样更符合E-E-A-T中的可信度要求。
3.3 绘制时间依赖ROC曲线
time_roc_df <- data.frame(
  TP_1 = time_roc$TP[, 1],
  FP_1 = time_roc$FP[, 1],
  TP_3 = time_roc$TP[, 2],
  FP_3 = time_roc$FP[, 2],
  TP_5 = time_roc$TP[, 3],
  FP_5 = time_roc$FP[, 3]
)

ggplot(time_roc_df) +
  geom_line(aes(FP_1, TP_1), lwd = 1, color = '#4DBBD5') +
  geom_line(aes(FP_3, TP_3), lwd = 1, color = '#E64B35') +
  geom_line(aes(FP_5, TP_5), lwd = 1, color = '#00A087') +
  geom_abline(slope = 1, intercept = 0, lty = 'dashed') +
  labs(subtitle = 'SYNGR2',
       x = '1 - Specificities (FPR)',
       y = 'Sensitivities (TPR)') +
  coord_fixed() +
  theme_bw()
如果你希望生存分析代码更适合发文,时间依赖ROC几乎是必做项。 因为它能展示不同时间点的预测性能,信息量明显高于单一ROC。
4. KM曲线:验证高低表达组的生存差异
4.1 分组并构建生存对象
KM曲线是预后分析中最直观的结果之一。它回答的是:高表达组和低表达组的生存是否不同。
group_SYNGR2$patient <- substr(group_SYNGR2$sample_id, 1, 12)
group_SYNGR2 <- group_SYNGR2[!duplicated(group_SYNGR2$patient), ]
rownames(group_SYNGR2) <- group_SYNGR2$patient

patient <- intersect(rownames(exp_cli), rownames(group_SYNGR2))
group_SYNGR2 <- group_SYNGR2[patient,]
exp_cli$group <- group_SYNGR2$group

fit_surv <- survfit(Surv(os_time, status) ~ group, data = exp_cli)
这一步的关键是确保表达数据和分组信息完全匹配。 如果患者ID对不上,KM结果就没有意义。
4.2 计算log-rank检验p值
diff <- survdiff(Surv(os_time, status) ~ group,
                 data = exp_cli,
                 rho = 0)

pvalue <- pchisq(diff$chisq,
                 length(diff$n) - 1,
                 lower.tail = F)

pvalue
log-rank检验是KM曲线常配套的统计检验。它用于判断两组生存曲线差异是否具有统计学意义。
通常p值小于0.05,说明两组生存曲线差异显著。 但在科研写作中,不能只看p值,还要结合样本量、风险表和置信区间一起解释。
4.3 绘制KM曲线
ggsurvplot(
  fit_surv,
  data = exp_cli,
  pval = T,
  linetype = 'solid',
  palette = c('#4DBBD5', '#E64B35'),
  title = 'SYNGR2',
  legend.title = 'SYNGR2',
  legend = c(0.7, 0.9),
  legend.labs = c('High', 'Low'),
  conf.int = T,
  conf.int.style = 'ribbon',
  conf.int.alpha = 0.1,
  risk.table = T
)
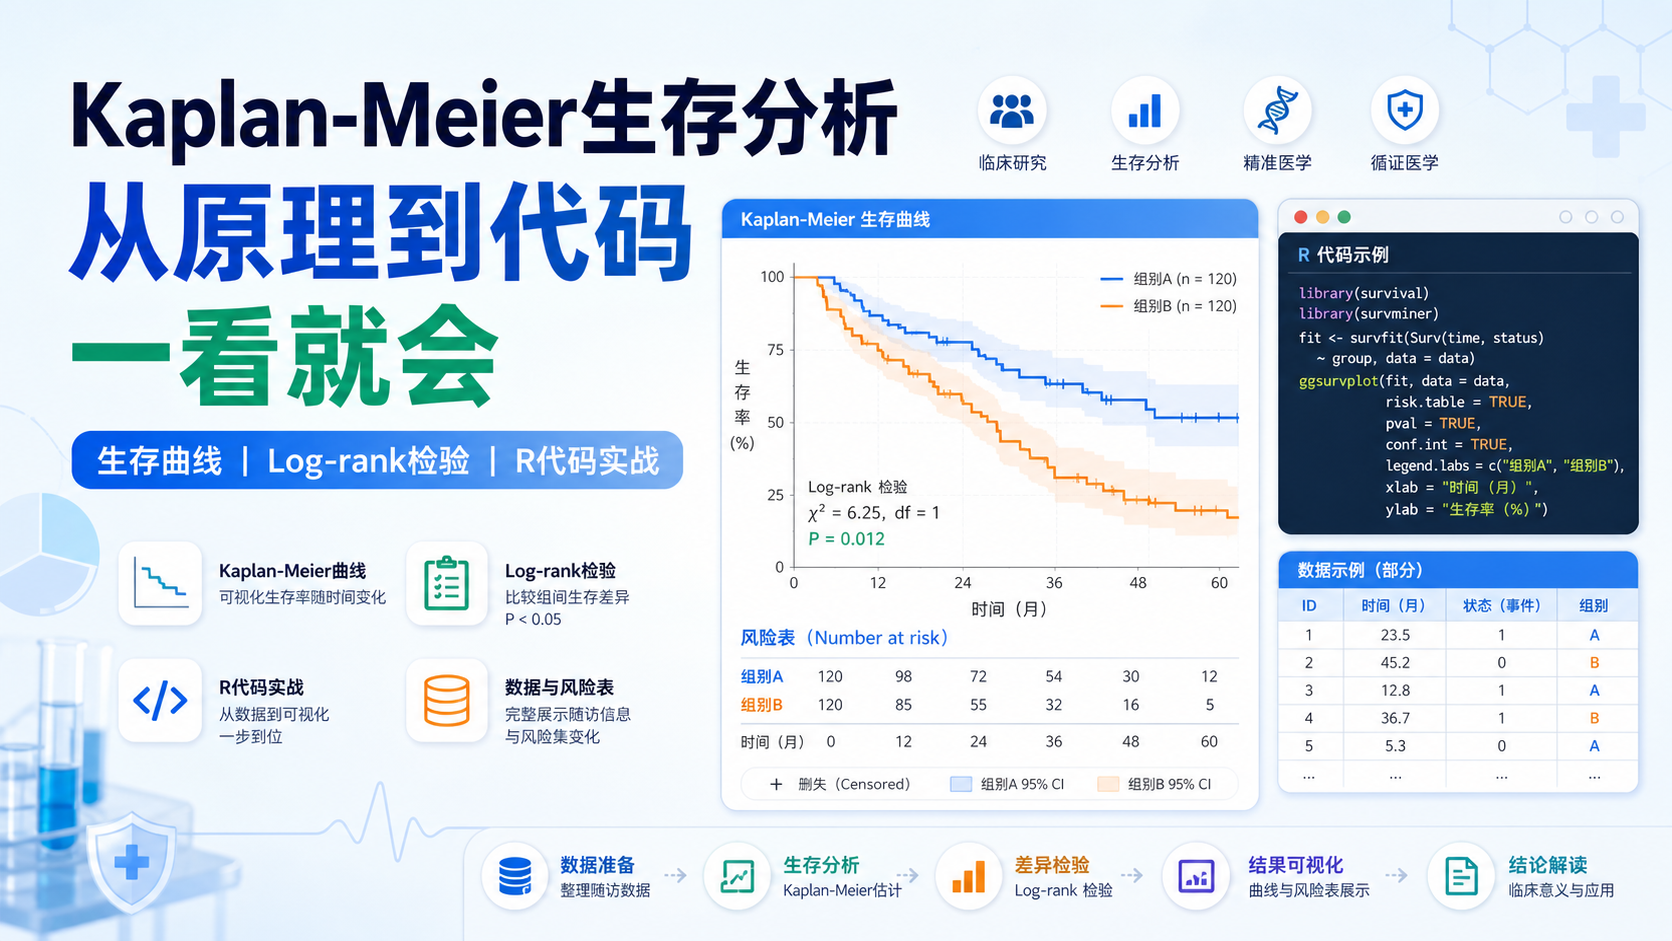
这张图通常包含以下信息:
- 生存曲线。
- p值。
- 置信区间。
- 风险表。
风险表很重要。 它能告诉读者每个时间点仍在随访的人数,能有效提升图形的可解释性和可信度。
5. 生存分析代码的常见错误与排查思路
5.1 最常见的3类问题
在实际操作中,错误通常不是出在算法,而是出在数据格式。
常见问题包括:
- 样本ID不一致,导致合并后大量缺失。
status编码错误,事件和删失混淆。- 生存时间单位不统一,天、月、年混用。
如果图能画出来,但结果异常,先检查数据结构,而不是急着改模型。
5.2 更稳妥的分析习惯
建议在正式分析前先做以下检查:
- 查看
head()和str()确认字段类型。 - 检查缺失值比例。
- 检查分组样本量是否过小。
- 确认时间单位是否一致。
这几步看似基础,但对保证结果可复现非常关键。
6. 在线数据库作为补充验证
6.1 UALCAN、GEPIA2和KM Plotter的作用
如果你想对自己的生存分析结果做交叉验证,可以借助在线数据库。常用工具包括UALCAN、GEPIA2和KM Plotter。
它们的优势是:
- 上手快。
- 适合快速验证单基因生存趋势。
- 便于和TCGA自建代码结果互相印证。
但在线数据库更适合初筛,不适合替代严谨的本地统计分析。 最终用于文章或汇报的数据,仍然建议用可追溯的代码流程完成。
6.2 代码分析和在线工具的组合策略
较稳妥的做法是:
- 先用R代码完成主分析。
- 再用在线数据库做独立验证。
- 最后整理成论文图和补充材料。
这样既能体现分析深度,也能提升结果的可信度。
总结Conclusion
生存分析代码的核心,不只是“会跑通”,而是把TCGA表达数据、临床信息、ROC、时间依赖ROC和KM曲线连成完整流程 。只要样本匹配正确、时间变量规范、分组逻辑清晰,就能得到结构完整、可发表的结果。
如果你希望把这套流程更快落地,减少数据整理和代码调试时间,可以直接借助解螺旋 的相关资源与工具支持,把更多精力放到结果解释和科研设计上。
- 引言Introduction
- 1. 生存分析前的准备工作
- 2. 诊断ROC分析:先看模型是否有区分能力
- 3. 时间依赖ROC:把随访时间纳入分析
- 4. KM曲线:验证高低表达组的生存差异
- 5. 生存分析代码的常见错误与排查思路
- 6. 在线数据库作为补充验证
- 总结Conclusion