17
 分享
引言Introduction
差异分析是生信文章最常见的起点,但很多人卡在数据整理、分组设计和代码报错上。真正影响结果的,不只是跑出火山图,而是从表达矩阵到统计检验的完整流程是否规范。 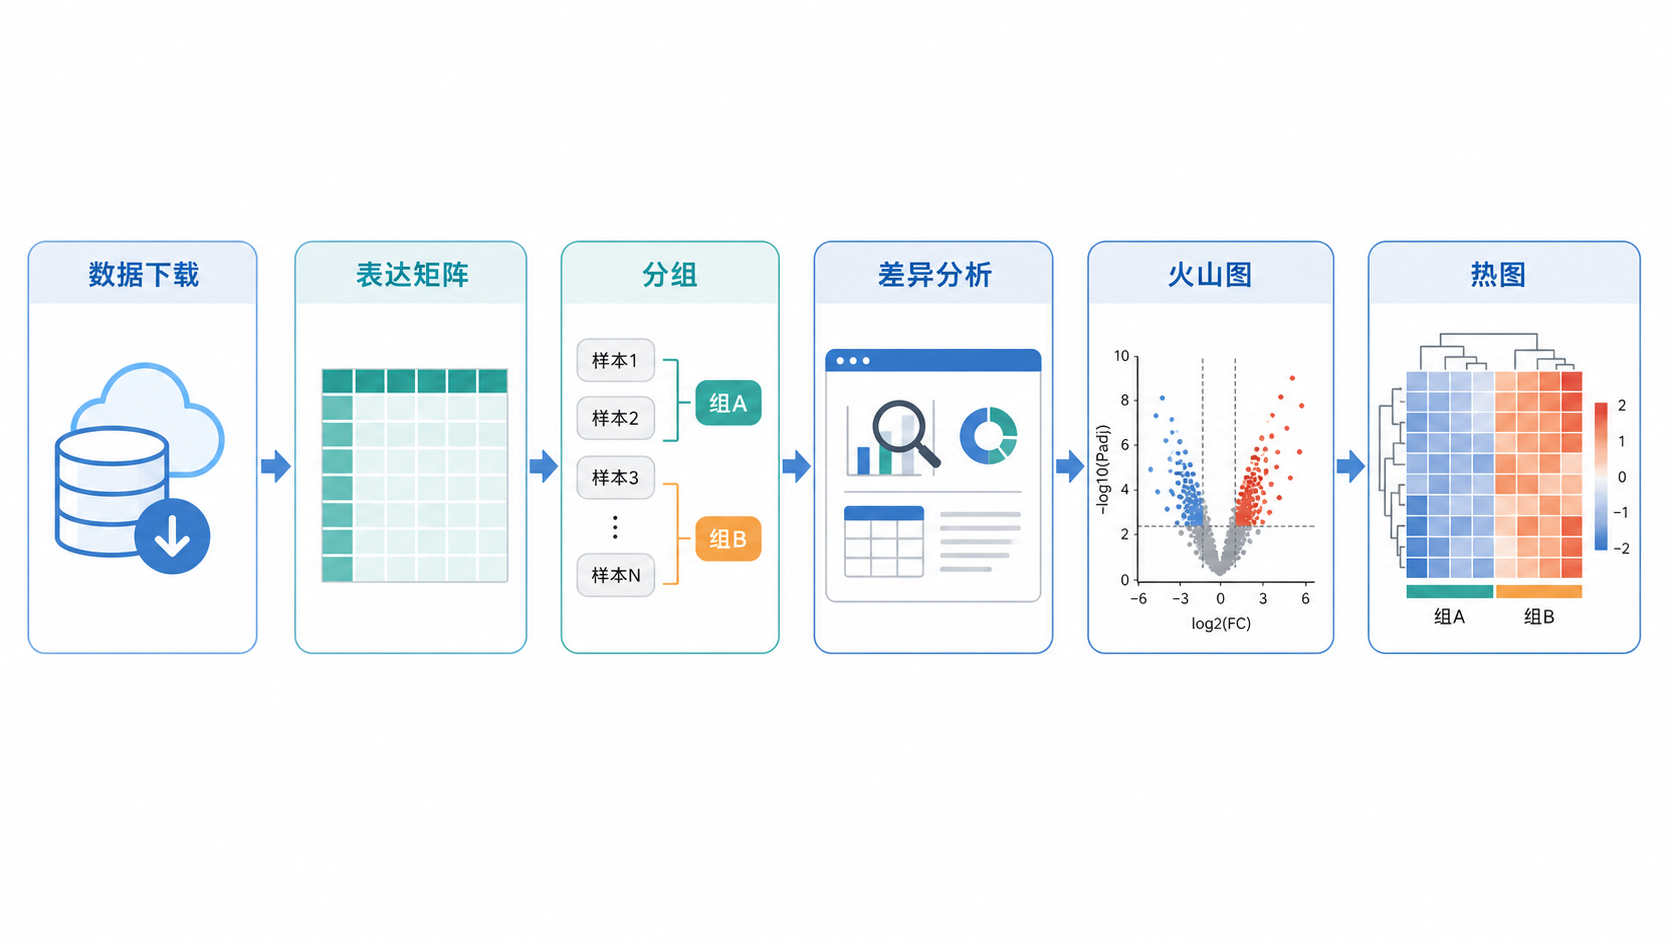
1.差异分析前,先把数据准备对
1.1 确认数据类型和输入格式
差异分析的第一步,不是写代码,而是确认数据来自哪里。常见数据包括芯片数据和测序数据。公开数据库如 GEO、TCGA,通常已经提供表达矩阵和分组信息,适合直接进入分析。
如果是单个数据集,重点是拿到表达矩阵、样本信息和分组变量。
如果是多个数据集,要先判断能否合并。对于同一注释平台的数据,可以合并后做批次效应处理。不同平台的数据,更稳妥的做法是先分别分析,再在结果层面整合。
1.2 先做质量控制,再谈差异
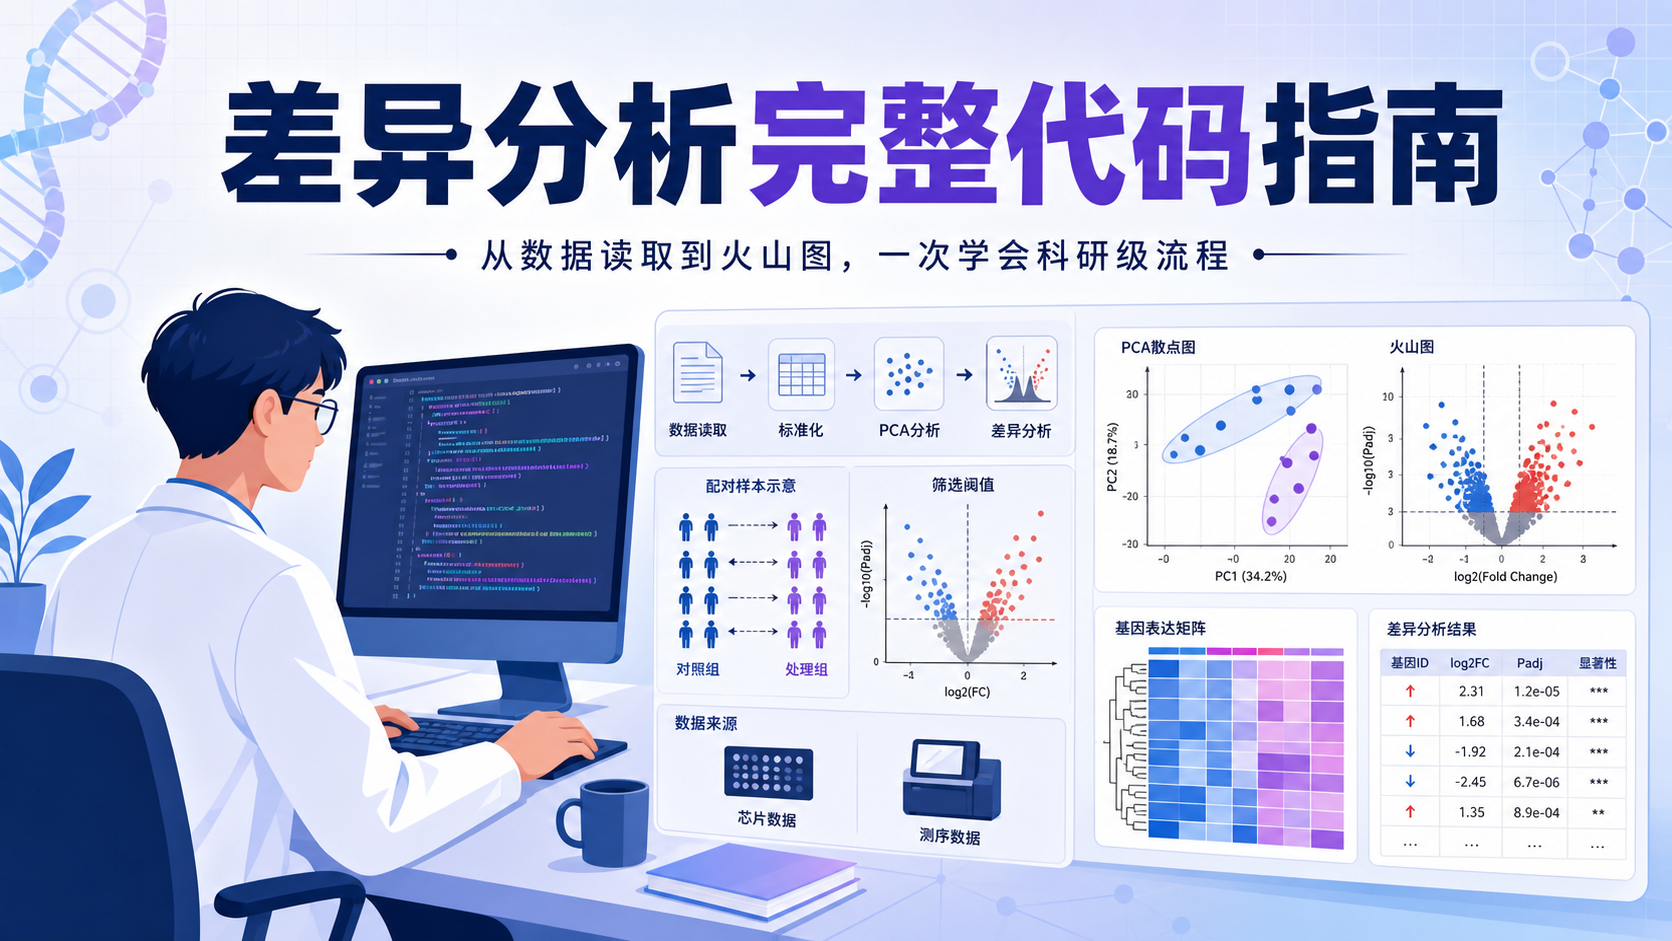
在进入差异分析前,必须先检查样本质量。常用方法是 PCA。它能帮助识别离群样本。若某个样本明显偏离同组中心,往往提示技术误差、样本污染或录入问题。
离群样本不处理,后面的差异基因列表很容易失真。
对于单细胞数据,UMAP 也常用于观察样本或细胞群的分布。对 bulk 数据而言,PCA 仍是最常用的第一道筛查。
1.3 统一命名和分组信息
代码开始前,先保证表达矩阵列名与样本分组表一一对应。常见错误包括:
- 样本名顺序不一致。
- 分组标签写法不统一。
- 表达矩阵中混入空值或重复基因名。
差异分析代码跑不通,很多时候不是算法错了,而是样本表没整理好。
2.差异分析Python代码的核心思路
2.1 Python适合做什么
在差异分析流程里,Python更适合做数据预处理、统计检验、结果整理和可视化。常见组合是:
pandas处理表格。numpy做数值计算。scipy.stats做统计检验。statsmodels做多重检验校正。matplotlib和seaborn出图。
如果你的目标是快速完成差异分析、筛出候选基因并形成可发表结果,Python完全够用。
2.2 差异分析的本质
本质上,差异分析是在比较两个或多个分组的表达分布是否存在显著差异。常见场景包括:
- 疾病组 vs 对照组。
- 药物处理组 vs 载体组。
- 高表达组 vs 低表达组。
- 多时间点比较。
对大多数生信文章而言,最常见的是两组比较。
若是多组问题,常先拆成二分组,或者使用适合多组的统计模型。
2.3 统计检验与阈值
对于表达矩阵,如果是标准化后的连续值,常见方法是:
- 正态分布近似时用 t 检验。
- 非正态分布时用 Mann-Whitney U 检验。
筛选差异基因时,通常结合两个指标:
P value或adjusted P value。log2 fold change。
常用阈值是:
adj.P < 0.05|log2FC| > 1
阈值不是固定标准,但一定要在文章方法中写清楚。
3.差异分析全流程Python代码实战
3.1 导入数据和整理分组
下面示例假设表达矩阵行为基因,列为样本,另有分组信息表。
import pandas as pd
import numpy as np
from scipy import stats
from statsmodels.stats.multitest import multipletests
import matplotlib.pyplot as plt
import seaborn as sns

# 读取表达矩阵
expr = pd.read_csv("expression_matrix.csv", index_col=0)

# 读取分组信息
group = pd.read_csv("group_info.csv")
group = group.set_index("sample")

# 确保样本顺序一致
expr = expr[group.index]
这一步的关键是对齐样本顺序。
顺序不一致会直接导致分组错配,属于最常见错误之一。
3.2 计算每个基因的差异结果
以下以两组比较为例。设 group 中分组列名为 status,分为 case 和 control。
results = []

case_samples = group[group["status"] == "case"].index
control_samples = group[group["status"] == "control"].index

for gene in expr.index:
    case_values = expr.loc[gene, case_samples].dropna()
    control_values = expr.loc[gene, control_samples].dropna()

    # 若样本数过少,可跳过
    if len(case_values) < 2 or len(control_values) < 2:
        continue

    # Welch t-test
    t_stat, p_value = stats.ttest_ind(case_values, control_values, equal_var=False)

    mean_case = case_values.mean()
    mean_control = control_values.mean()

    # 避免除零
    fc = (mean_case + 1e-8) / (mean_control + 1e-8)
    log2fc = np.log2(fc)

    results.append([gene, mean_case, mean_control, log2fc, p_value])

res = pd.DataFrame(results, columns=["gene", "mean_case", "mean_control", "log2FC", "pvalue"])
这里用的是 Welch t 检验,更适合方差不齐的情况。
如果表达数据明显偏态,也可以替换成非参数检验。
3.3 多重检验校正
差异分析的基因数量通常很多,单纯看原始 P value 会带来较高假阳性。必须做多重检验校正。
res["adj_pvalue"] = multipletests(res["pvalue"], method="fdr_bh")[1]
FDR 校正是生信中最常见的控制假阳性方法之一。
不做校正的差异结果,通常不适合直接用于文章。
3.4 筛选显著差异基因
res["regulate"] = "stable"
res.loc[(res["adj_pvalue"] < 0.05) & (res["log2FC"] > 1), "regulate"] = "up"
res.loc[(res["adj_pvalue"] < 0.05) & (res["log2FC"] < -1), "regulate"] = "down"

deg = res[res["regulate"] != "stable"]
deg.to_csv("DEG_results.csv", index=False)
建议同时保留全部基因结果和筛选后的差异基因表。
这样后续可以继续做火山图、热图、富集分析和网络分析。
4.常用可视化:火山图和热图
4.1 火山图
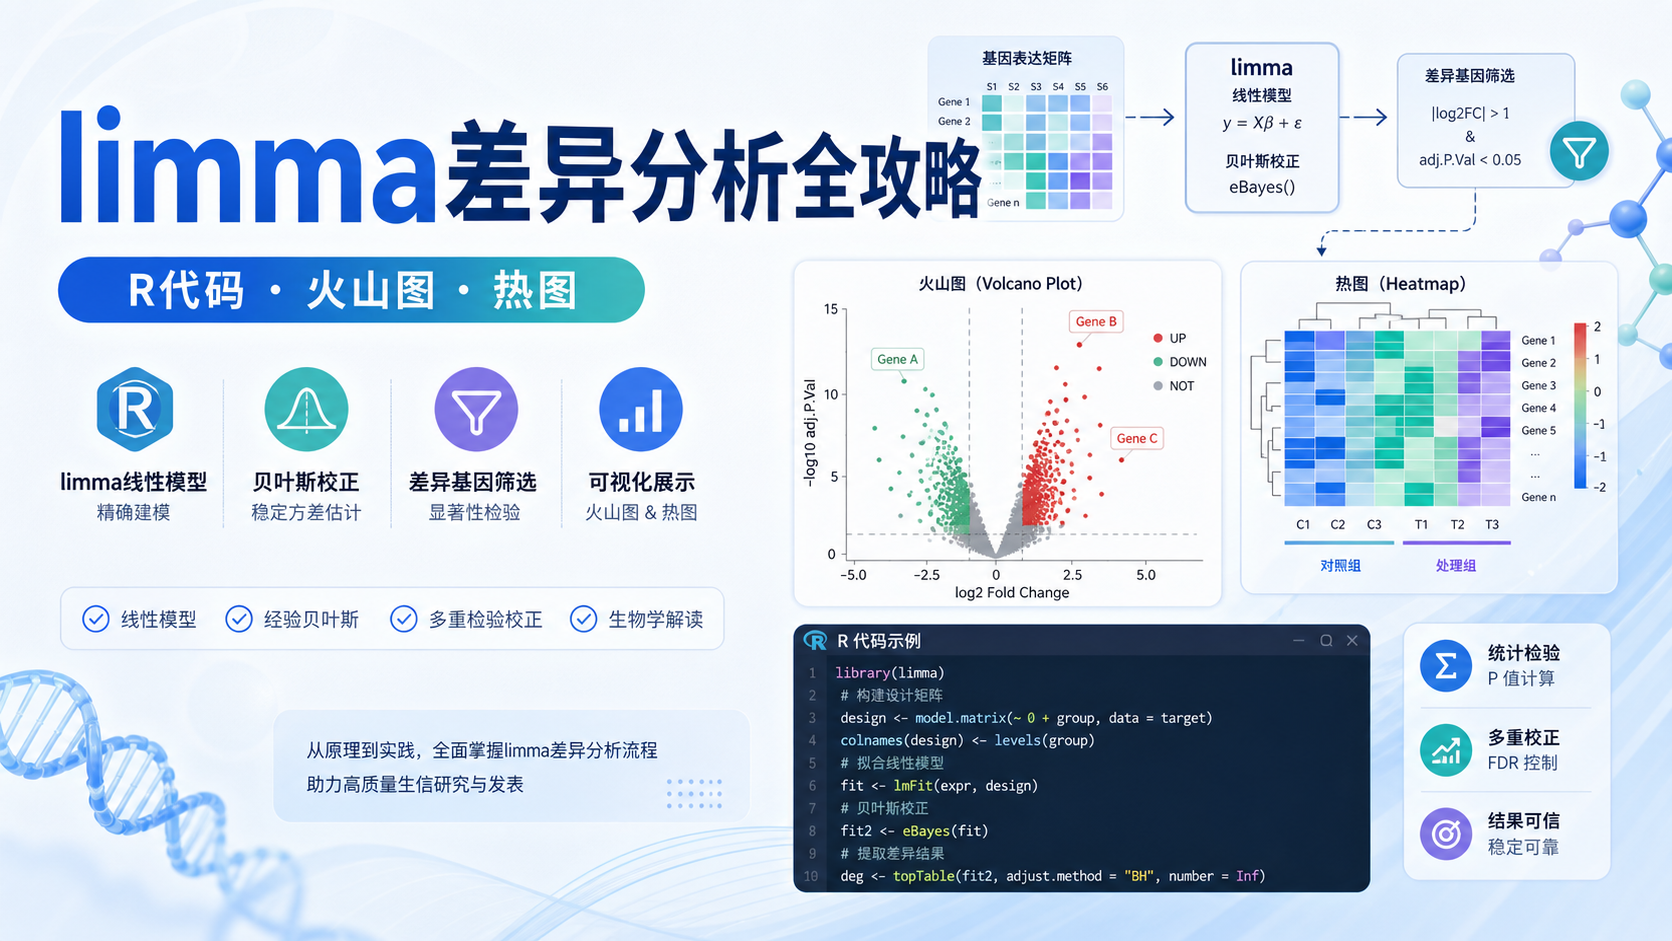
火山图是差异分析的标准展示方式。它能快速显示上调、下调和无显著变化的基因。
plt.figure(figsize=(8, 6))
sns.scatterplot(
    data=res,
    x="log2FC",
    y=-np.log10(res["adj_pvalue"] + 1e-300),
    hue="regulate",
    palette={"up": "red", "down": "blue", "stable": "gray"},
    s=18,
    edgecolor=None
)
plt.axvline(1, linestyle="--", color="black", linewidth=1)
plt.axvline(-1, linestyle="--", color="black", linewidth=1)
plt.axhline(-np.log10(0.05), linestyle="--", color="black", linewidth=1)
plt.xlabel("log2FC")
plt.ylabel("-log10(adj p-value)")
plt.legend(title="")
plt.tight_layout()
plt.show()
火山图的重点不是颜色好不好看,而是阈值是否清晰、标注是否规范。
4.2 热图
热图适合展示前若干个差异基因在样本中的表达模式。
top_genes = deg.sort_values("adj_pvalue").head(30)["gene"]
heat_data = expr.loc[top_genes]

# 简单标准化
heat_data = heat_data.sub(heat_data.mean(axis=1), axis=0).div(heat_data.std(axis=1) + 1e-8, axis=0)

sample_colors = group["status"].map({"case": "red", "control": "blue"})

sns.clustermap(
    heat_data,
    cmap="vlag",
    col_colors=sample_colors,
    figsize=(10, 10)
)
plt.show()
热图更适合回答两个问题:
- 差异基因能否区分样本分组。
- 上下调模式是否具有一致性。
5.实战技巧:让差异分析更稳、更像论文
5.1 先判断数据分布
不是所有表达矩阵都适合直接做 t 检验。
如果是 RNA-seq 原始计数,通常应先做标准化或转换,再进入统计检验。若使用公开数据库提供的表达矩阵,要先确认它是否已经标准化。
差异分析前,最重要的是弄清数据到底是“原始计数”还是“处理后矩阵”。
5.2 保留分析可追溯性
建议每一步都保存中间文件:
- 原始表达矩阵。
- 清洗后的表达矩阵。
- 分组信息表。
- 全基因差异结果。
- 筛选后的 DEG 表。
这样做的好处是,后续修改阈值时不必重跑全部流程。
科研里最怕的不是慢,而是结果无法复现。
5.3 不要只看一张图
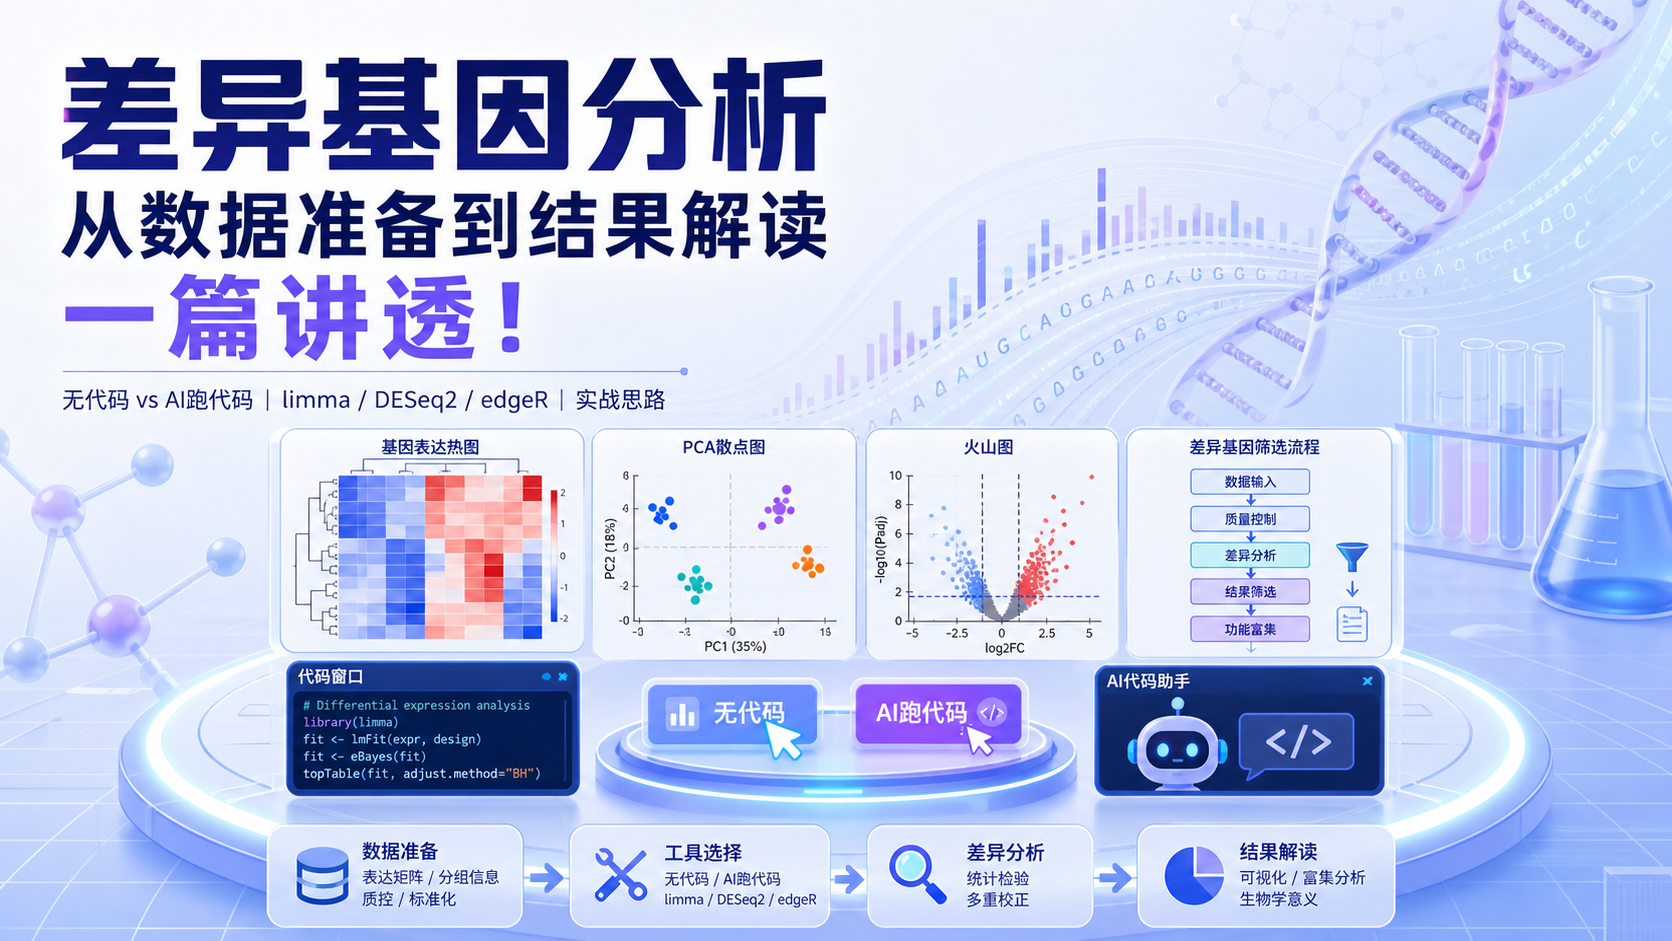
规范的差异分析至少要包含:
- PCA 或 UMAP 质量控制。
- 火山图。
- 热图。
- 差异基因列表。
如果要进一步提高文章质量,还可以接功能富集分析、互作网络分析和临床建模。
这也是生信文章从“数据展示”走向“机制解释”的关键一步。
5.4 多数据集时先想清楚整合策略
多个数据集并不总是适合先合并。
同一平台、同一注释体系、批次可控时,可以考虑合并后校正。
若平台不同、注释不同,常见策略是分别分析,再在差异基因或富集结果层面整合。
平台一致,才能谈批次校正。平台不一致,先合并往往会引入额外噪音。
6.从代码到文章,差异分析要服务于后续研究
6.1 差异结果只是起点
差异分析的目的,不是只得到一份基因列表,而是为后续分析提供候选分子。常见延伸路径包括:
- GO 和 KEGG 富集。
- PPI 网络分析。
- 转录因子或 miRNA 调控分析。
- 预后模型或诊断模型构建。
一个能发表的生信故事,通常不是止步于差异基因,而是继续回答“为什么会变”和“是否有临床价值”。
6.2 让代码真正服务科研问题
如果研究的是疾病机制,差异分析应围绕疾病组和对照组设计。
如果研究的是治疗反应,应围绕响应组和非响应组设计。
如果研究的是时间过程,应围绕时间点变化设计。
这样才能把代码和科学问题真正对应起来。
没有明确问题的差异分析,只是在跑统计,而不是在做研究。
6.3 用解螺旋提升分析效率
对于需要快速完成差异分析、标准化出图、整合后续富集流程的科研场景,可以借助成熟工具减少重复劳动。比如通过解螺旋的相关产品和服务,把数据清洗、结果整理和图表输出串联起来,能更快把注意力放回研究设计本身。当流程被规范化,差异分析就不再是报错和返工,而是可复现、可扩展的科研起点。
总结Conclusion
差异分析是生信研究最基础,也最关键的一步。它的核心不只是写出 Python 代码,而是把数据准备、质量控制、统计检验、多重校正和结果可视化串成完整流程。只有流程规范,差异基因才有可信度,后续富集、网络和建模才站得住。 如果你希望更高效地完成这类分析,并把结果快速转化为可发表图表与结论,可以进一步了解解螺旋,借助成熟方案提升科研效率。
- 引言Introduction
- 1.差异分析前,先把数据准备对
- 2.差异分析Python代码的核心思路
- 3.差异分析全流程Python代码实战
- 4.常用可视化:火山图和热图
- 5.实战技巧:让差异分析更稳、更像论文
- 6.从代码到文章,差异分析要服务于后续研究
- 总结Conclusion