13
 分享
引言Introduction
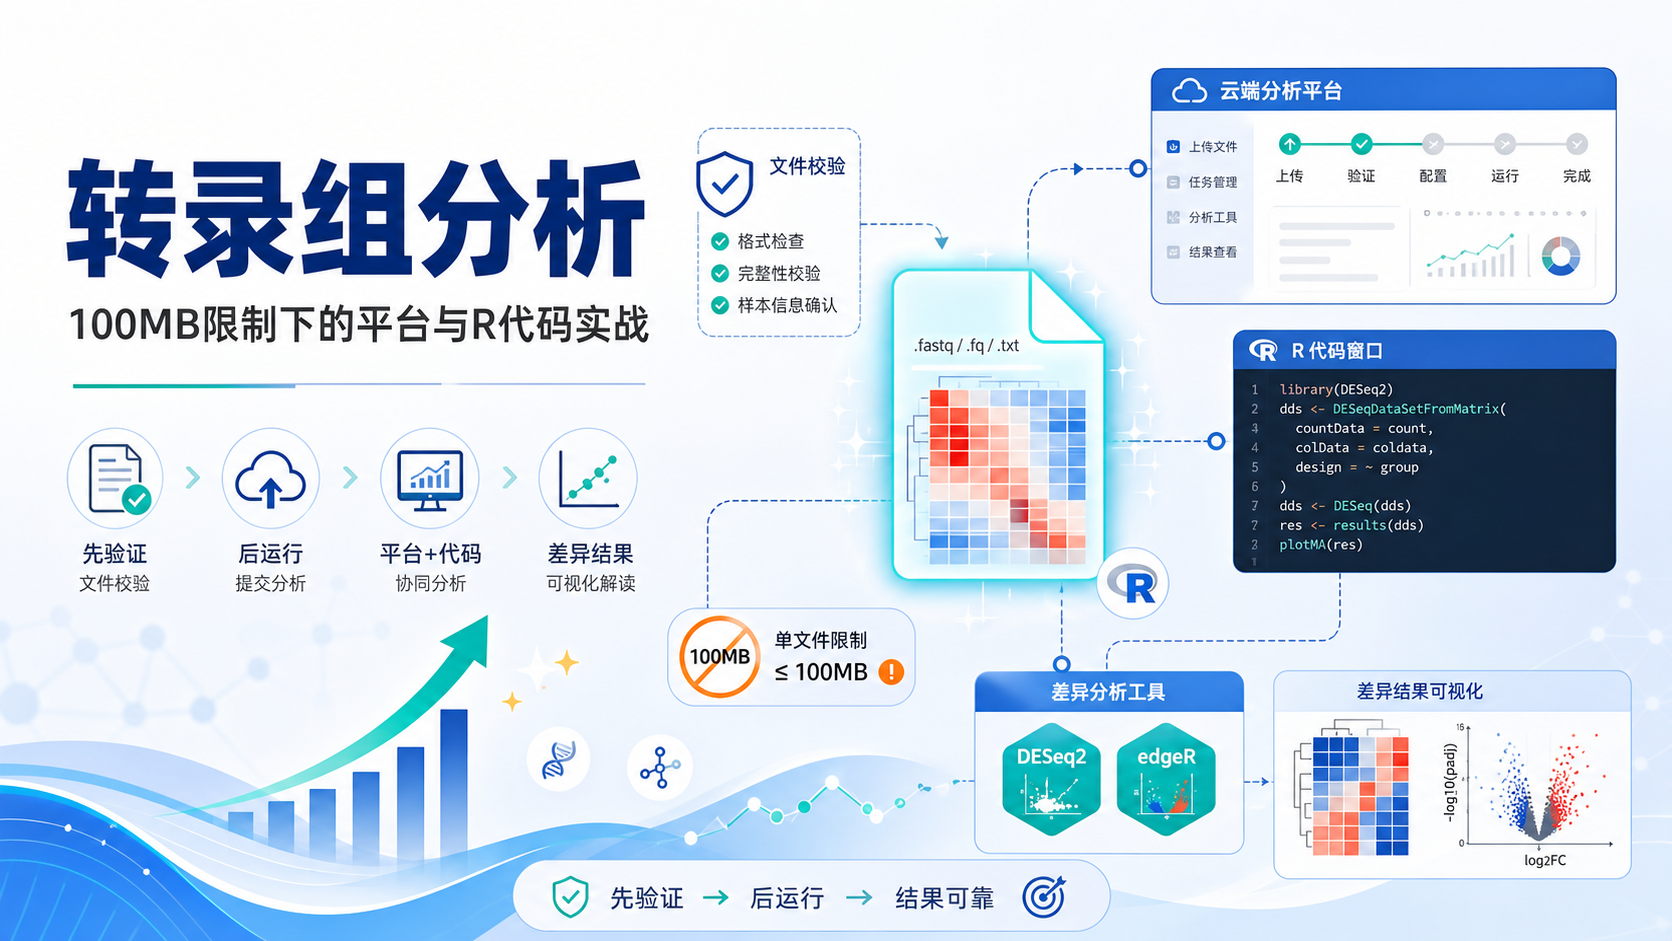
做转录组差异分析时,很多人不是卡在统计方法,而是卡在平台上传。表达矩阵动辄几十MB到上百MB,一旦超过100MB,任务就无法提交。本文直接给出仙桃平台与R代码两种实战路径,帮助你把差异分析顺利跑起来。

1. 为什么100MB限制会成为转录组分析的第一道门槛
1.1 大文件不是“导不进去”,而是“先要规范再上传”
转录组差异分析常见输入是表达矩阵和样本信息。矩阵一大,最常见的问题不是算不出来,而是平台上传验证不过 。仙桃平台对表达矩阵上传大小有明确限制,超过100MB就无法上传 。这对高通量项目很常见,尤其是基因数多、样本数多、保留小数位较多时。
因此,真正的难点不只是文件大小,而是如何在不破坏数据结构的前提下,让文件符合平台要求。常见可行思路包括:
- 先检查矩阵是否含有冗余列。
- 确认表达值格式是否统一。
- 样本信息文件是否命名规范。
- 先做数据整理,再提交任务。
如果格式不对,哪怕文件没超过100MB,也可能无法通过验证。
1.2 仙桃平台的核心逻辑是“先验证,后运行”
仙桃平台不是上传即跑,而是先进行数据验证。根据知识库信息,表达矩阵和样本信息需要满足指定格式,验证通过后才会进入分析流程。这里最关键的是两点。
第一,表达矩阵格式。
第一列必须是基因ID,后面每列对应一个样本,单元格里填表达值。
第二,样本信息文件。
样本信息文件要包含sample名称和分组信息。
只有验证绿灯通过,才能点击确认提交任务。服务器端运行后,系统会保留历史记录,任务完成后可查看差异基因结果,并下载报告。系统最多列出60个基因,这意味着结果展示是“精简版”,完整结果仍应以报告下载为准。
2. 仙桃平台实战:从文件准备到提交任务
2.1 表达矩阵和样本信息文件怎么准备
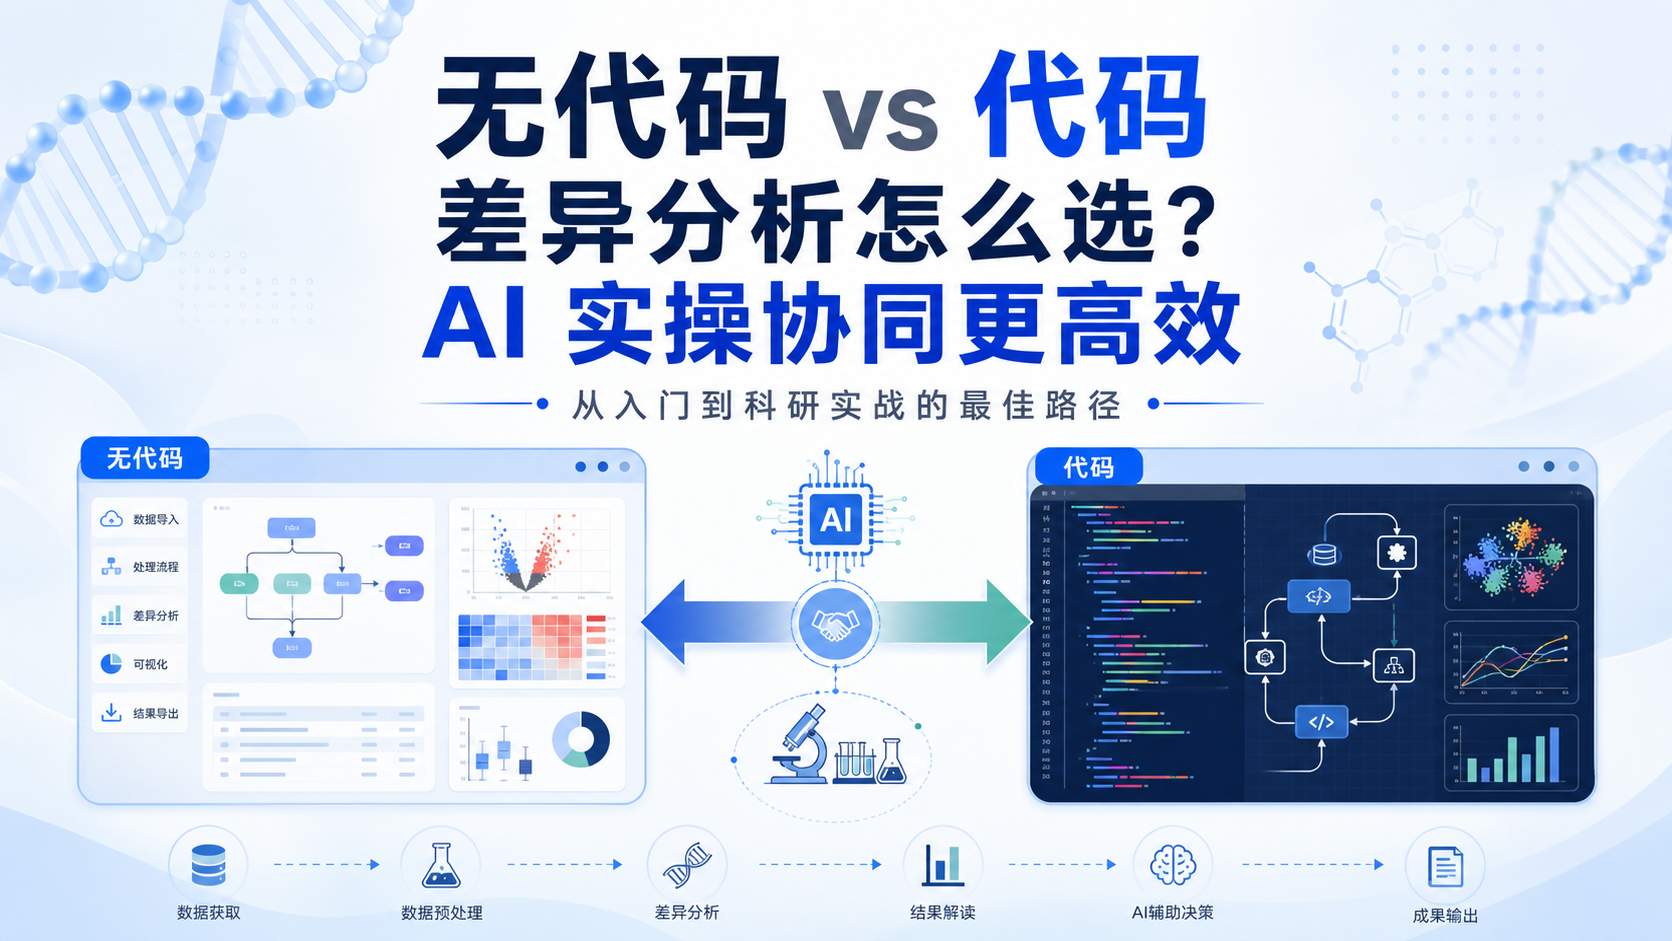
仙桃平台支持两种方式演示。第一种是点鼠标的无代码方式 。第二种是用AI跑代码的方式 。对多数医学生和科研人员来说,这两种方式可以互补。前者适合快速上手,后者适合批量化和可复现分析。
上传前要先确认文件结构。表达矩阵建议满足以下条件:
- 第一列为基因ID。
- 后续每列为一个样本。
- 表达值格式统一。
- 列名与样本信息中的sample名称一致。
样本信息文件建议至少包含:
- sample名称。
- 分组信息,如control与case。
- 分组命名保持前后一致。
样本名不一致,是差异分析失败的高频原因之一。
2.2 上传前先做一次格式自检
在正式提交前,先做一次人工核对,能节省大量返工时间。建议按下面顺序检查:
- 是否存在空列或空行。
- 基因ID是否重复。
- 分组信息是否完整。
- sample名称是否大小写一致。
- 文件大小是否超过100MB。
如果矩阵接近100MB,优先检查是否存在不必要的注释列、冗余说明列或格式残留。上传失败后再回头改,往往比事前核对更耗时。
平台验证通过,不代表分析一定合理,但验证不通过,分析一定无法开始。
2.3 提交任务后的结果查看重点
任务提交后,服务器端会记录运行历史。分析完成后,用户可以查看差异基因结果,并下载报告。由于系统最多列出60个基因,页面上通常只能看到部分结果,因此要重点关注:
- 上调基因和下调基因的方向。
- P值和校正后P值。
- fold change是否达到阈值。
- 报告中的筛选条件是否明确。
这里的思路不是只看排名前几的基因,而是判断结果是否与实验设计一致。差异分析的价值,在于解释分组之间的生物学差异,而不是只看表格是否“漂亮”。
3. 用R代码补足平台限制:DESeq2与edgeR的实战路径
3.1 两类常见转录组差异分析代码思路
根据知识库,课程中示范了两条主线。第一条是DESeq2差异分析实战 ,第二条是edgeR差异分析实战 。这两者都属于RNA-seq差异分析中的经典工具,适合基于原始counts数据进行建模。
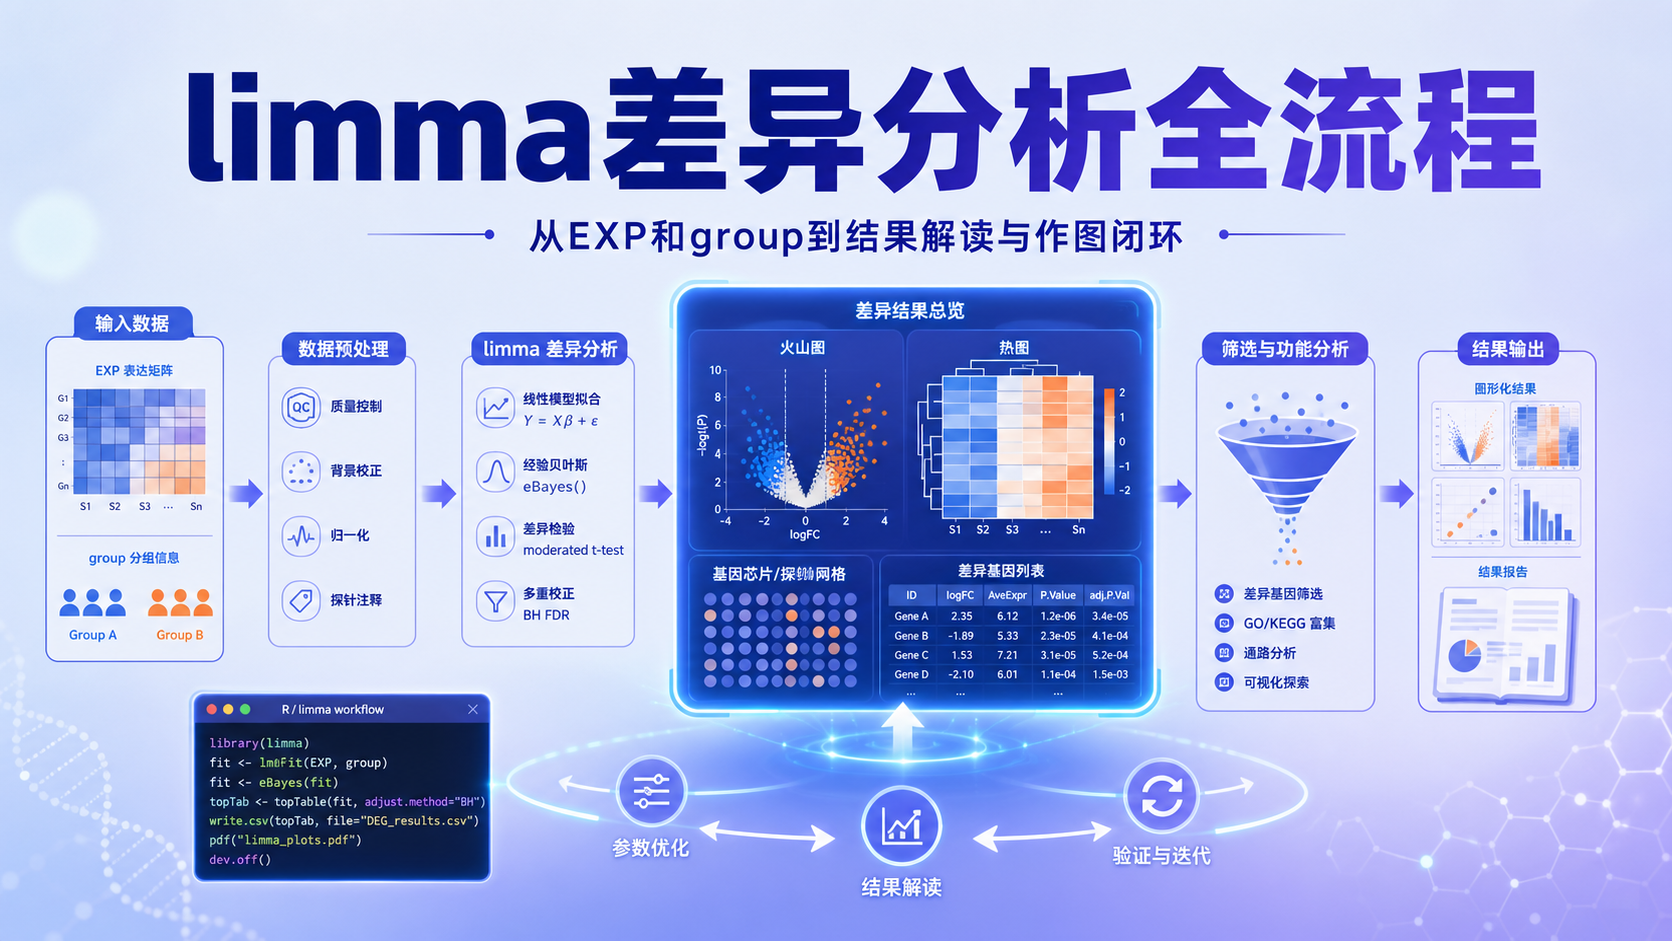
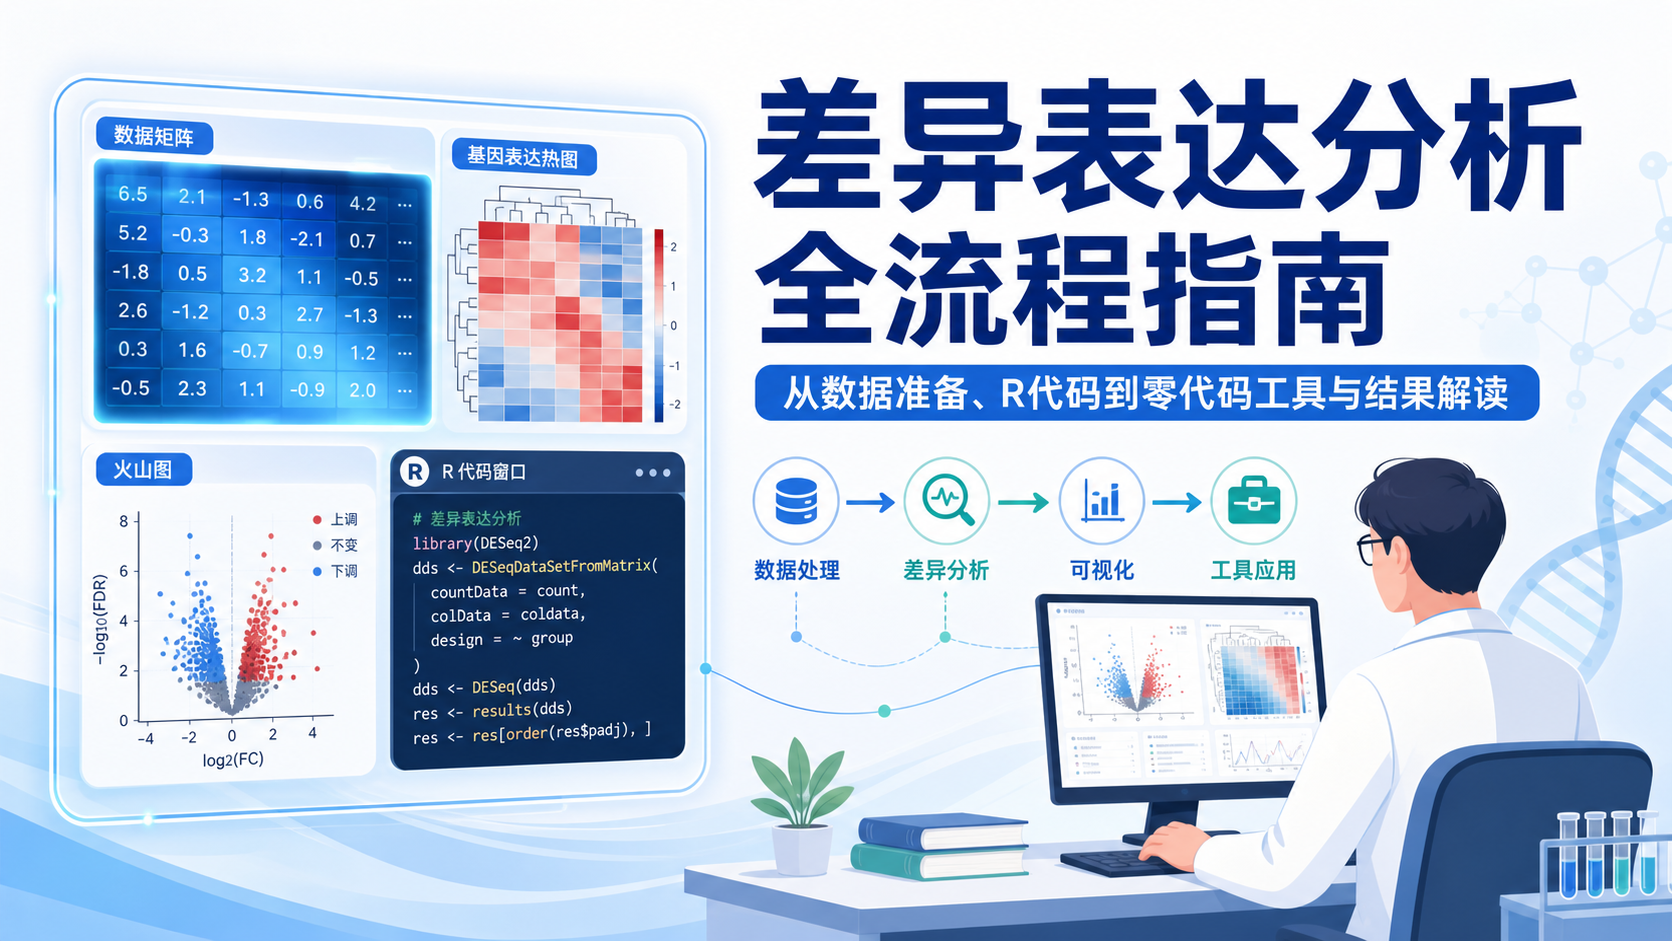
DESeq2流程的核心步骤包括:
- 读取counts矩阵。
- 创建样本信息表colData。
- 构建DESeqDataSet对象。
- 运行DESeq主函数。
- 提取results结果。
- 转换为数据框并保存。
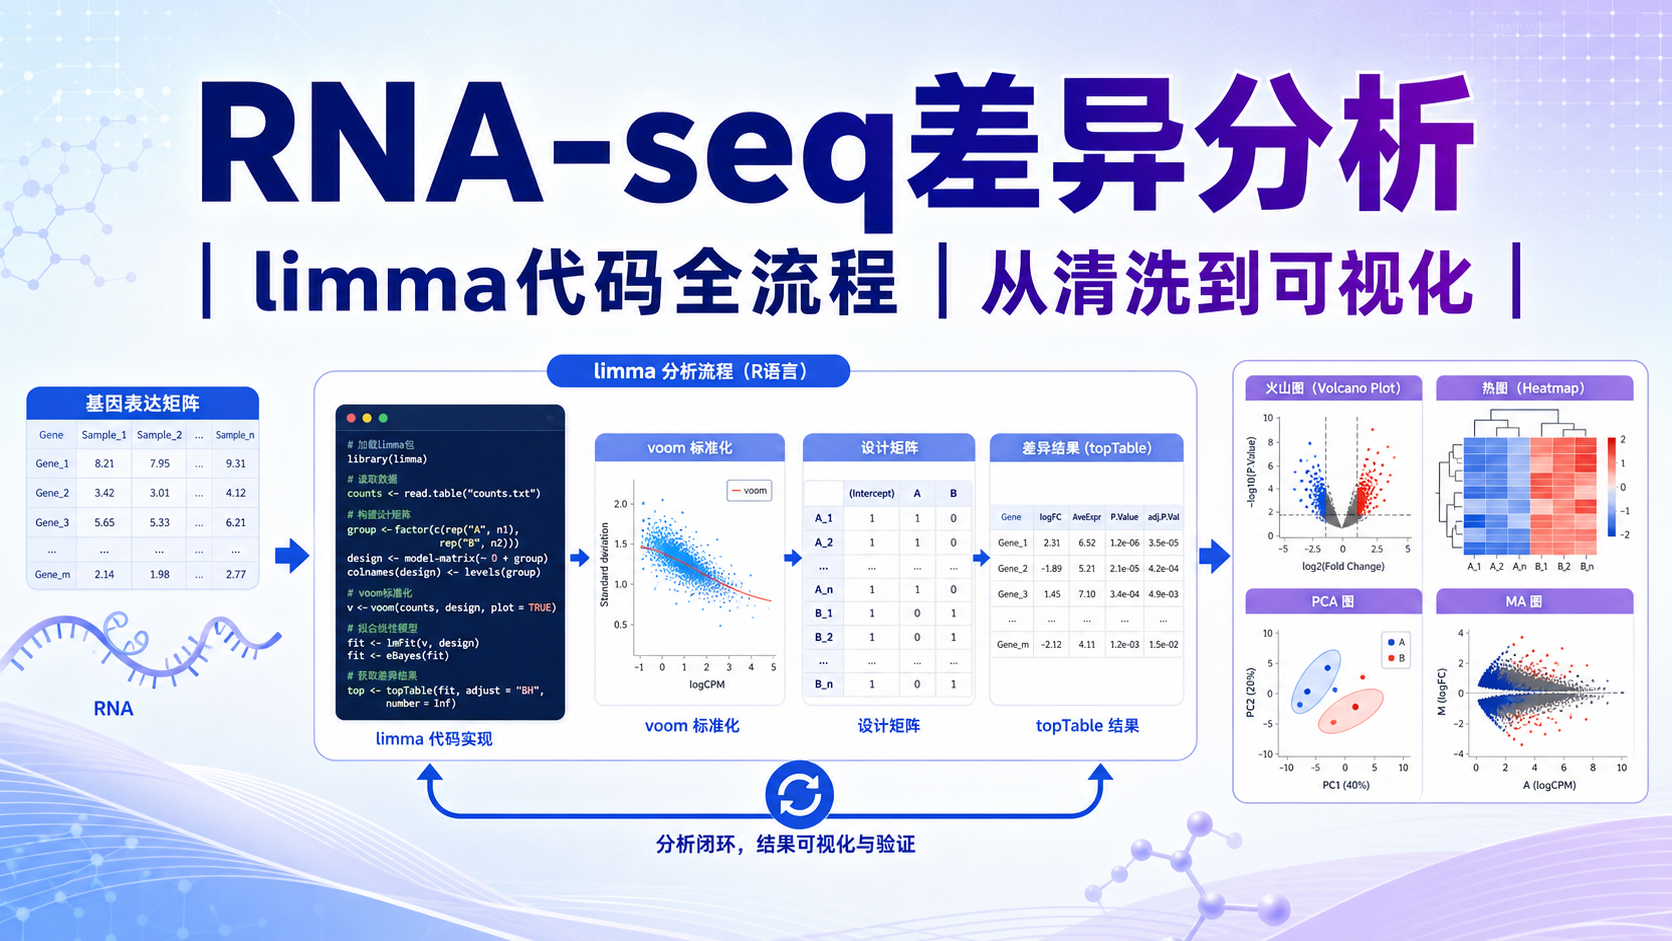
edgeR流程则包括:
- 读取原始表达矩阵。
- 创建group分组信息。
- 构建DGEList对象。
- 进行低表达过滤。
- 计算标准化因子。
- 估计离散度并做显著性检验。
- 用topTags导出结果。
如果你想要稳定、标准、可复现的转录组差异分析代码,DESeq2和edgeR都属于一线选择。
3.2 DESeq2的关键代码步骤,适合标准两组比较
DESeq2教程中,样本设置采用control和case两组。其核心是先读取原始counts,再定义分组变量condition,最后通过DESeqDataSetFromMatrix构建对象。
一个标准流程的逻辑是:
- 读取表达矩阵。
- 建立样本分组表。
- 设置因子水平。
- 运行差异分析。
- 导出结果表。
- 根据
p < 0.05和|log2FC| > 2筛选差异基因。
这一类代码的优势是结构清楚,适合初学者理解统计流程,也便于后续写进方法学部分。对于需要快速复现分析、并保留完整流程记录的项目,DESeq2非常合适。
3.3 edgeR更强调过滤和离散度估计
edgeR在实战中同样常用,尤其适合对低表达基因进行过滤、标准化和离散度建模。课程提纲中提到,edgeR分析会先创建DGEList对象,再进行calcNormFactors标准化,随后estimateDispersion计算离散度,最后通过显著性检验获得P值。
这套流程的重点是:
- 先过滤低表达基因,减少噪音。
- 再计算标准化因子,保证样本间可比。
- 最后输出完整结果,用
topTags(n = )查看所有基因。
edgeR和DESeq2没有绝对优劣,更多是工作流偏好和项目习惯问题。 课程内容也指出,两者结果重叠性通常较高,常见可达80%以上。
4. 如何让分析既能跑通,又便于写进论文和报告
4.1 结果解读不能只看显著性
差异分析不是只找“显著基因”,更重要的是理解每一列信息。知识库中提到,结果表通常包含:
- 基因ID。
- log2 fold change。
- cpm或baseMean等表达量指标。
- P值。
- 校正后的P值。
其中,log2 fold change决定变化方向和幅度。P值反映统计显著性,校正后P值更适合多重检验场景。真正用于论文汇报时,应同时看效应量和显著性,而不是只盯着P值。
4.2 筛选条件要和研究目的一致
课程示例中常用的筛选标准是:
- P值小于0.05。
- fold change绝对值大于2。
这是一套相对常见的初筛标准,但并不是固定模板。不同项目中,可以根据样本量、研究目标和测序深度做调整。比如,样本少时应更谨慎,避免把偶然波动当成生物学变化。
建议在报告中明确写出:
- 使用的工具版本。
- 分组方式。
- 过滤阈值。
- 统计检验方法。
- 多重校正策略。
方法写清楚,结果才可复查,论文才更有说服力。
4.3 平台结果与代码结果如何互相印证
仙桃平台适合快速提交、查看结果和下载报告。R代码更适合深入分析、批量处理和论文复现。两者并不是替代关系,而是互补关系。
实践中可以这样配合:
- 先用平台快速验证文件与分组设计。
- 再用R代码做精细化分析。
- 最后用结果交叉核对关键差异基因。
这种方式尤其适合科研人员和医学生。前期避免格式错误,后期保证结果可解释。当平台上传受限时,R代码就是最稳妥的备用方案。
5. 面对100MB限制,最有效的解决策略是什么
5.1 先排查文件结构,再决定用平台还是代码
很多人一遇到上传失败,就急着压缩文件或反复重传。更有效的办法,是先判断问题来源。若是格式问题,压缩没有意义。若是文件确实过大,则需要考虑是否拆分检查、精简无效信息,或转用代码分析。
实战上建议按以下顺序处理:
- 核对矩阵格式。
- 核对样本信息。
- 确认大小是否超过100MB。
- 先验证再提交。
- 必要时切换到R代码工作流。
5.2 用解螺旋产品提升效率
如果你希望更快完成从上传、验证到结果解读的整个流程,解螺旋 可以帮助你把课程、实战思路和分析路径串起来。对于经常需要处理转录组差异分析代码的医学生、医生和科研人员来说,这类工具的价值不只是“会跑”,而是少走弯路、减少格式错误、缩短分析周期 。当你被100MB限制卡住时,先用规范流程和可复现代码解决问题,再结合解螺旋的学习资源,会更稳、更快。
总结Conclusion
转录组差异分析真正的难点,往往不是统计模型,而是文件准备、格式验证和平台限制。仙桃平台要求表达矩阵和样本信息严格匹配,且表达矩阵超过100MB无法上传。解决这类问题,最有效的方法是先规范数据,再选择平台或R代码路径。
如果你要快速上手,可以先用仙桃平台验证。
如果你要批量分析和论文复现,DESeq2和edgeR的转录组差异分析代码更可靠。
想进一步系统掌握这套流程,建议结合解螺旋 的课程与实战资源,把上传、分析、解读一步步跑通。
- 引言Introduction
- 1. 为什么100MB限制会成为转录组分析的第一道门槛
- 2. 仙桃平台实战:从文件准备到提交任务
- 3. 用R代码补足平台限制:DESeq2与edgeR的实战路径
- 4. 如何让分析既能跑通,又便于写进论文和报告
- 5. 面对100MB限制,最有效的解决策略是什么
- 总结Conclusion