

 13
 分享

引言Introduction
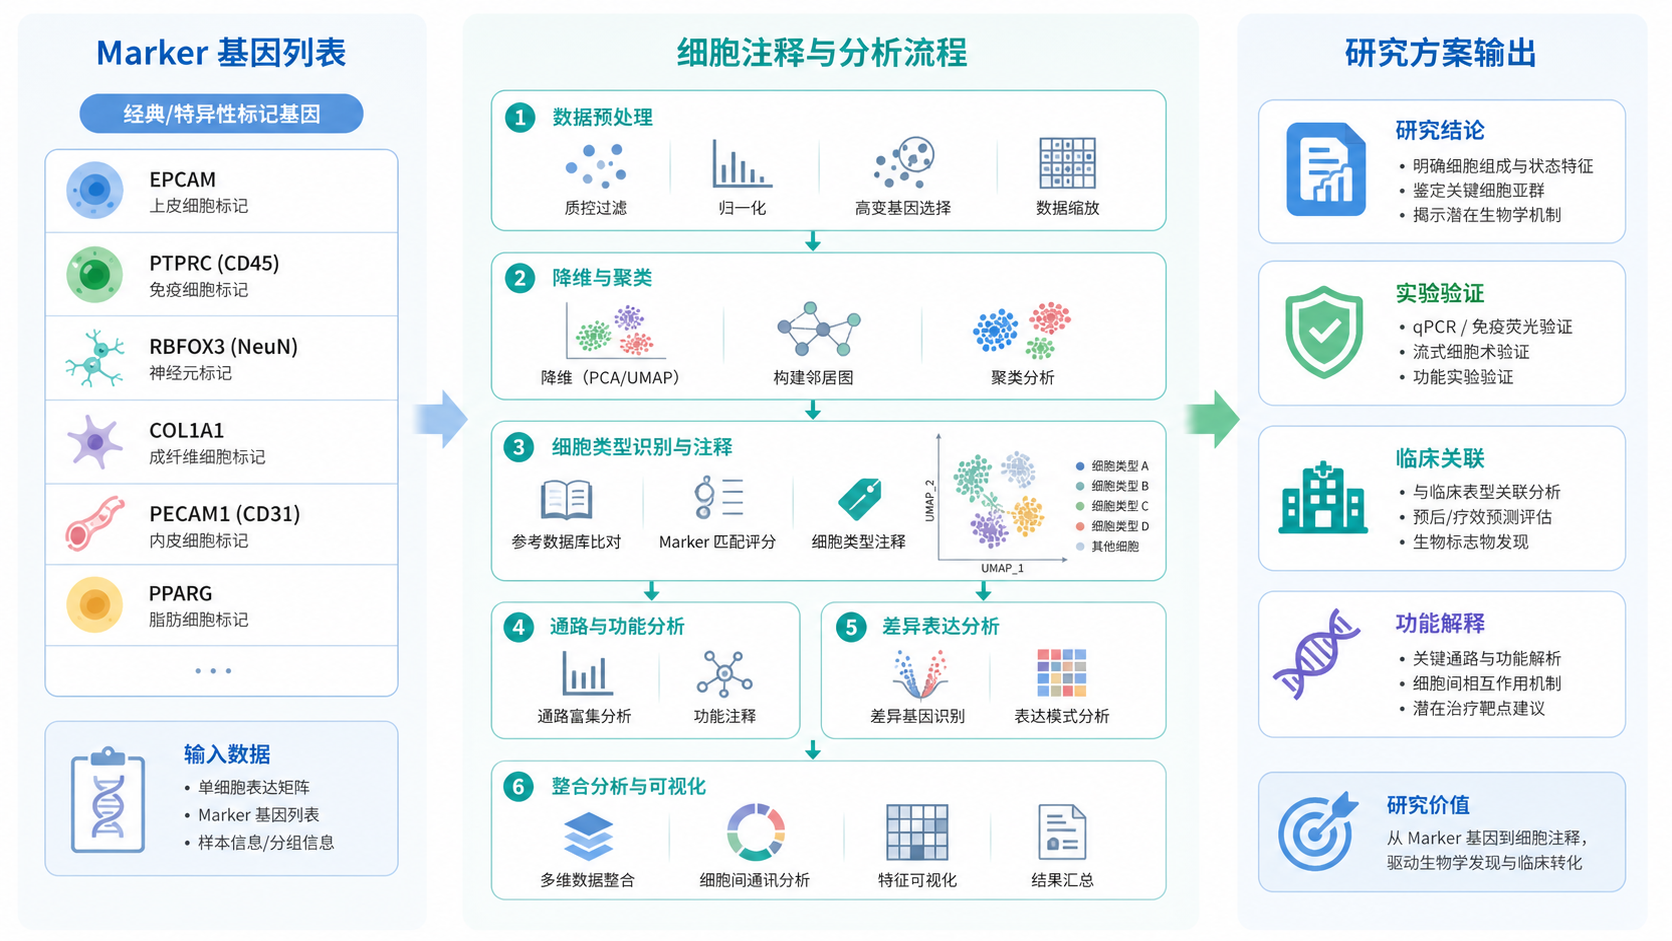
标记基因注释不是“找几个高表达基因”这么简单。真正的难点在于,结果能否解释细胞身份,能否支撑后续研究方案,能否从单次分析走向可复用流程。WorkBuddy+标记基因注释的价值,正是在于把零散结果整理成可执行的科研路径。
1. 标记基因注释为什么总卡在“结果有了,研究没跟上”
1.1 只有基因列表,不等于完成注释
很多单细胞研究会先得到一批差异基因,再依据经典marker进行细胞类型判断。但问题在于,marker列表本身只是证据,不是结论 。如果没有结合表达强度、细胞群特异性、组织背景和文献证据,注释很容易停留在经验判断。
尤其在异质性强的肿瘤、炎症或发育样本中,单个marker往往不够稳定。比如同一种细胞可能在不同状态下出现不同表达谱,传统“对照一个marker定身份”的方式会明显受限。
1.2 新手最缺的是“下一步怎么做”
很多初学者在完成聚类、找marker之后会遇到同样的问题。知道这些基因是什么,不等于知道后续该做什么。
常见断点包括:
- 该优先验证哪些marker。
- 该补做哪些亚群分析。
- 该如何从注释结果延伸到机制假设。
- 该如何组织成一条完整研究链。
这也是标记基因注释最容易“做完就结束”的原因。
1.3 高手不缺结论,缺的是可重复框架
对有经验的研究者来说,marker注释并不陌生。真正需要的是把注释过程结构化、标准化、可迁移化 。
也就是说,不只是给出“这个群像T细胞”,而是明确说明:
- 依据了哪些核心marker。
- 是否结合了通路或功能富集。
- 是否验证了群体稳定性。
- 是否可以据此形成后续实验设计。
这正是从“分析套路”走向“研究方案”的关键一步。
2. Workbuddy如何把标记基因注释从经验判断变成流程化输出
2.1 先提炼分析套路,再定位注释逻辑
根据上游知识库,Workbuddy的核心优势不是单纯输出一个答案,而是先从文章或数据中提炼分析套路 。这点非常适合标记基因注释场景。因为注释本质上也是一套流程:聚类、筛选、比对、验证、归类、延伸。
这种方式的好处是,它不要求用户一开始就把问题定义得很完整。系统可以先帮你整理出:
- 常见marker对应的细胞类型框架。
- 当前数据中最有解释力的候选基因。
- 哪些注释结论证据更强。
- 哪些环节还需要补充分析。
这比单纯生成一个“细胞类型名单”更有科研价值。
2.2 从注释结果延伸到研究问题
标记基因注释真正重要的,不只是“认出细胞”,而是“认出之后研究什么”。
Workbuddy的设计思路,恰好适合把注释结果继续转化为研究问题。例如:
- 某个细胞亚群是否与预后相关。
- 某组marker是否提示特定分化状态。
- 某个亚群是否与免疫微环境重塑有关。
- 某类marker能否作为后续验证靶点。
这意味着,注释不再只是图注中的一个步骤,而是研究逻辑的起点。
2.3 比传统工作台更灵活的地方
知识库中明确提到,类似功能不是简单放进一个固定工作台里,而是用Workbuddy加自定义skill实现。这种架构的优势在于灵活。
原因很直接。标记基因注释的需求差异很大。不同课题组、不同疾病、不同数据平台,关注点都不一样。
例如:
- 单细胞转录组更看重细胞亚群精细划分。
- 空间转录组更看重组织定位。
- 肿瘤项目更看重恶性细胞和微环境互作。
- 发育研究更看重谱系关系和状态转变。
固定模板很难覆盖这些差异。可扩展的skill架构更适合真实科研场景。
3. 标记基因注释的标准分析思路,应该包含哪些关键步骤
3.1 先看表达,再看特异性
标记基因注释不能只看“是否高表达”,还要看“是否足够特异”。
通常建议至少检查三层信息:
- 该基因在目标簇内是否明显富集。
- 是否在其他簇中出现较强背景表达。
- 是否与已知生物学功能一致。
如果一个基因在多个细胞群都高表达,它更适合作为状态基因,而不是稳妥的身份marker。
3.2 用多个证据交叉验证
单个marker容易误判,尤其在肿瘤和炎症环境中。更稳妥的做法是组合判断。
例如:
- 经典marker。
- 差异表达结果。
- 功能富集信息。
- 文献证据。
- 必要时加上免疫组化或空间定位证据。
多证据一致时,注释可信度才会显著提高。
这也是高质量文章和普通分析之间最核心的区别。
3.3 注释不是终点,而是下一轮分析入口
一旦细胞类型或状态被初步确认,就应该继续向下走。常见延伸方向包括:
- 亚群再聚类。
- 轨迹分析。
- 通路活性比较。
- 细胞通讯分析。
- 预后关联分析。
这样才能把“这是什么细胞”推进到“这个细胞为什么重要”。
4. 从论文套路到研究方案,Workbuddy适合解决哪些具体问题
4.1 把单篇文章的方法提炼成模板
知识库里提到,系统可以从论文中分批提取文本,识别材料方法,再总结实验链。这个能力对标记基因注释非常实用。
因为很多高质量文章都不是靠单一图,而是靠完整链条:
- 数据集筛选。
- 聚类与注释。
- 差异分析。
- 富集分析。
- 验证实验。
- 临床关联。
Workbuddy可以把这种链条提炼出来,帮助研究者快速判断一篇文章到底是怎么完成注释闭环的。
4.2 让新手知道“注释后怎么写方案”
对新手而言,最常见的问题不是不会看图,而是不知道如何把图变成方案。
Workbuddy的价值就在这里。它可以把标记基因注释后的结果继续延展为:
- 研究假设。
- 验证路径。
- 样本分组思路。
- 文章结构建议。
这一步非常关键,因为很多项目真正失败,不是分析没做,而是分析结果没被组织成可发表的研究问题。
4.3 让高手节省重复劳动
高手也需要效率。对于经常做单细胞或多组学分析的人来说,重复整理marker、对照文献、构建注释表,是高频但低创造性的工作。
如果能借助Workbuddy把套路先提取出来,再由研究者人工审核和修正,就能显著减少重复劳动,把时间留给更关键的判断和实验设计。
5. 如何把Workbuddy+标记基因注释真正用在科研中
5.1 推荐的使用顺序
为了避免“生成了结果却不知道怎么用”,建议按下面顺序推进:
- 先上传文章、方法或分析记录。
- 提炼标记基因注释所需的分析套路。
- 对照自己的数据,定位当前缺口。
- 生成细胞注释与后续验证建议。
- 进一步转成研究方案或学习计划。
这个路径的好处是,注释、解释、设计三步连起来了 。
5.2 适合重点检查的输出内容
在实际使用中,建议重点看以下几类输出:
- 关键marker是否足够经典。
- 证据链是否完整。
- 细胞分类是否过于粗糙。
- 是否存在状态基因误当身份基因。
- 后续实验建议是否可执行。
如果这些点都被梳理清楚,注释结果就不只是“图上标完了”,而是能进入论文写作和课题设计。
5.3 结合解螺旋,提升从分析到发表的效率
对医学生、医生和科研人员来说,真正稀缺的是把复杂分析快速变成可靠方案的能力。解螺旋提供的,不只是工具思路,更是把Workbuddy+标记基因注释落地到研究流程中的方法支持。
当你已经完成初步注释,但还卡在“如何形成研究设计、如何延伸验证、如何组织成文章”时,借助解螺旋可以更快把零散结果整理成可执行路径,减少返工,提高产出效率。
总结Conclusion
标记基因注释的核心,不是给细胞贴标签,而是建立一条从证据到结论、从结论到方案的完整链条。Workbuddy的价值在于,它能把分析套路提炼出来,再进一步延伸为研究方案。
对于新手,它解决“看懂结果但不会下一步”的问题。对于高手,它减少重复整理和结构化输出的时间。对于科研团队,它让标记基因注释真正进入可复用、可扩展、可发表的工作流。
如果你希望把单细胞注释、文献套路和课题设计连成一体,可以进一步了解解螺旋 ,把Workbuddy+标记基因注释真正变成你的科研加速器。
- 引言Introduction
- 1. 标记基因注释为什么总卡在“结果有了,研究没跟上”
- 2. Workbuddy如何把标记基因注释从经验判断变成流程化输出
- 3. 标记基因注释的标准分析思路,应该包含哪些关键步骤
- 4. 从论文套路到研究方案,Workbuddy适合解决哪些具体问题
- 5. 如何把Workbuddy+标记基因注释真正用在科研中
- 总结Conclusion