18
 分享
引言Introduction
临床预测模型常见问题有两个,模型看起来很好,但一到验证集就失真。另一种是AUC不错,却无法回答“预测值准不准”。列线图解决的是个体化预测,校准曲线解决的是预测是否可信。 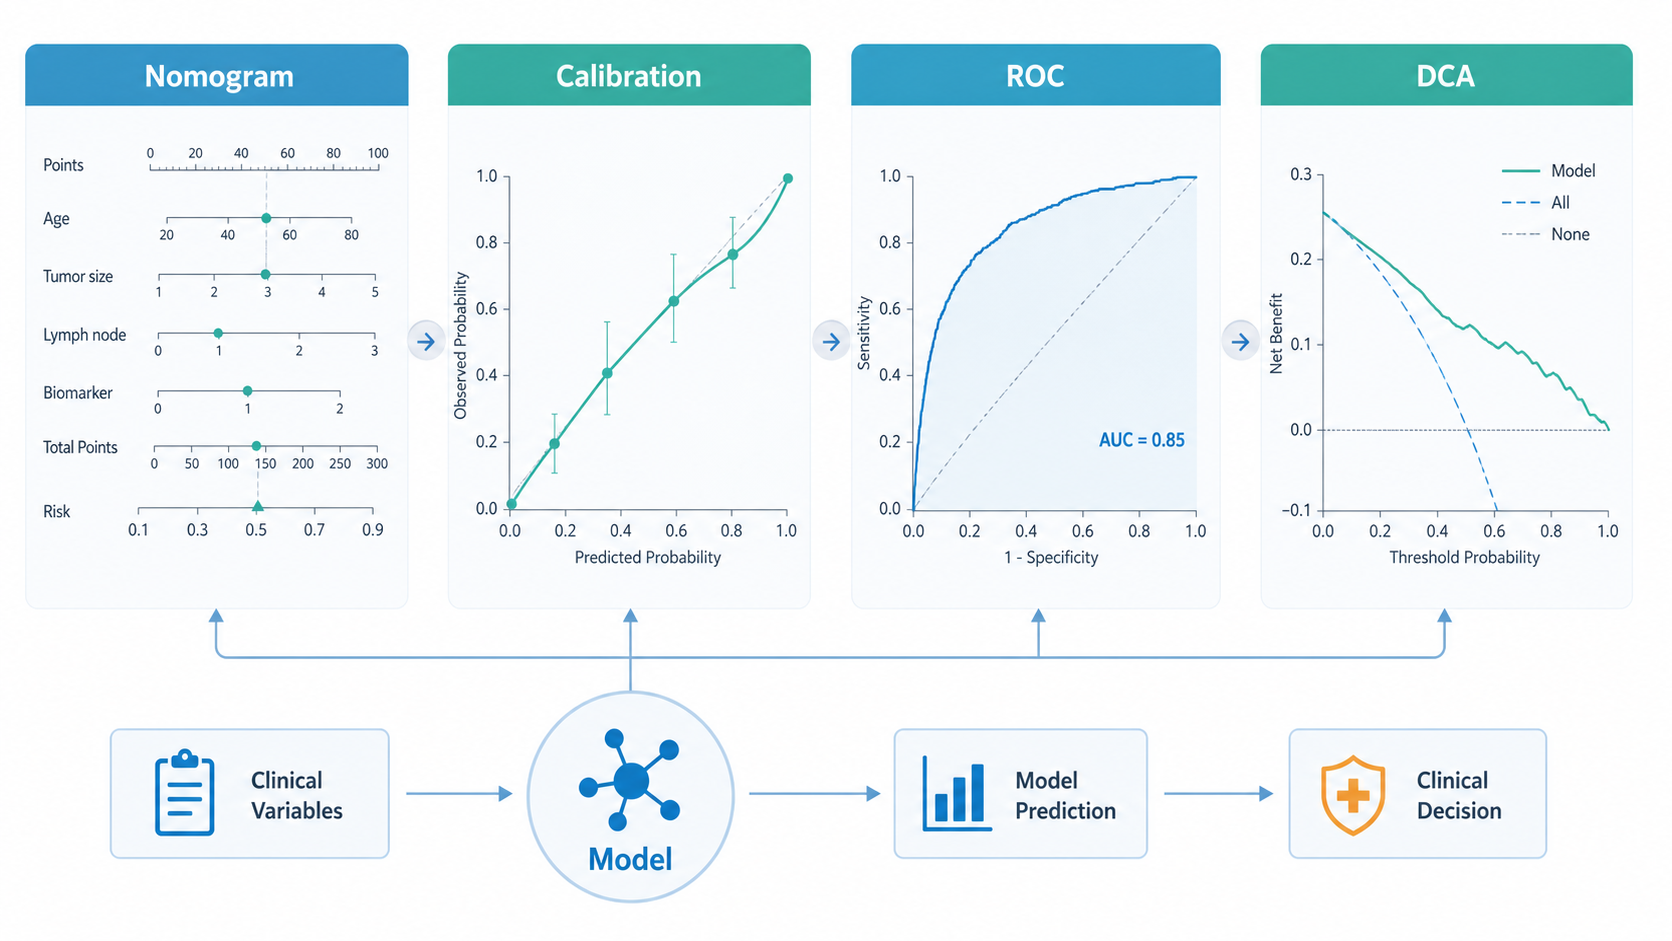
对于医学生、医生和科研人员来说,真正有价值的预后模型,不只是能分组,还要能预测到具体风险,并且在外部数据中保持稳定。本文结合SEER等数据库常见研究思路,梳理列线图校准曲线的构建逻辑、评价要点和常见误区。
1. 列线图是什么,为什么预后模型离不开它
1.1 列线图的核心作用
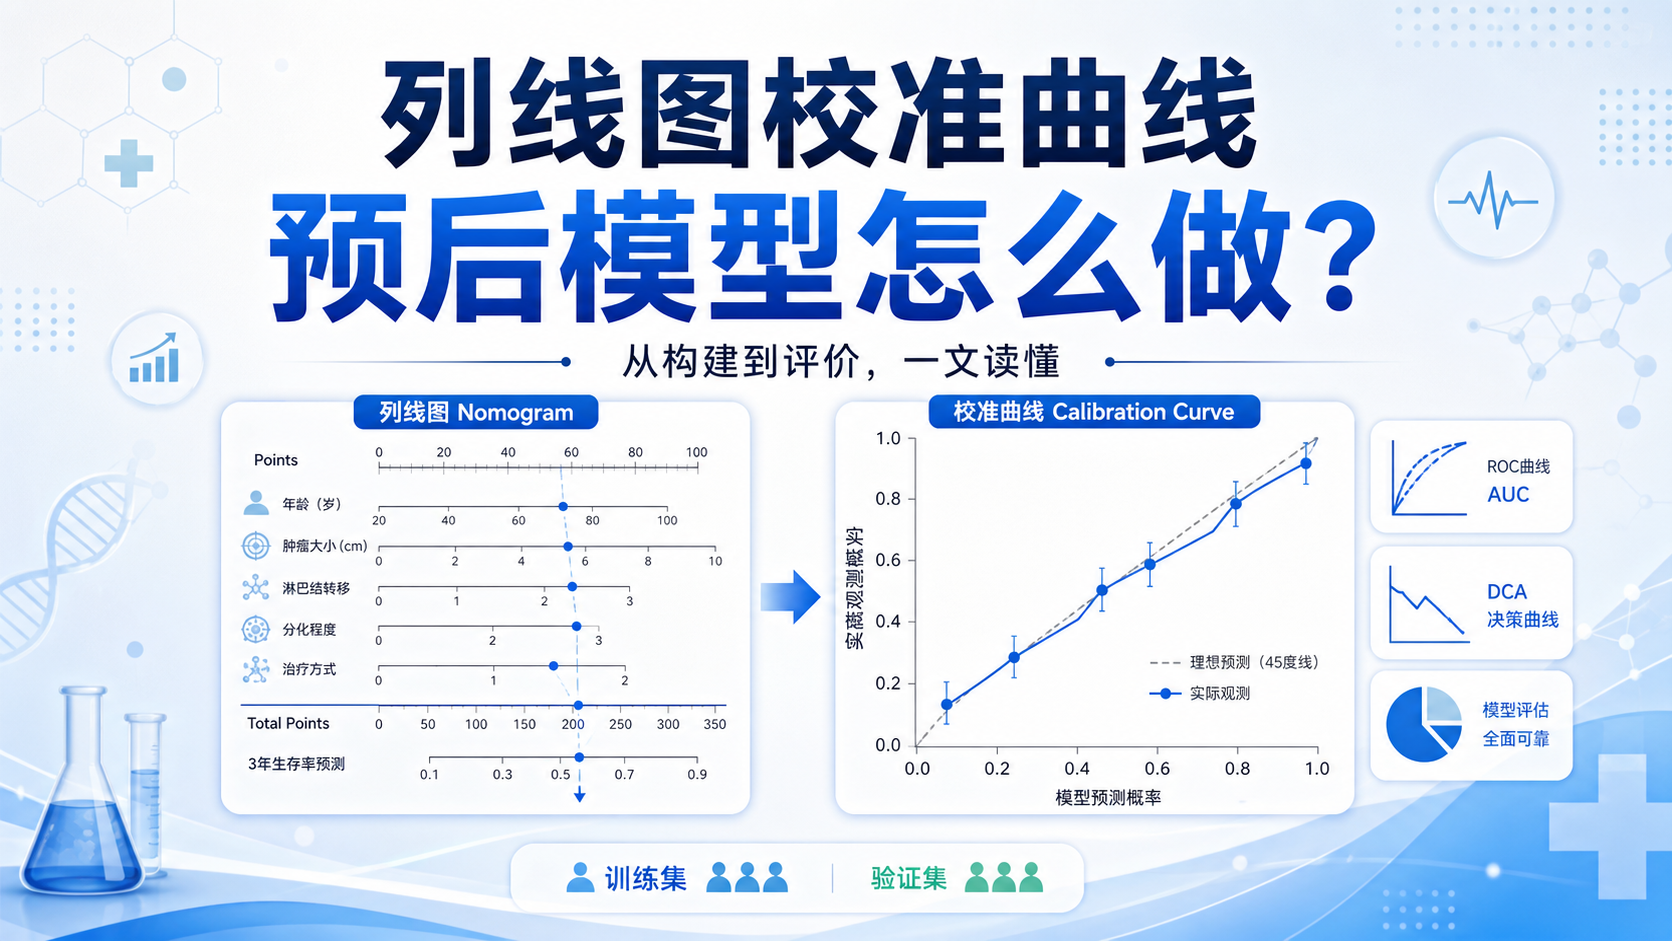
列线图,也叫诺谟图,是把多因素回归模型转成可视化工具。它把每个变量的回归贡献转换成分值,再汇总成总分,最后对应到某个时间点的生存概率或事件概率。
它的优势是直观。 复杂公式被转成图形,临床可以更快完成个体风险判断。比如肿瘤预后研究中,年龄、分期、分级、治疗方式等变量,都可纳入同一个模型。
列线图常建立在Cox回归或Logistic回归基础上。前者适合生存结局,后者适合二分类结局。如果你的研究目标是生存时间预测,Cox列线图更常见。
1.2 预后研究中列线图的价值
很多数据库研究的流程很相似。先做单因素分析,再做多因素分析,筛出独立预后因素。随后构建列线图,评估患者在1年、3年、5年等时间点的风险。
常见流程包括:
- 划分训练集和验证集。
- 做Kaplan-Meier曲线和Log-rank检验。
- 用单因素和多因素Cox筛选变量。
- 构建列线图。
- 进行区分度、校准度和临床决策分析。
真正决定模型质量的,不是训练集拟合得多好,而是验证集是否仍然成立。 这一点在数据库文献中尤其重要。
2. 校准曲线为什么是列线图评价的关键
2.1 校准曲线回答的是“准不准”
如果说ROC/AUC关注模型能不能区分高风险和低风险人群,那么列线图校准曲线关注的是预测概率与真实概率是否一致。
横轴通常是预测概率,纵轴是实际发生概率。理想状态下,点应该接近45度参考线。
越接近45度线,说明模型校准越好。
这和区分度是两回事。一个模型可能AUC很高,但预测概率系统性偏高或偏低,临床上仍然不可靠。对于预后模型,校准差会直接影响治疗决策。
2.2 校准曲线常见解读方式
校准曲线通常会分别画出不同时间点,例如1年、3年、5年生存校准。判断时可重点看三点:
- 曲线是否整体贴近45度线。
- 中高风险区是否偏离明显。
- 置信区间是否过宽,提示样本量不足或模型不稳定。
如果曲线在部分区间明显上翘或下弯,说明模型在该风险段存在系统误差。 这比单纯看一个整体P值更有意义。
2.3 校准曲线和H-L检验的关系
有些研究会同时报告Hosmer-Lemeshow检验。它可作为补充,但不能替代图形判断。
原因很简单,P值只能告诉你“是否存在差异”,不能告诉你“差异有多大、偏在哪”。
对于医学论文,图形化展示更关键。尤其在列线图研究中,校准曲线几乎是必做项。
3. 构建疾病预后模型的标准流程
3.1 变量筛选要有明确逻辑
预后模型不是变量越多越好。变量过多会导致过拟合。数据库研究中常见做法是先单因素筛选,再进入多因素分析。
常用标准是:
- 单因素分析P值小于0.1或0.2纳入候选变量。
- 多因素分析保留独立预后因素。
- 根据回归系数构建列线图。
变量筛选的本质,是在解释性和稳定性之间找平衡。
如果研究中还使用Lasso等方法进行降维,也可以提高模型简洁性。但无论采用哪种方法,都要保证变量来源合理,且具有临床可解释性。
3.2 训练集和验证集必须分开
训练集用于建模,验证集用于检验泛化能力。
这一步非常重要。很多模型在训练集里表现很好,但到了验证集就明显下降。
研究中常见的做法包括:
- 按比例随机分组。
- 使用内部验证,如bootstrap重抽样。
- 尽可能加入外部验证队列。
如果只有训练集结果,没有验证集支持,列线图的临床说服力会明显下降。
3.3 模型构建后必须完成三类评价
一个完整的预后模型,至少要看三件事:
- 区分度。 常用ROC曲线、AUC、C-index。
- 校准度。 用列线图校准曲线评估预测值和真实值一致性。
- 临床净获益。 用DCA判断是否值得用于实际决策。
区分度告诉你模型能不能分人,校准度告诉你模型准不准,DCA告诉你模型值不值得用。
4. 列线图校准曲线的绘制与解读要点
4.1 绘制前先确认结局类型
如果是生存结局,通常以Cox回归建立列线图,再按不同时间点做校准曲线。
如果是二分类结局,则可用Logistic回归模型。
在实际研究中,最常见的错误之一是把结局类型和模型形式弄混。结局变量、随访时间和删失信息,必须在建模前理清。
4.2 校准曲线常用的重采样方法
很多研究会用bootstrap进行内部验证。知识库中提到,重采样次数会影响稳定性评估。一般来说,重复抽样越充分,曲线越稳,但计算成本也越高。
校准曲线的核心不是“画出来就行”,而是看:
- 预测概率和实际概率是否一致。
- 不同时间点是否都保持较好拟合。
- 曲线波动是否过大。
模型在1年、3年、5年都校准良好,才更适合临床使用。
4.3 结果写作建议
写论文时,不要只说“校准曲线显示模型拟合良好”。更好的写法是:
- 1年、3年、5年校准曲线均接近45度参考线。
- 预测概率与实际观察概率一致性较好。
- 提示模型在不同时间点具有较高校准度。
这种表述更符合科研写作规范,也更利于审稿人快速判断模型质量。
5. 列线图校准曲线之外,还要看哪些指标
5.1 ROC和AUC用于看区分度
知识库中提到,AUC达到0.8以上通常提示区分效果较好。
但要注意,AUC高不等于临床可用。
比如两个模型AUC相近,一个校准很好,一个校准差,前者通常更适合临床预测。
所以不要只盯着AUC。
5.2 DCA用于判断临床净获益
DCA看的是在不同阈值概率下,模型是否优于“全部干预”或“全部不干预”。
如果一个模型能在合理阈值范围内获得更高净获益,就说明它更接近临床真实决策场景。
这一步对列线图很重要。因为预后模型的最终目标,不是发表图表,而是指导决策。
5.3 组间基线差异不要过度解读
数据库研究中,训练集和验证集常会出现一些基线差异。
知识库明确指出,这些差异多由人为分组造成,不能简单理解为混杂偏倚。
真正重要的是模型能否在验证集保持稳定,而不是两组表格看起来是否完全一致。
6. 写出高质量预后模型的实操建议
6.1 控制变量数量,避免过拟合
样本量有限时,不要放入过多变量。变量过多会让模型不稳,校准曲线也容易变差。
建议优先保留:
- 临床上有明确意义的变量。
- 多因素分析中稳定显著的变量。
- 可重复获取的变量。
6.2 关注临床可解释性
一个好模型不仅要统计学成立,还要让临床人员看得懂。
例如分期、分级、治疗方式、转移状态这类变量,通常比过于复杂的衍生指标更容易推广。
可解释性越强,模型越容易进入临床场景。
6.3 结果呈现要完整
推荐在论文中同时展示:
- 列线图。
- 1年、3年、5年校准曲线。
- ROC曲线或C-index。
- DCA曲线。
这样能形成完整证据链。
审稿人会更容易认可模型的可信度。
7. 用解螺旋提升列线图研究效率
如果你正在做SEER、NHANES或其他数据库的预后模型研究,最大痛点通常不是不会画图,而是不知道变量怎么筛、模型怎么验、结果怎么写得符合投稿要求。 解螺旋可以帮助你更系统地梳理列线图构建、校准曲线解读和模型评价思路,让你少走弯路,更快完成高质量论文。
总结Conclusion
列线图的价值在于把多因素预后模型转成临床可读的个体化风险工具,而列线图校准曲线则负责验证这个预测到底准不准。 对于疾病预后研究来说,区分度、校准度和临床净获益缺一不可。
如果你正在写预后模型论文,建议按照“变量筛选, 列线图构建, 校准曲线验证, ROC评估, DCA判断”的顺序推进。这样逻辑更完整,结果也更容易被审稿人接受。想系统掌握这套方法,可以关注解螺旋,获取更贴近实战的临床科研方法支持。
- 引言Introduction
- 1. 列线图是什么,为什么预后模型离不开它
- 2. 校准曲线为什么是列线图评价的关键
- 3. 构建疾病预后模型的标准流程
- 4. 列线图校准曲线的绘制与解读要点
- 5. 列线图校准曲线之外,还要看哪些指标
- 6. 写出高质量预后模型的实操建议
- 7. 用解螺旋提升列线图研究效率
- 总结Conclusion