24
 分享

引言Introduction
列线图是临床科研里最常用的个体化预测工具之一,但很多人会卡在“会看不会画”。真正的难点不在建模本身,而在于如何把回归模型转成可解释、可验证、可落地的图形。 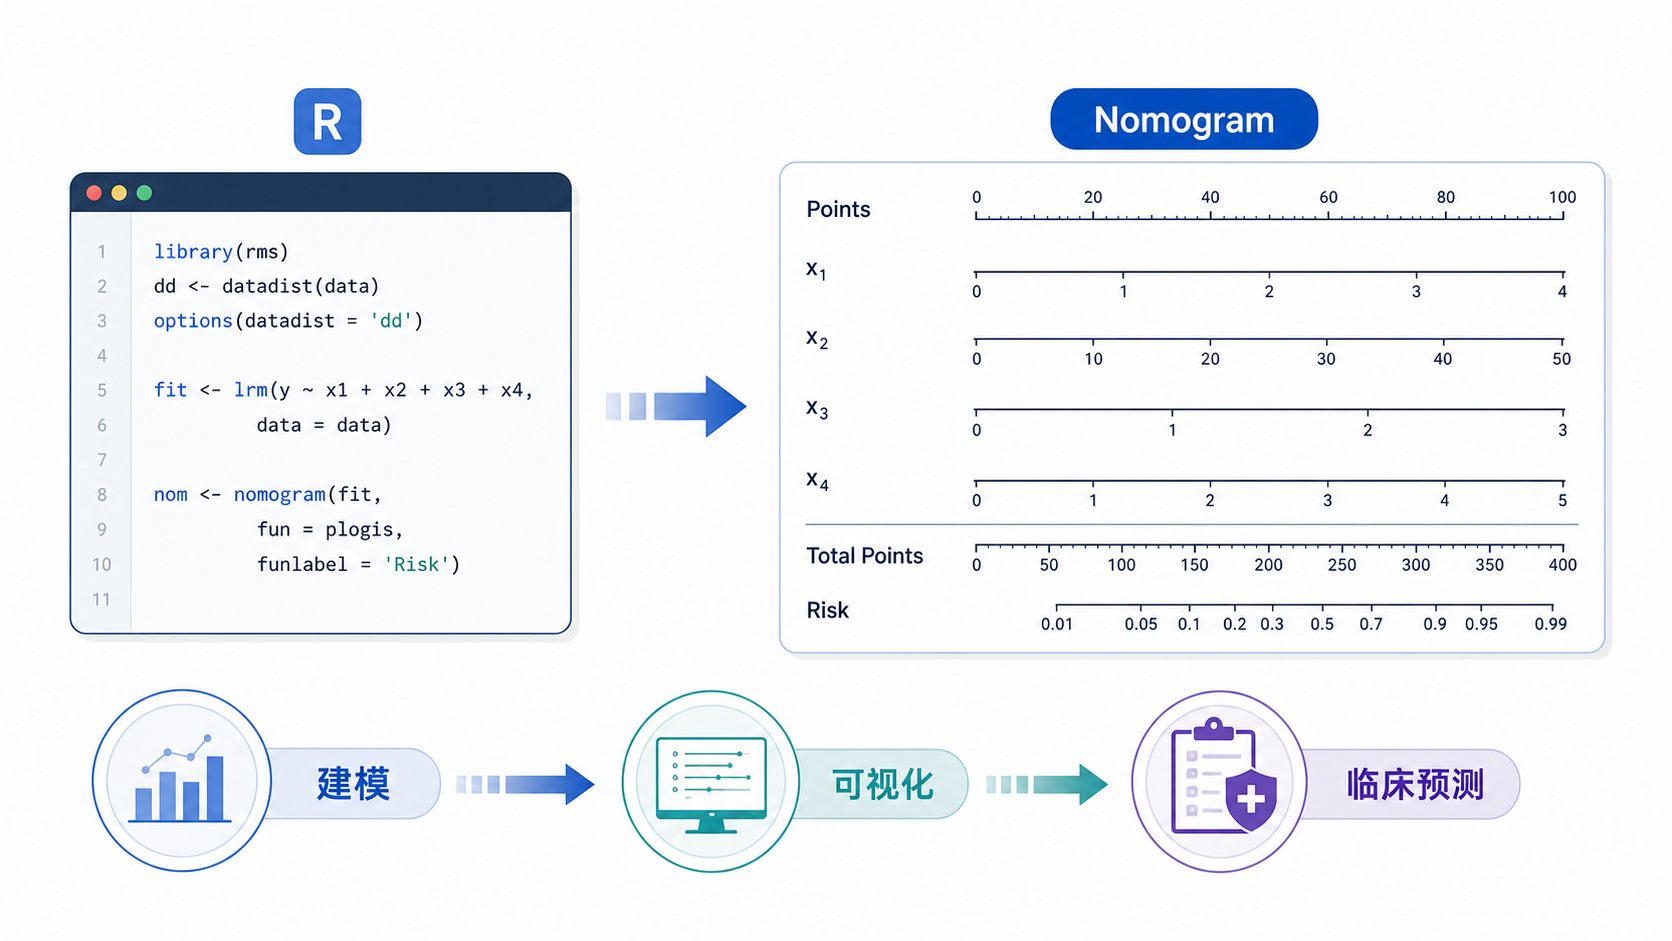
1. 列线图到底解决什么问题
1.1 从回归方程到临床可用图形
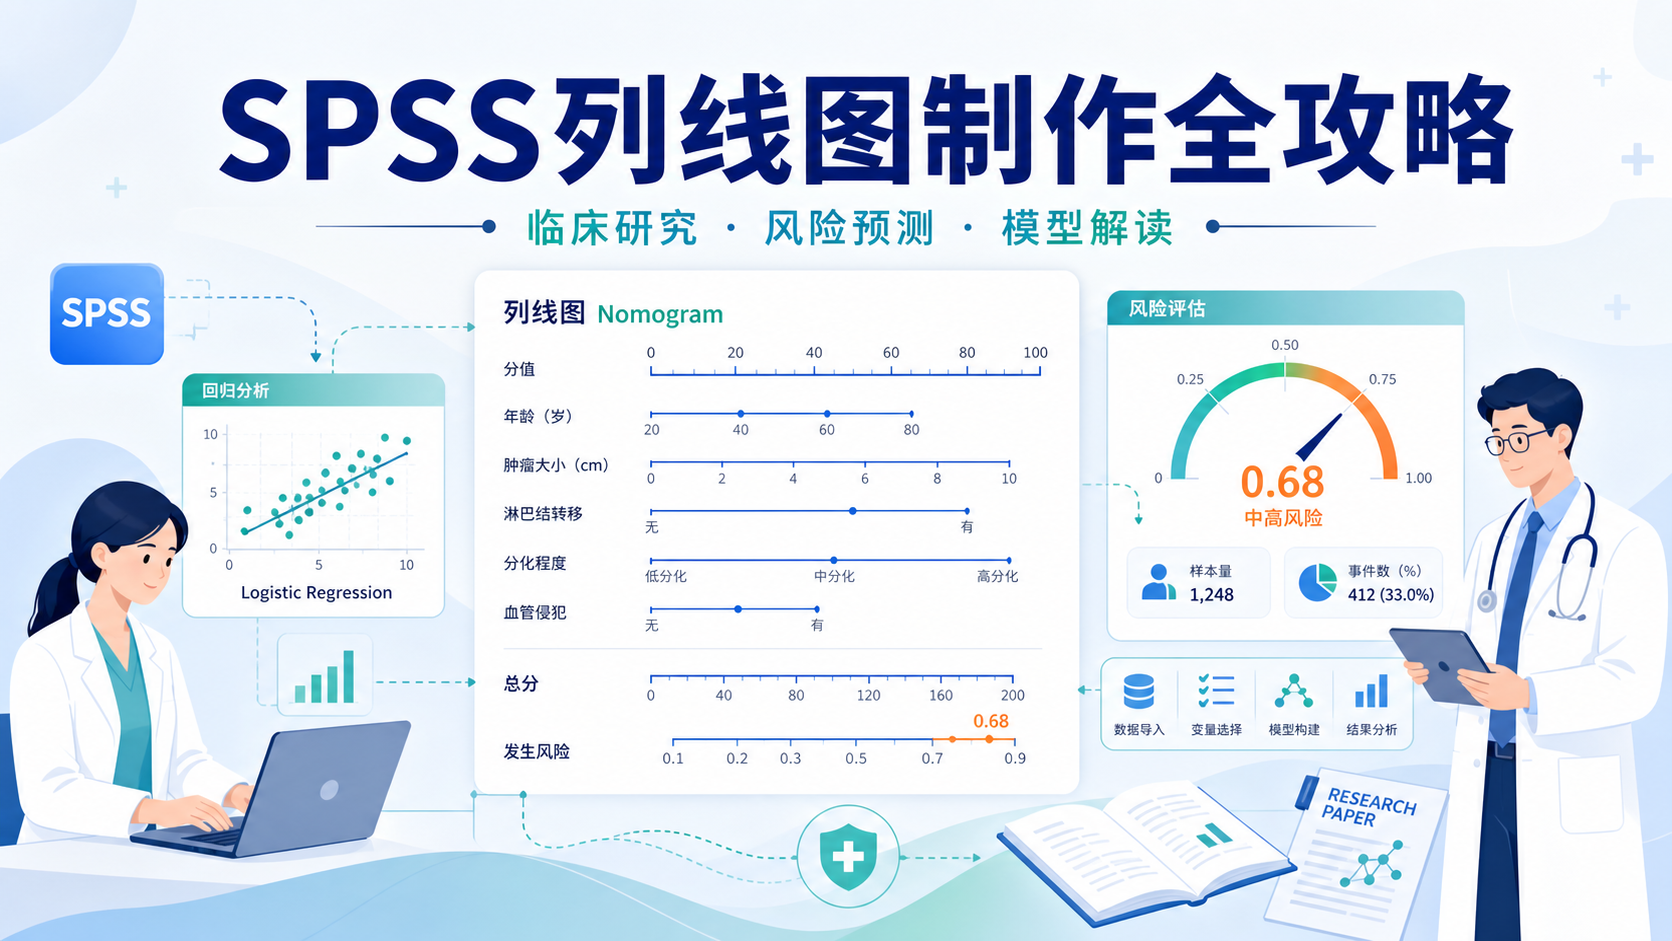
列线图,又称诺摩图,建立在多因素回归分析基础上,常见于Logistic回归和Cox回归。它的核心价值,是把复杂的回归方程变成直观的评分图。
每个变量都被赋予分值,最后汇总成总分,再映射到结局概率。 这比直接看OR值更适合临床使用,也更方便在病房或门诊快速判断风险。
对于医学生、医生和科研人员来说,列线图最重要的意义有三点。
- 便于做个体化风险预测。
- 便于展示多因素联合效应。
- 便于增强研究结果的临床转化价值。
1.2 列线图的基本结构
一个标准列线图通常包含三部分。
- 顶部的Points轴,用于给每个变量赋分。
- 中间的自变量轴,显示各变量取值及对应评分。
- 底部的Total Points和Risk轴,用于得到总分和预测概率。
理解列线图的关键,不是记住图长什么样,而是理解“变量贡献, 评分, 总分, 概率”这条逻辑链。
临床上,系数越大、影响越强的变量,通常在图中的刻度越长,分值权重也越高。
2. 画列线图前,先把模型基础打牢
2.1 先明确结局变量和自变量
在R语言里,列线图不是单独绘制的图,而是建立在模型之上的可视化结果。也就是说,先有回归模型,后有列线图。
如果是二分类结局,通常先做Logistic回归。
如果是生存结局,通常先做Cox回归。
建模前要先确认三件事。
- 结局变量是否定义清楚。
- 自变量是否经过合理编码。
- 缺失值、异常值是否处理过。
2.2 因子型变量要提前处理
分类变量在R中常需要转为factor。尤其是多分类变量,必须明确参考水平,否则模型解释会混乱。
常见做法包括:
- 二分类变量,按0/1编码后转为factor。
- 多分类变量,设定levels和labels。
- 连续变量,保留原始数值,必要时再做标准化或分层。
如果变量编码有问题,后面的列线图再漂亮,临床解释也可能是错的。
2.3 先做模型筛选,再谈列线图
高质量列线图一般不是把所有变量都放进去,而是先做筛选。课程知识库中提到,部分研究会先用LASSO筛选协变量,再进入最终模型。
这是合理的。因为变量太多时,模型容易出现共线性、过拟合,最后表现为:
- AUC看起来不低,但外部验证很差。
- 校准曲线偏离45度线。
- DCA净收益不稳定。
列线图的前提,是模型本身具有统计学与临床双重合理性。
3. 用R语言实现列线图的核心流程
3.1 先用rms包完成建模准备
R语言里画列线图,最常用的是rms包。
标准流程通常包括以下步骤。
- 加载rms包。
- 用datadist整理数据分布信息。
- 设置options(datadist=“dd”)。
- 用lrm或cph拟合模型。
- 用nomogram生成列线图对象。
- 用plot绘图。
这套流程是列线图R语言实现的主线。
3.2 Logistic列线图的常见写法
如果结局是二分类,通常用lrm函数拟合模型。
模型构建完成后,再通过nomogram函数生成列线图。
这里最需要理解的是参数逻辑。
- fun用于指定概率转换函数。
- lp表示是否显示线性预测值。
- fun.at用于设置概率刻度。
- funlabel用于命名风险轴。
也就是说,nomogram不是“直接画图”,而是把模型结果翻译成可视化刻度。
3.3 图太挤时,先别急着改模型
很多初学者第一次画图,都会遇到一个问题,文字重叠、版面拥挤、刻度太密。
这不是错误,往往只是图形尺寸不合适。
常见处理方法有三种。
- 放大绘图窗口。
- 调整输出图像尺寸。
- 精简变量数量。
如果变量太多,建议优先考虑筛选重要变量,而不是强行把所有变量塞进一张图里。
一张清晰的列线图,比一张信息过载的列线图更有临床价值。
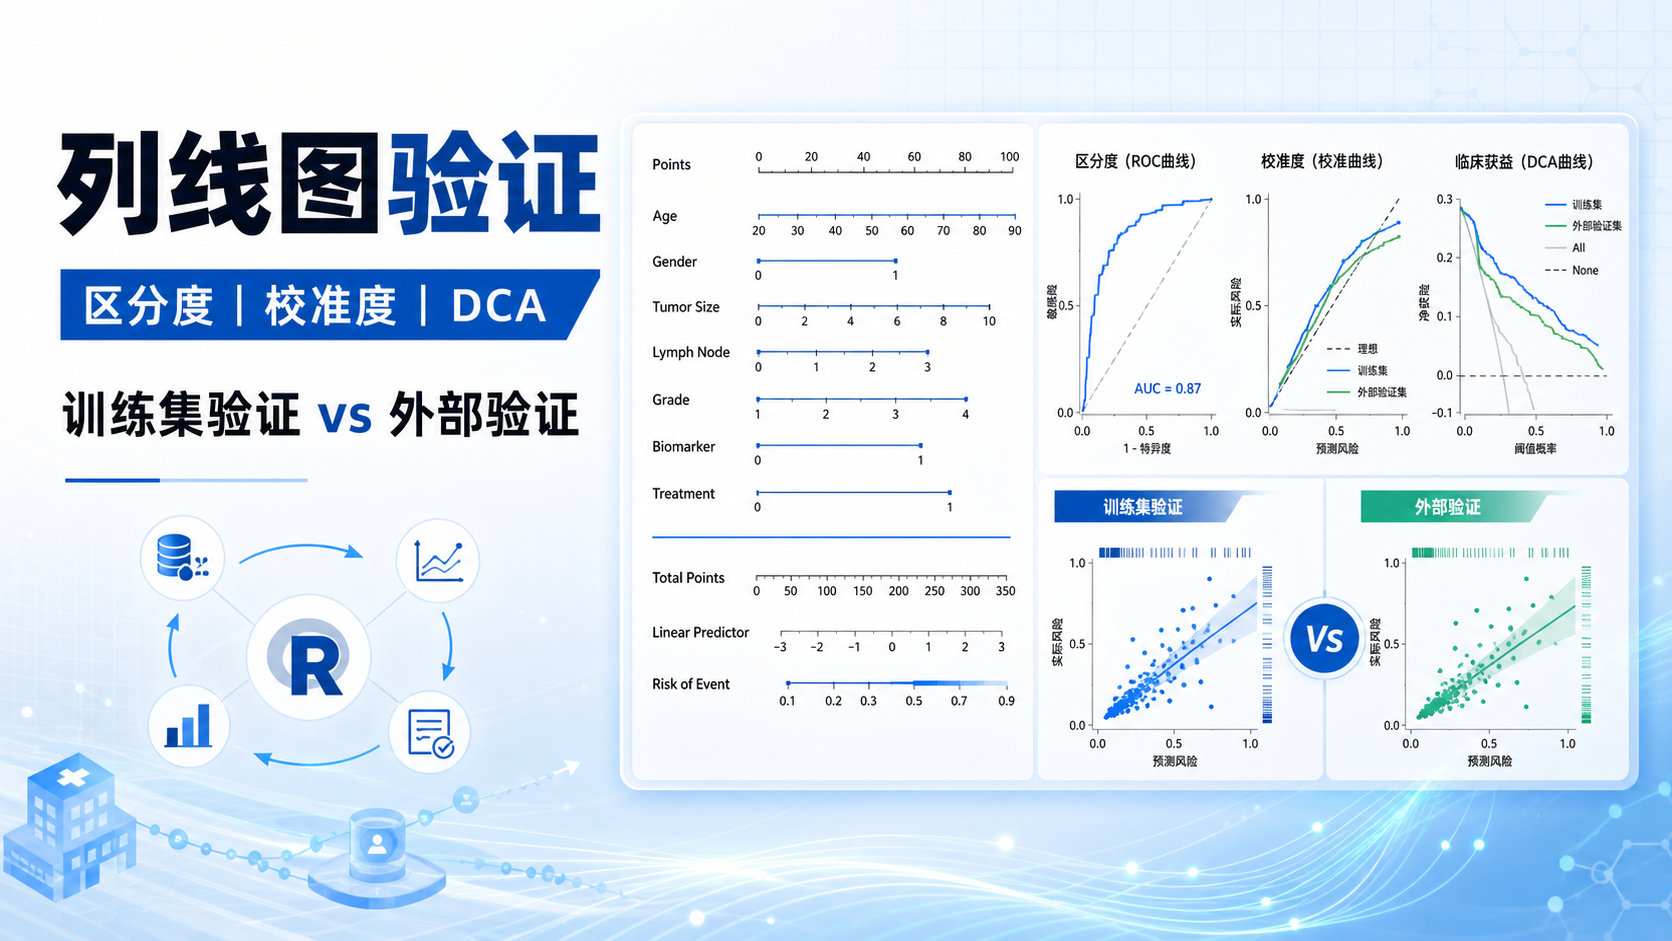
4. 列线图能不能用,关键看这三个评价
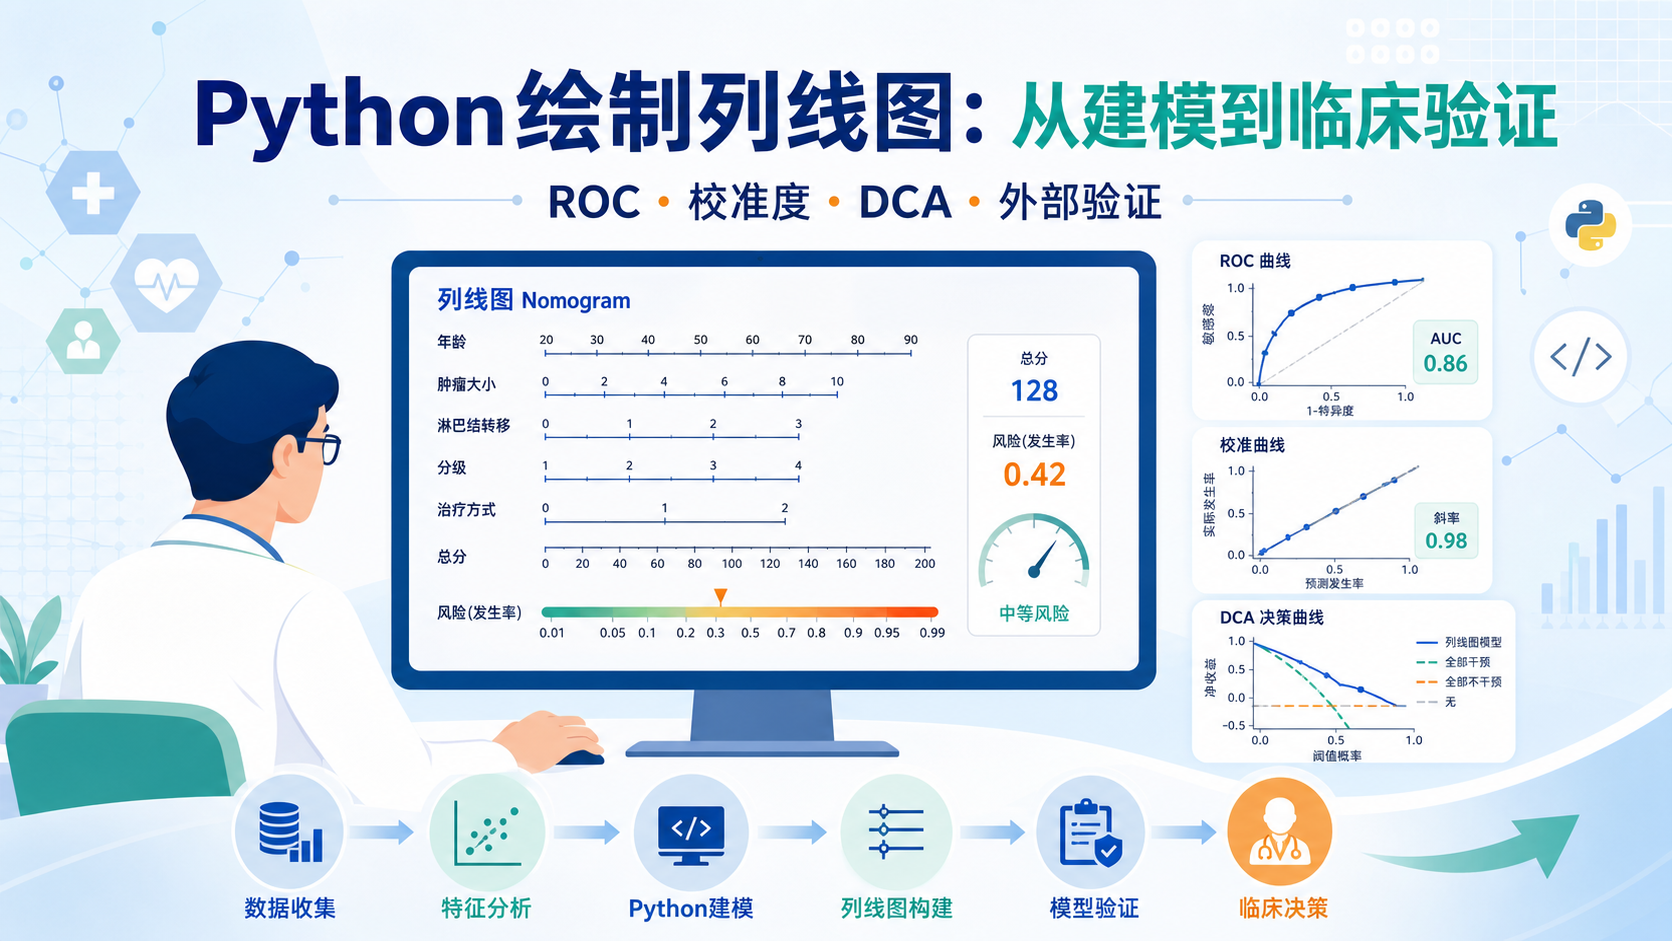
4.1 ROC曲线看区分度
列线图做出来以后,不能只看外观。
首先要看模型有没有区分能力,也就是能不能把高风险和低风险患者分开。
最常用的是ROC曲线和AUC。
- AUC越接近1,区分能力越强。
- 一般AUC大于0.8,可认为诊断效能较好。
- 若AUC接近0.5,说明模型接近随机判断。
区分度好,只说明模型能分层,不代表预测就一定准确。
4.2 校准曲线看预测是否接近真实
校准曲线回答的是另一个问题。
模型预测的概率,和真实发生率是否一致。
理想情况下,预测曲线应尽量贴近45度线。
如果整体趋势偏离很大,说明模型预测偏差较明显。
判断校准时,可以重点看两点。
- 曲线是否靠近45度线。
- 置信区间是否过宽,是否提示不稳定。
区分度和校准度是两回事,不能混为一谈。
4.3 DCA曲线看临床净收益
DCA,即决策曲线分析,评价的是模型在临床上的实际收益。
它关注的是,在不同阈值概率下,用模型指导干预,是否比“全做”或“全不做”更有价值。
DCA图里常见三类参考线。
- 横线,代表不干预。
- 斜线,代表对所有人干预。
- 模型曲线,代表列线图预测策略。
如果模型曲线在合理阈值范围内高于两条参考线,才说明它有临床应用潜力。
5. 初学者最容易踩的坑
5.1 只会画图,不会解释
列线图不是装饰图。
它的价值来自可解释性。
在解释时,要回到变量本身,说明哪些因素贡献更大,哪些因素权重更高,结局风险如何变化。
不要只说“图画出来了”,而要说“图能帮助医生快速估计个体风险”。
5.2 只看单次结果,不做验证
一个模型在训练集表现好,不代表就能直接推广。
至少要考虑内部验证,最好还有外部验证。
常见验证方式包括:
- Bootstrap重抽样。
- 时间外验证。
- 独立队列验证。
没有验证的列线图,临床可信度有限。
5.3 变量过多,模型过拟合
变量越多,不一定越好。
尤其在样本量有限时,过多变量会让模型变得不稳定。
建议遵循一个原则。
围绕临床问题筛选少而精的变量,而不是追求“全变量入模”。
6. 为什么很多人会用解螺旋来学这类分析
6.1 从代码到结果,需要完整路径
列线图的难点,不只是R代码。
更难的是从数据清洗、变量筛选、建模,到验证和可视化的完整流程。
对于零基础或刚入门的人来说,如果只看零散代码,很容易出现这些问题。
- 知道函数名,但不知道顺序。
- 会跑代码,但不知道为什么这样写。
- 图能画出来,但不会判断模型好坏。
真正有效的学习方式,是把建模逻辑、R实现和图形解读放在同一条线上。
6.2 用规范流程减少试错成本
像解螺旋这类科研工具和内容平台,价值就在于把常见分析流程标准化。
对临床科研人员来说,这种方式能明显减少重复试错时间,帮助更快完成从数据到图形的转换。
如果你正在做回顾性研究、队列分析或临床预测模型,建议优先建立这套思维:
- 明确结局。
- 筛选变量。
- 建立模型。
- 绘制列线图。
- 做ROC、校准曲线和DCA验证。
- 再考虑论文展示与投稿表达。
有了规范流程,列线图R语言实现就不再是难题。
总结Conclusion
列线图的本质,是把多因素回归模型转化为可视化、可解释、可应用的临床预测工具。
掌握它,关键不在“会不会画”,而在于是否理解建模逻辑、变量编码、模型验证和临床解释。
只要你掌握了R中rms包的建模流程,再结合ROC、校准曲线和DCA三项评价,就能把列线图真正用起来。
如果你希望更高效地完成列线图R语言实现,少走弯路,可以进一步了解解螺旋提供的科研方法与实操支持。
- 引言Introduction
- 1. 列线图到底解决什么问题
- 2. 画列线图前,先把模型基础打牢
- 3. 用R语言实现列线图的核心流程
- 4. 列线图能不能用,关键看这三个评价
- 5. 初学者最容易踩的坑
- 6. 为什么很多人会用解螺旋来学这类分析
- 总结Conclusion