17
 分享
引言Introduction
ROC曲线是生物医学建模里最常见的评价工具之一。但很多人只会算AUC,不会选阈值,也不清楚灵敏度和特异度如何一起解释。如果你正在做二分类预测模型,ROC曲线是必须掌握的基础。

1. ROC曲线是什么,为什么生物医学研究离不开它
1.1 ROC曲线的核心含义
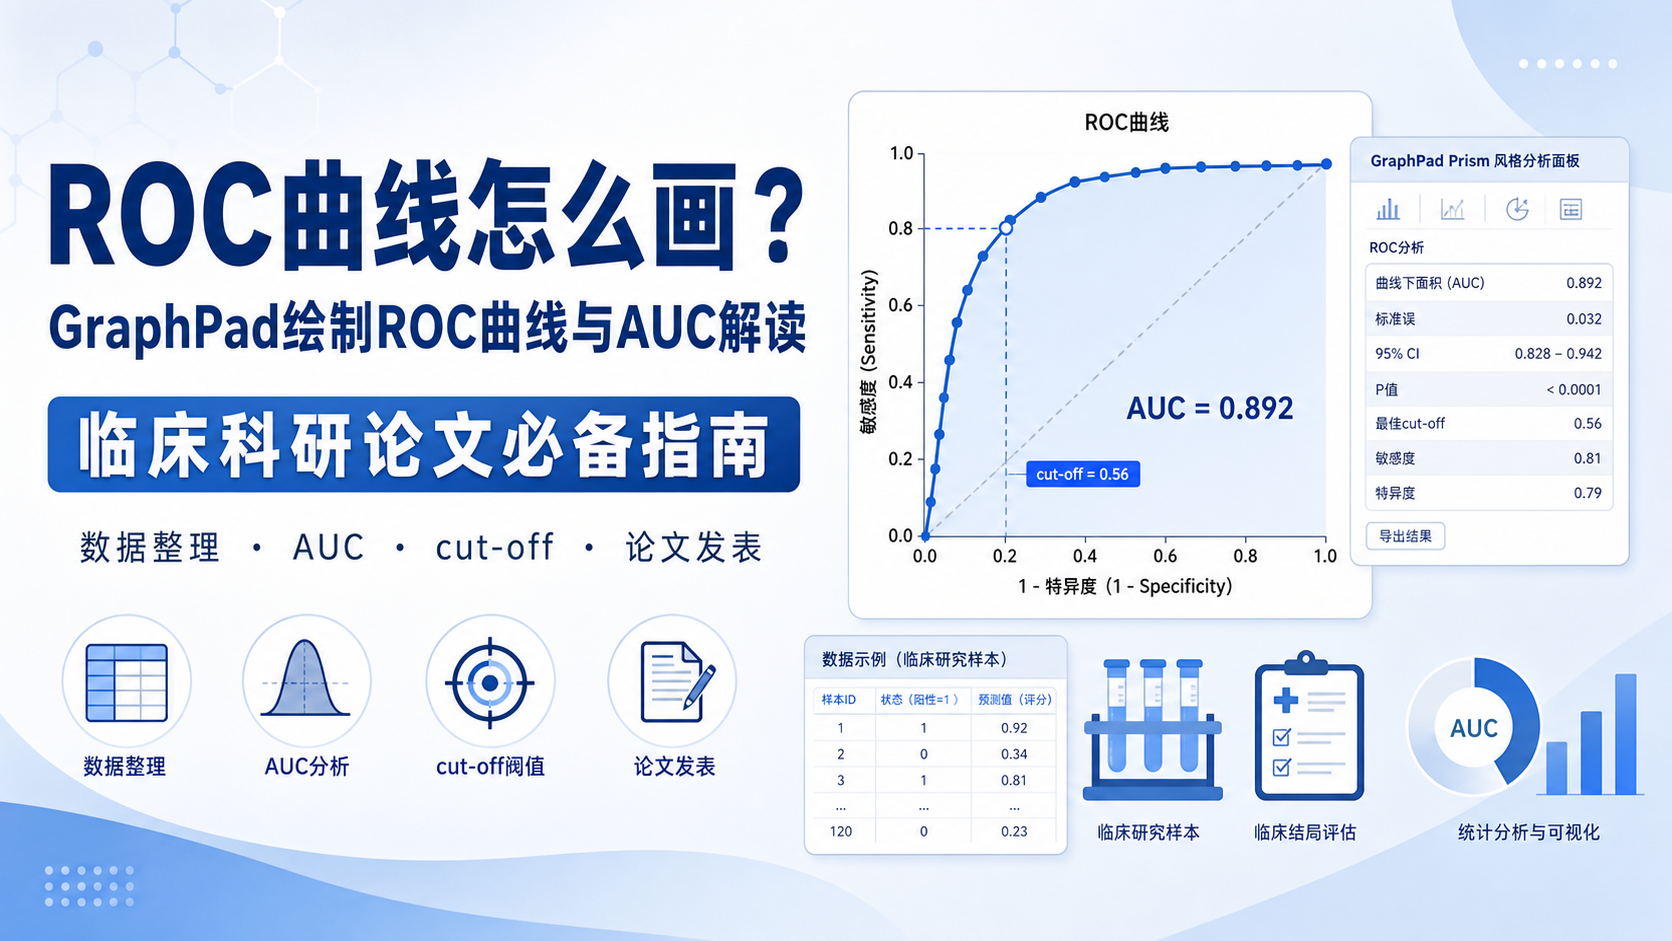
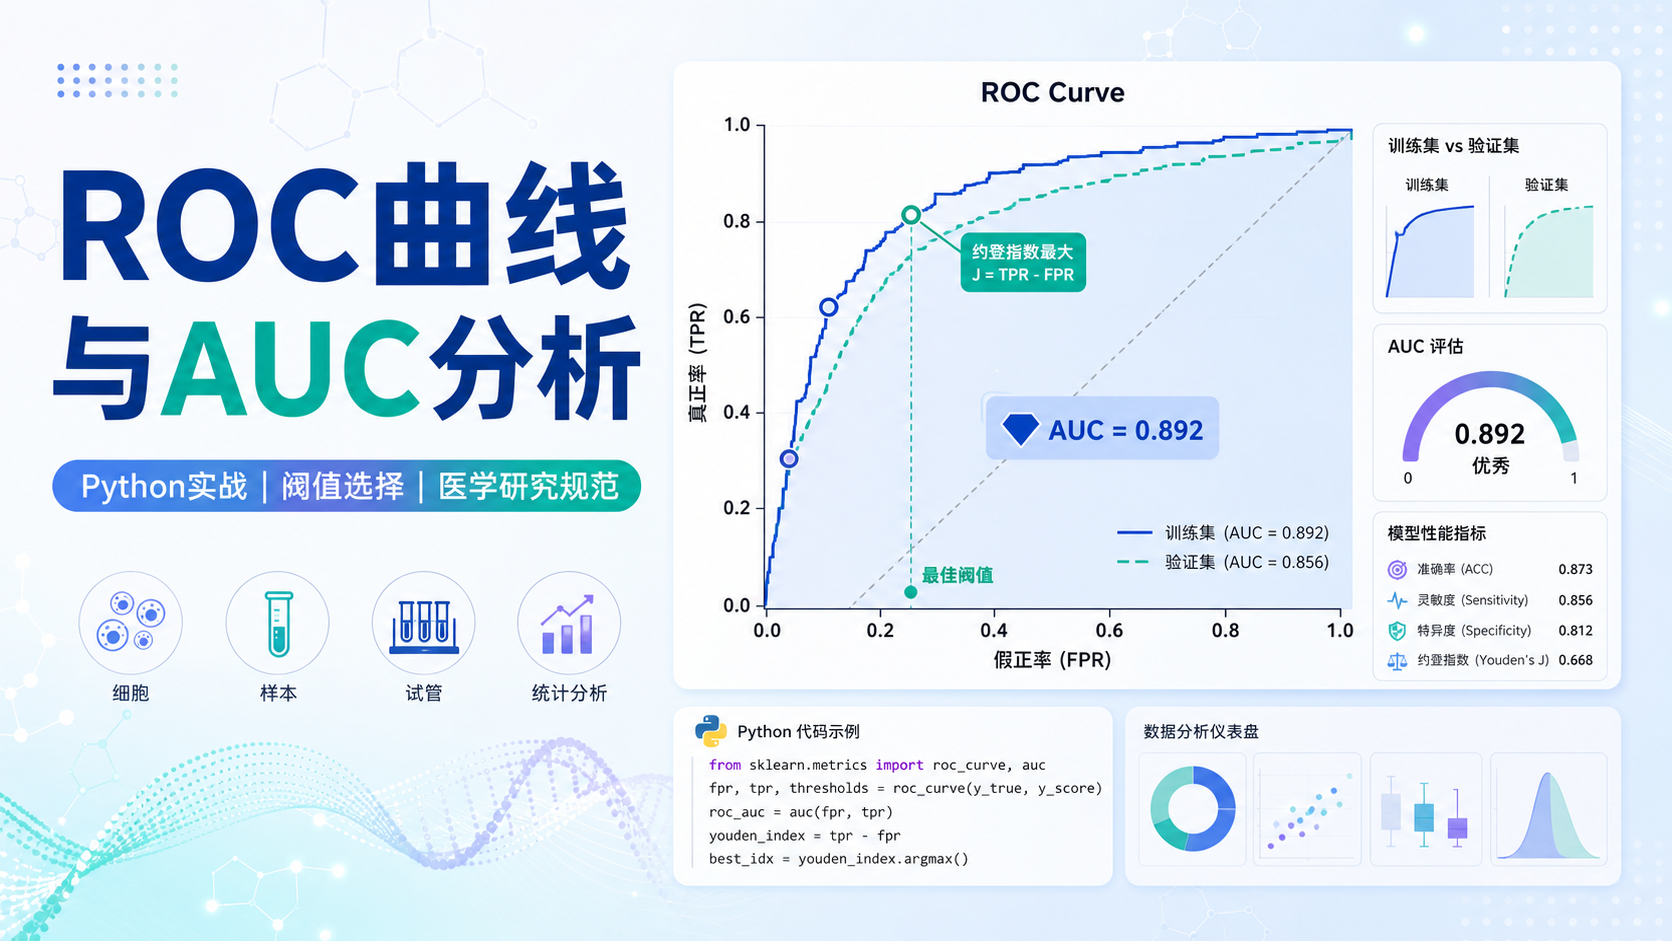
ROC曲线,全称是受试者工作特征曲线。它描述的是,在不同阈值下,模型区分阳性和阴性的能力。横坐标是1-特异度 ,纵坐标是灵敏度 。
对于医学场景,这个指标很重要。因为临床判断通常不是非黑即白,而是基于概率。比如一个模型输出某患者患病概率为0.73,是否判为阳性,就要靠阈值决定。ROC曲线本质上就是在看“阈值变化时,模型性能如何变化”。
1.2 AUC的实际意义
AUC是ROC曲线下面积。它反映模型整体区分能力。AUC越接近1,说明模型越好;AUC为0.5,说明模型接近随机猜测。
在生物医学研究中,AUC常用于比较不同标志物、不同算法或不同特征组合的预测能力。比如同一组数据里,基因A的AUC为0.81,基因B的AUC为0.69,通常可以认为A的区分能力更强。但AUC高,不代表临床阈值一定合适。 这也是很多论文只报AUC还不够完整的原因。
2. Python实现ROC曲线的标准流程
2.1 先准备二分类数据
ROC曲线适用于二分类任务。你需要两类变量。
- 真实标签,通常是0和1。
- 预测概率,来自逻辑回归、随机森林、XGBoost等模型。
在医学数据里,标签可能代表“是否患病”,“是否复发”,“是否死亡”。预测值最好是概率,而不是硬分类结果。因为ROC要比较的是不同阈值下的表现。如果只输入类别标签,ROC曲线就失去意义。
2.2 用scikit-learn绘制ROC曲线
Python里最常用的是sklearn.metrics。核心函数是roc_curve和roc_auc_score。
from sklearn.metrics import roc_curve, roc_auc_score
import matplotlib.pyplot as plt

y_true = [0, 0, 1, 1, 1, 0, 1]
y_score = [0.12, 0.35, 0.68, 0.72, 0.81, 0.22, 0.66]

fpr, tpr, thresholds = roc_curve(y_true, y_score)
auc_value = roc_auc_score(y_true, y_score)

plt.figure(figsize=(6, 6))
plt.plot(fpr, tpr, color='red', lw=2, label=f'ROC curve (AUC = {auc_value:.3f})')
plt.plot([0, 1], [0, 1], color='gray', lw=1, linestyle='--')
plt.xlabel('1 - Specificity')
plt.ylabel('Sensitivity')
plt.title('ROC Curve')
plt.legend(loc='lower right')
plt.show()
这段代码输出的就是标准ROC图。红线是模型曲线,灰色虚线是随机参考线。 如果曲线明显位于对角线以上,说明模型有预测价值。
2.3 阈值不是越高越好
很多初学者会误以为,只要AUC高就可以直接发表。其实不然。临床决策还要看阈值。
roc_curve会返回thresholds。这些阈值对应每一个分类切点。某个阈值下,你可以得到:
- 灵敏度。
- 特异度。
- 假阳性率。
- 真阳性率。
这一步很关键。因为医学研究通常还要回答一个问题,模型在某个具体切点下,能不能真正用于临床筛查或辅助诊断。
3. 如何从ROC曲线中找到合适阈值
3.1 约登指数是常用选择
在医学研究中,常用约登指数来选择最佳阈值。公式是:
Youden Index = Sensitivity + Specificity - 1
也就是灵敏度和特异度之和减1。这个指标越大,说明该阈值综合表现越好。
Python里可以这样计算:
import numpy as np
from sklearn.metrics import roc_curve

fpr, tpr, thresholds = roc_curve(y_true, y_score)
specificity = 1 - fpr
youden_index = tpr + specificity - 1

best_idx = np.argmax(youden_index)
best_threshold = thresholds[best_idx]
best_sensitivity = tpr[best_idx]
best_specificity = specificity[best_idx]

print(best_threshold, best_sensitivity, best_specificity)
这个方法适合大多数二分类医学预测任务。 但要注意,最佳阈值不是固定真理。筛查研究和确诊研究,阈值策略往往不同。
3.2 结果解释要结合场景
如果是疾病筛查,通常更重视灵敏度。因为漏诊代价高。
如果是确诊或分层,往往更关注特异度。因为误诊会带来不必要检查。
所以,ROC曲线给你的是整体性能,阈值选择才决定临床用途。 这也是生物医学数据挖掘和普通机器学习展示的最大区别之一。
4. 生物医学研究里,ROC曲线怎么做得更规范
4.1 先区分训练集和验证集
如果你直接在训练集上画ROC,AUC往往会偏高。因为模型已经“见过答案”。这会造成过拟合假象。
更规范的做法是:
- 用训练集建模。
- 在验证集上评估。
- 最好再做外部验证。
只有验证集或外部队列上的ROC,才更接近真实临床表现。
这在医学生、医生和科研人员写文章时尤其重要。
4.2 注意样本不平衡问题
在肿瘤、罕见病、预后事件分析中,阳性样本常常很少。此时ROC曲线虽然仍可用,但单看AUC可能会显得“过于乐观”。
这种情况下,建议同时报告:
- 混淆矩阵。
- 精准率。
- 召回率。
- F1值。
- 必要时补充PR曲线。
ROC适合看整体区分度,PR曲线更适合不平衡数据。 这是实际科研里非常常见的搭配。
4.3 报告AUC时最好给出置信区间
只报一个AUC值,不够严谨。更好的方式是同时报告95%置信区间。这样可以体现估计的不确定性。
医学论文中常见写法是:
- AUC = 0.807。
- 95% CI = 0.759–0.855。
这样的表达比单一数值更完整,也更符合统计规范。置信区间越窄,说明结果越稳定。
5. Python里常见的ROC分析扩展
5.1 比较两个模型
在实际研究中,常常需要比较两个模型谁更好。比如:
- 传统临床指标模型。
- 临床指标加分子标志物模型。
这时可以分别画两条ROC曲线,并比较AUC。若要进一步做统计检验,可使用DeLong检验等方法。Python生态里可以借助第三方实现,但要注意方法来源和适用条件。
不要只凭肉眼判断两条曲线谁更强。 如果AUC差异小,往往需要统计检验支持。
5.2 多分类任务不能直接照搬
ROC原本是二分类指标。多分类场景下,一般需要采用one-vs-rest策略,分别计算每个类别的ROC,再做宏平均或微平均。
对于医学研究来说,这常见于:
- 分型诊断。
- 分期预测。
- 多类别病理分类。
如果是多分类问题,必须先明确统计策略,再谈ROC。 否则结果很容易误读。
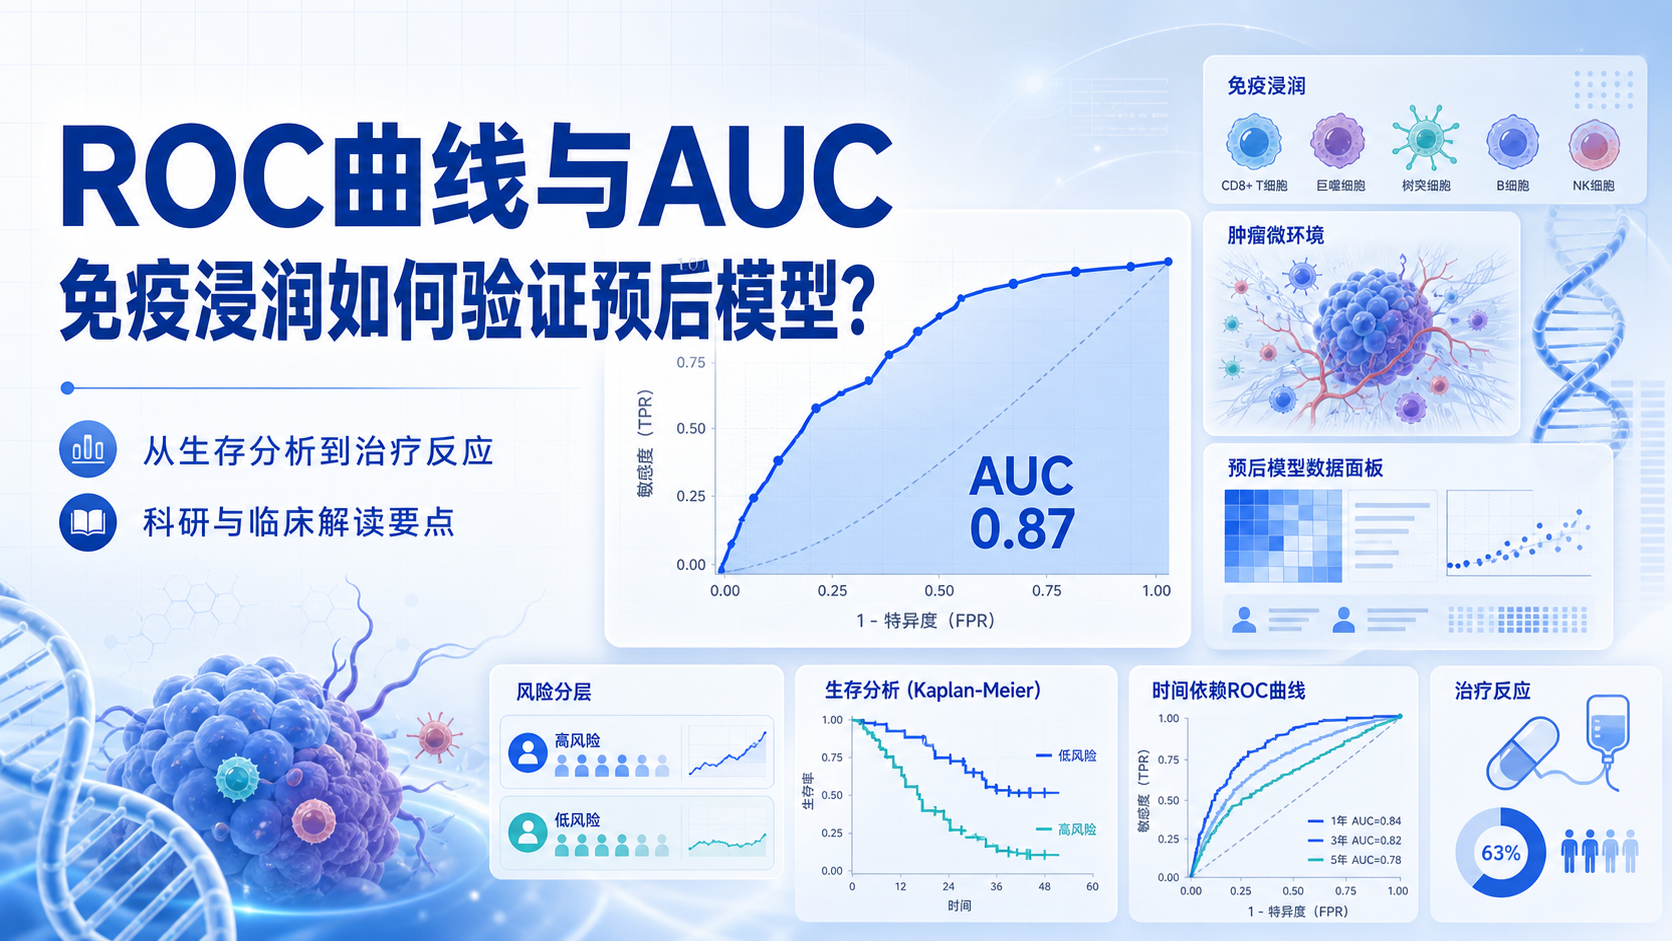
5.3 时间依赖ROC更适合生存分析
如果你的结局是生存时间,而不是简单的0/1分类,那么普通ROC就不够了。应考虑时间依赖ROC,用于评估某个时间点的预测能力。
这在肿瘤预后研究里很常见。比如1年、3年、5年生存预测。
此时更重要的是时间点特异性,而不是单纯一个静态AUC。
6. 一个适合论文写作的ROC分析模板
6.1 推荐的分析顺序
做生物医学ROC分析时,建议按这个顺序:
- 明确结局变量。
- 获取模型预测概率。
- 绘制ROC曲线。
- 计算AUC和95%CI。
- 用约登指数找阈值。
- 报告灵敏度和特异度。
- 如有需要,补充分层或外部验证。
这一套流程更符合论文审稿人的预期。 只要逻辑完整,结果才更有说服力。
6.2 结果描述要简洁准确
论文里可以这样写:
“ROC曲线显示,该模型对结局具有较好的区分能力,AUC为0.807。以约登指数确定最佳截断值后,灵敏度为0.655,特异度为0.806。”
这种写法简短、清楚、可复现。
比单纯写‘模型效果良好’更专业。
7. 结论与实战建议
ROC曲线是生物医学数据挖掘中最基础,也最容易被误用的工具。它能帮助你判断模型是否有区分能力,但不能替代临床决策。真正有价值的分析,必须把AUC、阈值、灵敏度、特异度和验证集结果一起看。
如果你正在做论文、课题或模型验证,建议把ROC分析做规范。这样更容易通过审稿,也更容易转化为临床解释。想提升ROC分析、Python绘图和医学统计写作效率,可以直接使用解螺旋 的系统化内容与实战支持,帮助你少走弯路,更快完成高质量研究。
- 引言Introduction
- 1. ROC曲线是什么,为什么生物医学研究离不开它
- 2. Python实现ROC曲线的标准流程
- 3. 如何从ROC曲线中找到合适阈值
- 4. 生物医学研究里,ROC曲线怎么做得更规范
- 5. Python里常见的ROC分析扩展
- 6. 一个适合论文写作的ROC分析模板
- 7. 结论与实战建议