20
 分享
引言Introduction
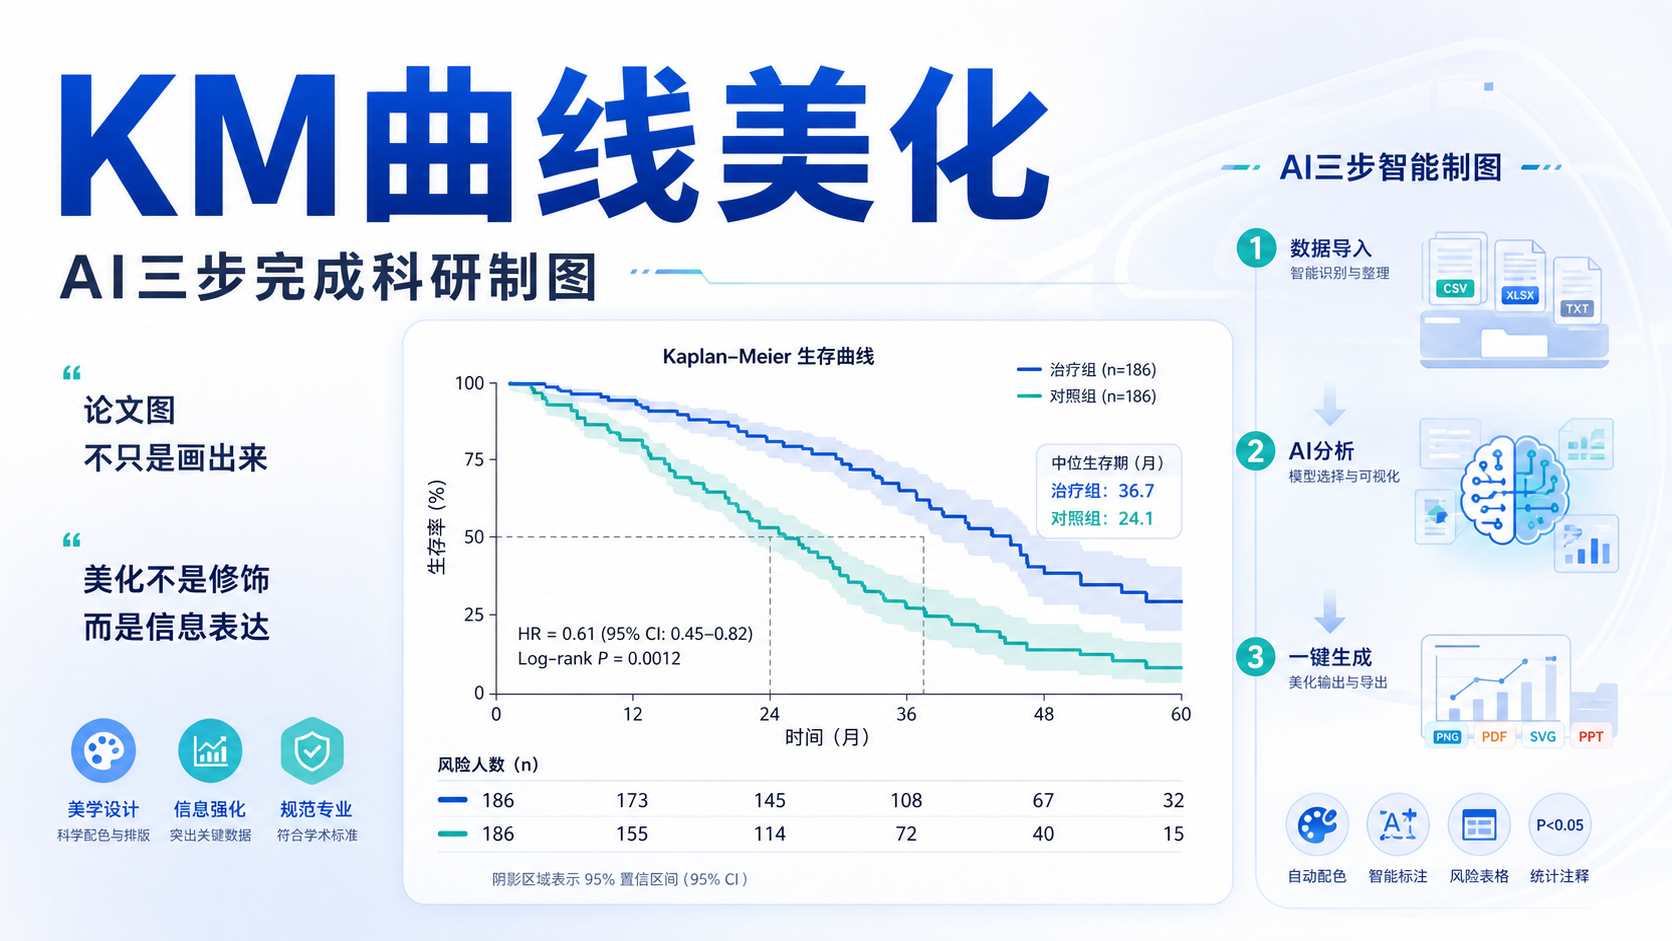
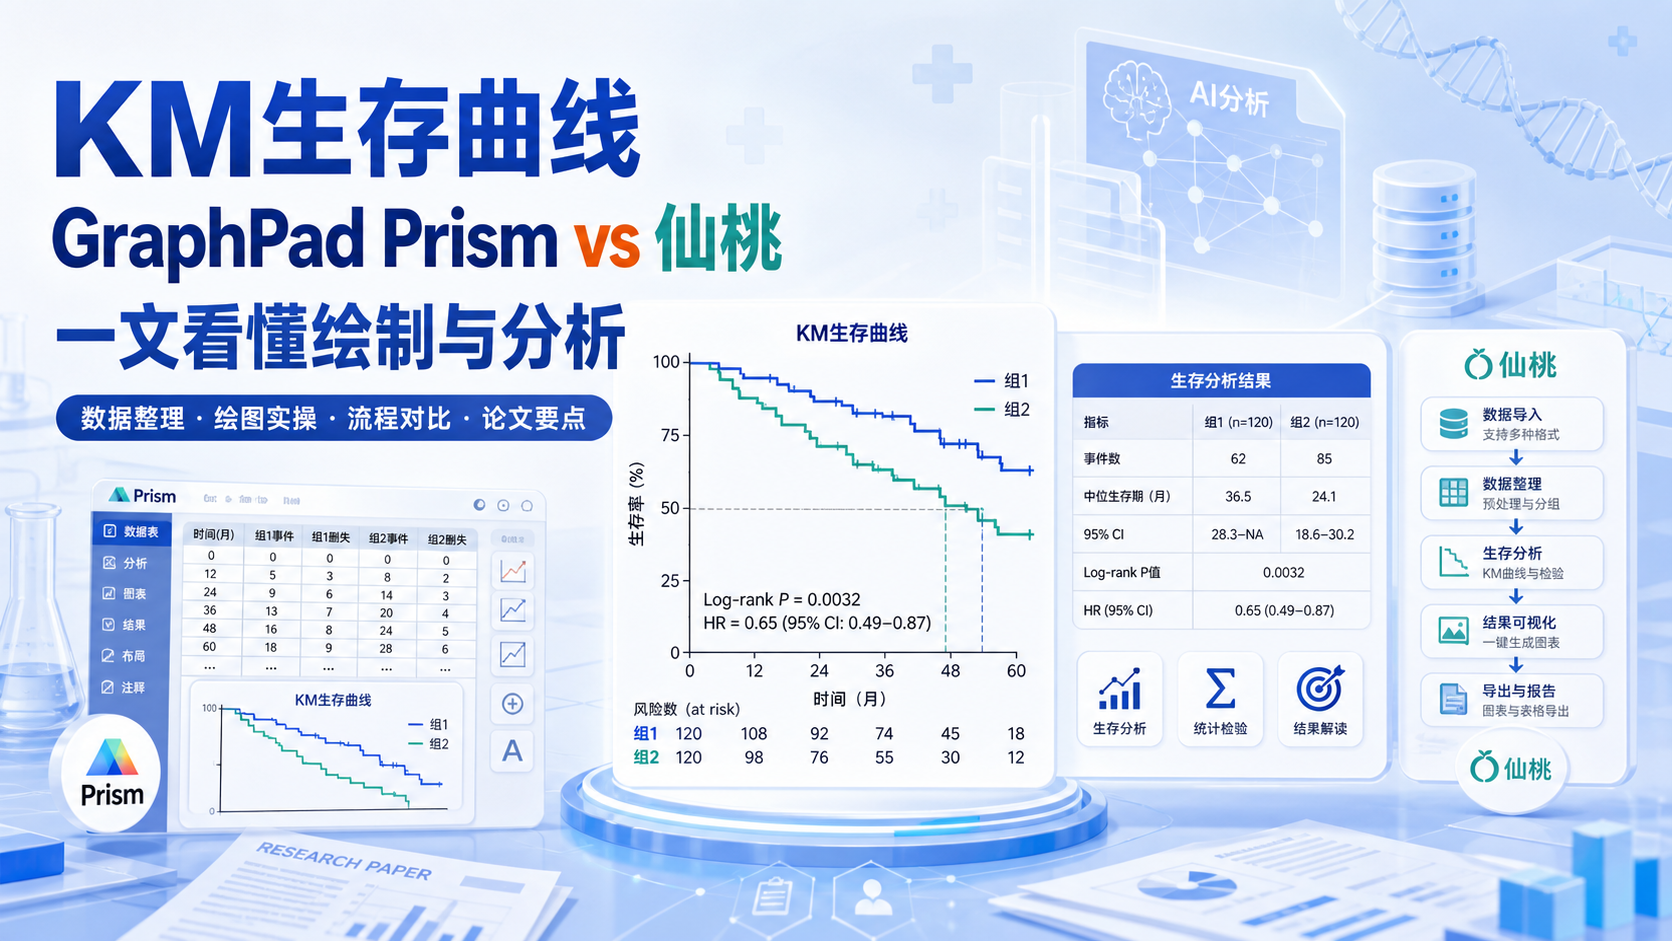
KM生存曲线是临床研究中最常用的预后分析工具之一。但很多人只会画图,不会判断何时适用、如何解读、怎样避免常见错误。如果删失处理不当,结论就可能失真。

1. KM生存曲线到底解决什么问题
1.1 用时间维度回答“能活多久”
KM生存曲线,也叫Kaplan-Meier曲线,核心任务是估计生存函数。它回答的是,在某个时间点之后,研究对象仍然存活或未发生事件的概率是多少。
这类问题在肿瘤预后、复发时间、无进展生存期、移植结局中都很常见。相比只看终点事件比例,KM曲线把“时间”纳入分析,更符合临床真实过程。
1.2 生存分析不是简单统计人数
生存分析关注两件事。第一,事件有没有发生。第二,事件发生在什么时候。
这也是KM法的价值所在。 它不只看结局,还利用了每一位受试者的随访时间信息。哪怕有人中途失访,只要删失时间明确,仍可纳入估计。
1.3 适合回答组间预后差异
KM曲线最常用于比较两组或多组患者的生存差异,比如治疗组与对照组,基因高表达组与低表达组,分期早与分期晚组。
当研究目的在于比较不同组的预后曲线时,KM分析是首选方法之一。
2. KM法的适用前提与数据要求
2.1 适用未分组或分组随访数据
KM法本质上是非参数方法,常用于样本量不大、数据未服从特定分布的场景。它适合未分组资料,也适合按临床因素分组后的比较。
常见数据字段包括:
- 随访时间。
- 结局状态,通常用1和0编码。
- 分组变量,如性别、治疗方案、分子分型。
2.2 必须正确处理删失
删失是KM分析的关键概念。它表示随访结束时事件未发生,或患者失访、退出观察。
删失不是失败数据,而是“截至目前未观察到事件”。 在KM法中,删失个体仍会参与删失前的风险集计算,但不会被当作事件发生。
临床数据中常见三类情况:
- 完全结局,事件已发生。
- 右删失,随访截止仍无事件。
- 失访删失,后续状态未知。
2.3 事件定义必须与研究终点一致
KM曲线并不只用于死亡结局。它也可用于复发、进展、转移等终点。
因此,结局定义必须与研究问题一致。 如果研究的是无复发生存,事件就应定义为复发,而不是死亡。终点设定一旦混乱,整条曲线的解释都会偏离临床意义。
3. KM曲线的估计原理,临床上怎么理解
3.1 生存率是逐段相乘得到的
KM法的基本思想是,将所有生存时间按从小到大排序,在每个事件时间点估计该时段的生存概率,再逐段相乘得到累计生存率。
公式上可写为:S(tk)=p1×p2×…×pk。
这意味着,某个时点的生存率不是单独算出来的,而是建立在前面每个时间段生存概率的基础上。
3.2 曲线为什么是阶梯形
KM曲线不是平滑下降,而是阶梯状下降。原因很简单。
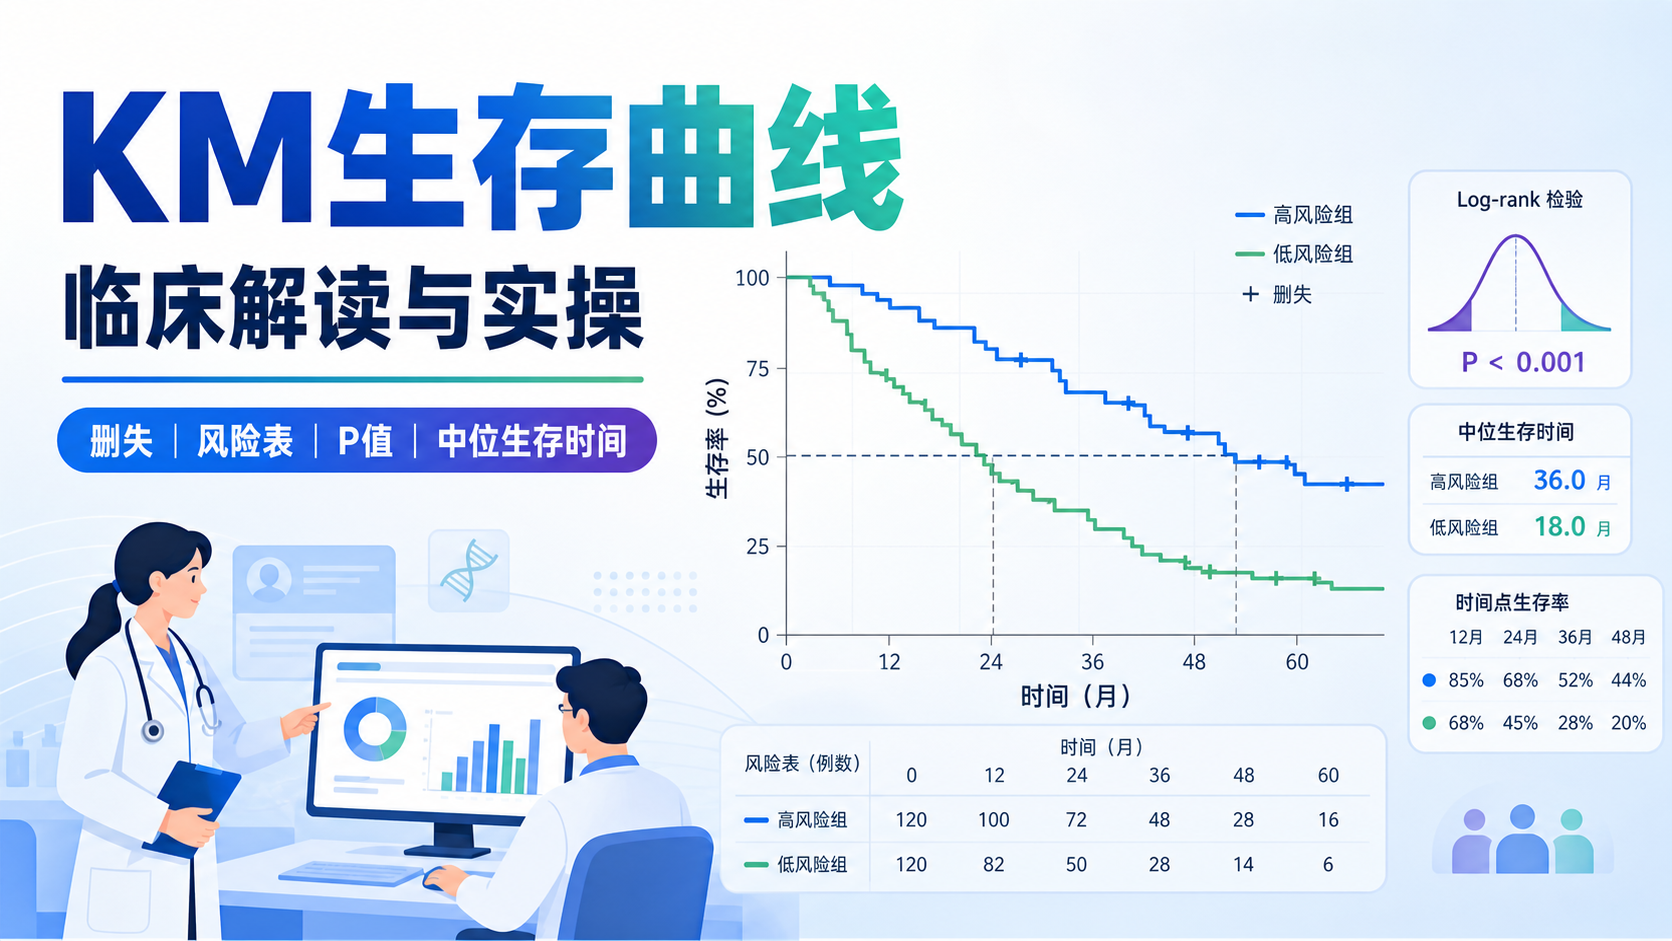
在两个事件时间点之间,生存率保持不变。 一旦发生死亡或其他终点事件,曲线就在该时间点下降。删失点通常以符号标记,不会直接导致曲线下降。
3.3 中位生存时间怎么读
中位生存时间是KM结果里非常重要的指标。它指的是累计生存率降到0.5时对应的时间。
临床解释很直接。如果中位生存时间为13个月,说明50%的研究对象在13个月时仍然存活或未发生终点事件。
如果曲线始终未降到0.5,中位生存时间就无法直接估计,需要报告其他分位数或限制平均生存时间。
4. KM生存曲线临床应用中的关键技巧
4.1 先看曲线形态,再看P值
很多人一上来只盯着P值,这是常见误区。
正确顺序应是:
- 看曲线是否有明显分离。
- 看是否存在交叉。
- 再看统计学检验结果。
如果两条曲线明显分离,且随时间差异稳定,临床解释更有说服力。 如果曲线交叉,单纯依赖log-rank检验就可能不够稳妥。
4.2 log-rank检验适合曲线不交叉的情况
KM分析常配合log-rank检验比较组间差异。它对远期差异更敏感,因此特别适合观察时间越长差异越明显的场景。
例如某治疗早期效果接近,但随着随访延长,生存差异逐渐拉开,log-rank检验往往更合适。
如果曲线明显交叉,就要警惕log-rank检验的适用性。
4.3 风险表比单纯曲线更重要
绘图时建议同时展示风险表。风险表能告诉读者每个时间点仍在随访中的人数。
这很重要,因为后期样本越来越少,曲线尾端的不稳定性会明显增加。
当风险集人数过低时,尾端曲线的临床解释要谨慎。
4.4 尽量报告时间点生存率
除了中位生存时间,建议在论文中补充1年、3年、5年生存率。
这能让临床读者更快理解预后差异,也更方便与既往研究对照。
例如,在肿瘤研究中,1年和3年生存率常比单一中位生存时间更具应用价值。
5. 常见错误与如何避免
5.1 把删失当成事件
这是最严重的错误之一。删失个体不是死亡,也不是结局发生。
如果将删失错误编码为事件,生存率会被系统性低估,导致结论偏差。
建模前必须统一编码规则。 尤其要确认1和0分别代表什么。
5.2 样本量太小还强行分组
KM曲线可以用于小样本,但不等于样本越少越能随意分组。
如果分组后某一组事件数过少,曲线会非常不稳定,P值也不可靠。
临床研究中,通常要关注每组的事件数,而不只是总样本量。
5.3 忽略比例风险之外的结构问题
KM曲线本身只是描述性分析,不直接控制混杂因素。
如果组间年龄、分期、治疗方案差异明显,KM结果只能说明“表面上的生存差异”。
要进一步判断独立预后因素,通常还需要Cox回归。
5.4 曲线交叉仍机械解读
曲线交叉提示风险随时间变化,或组间效应不恒定。
这种情况不应简单下结论说“哪组更好”。更合理的做法是结合分层分析、landmark分析,或进一步检查比例风险假设。
这是KM图在临床研究中最容易被误读的地方。
6. 写论文和作图时的实操建议
6.1 图形表达要规范
一张合格的KM图,通常应包含:
- 横轴为随访时间。
- 纵轴为生存率。
- 组别颜色区分。
- 删失标记。
- 风险表。
- P值或log-rank结果。
图的目标不是“好看”,而是让审稿人一眼看懂分组差异、随访结构和统计结论。
6.2 结果描述要简洁但完整
正文中建议写清楚:
- 使用的终点类型,如OS、DSS、PFI。
- 使用的统计方法,如Kaplan-Meier和log-rank检验。
- 主要结果,如中位生存时间、各时间点生存率、P值。
例如,可写为:
“高表达组的中位生存时间低于低表达组,KM曲线显示两组生存差异具有统计学意义。”
这种表述比单纯写“有差异”更规范。
6.3 分析前先检查数据质量
在进入KM分析前,建议先核对:
- 时间变量是否单位统一。
- 结局编码是否正确。
- 是否存在重复记录。
- 是否有明显异常值。
- 分组变量是否定义一致。
前期数据清洗做得好,后面的曲线才可信。
7. KM曲线临床应用的真正价值
7.1 它帮助你把预后差异可视化
KM曲线最大的优势是直观。它把复杂的随访数据转成一张图。
对医学生、医生和科研人员来说,这种图不仅便于汇报,也便于在论文中展示分组预后差异。
7.2 它是进入更深入分析的起点
KM分析往往是第一步。
如果KM提示组间存在差异,下一步可以结合Cox回归寻找独立危险因素,或者结合亚组分析、分层分析做更深入解释。
KM负责“看见差异”,Cox负责“解释差异”。
7.3 借助专业工具提高效率
如果你希望快速完成规范的KM分析、出图和结果整理,可以使用更成熟的科研工具平台。解螺旋 提供面向临床研究场景的分析支持,可帮助你更高效完成生存曲线绘制、结果展示和论文表达,减少重复劳动,把更多时间留给机制分析与论文打磨。
总结Conclusion
KM生存曲线是临床预后评估中最基础,也最实用的方法之一。它适合描述时间到事件结局,能处理删失数据,能直观比较不同组的生存差异。
但要真正用好它,关键不在于“会不会画图”,而在于是否正确定义终点、正确处理删失、正确解读曲线和P值。
如果你正在做临床研究、毕业课题或论文投稿,建议把KM分析作为标准流程的一部分。需要更高效、更规范的分析支持时,可以进一步了解解螺旋 ,让生存曲线分析更快落地。
- 引言Introduction
- 1. KM生存曲线到底解决什么问题
- 2. KM法的适用前提与数据要求
- 3. KM曲线的估计原理,临床上怎么理解
- 4. KM生存曲线临床应用中的关键技巧
- 5. 常见错误与如何避免
- 6. 写论文和作图时的实操建议
- 7. KM曲线临床应用的真正价值
- 总结Conclusion