28
 分享
引言Introduction
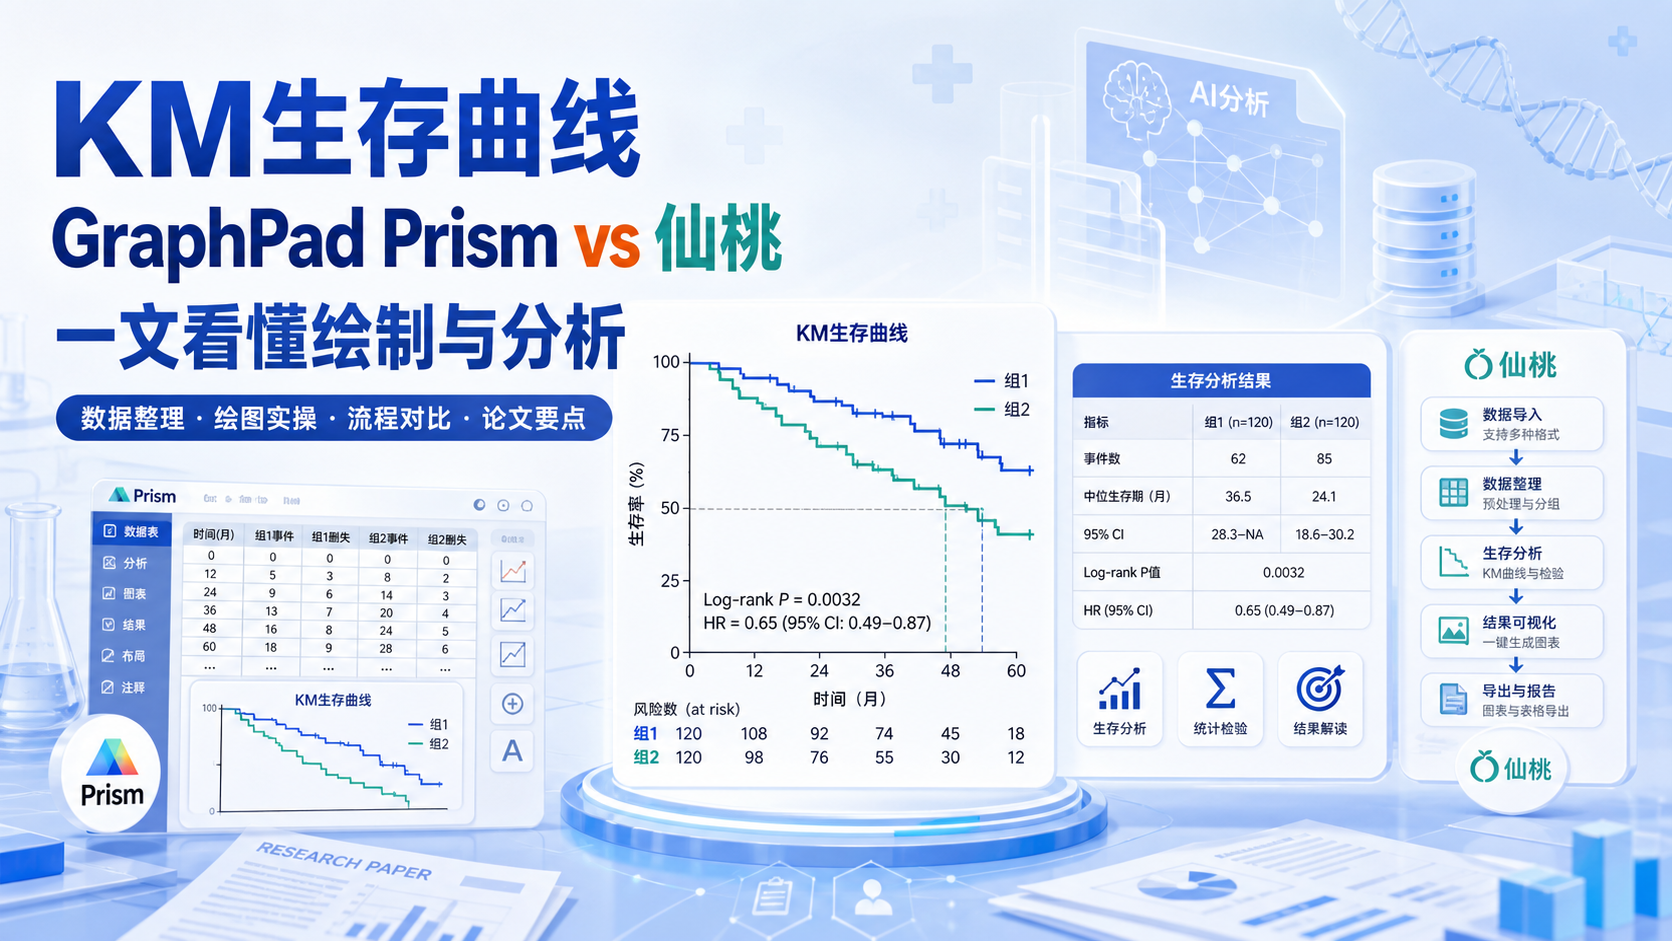
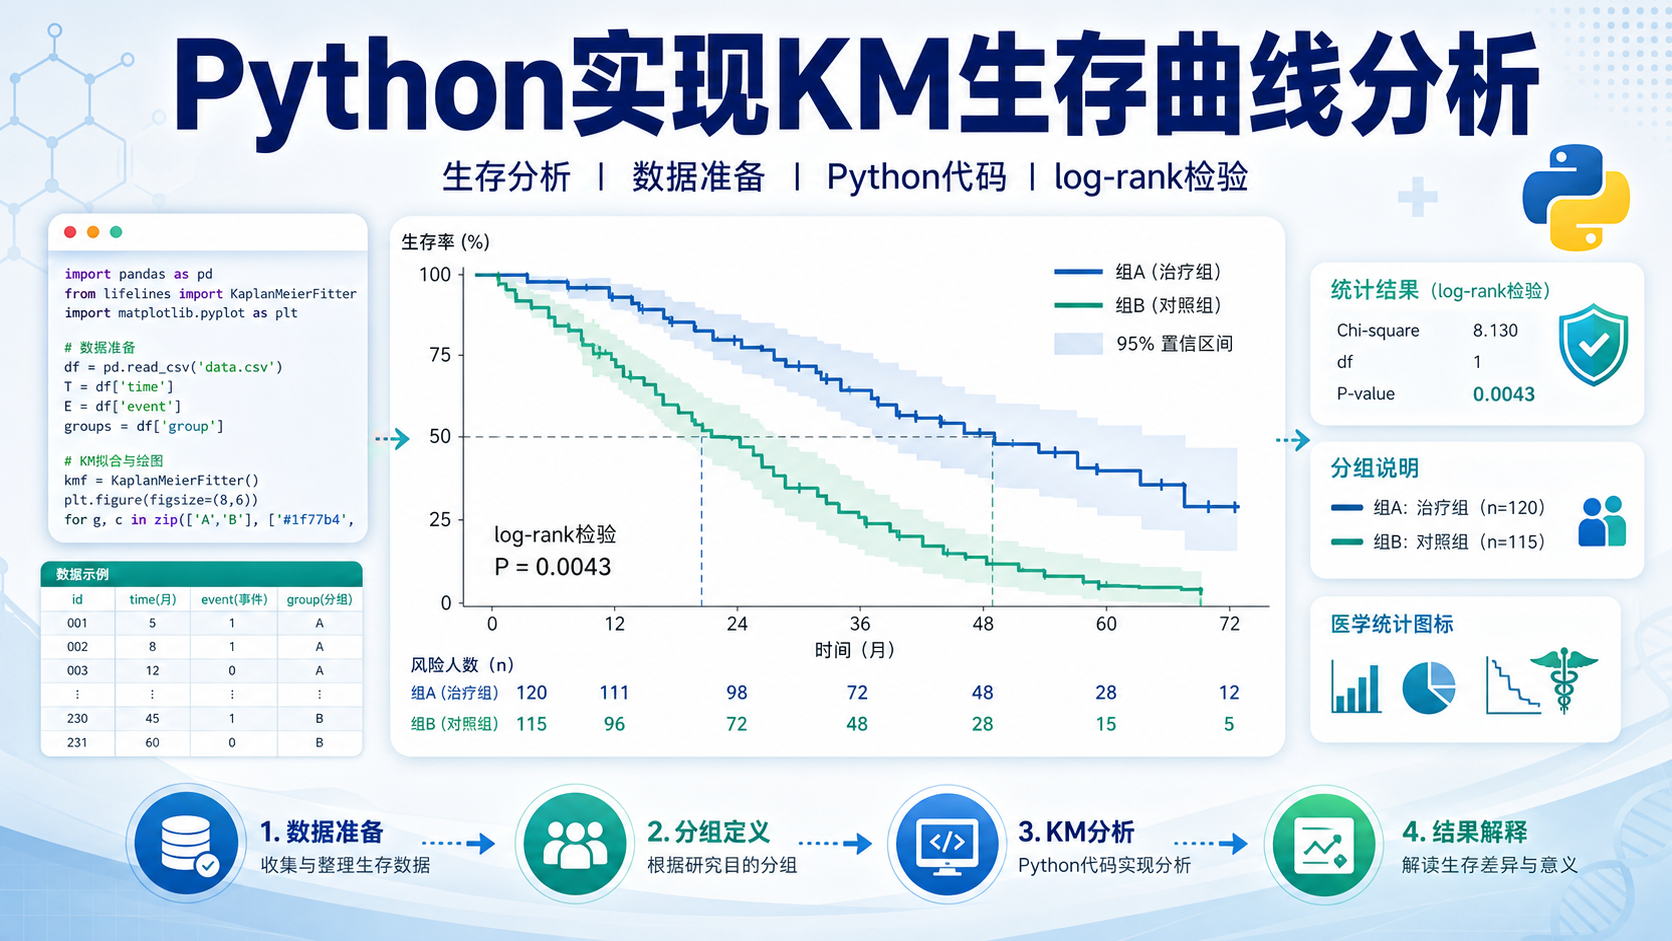
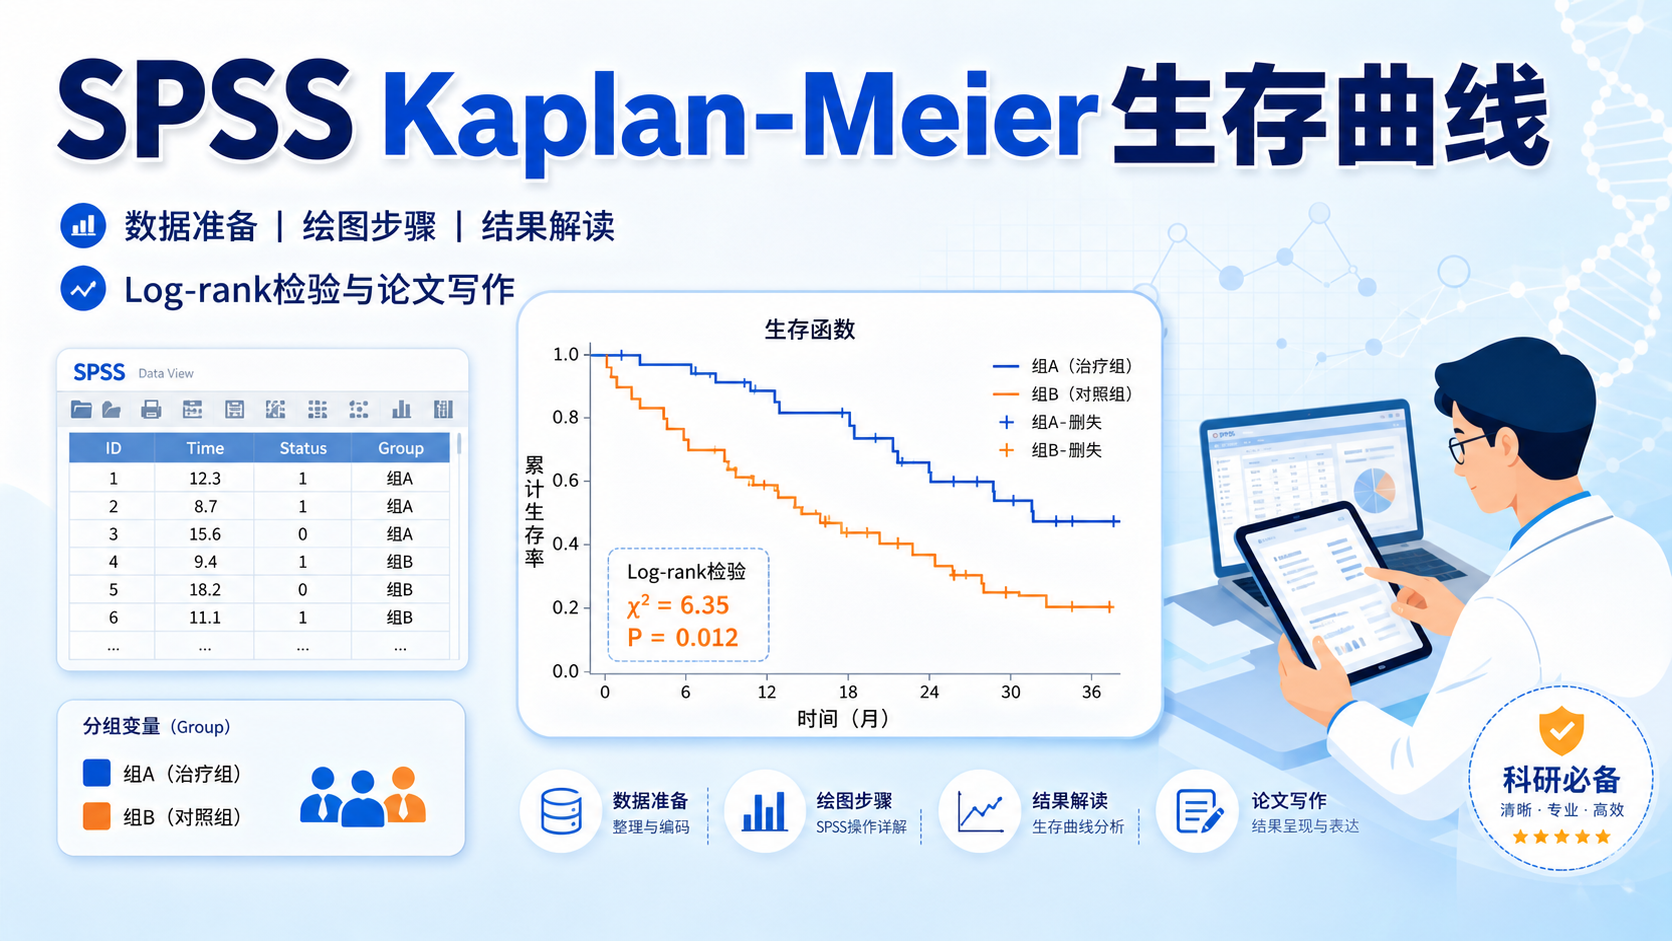
KM生存分析是临床科研里最常见的图之一,但很多人卡在数据格式、分组和出图细节上。曲线会画,但结果不一定能解释清楚。 更麻烦的是,审稿人常会追问事件定义、删失处理和P值来源。
1. KM生存分析到底在分析什么
1.1 先理解时间、事件和删失
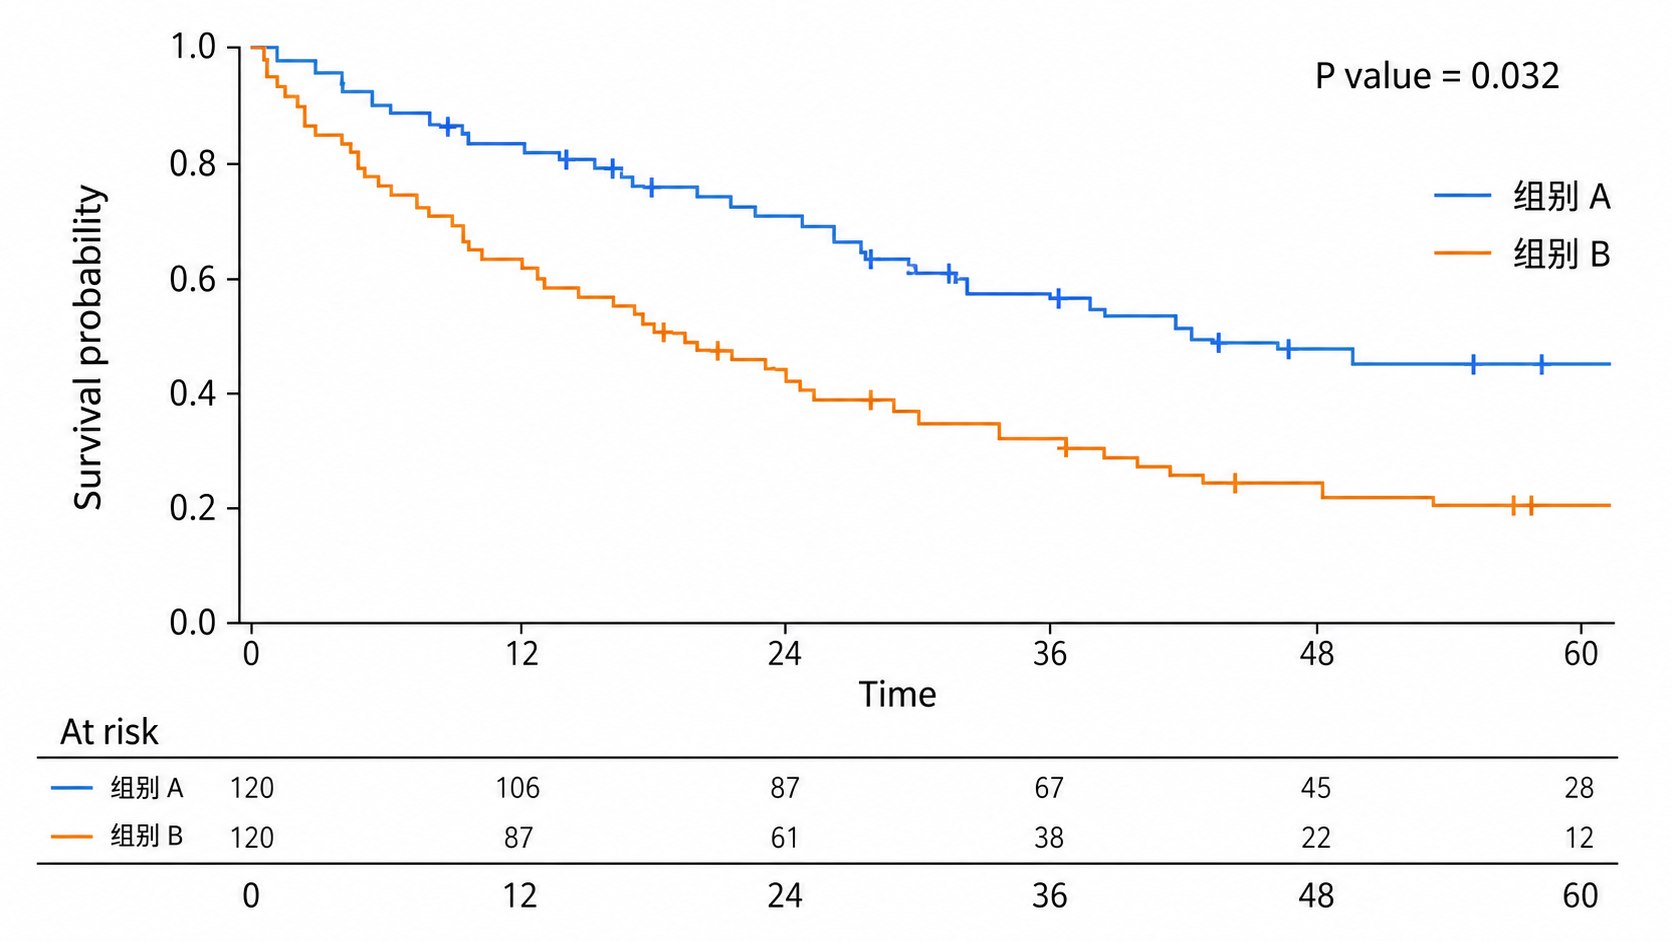
KM分析研究的核心不是“活多久”,而是**“在多长时间内发生了结局事件”** 。结局事件可以是死亡、复发、进展,也可以是研究自定义的终点。只要事件发生,就记为1。未发生,就记为0。
在实际数据里,最容易出问题的是删失。删失不是错误,而是随访截止时事件未发生,或患者失访。如果失访率过高,结论可信度会明显下降。 临床研究中,失访率一般建议控制在20%以内。
1.2 KM曲线为什么适合临床研究
KM曲线的优势很直接。它能处理不同入组时间、不同随访长度和删失数据。对于医学生、医生和科研人员来说,这种方法非常适合回顾性队列和小中样本研究。
KM分析还便于组间比较。比如按基因高低表达、治疗反应、分子分型、临床分期分组后,可以快速判断两组生存是否存在差异。如果你需要一张能直观展示预后差异的图,KM曲线几乎是首选。
2. 做KM生存分析前要准备什么
2.1 数据结构必须正确
KM分析最少需要三列信息。
- 生存时间,通常记为
time或os_time。 - 结局状态,通常记为
status。 - 分组变量,通常记为
group。
其中,status 的编码一定要统一。多数R包默认将事件记为1,删失记为0。 如果编码反了,图会画出来,但结果是错的。
2.2 数据清理比建模更重要
正式分析前,建议先检查以下几点。
- 是否有缺失值。
- 生存时间是否为数值型。
- 状态变量是否只有0和1。
- 分组样本是否与临床数据一一对应。
- 是否存在重复样本。
这些步骤看起来基础,但实际文章返修中,经常就是这里出问题。R语言代码只是工具,真正决定结果质量的是前处理。
2.3 分组方式要有依据
分组不能随意。常见方式包括中位数分组、最佳截点分组、临床阈值分组和文献阈值分组。不同分组方式会影响曲线形态和P值。
如果是机制研究或模型验证,建议优先使用预先设定的阈值 ,这样更符合E-E-A-T中的可验证性和可重复性。若使用中位数分组,解释更稳妥,但可能会降低临床可转化性。
3. KM生存曲线R语言代码怎么做
3.1 先加载常用R包
KM分析最常用的是 survival 和 survminer。前者用于建模,后者用于可视化。
library(survival)
library(survminer)
如果你还要做数据整理,可以同时加载 tidyverse。
library(tidyverse)
3.2 构建生存对象
KM分析的关键是把时间和结局合并成生存对象。
fit <- survfit(Surv(os_time, status) ~ group, data = exp_cli)
这里的含义很清楚。Surv(os_time, status) 表示生存时间和结局状态。~ group 表示按组比较。fit 就是拟合后的KM对象。
这一步是KM生存曲线R语言代码的核心。 只要数据格式正确,后面出图就很顺。
3.3 计算组间差异
KM曲线通常配合 log-rank 检验。它用于判断两组生存曲线是否有统计学差异。
diff <- survdiff(Surv(os_time, status) ~ group, data = exp_cli, rho = 0)
pvalue <- pchisq(diff$chisq, length(diff$n) - 1, lower.tail = FALSE)
pvalue
rho = 0 对应标准的 log-rank 检验。如果P值小于0.05,说明组间生存差异具有统计学意义。
3.4 直接绘制KM曲线
最常用的可视化函数是 ggsurvplot()。
ggsurvplot(
  fit,
  data = exp_cli,
  pval = TRUE,
  linetype = "solid",
  palette = c("#4DBBD5", "#E64B35"),
  title = "SYNGR2",
  legend.title = "SYNGR2",
  legend.labs = c("High", "Low"),
  conf.int = TRUE,
  conf.int.style = "ribbon",
  conf.int.alpha = 0.1,
  risk.table = TRUE
)
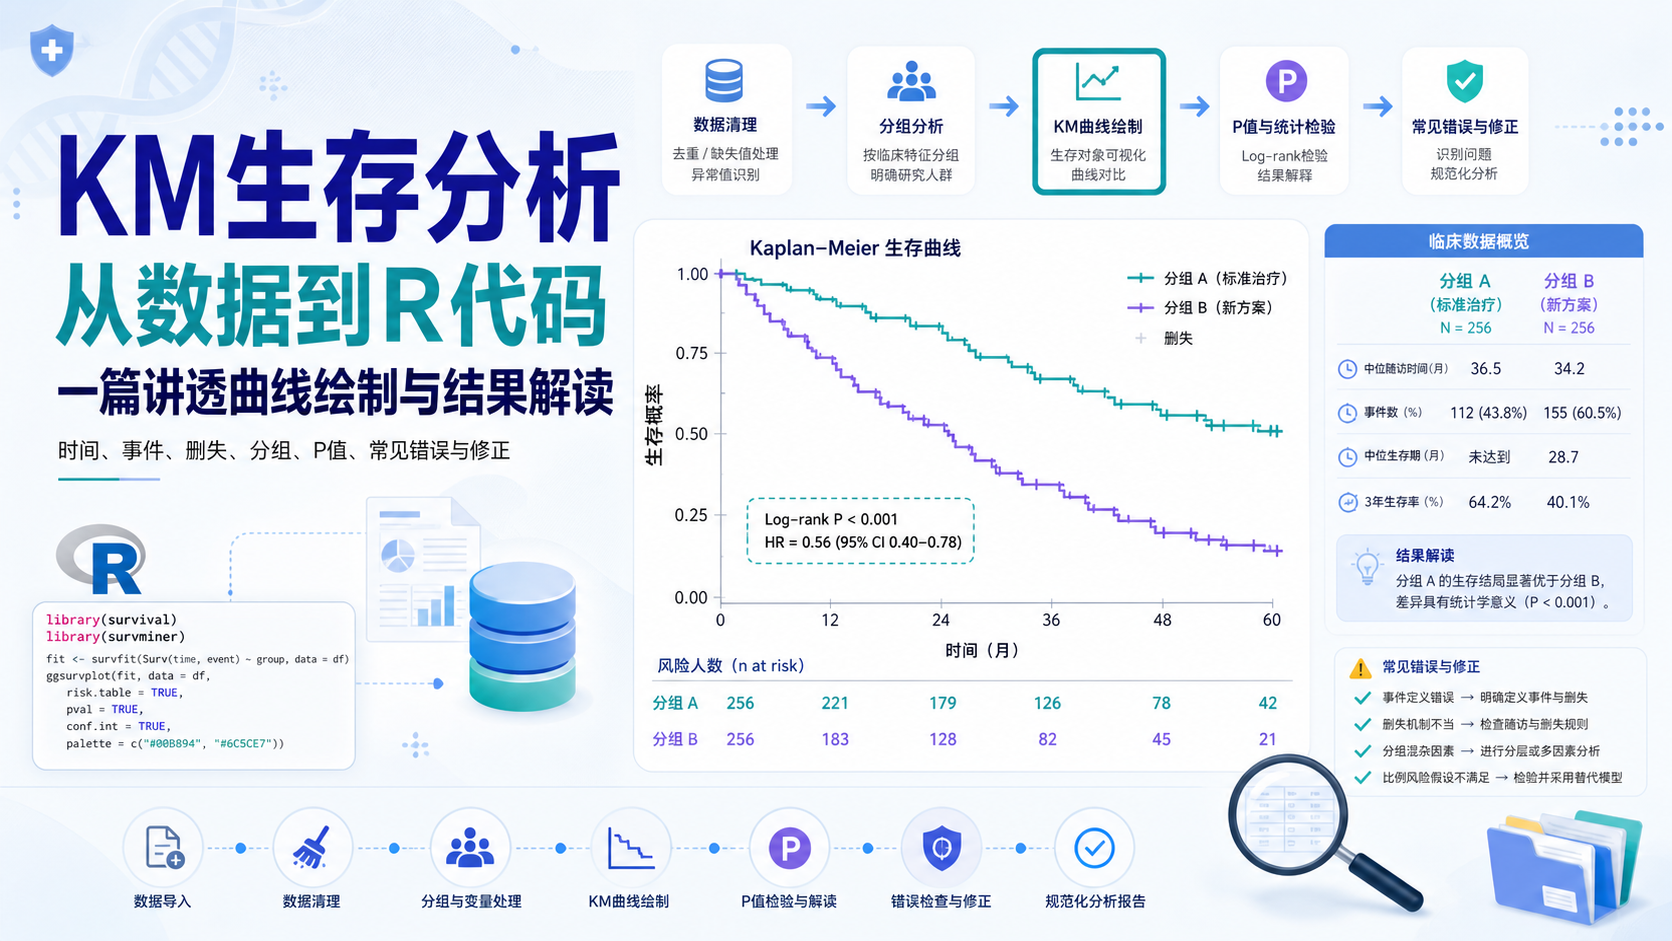
这段代码会同时输出KM曲线、P值、置信区间和风险表。风险表很重要,它能告诉读者每个时间点还剩多少样本在随访。 对临床论文来说,这比单纯一张曲线更完整。
4. 结果该怎么解释才专业
4.1 先看曲线,再看P值
很多人上来只看P值,这不够。正确顺序是:
- 看曲线是否分离。
- 看删失点是否过多。
- 看风险表是否在后期样本过少。
- 最后再看P值。
如果后期样本量非常少,即使P值显著,结论也要谨慎解释。
4.2 曲线交叉时不要机械使用log-rank
当KM曲线交叉时,log-rank检验可能不再合适。因为它更强调整个随访过程中的总体差异。若早期和晚期趋势相反,就可能出现解释困难。
这种情况下,通常需要进一步考虑分段分析、landmark分析或其他生存方法。不要为了“出图好看”而忽略统计假设。
4.3 KM图的标准表达方式
写论文时,建议把结果表达得更完整。
- 说明分组依据。
- 说明事件定义。
- 说明使用的检验方法。
- 给出HR时要注明是否来自Cox回归。
- 给出P值和样本量。
例如可以写成:高表达组的总生存率显著优于低表达组,log-rank检验P<0.05。这样更符合论文写作规范,也更容易通过审稿。
5. KM生存分析常见错误与修正
5.1 状态变量编码错误
这是最常见的问题之一。很多初学者会把“存活”记为1,把“死亡”记为0,导致模型方向完全相反。
在R里做KM分析前,务必先确认事件编码。
5.2 样本ID对不上
表达矩阵和临床数据经常因为ID格式不同而无法正确匹配。常见问题包括:
- 样本ID长度不一致。
- 一个患者对应多个样本。
- 临床表和表达表顺序不一致。
解决方法是先统一ID,再去重,再取交集。数据配对正确,分析才可信。
5.3 生存时间单位混乱
有些数据用天,有些用月,有些用年。混用后,图形虽然能出,但临床解释会失真。
建议在作图前统一单位,并在图注中明确标注。
5.4 只做图,不做解释
KM曲线不是“作图任务”,而是分析工具。论文里必须说明:
- 为什么这样分组。
- 事件是什么。
- 曲线差异代表什么。
- 结论是否与其他分析一致。
单独一张KM图不能替代完整的生存分析逻辑。
6. 用解螺旋快速完成KM分析,能省什么
6.1 适合科研人员批量出图
如果你在做多个基因、多个分组或多个队列的预后分析,手写代码会比较耗时。尤其是样本整理、分组、出图、批量导出这些步骤,重复劳动很多。
这时候可以借助解螺旋的分析流程和图形化工具,快速完成KM生存分析的标准化输出。
6.2 更适合需要规范化结果的场景
对于投稿来说,图的统一性很重要。颜色、字体、风险表、P值位置和图例格式都需要一致。使用解螺旋的流程化工具,可以减少手工调整带来的格式误差。
这对医学生、医生和科研人员尤其有价值,因为它能把更多时间留给结果解读和论文写作。
总结Conclusion
KM生存分析的本质,是用时间和事件来比较不同组的预后差异。它的关键不在于“会不会画图”,而在于数据是否正确、分组是否合理、事件定义是否清晰、统计方法是否匹配 。掌握 survival 和 survminer 后,KM生存曲线R语言代码其实并不复杂。
如果你想更高效地完成规范化生存分析和出图,可以进一步使用解螺旋 的工具和流程,减少重复操作,提高科研产出效率。
- 引言Introduction
- 1. KM生存分析到底在分析什么
- 2. 做KM生存分析前要准备什么
- 3. KM生存曲线R语言代码怎么做
- 4. 结果该怎么解释才专业
- 5. KM生存分析常见错误与修正
- 6. 用解螺旋快速完成KM分析,能省什么
- 总结Conclusion