7
 分享
引言Introduction
FASTQ是RNA-seq、WES等测序分析的起点。很多人拿到原始数据后,最先卡在质控判断。如果QC不过关,后续比对、定量和差异分析都会被放大误差。 本文结合实操流程,梳理FASTQ分析的关键步骤和常见质控要点。
1.FASTQ是什么,为什么必须先做质控
1.1 FASTQ文件的基本结构
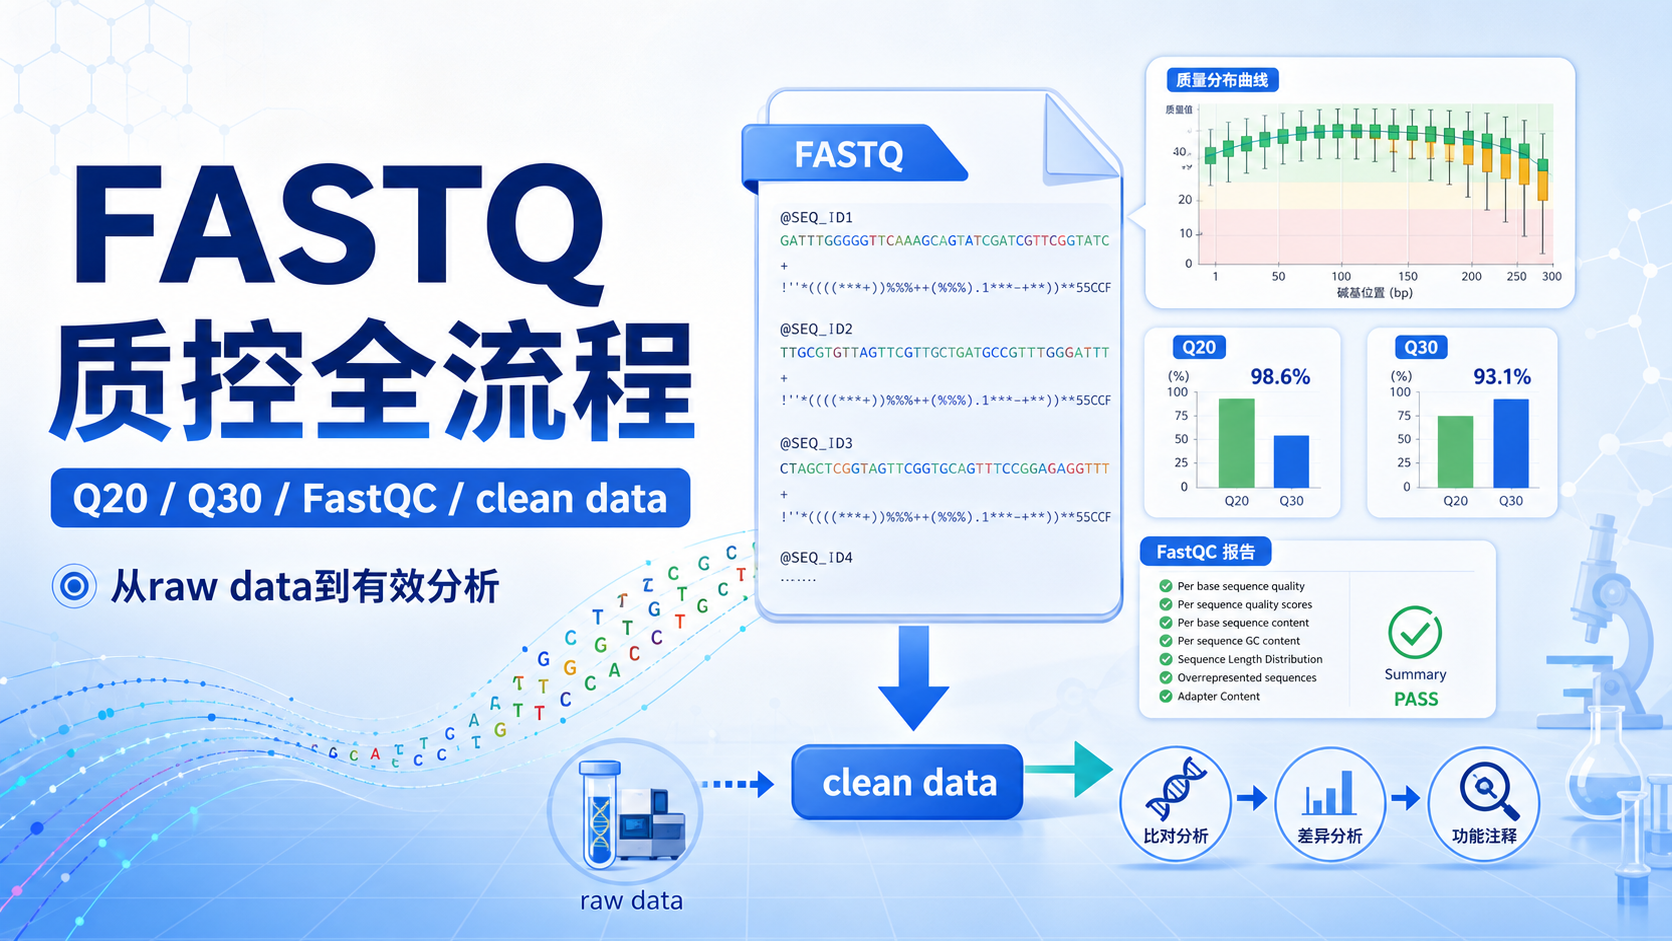
FASTQ文件是测序数据的标准格式。每个read通常由4行组成。
第一行以“@”开头,记录序列标识信息。第二行是真实碱基序列,如ATCG。若出现N,说明该位点测定不确定。第三行通常是“+”。第四行是与每个碱基一一对应的质量值。
这种结构决定了FASTQ不能直接用于下游分析。先看序列对不对,再看质量高不高,最后才能进入比对或组装。
1.2 从raw data到clean data的必要过程
FASTQ原始数据一般要经过QC和filter。前者是质量检查,后者是过滤低质量序列、接头污染和过多不确定碱基。只有生成clean data,才能进入后续比对、组装、定量、差异基因和注释分析。
在RNA-seq里,质控不只是“看一眼图”。它直接影响比对率、基因覆盖均匀性和表达矩阵可信度。对科研人员来说,这一步相当于为后面的统计分析打地基。
2.质控怎么看,重点关注哪些指标
2.1 Q值、Q20、Q30到底代表什么
质量值通常用Q值表示。常用判断标准有:
- Q20,准确率约99%以上。
- Q30,准确率约99.9%。
- Q40、Q50代表更高准确率。
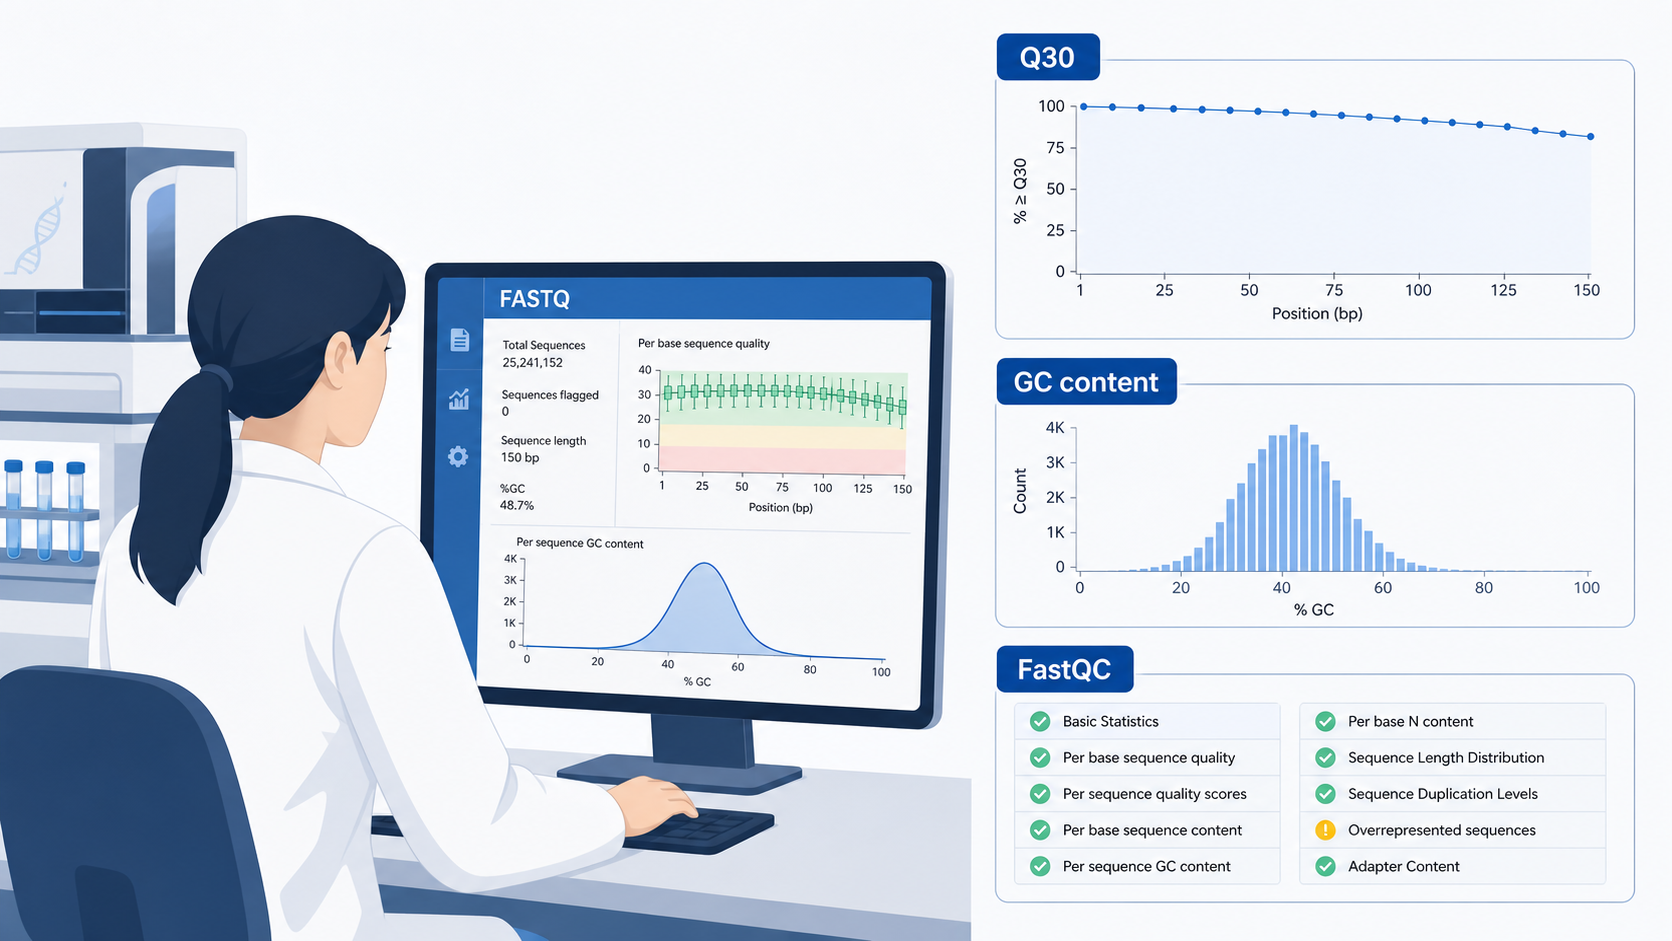
在实际分析中,Q30是最常用的分界线。 如果碱基质量曲线能稳定落在Q30以上,通常说明数据质量较好。对绝大多数二代测序项目来说,这已经是比较理想的基础。
2.2 FastQC报告最该看什么
FastQC是最常见的质控工具之一。它能输出HTML报告,方便快速查看关键指标。常看的部分包括:
- 基本信息,文件名、文件类型、编码方式、序列长度、GC含量。
- 碱基质量分布。
- 序列重复水平。
- Adapter含量。
- N碱基比例和序列长度分布。
真正最值得优先关注的是碱基质量。 如果大部分碱基质量处于绿色通过区间,说明数据基础较稳。GC含量也要看,但它更多是辅助判断。人类样本常见GC含量大约在50%左右,轻微波动通常可接受。
2.3 哪些“不过关”不必过度紧张
质控里有些指标经常会亮黄灯或红灯,但不一定意味着数据不能用。典型例子是:
- sequence duplication levels。
- 部分Adapter残留。
- 某些长度分布偏移。
尤其在转录组数据中,重复水平偏高并不罕见。因为某些高表达基因会被测到很多次。不能只看单个红灯就否定整份数据,要结合实验设计和样本类型综合判断。
3.FASTQ分析流程怎么做,实操顺序要清楚
3.1 先确认数据,再进入分析
拿到测序文件后,第一步先确认文件格式和命名。常见场景是从SRA或测序公司获得.gz压缩文件,之后解压成FASTQ。进入对应目录后,先检查文件是否完整,再决定是否清理旧文件。
如果同一目录下有旧的FASTQ或重复文件,建议先删除无关数据,避免后续混淆。文件管理清晰,是批量分析稳定运行的前提。
3.2 用FASTQC做质控检查
FASTQC的基础命令很直接。可以对单个文件做质控,也可以同时处理多个文件。常见参数有:
- -o,用于指定输出路径。
- -t,用于指定线程数。
例如,批量分析时可以通过循环命令依次读取多个样本。线程数的设置要结合电脑配置。不是线程越多越好,而是要在稳定和速度之间平衡。
3.3 批量分析时要注意什么
批量FASTQ分析最容易出问题的是文件对应关系。比如双端测序数据,R1和R2必须一一对应。只要一个样本的配对关系错了,后面的比对和定量都会受影响。
建议在进入批量处理前,先确认:
- 样本编号是否统一。
- R1、R2是否成对。
- 输出目录是否独立。
- 中间文件是否可追溯。
对医学生和科研人员来说,批量处理最怕的不是慢,而是错配。
4.如何解读质控结果,避免被表面图形误导
4.1 碱基质量曲线是第一优先级
在FastQC报告中,碱基质量曲线是核心。一般来说,前中后段的质量都应尽量稳定。如果后段略有下降,常见于读长末端质量衰减,这是二代测序中比较典型的现象。
判断时不要只盯着“是否掉线”,而要看下降幅度是否影响整体数据可用性。如果主要读段质量仍然稳定,通常可以继续下游分析,必要时再做修剪。
4.2 GC含量和重复水平怎么理解
GC含量主要用于看样本是否存在明显偏差。不同物种和不同文库类型会有差别,但若偏离预期太多,需要警惕污染、偏倚或建库问题。
重复水平则更复杂。它受表达量、文库复杂度、PCR扩增和测序深度影响。重复高不等于一定失败,但它会影响有效信息量。 特别是低输入样本,重复升高更常见。
4.3 Adapter和N碱基不能忽略
Adapter残留说明接头未完全去除。若比例较高,后续比对会受干扰。N碱基表示不确定碱基,过多会降低可比对性。
因此,质控后的常规动作不是直接上比对,而是先根据报告决定是否需要:
- 去接头。
- 去低质量碱基。
- 去除过短reads。
- 过滤含N过多的序列。
这一步直接决定clean data的真实质量。
5.质量合格后,下一步才是有效分析
5.1 质控通过后,才能进入比对和定量
无论是RNA-seq还是WES,FASTQ通过质控后,下一步通常是比对。RNA-seq常转向基因组或转录组比对,再做定量和差异分析。WES则会进入比对、去重复、变异检测,最终形成VCF文件。
这里要强调一点。质控不是附属步骤,而是整个流程的入口控制。 入口质量差,后面再复杂的算法也只能在错误数据上运算。
5.2 不同测序技术,质控关注点略有区别
二代测序仍然是目前最常见的主流平台,像Illumina体系应用广泛,读长常在250到300 bp左右。它通量高、成本较低,但仍需要质控来确认真实可用性。
如果是单细胞转录组、WES或肿瘤相关测序,关注重点会有不同。单细胞更看重文库复杂度和条形码质量,WES更看重捕获效率和读段质量,RNA-seq更看重碱基质量、接头和重复情况。
同样是FASTQ,不同项目的判读逻辑不能完全照搬。
6.用WorkBuddy做FASTQ分析,如何提升效率
6.1 适合需要批量处理的科研场景
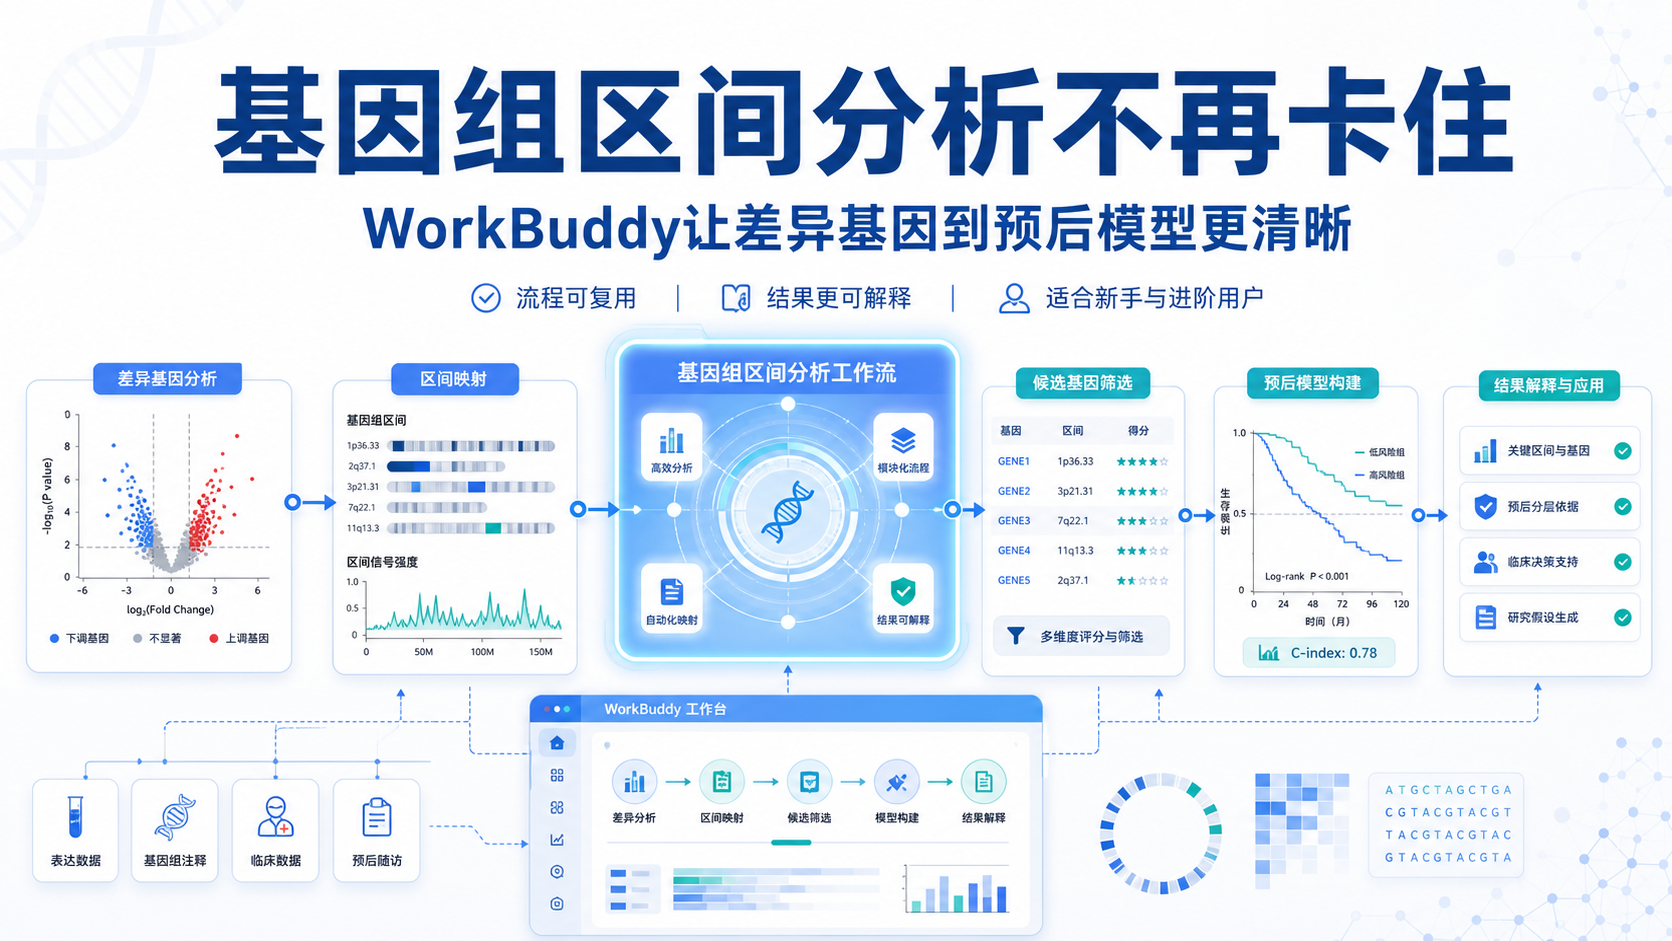
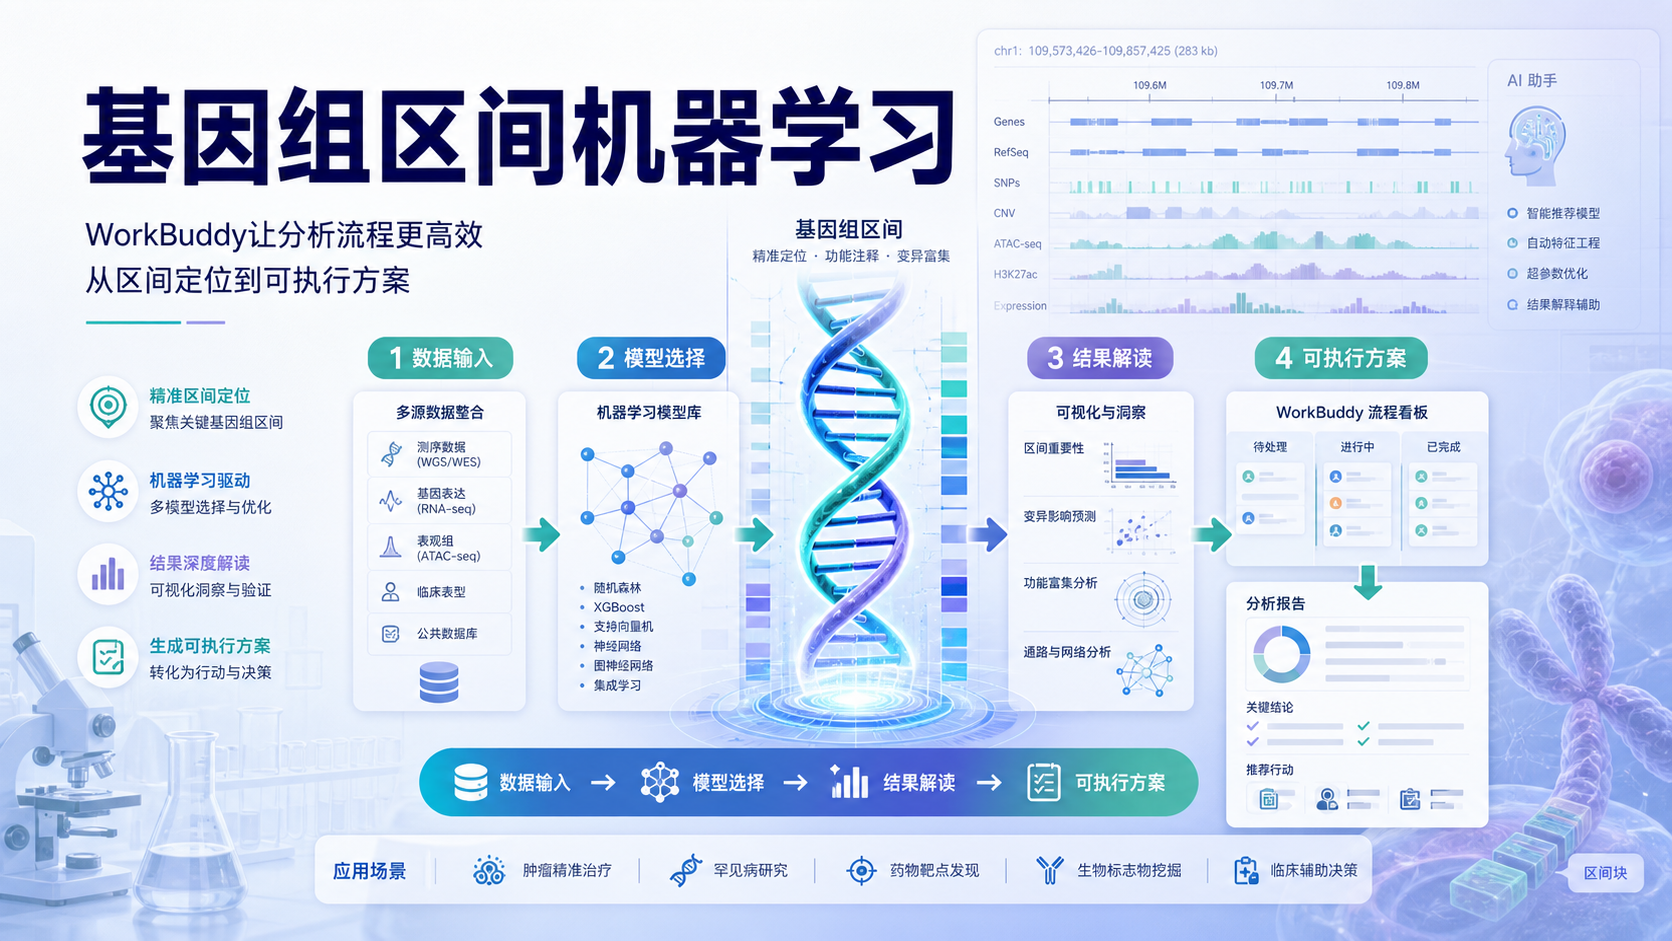
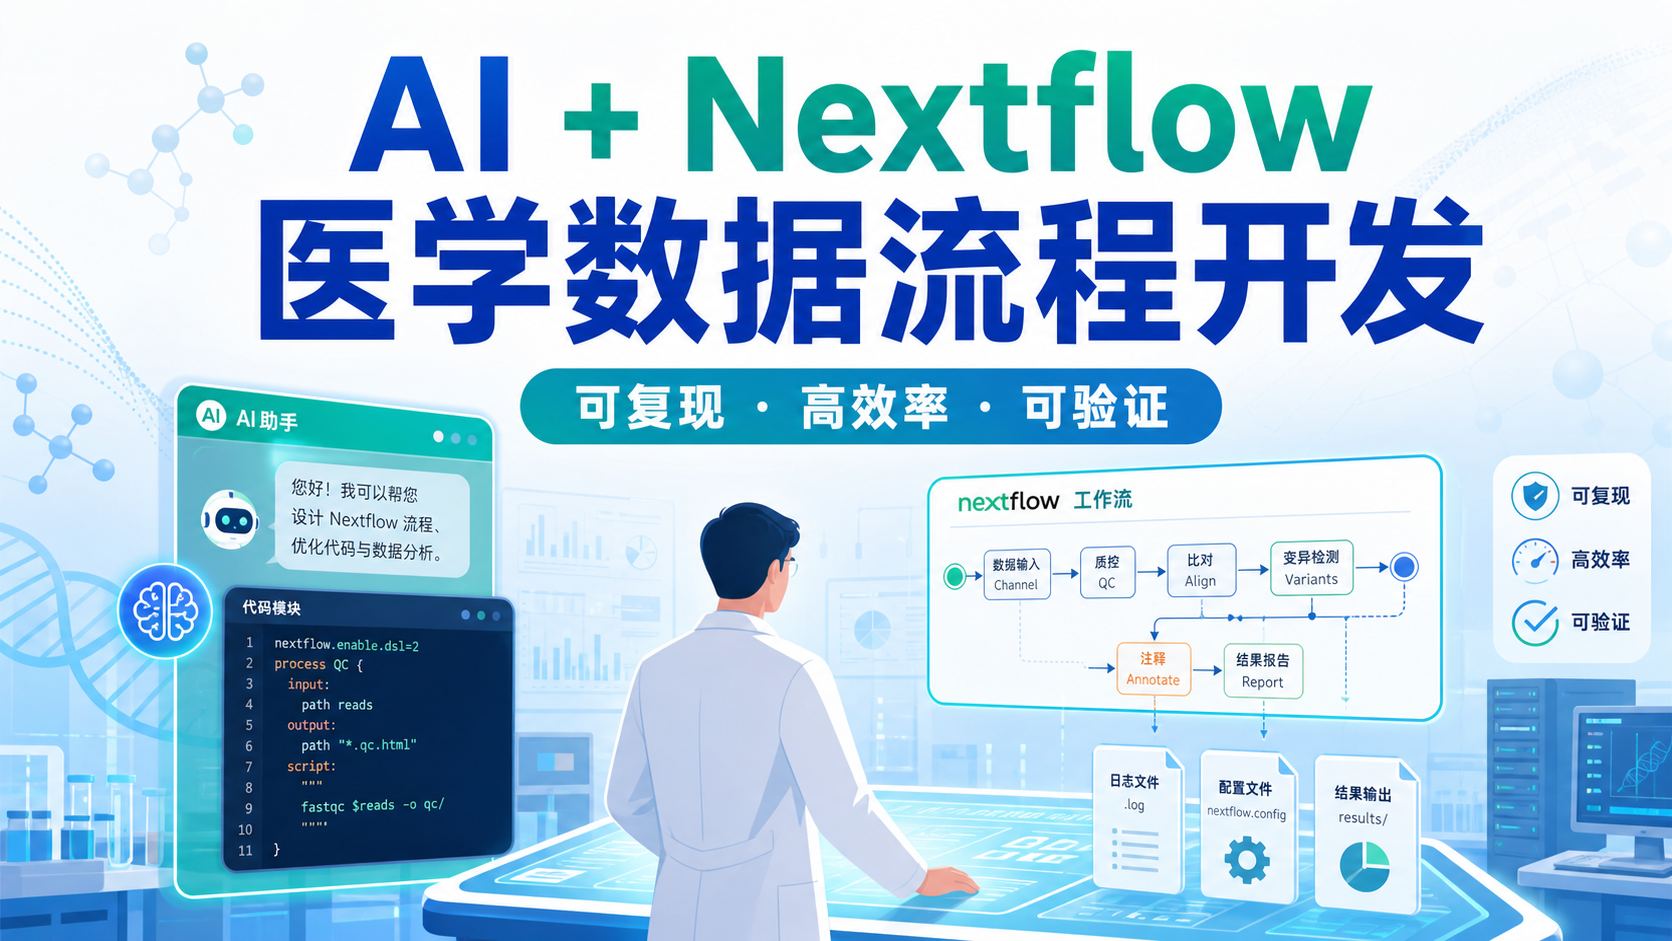
在真实项目里,FASTQ往往不是一个文件,而是一批样本。此时最需要的是稳定、清晰、可复用的分析流程。WorkBuddy FASTQ分析可以帮助用户把质控、整理和批量处理串起来,减少人工重复操作。
对课题组来说,最大的价值不是“多点几下”,而是让样本管理更规范,让结果输出更统一。 这样在样本多、时间紧、人员交接频繁的情况下,也能降低出错率。
6.2 把流程标准化,才能真正节省时间
一个成熟的FASTQ分析流程,至少应做到:
- 输入文件命名统一。
- R1、R2自动识别。
- 输出报告结构固定。
- 质控结果可追溯。
- 批量样本可复用同一套参数。
这类标准化流程,对医学生、医生和科研人员都很重要。它不只是提速,更是在减少“看不懂、找不到、复现不了”的问题。对长期项目而言,这比临时手工处理更可靠。
6.3 让质控结果真正服务于下游分析
很多人做完FastQC就结束了,但真正有价值的是把结果用于决策。比如是否需要修剪,是否适合继续比对,是否应该重新建库。WorkBuddy的意义就在于把这些动作前后衔接起来,让FASTQ分析不止停留在查看报告,而是进入可执行的分析决策链。
如果你想把FASTQ分析做得更稳定、更高效、更适合批量项目,解螺旋可以提供更贴近实战的WorkBuddy FASTQ分析支持,帮助你把质控、整理和下游分析串成一条清晰流程。
总结Conclusion
FASTQ分析的核心,不是“跑一次软件”,而是先把数据质量看清楚。Q30、碱基质量、GC含量、重复水平、Adapter和N碱基,都是必须结合判断的关键指标。 质控通过后,才适合进入比对、定量和变异分析。
对于医学生、医生和科研人员来说,建立标准化FASTQ流程,能显著降低后续分析风险。若你希望把批量质控和数据整理做得更高效,可以进一步了解解螺旋 提供的WorkBuddy FASTQ分析方案,让原始数据更快进入可用、可信的分析阶段。
- 引言Introduction
- 1.FASTQ是什么,为什么必须先做质控
- 2.质控怎么看,重点关注哪些指标
- 3.FASTQ分析流程怎么做,实操顺序要清楚
- 4.如何解读质控结果,避免被表面图形误导
- 5.质量合格后,下一步才是有效分析
- 6.用WorkBuddy做FASTQ分析,如何提升效率
- 总结Conclusion