68
 分享

引言Introduction
Meta分析的结论,往往不是被模型“算错”,而是被前期数据质量“带偏”。基线表是否完整,纳入标准是否一致,异质性是否可解释,发表偏倚是否存在,都会直接影响最终证据等级。对医学生、医生和科研人员来说,真正的难点不是跑出森林图,而是把每一步数据都控稳。
1. 基线表为什么是Meta分析的起点
1.1 基线数据统计决定可比性
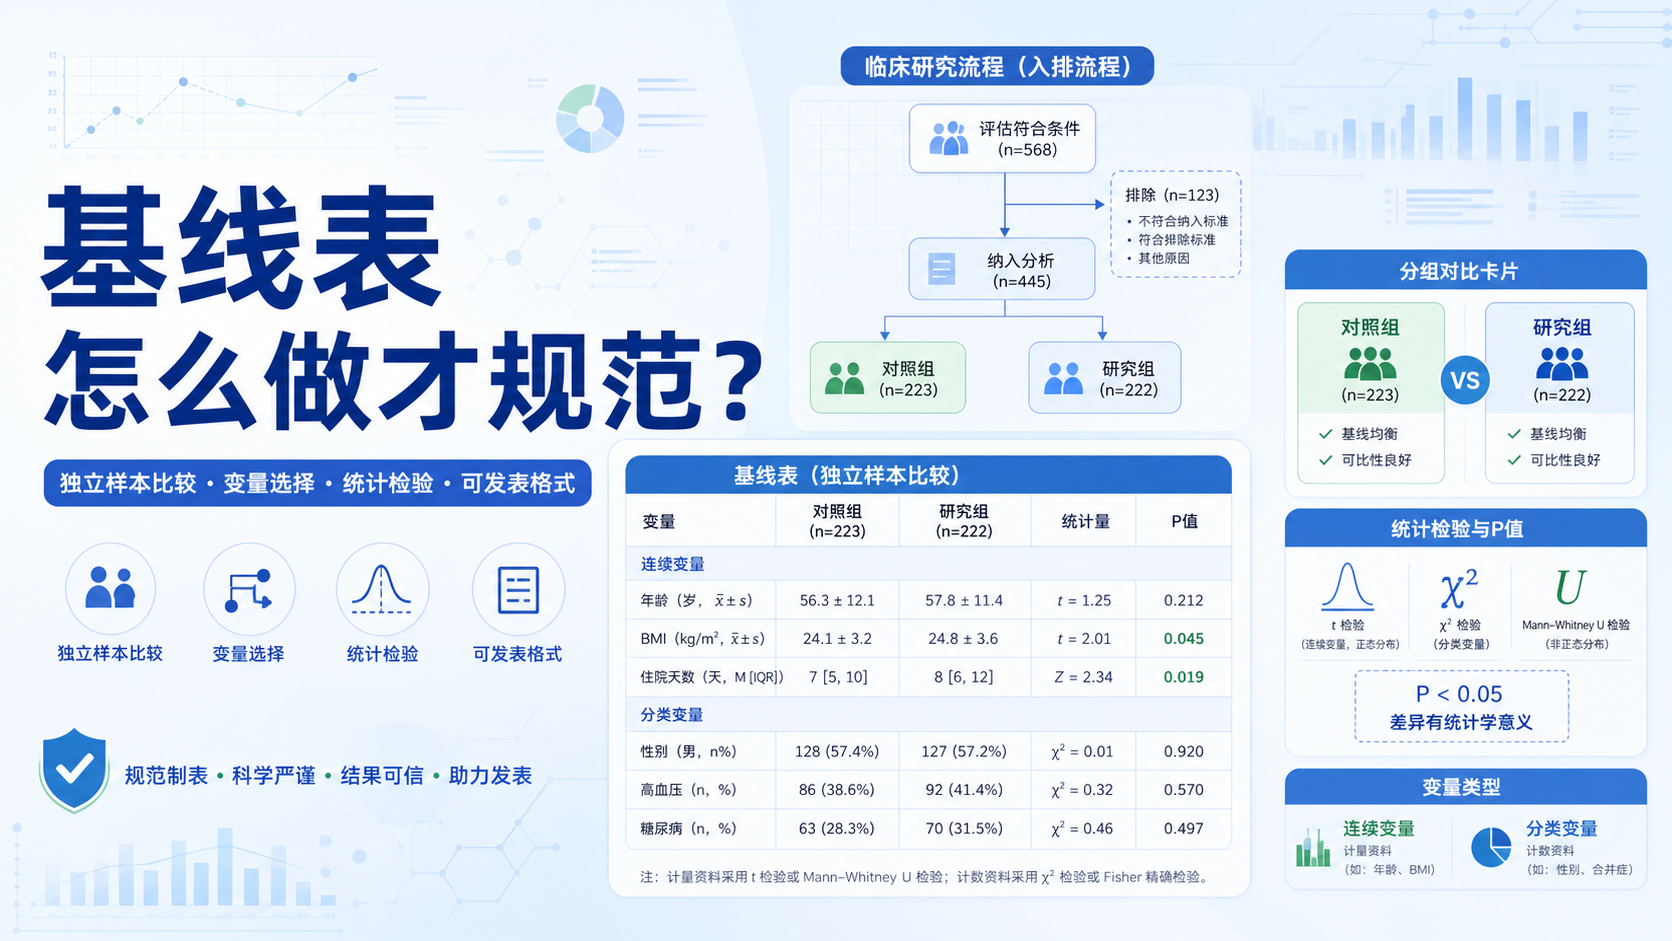
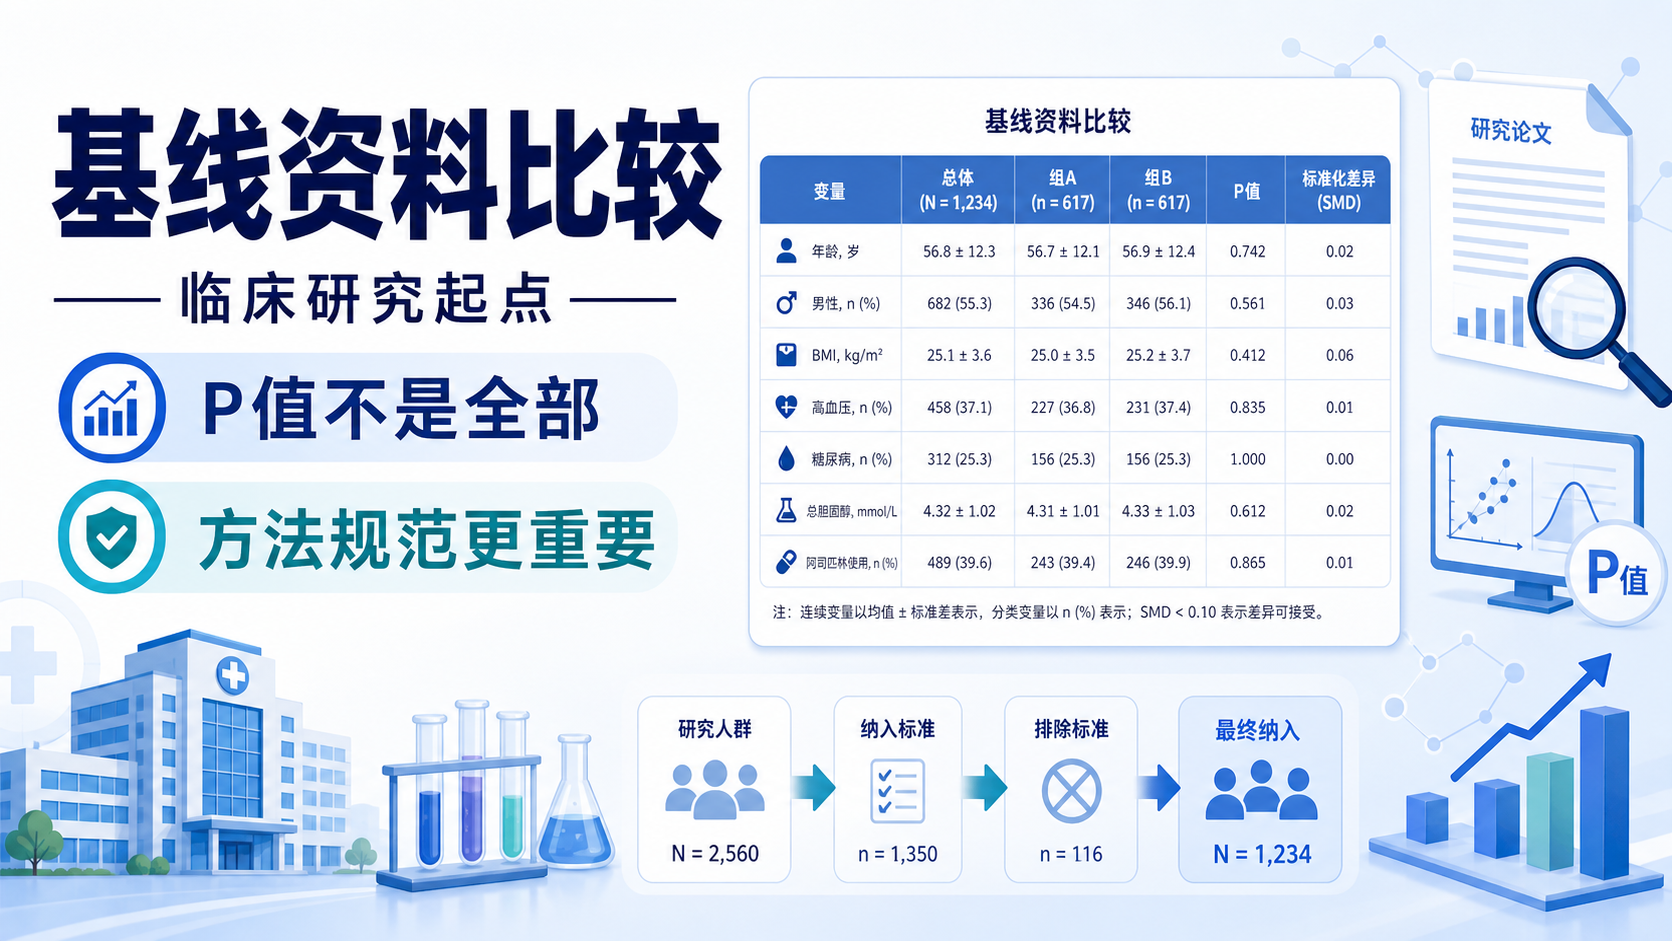
基线表不是附录,而是判断研究能否合并的第一道门槛。它通常包含作者、国家、中心、样本量、干预组与对照组特征,以及年龄、性别、病程、诊断标准等信息。如果两组基线明显不平衡,后续合并结果就可能被混杂因素干扰。
对观察性研究和随机对照试验来说,基线信息的意义不同。RCT更强调随机后组间是否平衡,观察性研究则更依赖后续亚组分析和敏感性分析来解释差异。科研人员在做系统评价时,至少要把这些字段提取完整:
- 样本量。
- 年龄和性别构成。
- 疾病分期或严重程度。
- 干预方式和随访时间。
- 结局指标及测量时点。
基线数据统计越完整,后续异质性分析越有依据。 如果关键变量缺失,哪怕森林图“显著”,证据也可能不稳。
1.2 重复发表和信息缺失要先排除
基线表阶段还要处理重复发表。若同一研究在不同期刊或不同主题下重复出现,通常应保留最新发表或样本量更大的版本,剔除重复数据。这样做的目的很直接,避免同一批受试者被重复计入,导致效应量被夸大。
信息不完整也是常见问题。对于缺失均数、标准差、HR或95%置信区间的文章,可以先尝试联系原作者。若仍无法补全,应记录原因,并在流程图中注明。规范记录剔除理由,不只是格式要求,也是提高研究透明度的关键一步。
2. 数据提取与质量评价要同步完成
2.1 先统一数据类型,再提取效应指标
Meta分析最怕“数据格式混乱”。在正式提取前,必须先确认研究类型和结局类型。常见数据包括:
- 二分类数据,如事件发生与否。
- 连续性资料,如均数、标准差、例数。
- 生存资料,如HR及其95%置信区间。
- 诊断性资料,如灵敏度、特异度、真阳性和假阴性。
不同数据类型对应不同效应指标。 二分类资料常用OR、RR、RD;连续性资料常用MD或SMD;生存资料常用HR。若单位一致,优先考虑MD。若量纲不同或量表不同,则更适合用SMD。
2.2 质量评价决定结论可信度
数据提取后,必须同步做质量评价。对于RCT,常看随机方法、分配隐藏、盲法、失访和选择性报告。对于队列研究、病例对照研究或横断面研究,常用NOS等量表进行评分。一般来说,NOS评分大于6分,常被视为较高质量研究。
质量评价的意义不是“打分好看”,而是帮助你判断证据强弱。若低质量研究占比高,合并结果即使显著,也要在讨论中明确其局限性。对科研写作而言,这部分内容直接影响文章的可信度和可发表性。
3. 异质性判断决定模型选择
3.1 先看Q检验,再看I²
Meta分析中,异质性是绕不开的问题。常用判断方法是卡方检验和I²统计量。Q检验提供P值,I²则反映研究间变异占总变异的比例。I²小于等于50%,通常认为异质性可接受。 50%到75%提示偏高,超过75%则说明异质性很高。
这里要注意,P值不能单独判断异质性。研究数量少时,Q检验容易不显著,但并不代表没有异质性。相反,研究数量很多时,即使I²不高,P值也可能偏小。因此,Q检验和I²必须联合解读。
3.2 固定效应模型和随机效应模型怎么选
模型选择不是机械套公式,而是根据研究间一致性决定。一般来说:
- 异质性较小,可优先使用固定效应模型。
- 异质性较大,通常使用随机效应模型。
固定效应模型假设各研究估计的是同一个真实效应。随机效应模型则认为各研究的真实效应可能不同,更适合临床差异、方法学差异较大的数据。实际操作中,若P值大于0.05且I²较低,可以考虑固定效应模型;若P值小于0.05或I²较高,则更适合随机效应模型。
3.3 亚组分析比“硬合并”更重要
当异质性明显时,不应急于求总效应。更合理的做法是做亚组分析。可按以下维度分组:
- 年龄,成人和儿童。
- 地区,中国、欧美、亚洲人群。
- 研究时间,早期和近期研究。
- 诊断标准或实验方法。
- 疾病分型或病情严重程度。
亚组分析的价值在于解释差异,而不是掩盖差异。 如果不同亚组方向一致,证据外推性更强;若结果不同,就说明总体合并结论需要谨慎使用。
4. 森林图和敏感性分析要一起看
4.1 森林图不是“只看显著性”
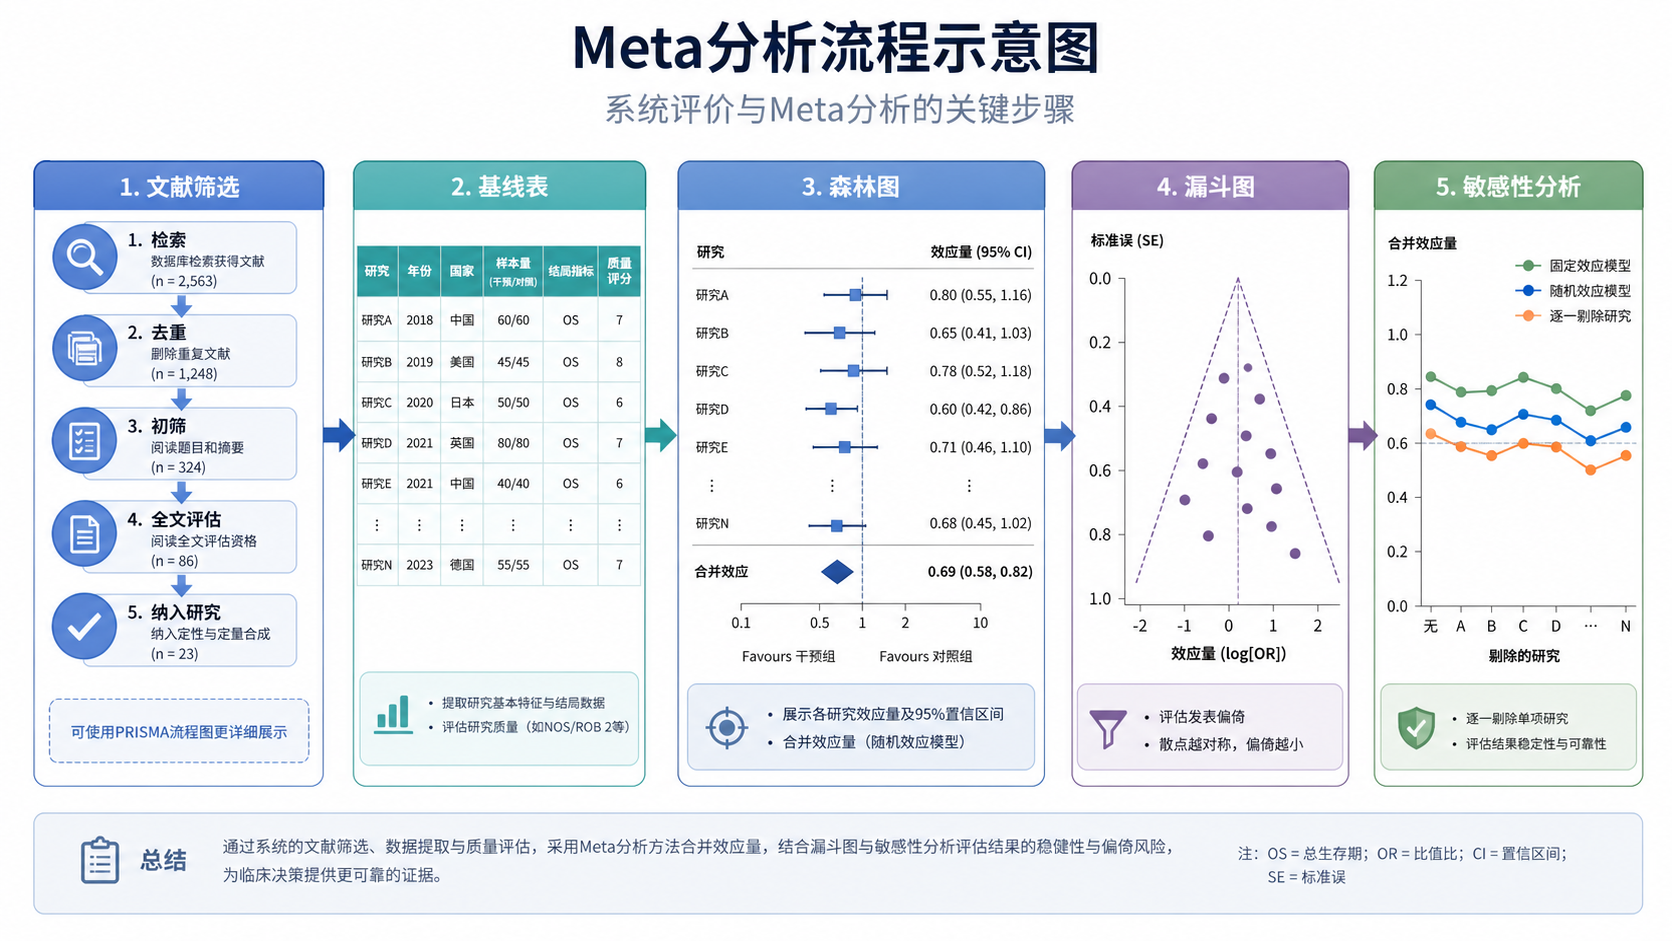
森林图是Meta分析最常见的图。中间的参考线表示无效值。对于比值类指标,参考线通常是1;对于均数差,参考线通常是0。每项研究对应一个方块和一条水平线,方块代表效应量,线条代表95%置信区间。置信区间是否跨越无效线,是判断统计学意义的核心。
但只看“跨不跨线”远远不够。还要同时关注:
- 方块大小,代表权重。
- 置信区间长短,反映精确度。
- 合并效应值位置,是否偏向某一侧。
- 异质性指标,是否支持合并。
如果单篇研究权重过大,或置信区间特别宽,说明结果稳定性有限。此时不宜只强调P值。
4.2 敏感性分析检验结果稳不稳
敏感性分析的目的,是看总体结论是否被某一篇文献“拉偏”。常见做法是逐一剔除研究,观察合并效应是否明显改变。如果剔除某篇文献后,结论从阳性变阴性,或效应量大幅波动,就提示该研究影响较大。
敏感性分析还可以通过以下方式进行:
- 改变纳入标准。
- 排除低质量研究。
- 更换统计模型。
- 改变效应指标。
科研写作中,这一步非常关键。它能告诉读者,你的结论不是偶然结果,而是在多种假设下仍然成立。对临床决策而言,这种稳定性尤其重要。
5. 漏斗图与发表偏倚不能忽略
5.1 漏斗图看的是“对称性”
发表偏倚通常用漏斗图判断。原则上,点应落在漏斗图两条斜边范围内,并且围绕中心线较对称。如果图形明显不对称,或者小样本研究缺失明显,就要警惕发表偏倚。
漏斗图的局限也要明确。它是定性工具,不给出直接P值。样本量少时,对称性判断本身就不稳定。所以,漏斗图适合初筛,不适合单独下结论。
5.2 定量方法能补充漏斗图
如果需要更严谨地评估发表偏倚,可以结合Egger检验、线性回归法或Trim and Fill方法。它们属于定量方法,能辅助判断是否存在系统性偏倚。在证据整合中,定性和定量方法最好一起用。
这里要强调,发表偏倚不等于“研究一定有问题”,而是提示现有文献体系可能不完整。常见原因包括阳性结果更容易发表、语言限制、数据库检索不全等。对系统评价来说,这一步关系到证据是否过度乐观。
6. 把方法落实到工具和流程
6.1 规范流程比单次分析更重要
真正高质量的Meta分析,不是一次性跑出结果,而是从文献筛选开始就全程可追溯。建议按这个顺序执行:
- 制定纳入和排除标准。
- 完成检索和去重。
- 提取基线表和结局数据。
- 进行质量评价。
- 判断异质性并选择模型。
- 做亚组和敏感性分析。
- 检查发表偏倚。
- 解释结果并写入讨论。
每一步都要有记录。 这样不仅便于复核,也方便后续投稿时回应审稿意见。
6.2 解螺旋如何帮助你提升效率
如果你正在做Meta分析,最耗时的通常不是统计,而是前期整理。基线数据统计、文献去重、效应指标选择、质量评价表制作,这些环节最容易出错。解螺旋可以帮助你把这些流程标准化,减少重复劳动,提高数据整理效率。 对医学生和科研人员来说,这意味着更少的格式错误,更快的分析节奏,也更容易把精力放在结果解释上。
总结Conclusion
Meta分析的数据质量控制,核心就是四件事:基线表要完整,异质性要解释,敏感性分析要验证,发表偏倚要警惕。 只有把这些环节逐一落实,森林图和漏斗图才有真正的解释价值。对于医学生、医生和科研人员来说,Meta分析不是“会点软件”就够了,而是要建立一套可复核、可追踪、可解释的证据整合流程。若你希望更高效地完成基线数据统计和前期整理,不妨尝试解螺旋,让复杂流程更规范、更省时。
- 引言Introduction
- 1. 基线表为什么是Meta分析的起点
- 2. 数据提取与质量评价要同步完成
- 3. 异质性判断决定模型选择
- 4. 森林图和敏感性分析要一起看
- 5. 漏斗图与发表偏倚不能忽略
- 6. 把方法落实到工具和流程
- 总结Conclusion