47
 分享
引言Introduction
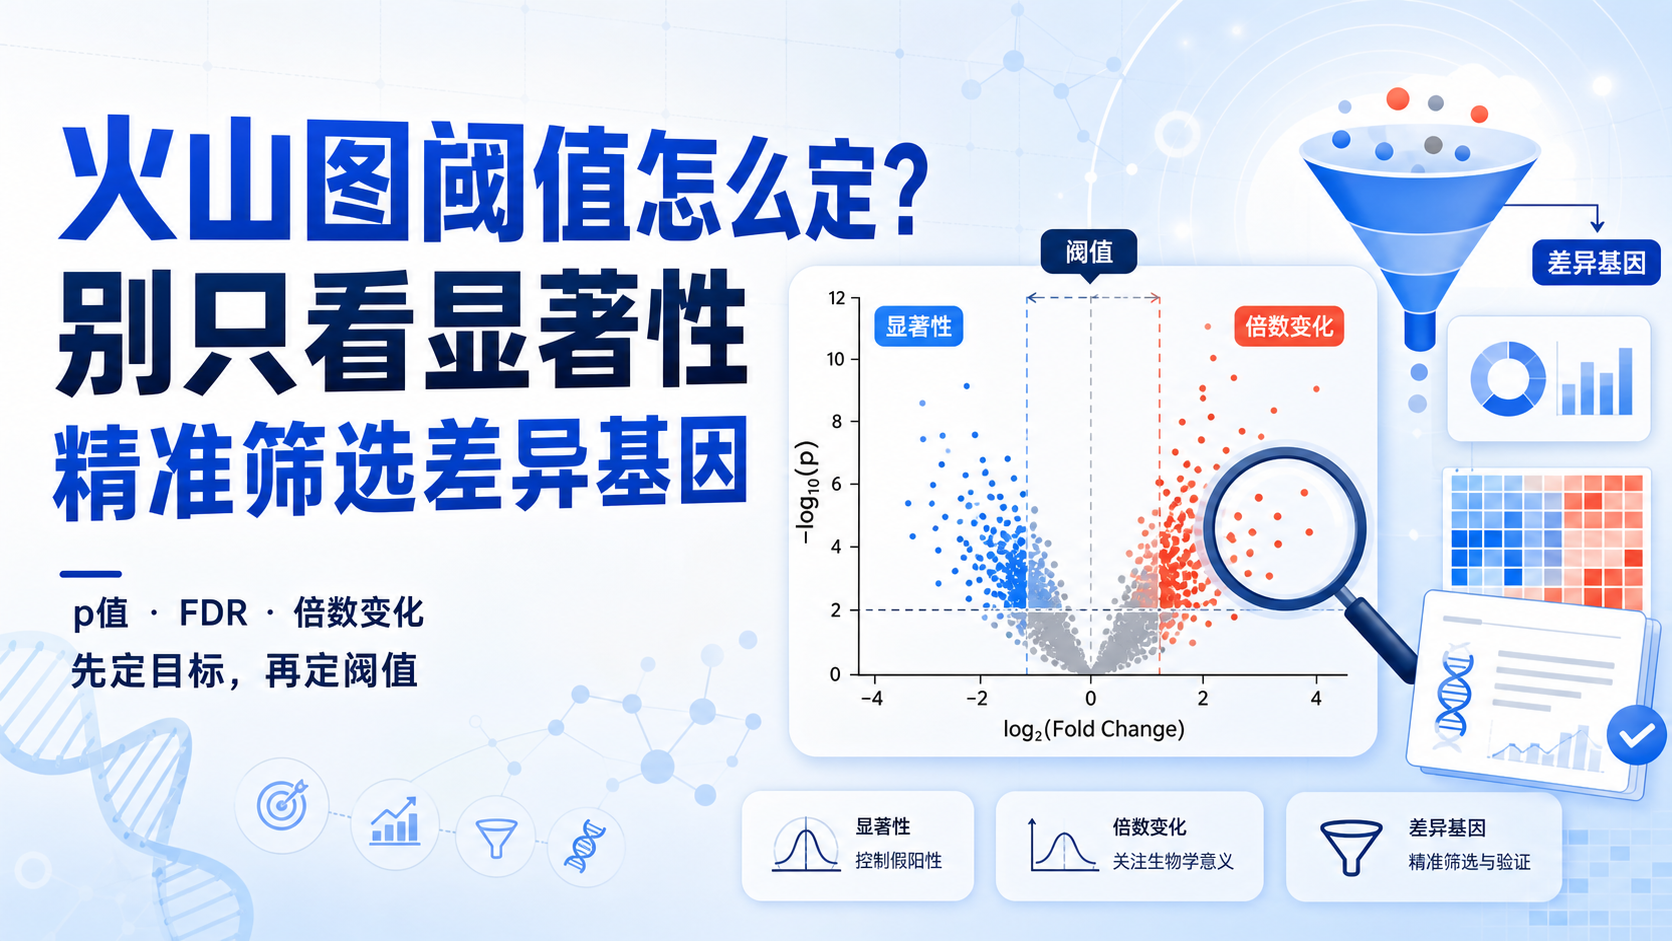
做差异分析时,很多人卡在同一个问题上。火山图看懂了,却不知道阈值该怎么设。设宽了,假阳性多。设严了,真实信号又被漏掉。阈值不是越严越好,而是要和研究目的、样本质量、统计策略匹配。
1. 火山图解读的核心:先看什么,再看阈值
1.1 火山图表达了什么信息
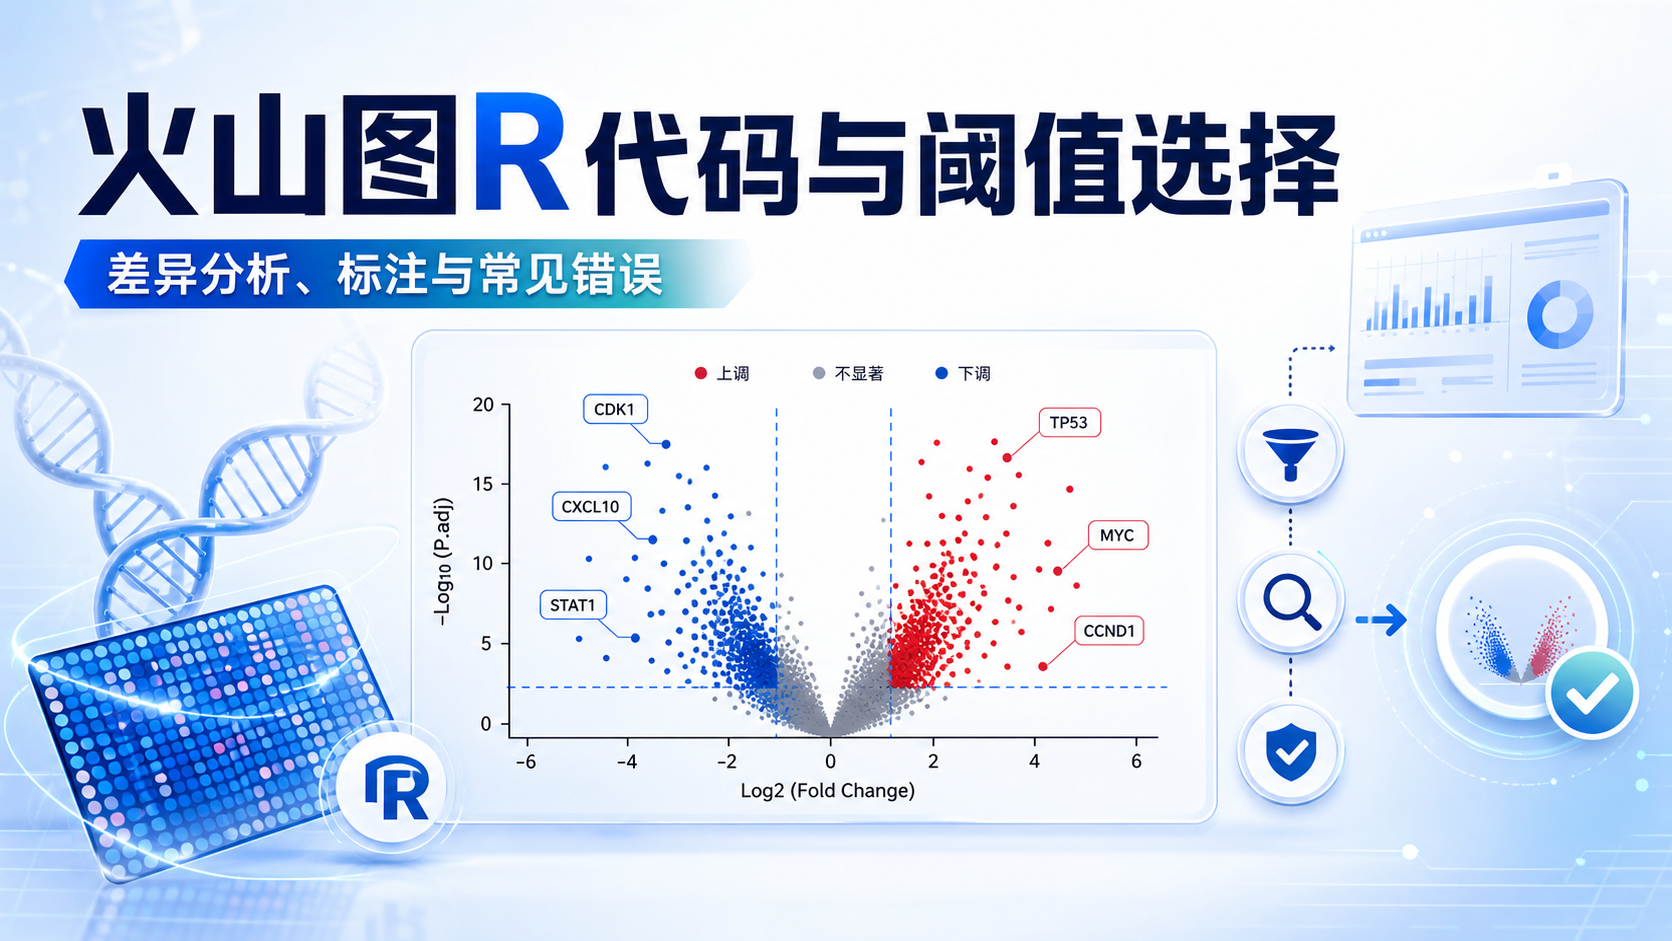
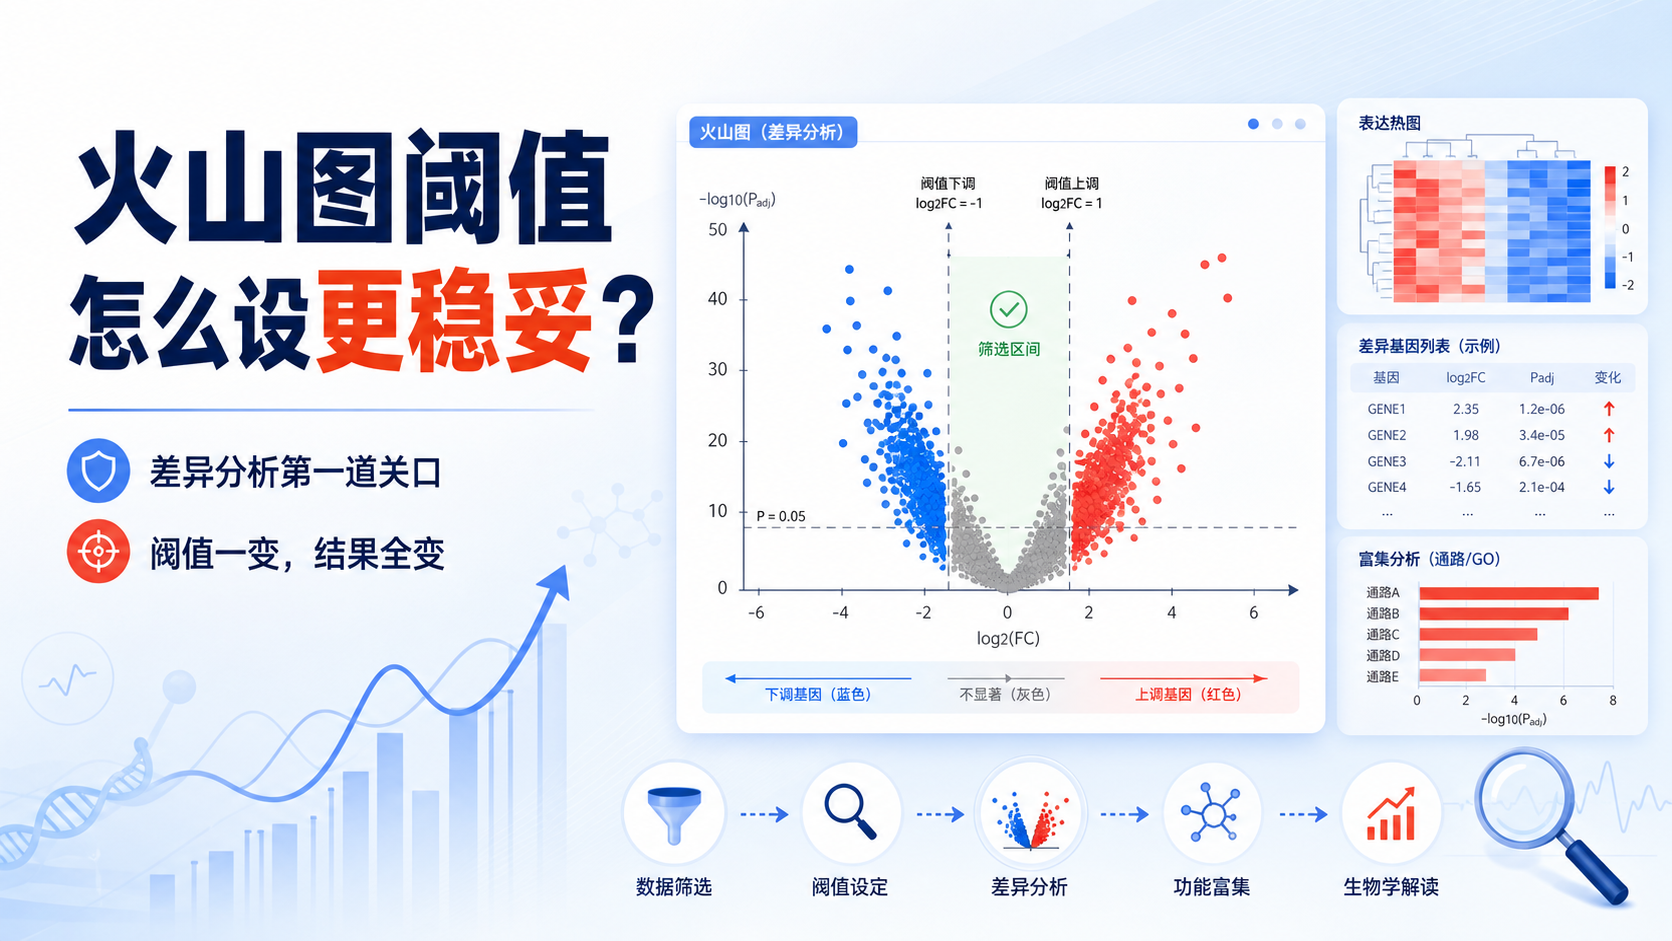
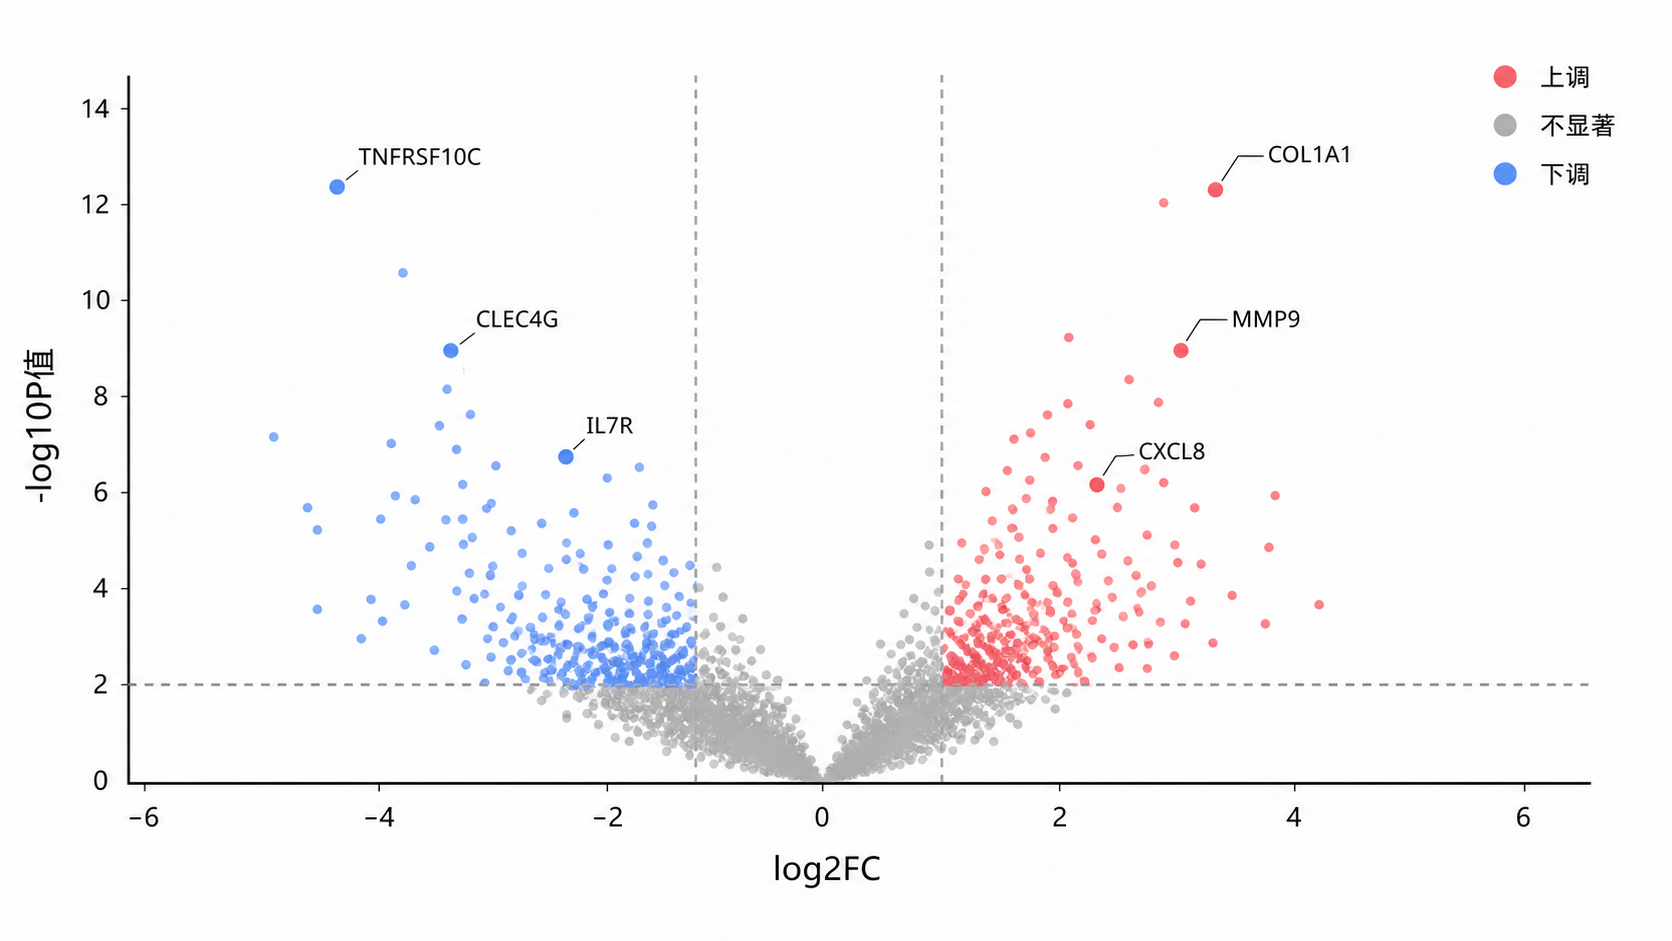
火山图是差异分析最常见的二维可视化。横轴通常是 log2 fold change ,表示表达倍数变化。纵轴通常是 -log10(p值) 或校正后的显著性指标,表示统计学证据强弱。
左上角和右上角是最值得关注的区域。 右上角代表上调且显著。左上角代表下调且显著。中间区域大多是变化幅度小,或者统计上不显著的基因。
从解读逻辑上看,火山图回答的是两个问题。
- 变化幅度够不够大。
- 统计学上能不能站得住。
1.2 为什么火山图不能单独决定结论
很多初学者会把火山图当成“最终答案”。其实不对。火山图只是差异基因筛选结果的可视化展示。真正影响后续富集分析、PPI网络和验证实验的,是阈值背后的筛选策略。
如果阈值设置不合理,后续所有分析都会偏。
- 阈值太宽,会把噪音带进来。
- 阈值太严,会错过生物学上重要但变化幅度较小的基因。
- 样本量太小,还容易出现统计不稳定。
所以,火山图解读的重点,不只是“看红点有多少”,而是要判断这个筛选结果是否适合研究场景。
2. 阈值设定的常用标准与统计逻辑
2.1 最常见的两个阈值
在实际生信分析中,最常见的设定是:
- log2FC = ±1
- p < 0.05
其中,log2FC = 1 表示表达量变化约2倍。log2FC = -1 表示下降到原来的1/2。这个标准简单,适合多数探索性研究。
但要注意,“常用”不等于“固定” 。有些文章会根据样本数量、数据波动和研究目的改成:
- log2FC = ±0.58,对应1.5倍变化。
- log2FC = ±1.5,要求更强的变化幅度。
- 使用FDR或校正后p值替代原始p值。
2.2 p值、校正p值和FDR的区别
火山图解读时,很多人只看p值,但在多重比较场景下,这并不够严谨。因为一次差异分析会同时检验成千上万基因,假阳性会累积。
因此,很多规范流程更推荐使用:
- adj.P.Val
- FDR
- q value
这类指标本质上是对多重检验后的错误率控制。如果你的样本量较大、基因数较多,优先考虑校正后的显著性指标。 这样更符合发表要求,也更稳健。
2.3 阈值设定会直接改变结果数量
阈值变化,结果数量会明显波动。这个现象很正常。
例如:
- 使用 log2FC = ±1,p < 0.05,通常得到的差异基因更少,但更稳。
- 改成 log2FC = ±0.58,p < 0.05,基因数会增加。
- 若再把显著性标准提高到 p < 0.01,基因数会再次减少。
阈值越严格,筛到的基因越少。 这不是坏事,但意味着你更偏向高置信度结果。相反,宽阈值适合早期筛查,但后续需要更严格验证。
3. 如何根据研究目标精准设定阈值
3.1 探索性研究适合相对宽松的阈值
如果你的目标是尽可能发现候选基因,适合用较宽松的阈值。比如 log2FC = ±0.58 或 ±1,配合 p < 0.05。这样可以保留更多信号,方便后续做通路富集、网络分析和候选基因优选。
但探索性分析有一个前提。你要接受一定比例的假阳性。 所以这类结果更适合“发现线索”,不适合直接下结论。
3.2 验证性研究应优先提高特异性
如果你的目标是筛少而精的基因,用于qPCR、Western blot或功能实验,阈值就应更严格。
可以考虑:
- 更高的倍数阈值。
- 校正后p值控制。
- 结合生物学背景筛选。
验证实验更怕“多”,不怕“少”。 因为实验资源有限,优先保证候选基因的可信度更重要。
3.3 不同数据类型阈值不应一刀切
RNA-seq、芯片、单细胞转录组、非肿瘤公共数据集,阈值策略都不完全一样。
例如:
- 芯片数据波动相对稳定,常见阈值更接近标准化差异分析。
- RNA-seq离散度更高,常结合DESeq2或edgeR的统计框架。
- 样本极少时,单纯依赖p值容易不稳,要结合效应量。
火山图解读不能脱离数据类型。 看到别人的文章用什么阈值,不代表你的项目也适合照搬。
4. 火山图解读中最容易忽略的三个误区
4.1 误区一,只看显著性,不看变化幅度
有些基因p值很小,但log2FC很低。它们可能是稳定但幅度很小的变化。如果变化幅度不够,生物学意义未必强。
尤其在样本量大时,哪怕很小的差异也可能达到统计显著。此时更要警惕“显著但不重要”的结果。
4.2 误区二,只看倍数,不看统计学证据
另一种常见错误是只追求高倍数变化。某些基因看起来变化很大,但如果样本波动大、重复性差,可信度并不高。
倍数大不等于可靠。 火山图的价值就在于把效应量和显著性放在同一张图里,帮助你同时判断这两个维度。
4.3 误区三,阈值定死不调整
很多人做项目时直接套用 log2FC = 1 和 p < 0.05,但不再回看结果数量和分布。这样很容易出现两种极端:
- 基因太少,后续富集分析没信息量。
- 基因太多,结果杂乱,验证压力过大。
正确做法是先看数据分布,再回调阈值。阈值应该服务于研究目的,而不是为了套模板。
5. 实操上如何提高差异基因筛选的准确性
5.1 先做数据质控,再看火山图
差异分析前,先确认基础数据质量。包括:
- 样本分组是否清晰。
- 是否存在明显离群样本。
- 是否完成标准化或批次校正。
- 表达矩阵是否适合后续统计模型。
如果前处理不稳,火山图再漂亮也没用。基础不牢,后续分析往往徒劳。
5.2 结合热图和箱线图一起判断
火山图适合快速筛选,但不能替代表达模式确认。常规流程里,差异分析后通常会配合:
- 火山图,看总体差异分布。
- 热图,看样本聚类与基因表达模式。
- 箱线图或小提琴图,看单基因分布差异。
三类图联合判断,比单看火山图更可靠。 这也是为什么成熟文章通常不会只放一张火山图。
5.3 优先保留可复现、可验证的候选基因
从发表和转化角度看,真正有价值的差异基因,通常满足三点:
- 统计显著。
- 变化幅度足够。
- 在独立验证或外部队列中可重复。
如果候选基因只是“图上看起来很红”,但缺乏稳定性,后续实验风险会很高。
6. 让阈值设定更稳的实用建议
6.1 先定研究目标,再定阈值
如果你是做机制探索,允许适度宽松。
如果你是做实验验证,建议更严格。
如果你是做文章复现,优先对齐原文方法,再结合自己的数据质量微调。
6.2 看结果数量是否合理
一个简单判断标准是,筛出来的差异基因数量是否和数据规模匹配。
- 过少,说明阈值可能过严。
- 过多,说明阈值可能过松,或者批次效应未处理好。
6.3 记录并报告清楚阈值
写文章时,不要只写“筛选差异基因”。要明确写出:
- 使用的log2FC阈值。
- 使用的p值或校正p值。
- 是否做了多重检验校正。
- 统计软件和版本。
这不仅是规范问题,也是可重复性问题。
7. 总结:阈值不是越硬越好,关键是精准
火山图解读的本质,是在效应量和显著性之间找到平衡。阈值设定决定了你能锁定哪些差异基因,也决定了后续分析是否可靠。 对医学生、医生和科研人员来说,最重要的不是机械套用标准,而是根据数据类型、样本质量和研究目标动态调整。
如果你希望把差异基因筛选、火山图解读和后续分析流程做得更稳、更快,可以借助 解螺旋 的专业内容和工具支持,减少阈值设置的试错成本,提升分析效率与文章质量。
- 引言Introduction
- 1. 火山图解读的核心:先看什么,再看阈值
- 2. 阈值设定的常用标准与统计逻辑
- 3. 如何根据研究目标精准设定阈值
- 4. 火山图解读中最容易忽略的三个误区
- 5. 实操上如何提高差异基因筛选的准确性
- 6. 让阈值设定更稳的实用建议
- 7. 总结:阈值不是越硬越好,关键是精准