46
 分享
引言Introduction
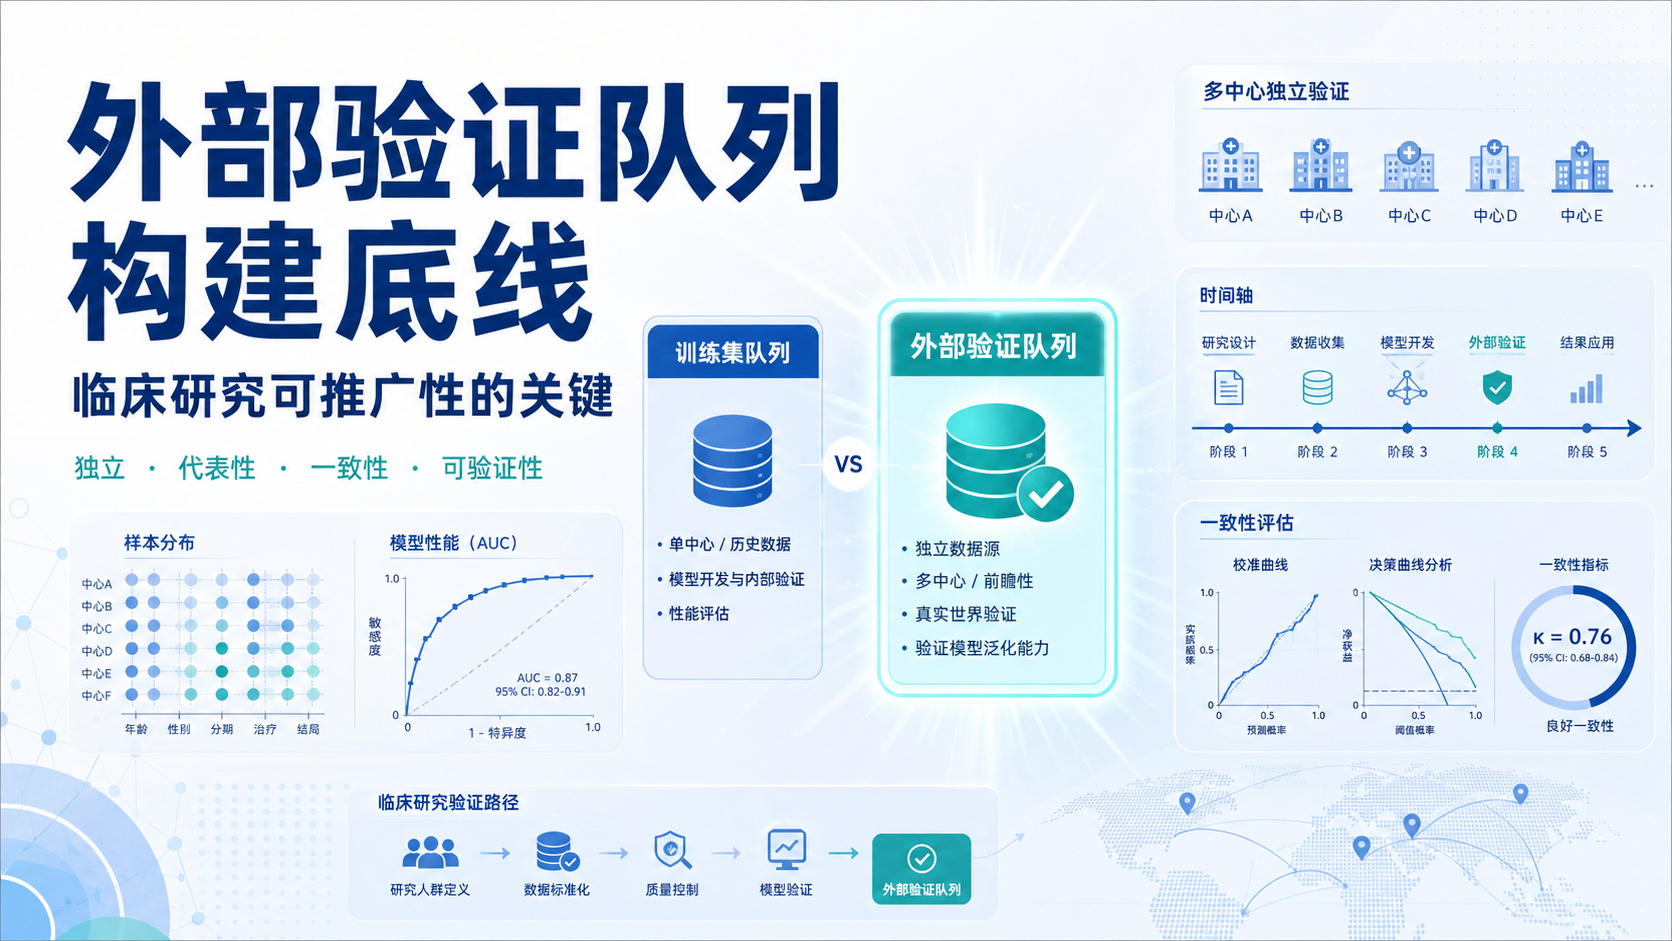
外部验证队列不是“加分项”,而是临床研究能否站住脚的关键。很多模型在训练集表现很好,一到独立队列就失效,问题往往不在算法,而在研究设计。如果没有外部验证,结论很难证明可推广性。

1. 为什么外部验证队列构建是临床研究的底线
1.1 训练集高分,不等于真实有效
很多研究常见的误区,是把训练集里的AUC、准确率、C-index当成最终结论。事实上,这些指标只能说明模型“会记忆”,不能证明它“会泛化”。外部验证队列的核心价值,就是检验模型在新来源样本中的稳定性。
在生物信息、临床预测模型和诊断研究中,训练集往往存在选择偏倚、中心偏倚和变量偏倚。模型一旦过度贴合原始样本,就容易出现过拟合。尤其是特征多、样本少时,这种风险更高。
没有外部验证,模型更像“单中心回忆题”,不是临床工具。
1.2 外部验证解决的是可推广性问题
临床研究最终要回答的,不是“在我这批数据上能不能成立”,而是“换一批人还能不能成立”。这也是外部验证队列构建的意义所在。它通常来自不同时间段、不同医院、不同地区,甚至不同平台的数据。
从研究设计角度看,外部验证至少能回答三个问题。
- 模型是否稳定。
- 变量方向是否一致。
- 结果是否具有临床可迁移性。
如果模型只能在原始数据上成立,它的临床价值就非常有限。
2. 外部验证队列构建的核心原则
2.1 队列要“独立”,而不是“拆分”
外部验证队列最重要的标准是独立性。很多初学者把同一个数据库随机分成训练集和验证集,这属于内部验证,不是严格意义上的外部验证。外部验证队列通常应满足以下条件:
- 来源独立,来自不同中心或不同数据库。
- 时间独立,来自不同时间段的病例。
- 采集流程相对独立,减少同源偏差。
- 不参与模型训练、特征筛选和阈值优化。
只要验证集参与了建模过程,就会削弱外部验证的说服力。
2.2 样本代表性比样本数量更重要
构建外部验证队列时,很多人首先问“要多少例”。数量当然重要,但更重要的是代表性。队列应尽量覆盖目标人群的真实临床分布,包括年龄、性别、分期、治疗方案和结局构成。
如果验证队列和训练队列在基础特征上差异过大,模型失效不一定说明模型差,也可能是样本不匹配。因此,研究者需要提前定义目标人群。
验证队列不是“越多越好”,而是“越接近真实应用场景越好”。
2.3 变量定义必须一致
外部验证常见失败原因之一,是变量定义不统一。比如同一个临床指标,在不同中心使用的检测方法、单位、截点、时间窗不同,都会影响结果。对于生信和临床预测模型,尤其要注意:
- 结局定义是否一致。
- 纳入标准是否一致。
- 排除标准是否一致。
- 检测平台和标准化流程是否一致。
- 随访时间是否足够。
变量口径不统一,外部验证就会变成“不同问题的比较”,而不是同一模型的检验。
3. 如何设计一套可用的外部验证队列
3.1 先定问题,再定队列
外部验证不是拿到数据后再补设计,而是从选题开始就要预留。一个合格的研究设计,通常先明确以下内容:
- 研究终点是什么,生存、诊断、分层,还是疗效预测。
- 目标人群是谁,肿瘤、慢病,还是特定亚型患者。
- 模型将用于什么场景,筛查、风险分层,还是临床决策支持。
- 外部验证队列来自哪里,单中心、多中心,还是公开数据库。
选题阶段就想清楚验证路径,后面才不会出现“有模型没验证”的断裂。
3.2 优先采用多中心或时间外验证
从证据强度看,多中心外部验证优于单中心外部验证,时间外验证优于同一时间窗内的随机划分。原因很简单,多中心和时间外数据更接近真实临床波动,能更好评估模型稳健性。
对于回顾性研究,常见做法是:
- 训练集来自A中心的早期病例。
- 外部验证队列来自B中心病例。
- 或者训练集来自2018至2021年,外部队列来自2022至2023年。
这种设计的优点是清晰。只要模型在独立时间和独立中心上依旧稳定,可信度就明显提高。
3.3 保证事件数和随访质量
如果研究终点是生存结局,外部验证队列除了样本量,还要关注事件数。事件太少,模型性能波动会很大。对于随访研究,随访缺失、失访过多、结局记录不完整,都会削弱验证价值。
建议在构建队列时重点检查:
- 失访率是否可接受。
- 中位随访时间是否足够。
- 终点事件是否定义明确。
- 核心协变量是否缺失严重。
高质量外部验证,关键不只是“有数据”,而是“有可用结局”。
4. 外部验证队列构建后的评价重点
4.1 不只看AUC,还要看一致性
外部验证不是简单报一个AUC就结束。对于临床研究,至少应同时关注以下几类指标:
- 区分度,如AUC、C-index。
- 校准度,如校准曲线。
- 临床净获益,如决策曲线分析。
- 风险分层能力,如KM生存曲线。
- 一致性,训练集与外部队列结果是否方向一致。
如果区分度尚可,但校准严重偏离,模型仍然不适合直接临床应用。
4.2 结果不一致时,要先找原因
外部验证失败并不罕见。研究者不能只看结果好不好,还要分析为什么不同。常见原因包括:
- 队列人群差异过大。
- 检测平台不同。
- 样本量不足。
- 终点定义不统一。
- 训练模型过拟合。
- 临床干预背景不同。
这类分析很重要。它能帮助研究者判断问题出在模型本身,还是出在验证设计。
真正成熟的研究,不是回避失败,而是解释失败。
5. 外部验证队列构建对临床研究选题的启示
5.1 好选题必须考虑可验证性
很多看起来“新”的选题,最后都卡在验证上。原因不是假设不新,而是没有可落地的独立队列。临床研究选题要同时满足三个条件:
- 有明确的临床问题。
- 有可获得的数据来源。
- 有可验证的独立队列。
如果这三点缺一,课题就容易停留在概念层面。选题的成熟度,本质上取决于验证路径是否清楚。
5.2 从一开始就为外部验证留接口
对于医学生、医生和科研人员而言,最实用的做法,是在选题阶段就预设外部验证方案。可以优先选择:
- 公共数据库可获取的研究主题。
- 本院病例充足、且可合作多中心扩展的方向。
- 随访和结局记录完整的疾病领域。
- 变量标准化程度较高的临床场景。
这样做的好处很直接。研究更容易完成,文章也更容易通过审稿。没有外部验证设计的研究,往往在投稿阶段就会被质疑证据层级不足。
5.3 用专业工具提高验证效率
外部验证队列构建往往涉及数据整理、变量匹配、随访清洗和统计建模,工作量很大。对于需要快速完成临床研究选题与验证设计的团队,借助成熟的平台和资源更高效。比如通过解螺旋 获取规范化的研究思路、数据分析支持和文章框架参考,可以显著减少重复劳动,把精力放在真正重要的验证设计和结果解释上。
总结Conclusion
外部验证队列构建,是临床研究从“能发表”走向“能应用”的关键一步。它决定了模型是否独立、结果是否稳健、结论是否可推广。没有外部验证,研究的可信度和临床价值都会打折。
对医学生、医生和科研人员来说,最优策略不是先做模型再找验证,而是在选题阶段就把验证路径设计好。若你希望更高效地完成临床研究设计、数据整理和验证流程搭建,可以进一步了解解螺旋 ,让课题从一开始就走在正确轨道上。
- 引言Introduction
- 1. 为什么外部验证队列构建是临床研究的底线
- 2. 外部验证队列构建的核心原则
- 3. 如何设计一套可用的外部验证队列
- 4. 外部验证队列构建后的评价重点
- 5. 外部验证队列构建对临床研究选题的启示
- 总结Conclusion