27
 分享
引言Introduction
做基因组分析时,很多人卡在同一个环节,数据来源分散,检索路径复杂,导出结果也不统一。对医学生、医生和科研人员来说,真正的问题不是“有没有数据库”,而是如何更快、更准地把Ensembl里的基因、转录本、变异和注释信息串起来 。

1. 为什么Ensembl是基因组研究的基础工具
1.1 Ensembl能解决什么问题
Ensembl 由 Wellcome Sanger Institute 和 EMBL-EBI 共同运营,核心目标是对真核生物基因组进行自动注释,并把注释结果与其他生物数据整合公开。它不是单一的查询网站,而是一个覆盖基因、转录本、蛋白、变异、比较基因组学、调控信息 的综合数据库。
对实际研究而言,Ensembl 的价值主要体现在三点。
- 快速定位基因与转录本。
- 查看变异在基因结构中的位置。
- 进行跨物种比较和功能注释。
它支持人类、鼠、斑马鱼等常用模式生物,也扩展到植物、真菌、原生生物、无脊椎动物和细菌相关门户。到 2020 年,Ensembl 在相关网站上已支持超过 50 万个基因组,说明其覆盖范围和更新能力都很强。
1.2 Ensembl与NCBI、UCSC的差异
很多研究者会同时用 Ensembl、NCBI Map Viewer 和 UCSC。三者都常用,但侧重点不同。
Ensembl 的特点是自动化注释和统一的数据结构。
它的基因集主要依据 mRNA、蛋白序列、RefSeq、EMBL cDNA 等来源自动生成。相比依赖人工浏览的传统方式,Ensembl 更适合做大规模筛查和标准化分析。
Ensembl 还有两个优势很实用。
- BioMart 批量导出能力强。
- VEP 可直接做变异功能注释。
如果你的任务是从基因列表出发,快速得到坐标、转录本、蛋白、同源基因和表达线索,Ensembl 通常更高效。
2. WorkBuddy对接Ensembl的核心价值
2.1 把“检索”变成“流程”
很多人使用 Ensembl 时,问题不在数据库本身,而在操作断裂。要先搜索基因,再进转录本页,再切换到变异页,最后还要手动整理结果。对单个基因可以接受,但一旦涉及多个样本、多基因、多批次,就容易出错。
WorkBuddy 对接 Ensembl 的意义,是把原本分散的检索动作,组织成更稳定的分析流程。
它更适合做以下工作。
- 统一管理检索入口。
- 规范化记录查询对象。
- 提高批量筛选和结果整理效率。
- 降低重复点击和人工复制带来的错误。
这对科研人员尤其重要。因为高通量分析最终拼的是效率与可复现性,而不是单次搜索速度。
2.2 适合哪些场景
WorkBuddy 与 Ensembl 的结合,最适合以下场景。
- 文献前期调研,需要快速核对基因名、别名和功能描述。
- 转录组或突变研究,需要查看某个基因的转录本结构。
- 变异分析,需要结合 VEP 判断突变潜在影响。
- 批量基因整理,需要借助 BioMart 导出标准化信息。
- 跨物种比较,需要查看同源基因和保守性。
如果你的工作目标是从“原始列表”走到“可解释结果”,这个组合会明显提升效率。
3. Ensembl常用功能与实战检索路径
3.1 基因、转录本和变异的检索逻辑
Ensembl 首页提供多个入口,常见标签包括 genome、chromosome region、gene、transcript 和 variation。实际使用时,可以按任务选择不同路径。
- gene:适合找基因总览。
- transcript:适合看转录本结构和编码信息。
- variation:适合查 SNP 和功能影响。
- chromosome region:适合按染色体坐标定位。
比如检索人类 lncRNA XIST。先在物种栏选择 Human,再输入基因名搜索。进入结果页后,可进一步查看基因位置、转录本结构、序列和表达信息。
这类步骤看似简单,但它是后续分析的基础。 因为只有先确认基因身份,后续的变异解释才可靠。
3.2 BLAST、BioMart、VEP分别做什么
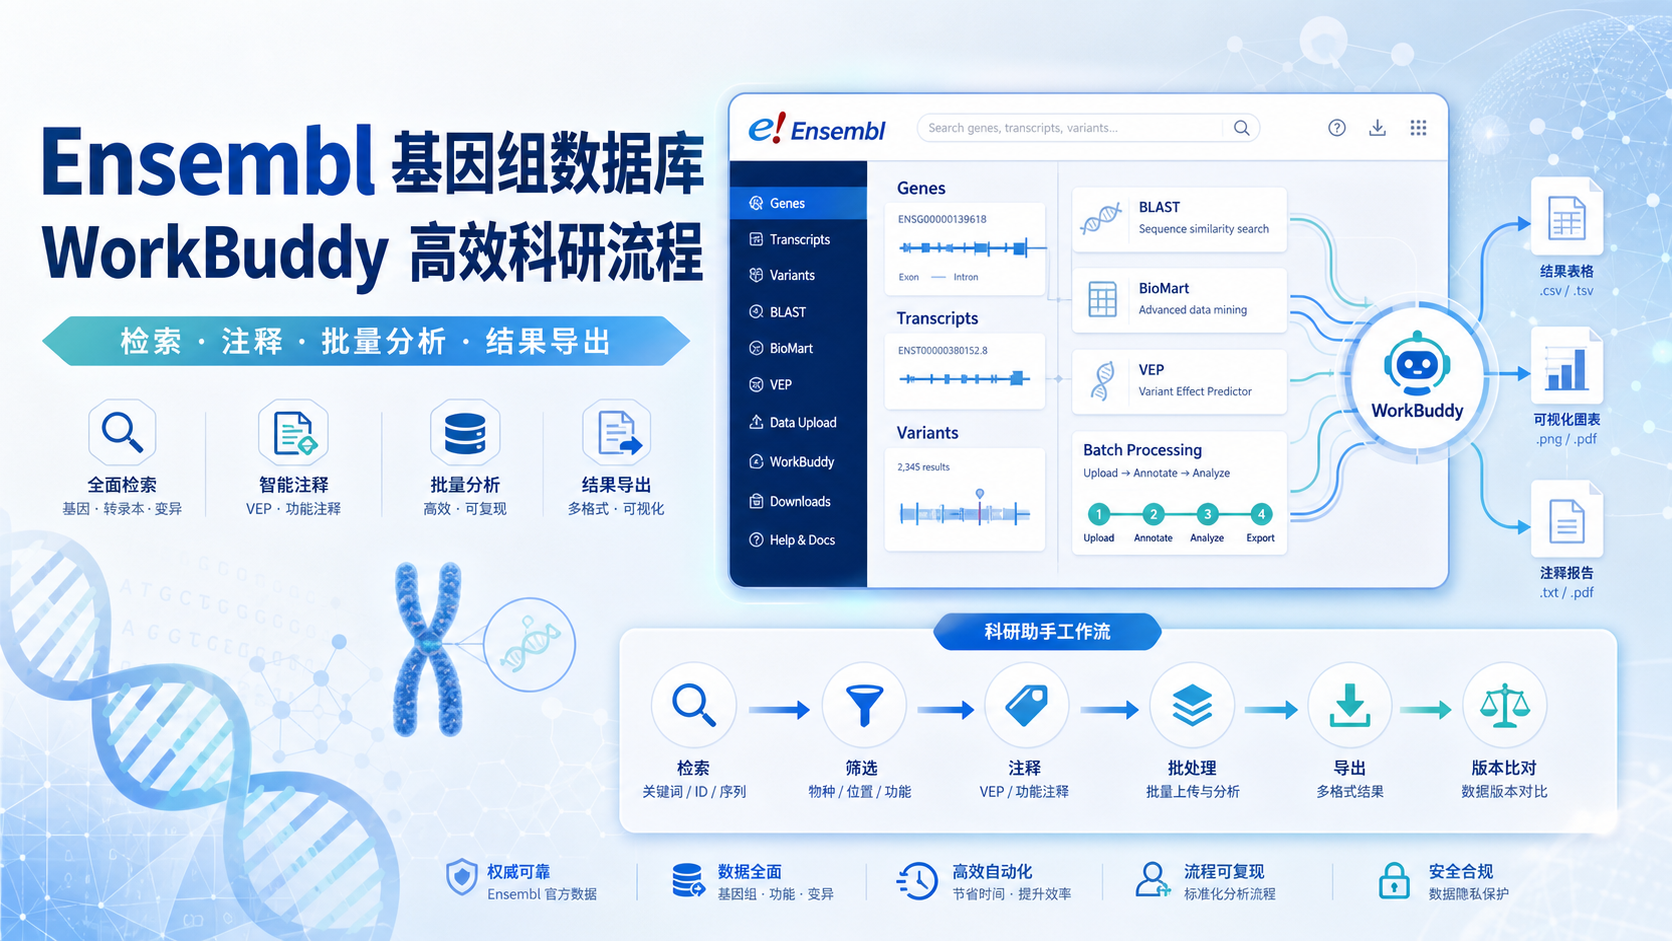
Ensembl 最常用的三个工具是 BLAST、BioMart 和 VEP。
-
BLAST。
用于短序列相似性搜索。适合从未知序列反推基因来源。 -
BioMart。
用于批量筛选和下载。可按基因、区域、同源关系、变异信息等条件导出数据。 -
VEP。
用于变异效应预测。适合判断某个 SNP 或插入缺失是否影响蛋白编码或调控区域。
在真实项目中,这三个工具经常联动使用。
先用 BLAST 或关键词定位,再用 BioMart 批量导出,再用 VEP 做变异解释,能形成完整链路。
3.3 结果页面要重点看哪些信息
进入 Ensembl 基因页后,建议重点关注以下模块。
- 基因名称和 Ensembl 编号。
- 基因组位置。
- 转录本数量和结构。
- 蛋白编码状态。
- 同源基因信息。
- 组织表达信息。
- 变异注释信息。
其中,Ensembl 基因编号通常以 ENSG 开头,转录本编号通常以 ** ENST** 开头。
这两个编号是后续数据对齐和结果复现的关键锚点。 如果编号记录不规范,后面很容易出现版本不一致或映射错误。
4. 用WorkBuddy提升Ensembl数据处理效率
4.1 批量任务比单次搜索更重要
对于科研项目,真正耗时的往往不是查一个基因,而是整理一批基因。比如差异表达分析后,你可能得到几十到几百个候选基因,需要统一补齐以下信息。
- Ensembl ID。
- Gene symbol。
- 转录本信息。
- 蛋白编码状态。
- 染色体位置。
- 同源基因。
- 变异注释。
这时,WorkBuddy 的价值在于帮助研究者把重复性的查询和整理动作标准化。
与其手工逐个打开页面,不如把任务按固定模板执行,减少遗漏。
4.2 适合科研工作流的三个步骤
一个更稳定的分析流程,通常可以这样设计。
第一步,统一输入。
先整理基因列表或变异列表,明确物种、ID 类型和参考版本。
第二步,标准化查询。
在 Ensembl 中确认基因身份、版本和注释层级。必要时使用 BioMart 或 VEP。
第三步,结果归档。
把关键字段统一保存,方便后续统计、绘图和论文写作。
WorkBuddy 对接 Ensembl,最重要的不是“多一个工具”,而是把这三个步骤串成闭环。
对于需要反复迭代的数据分析项目,这种闭环能明显降低沟通成本和返工率。
5. 实际应用中最容易踩的坑
5.1 参考版本不一致
Ensembl 常见参考版本包括 GRCh37 和 GRCh38。不同版本的基因坐标可能不同。
如果文献、数据库和自己的分析版本不一致,结果会出现偏差。
建议在开始前先确认三件事。
- 使用的基因组版本。
- 使用的物种和亚群数据库。
- 结果导出时的 ID 类型。
5.2 只看基因名,不看注释来源
同一个基因名,可能对应多个转录本。不同转录本的外显子结构、编码能力和功能注释并不完全一致。
因此,单看 gene symbol 远远不够。
特别是在以下研究中更要谨慎。
- 剪接变异研究。
- lncRNA 研究。
- 肿瘤体细胞突变分析。
- 跨物种同源比较。
5.3 批量导出时忽略字段设计
使用 BioMart 时,如果一开始没有设定好 attributes,导出的结果就可能缺少关键字段。
建议在导出前明确你要什么。
- 只要基因名和坐标。
- 还是要转录本和蛋白信息。
- 是否需要同源基因。
- 是否需要变异和功能域信息。
字段设计比后期补救更省时间。
6. 结论与行动建议
Ensembl 的强项,是把基因组、转录本、变异、表达和跨物种信息整合在一个标准化框架里。对医学生、医生和科研人员来说,它不仅是查询工具,更是研究设计和结果解释的基础设施。
WorkBuddy 对接 Ensembl 的核心价值,在于把这种复杂检索变成更高效、更可重复的分析流程。
如果你正在做基因组数据整理、变异注释或批量信息提取,建议先建立统一的检索与归档路径。这样可以显著减少重复劳动,提升结果一致性。
想把 Ensembl 的数据能力真正用到项目里,可以结合解螺旋的工具与服务,进一步优化你的检索、注释和结果整理流程。
- 引言Introduction
- 1. 为什么Ensembl是基因组研究的基础工具
- 2. WorkBuddy对接Ensembl的核心价值
- 3. Ensembl常用功能与实战检索路径
- 4. 用WorkBuddy提升Ensembl数据处理效率
- 5. 实际应用中最容易踩的坑
- 6. 结论与行动建议