53
 分享
引言Introduction
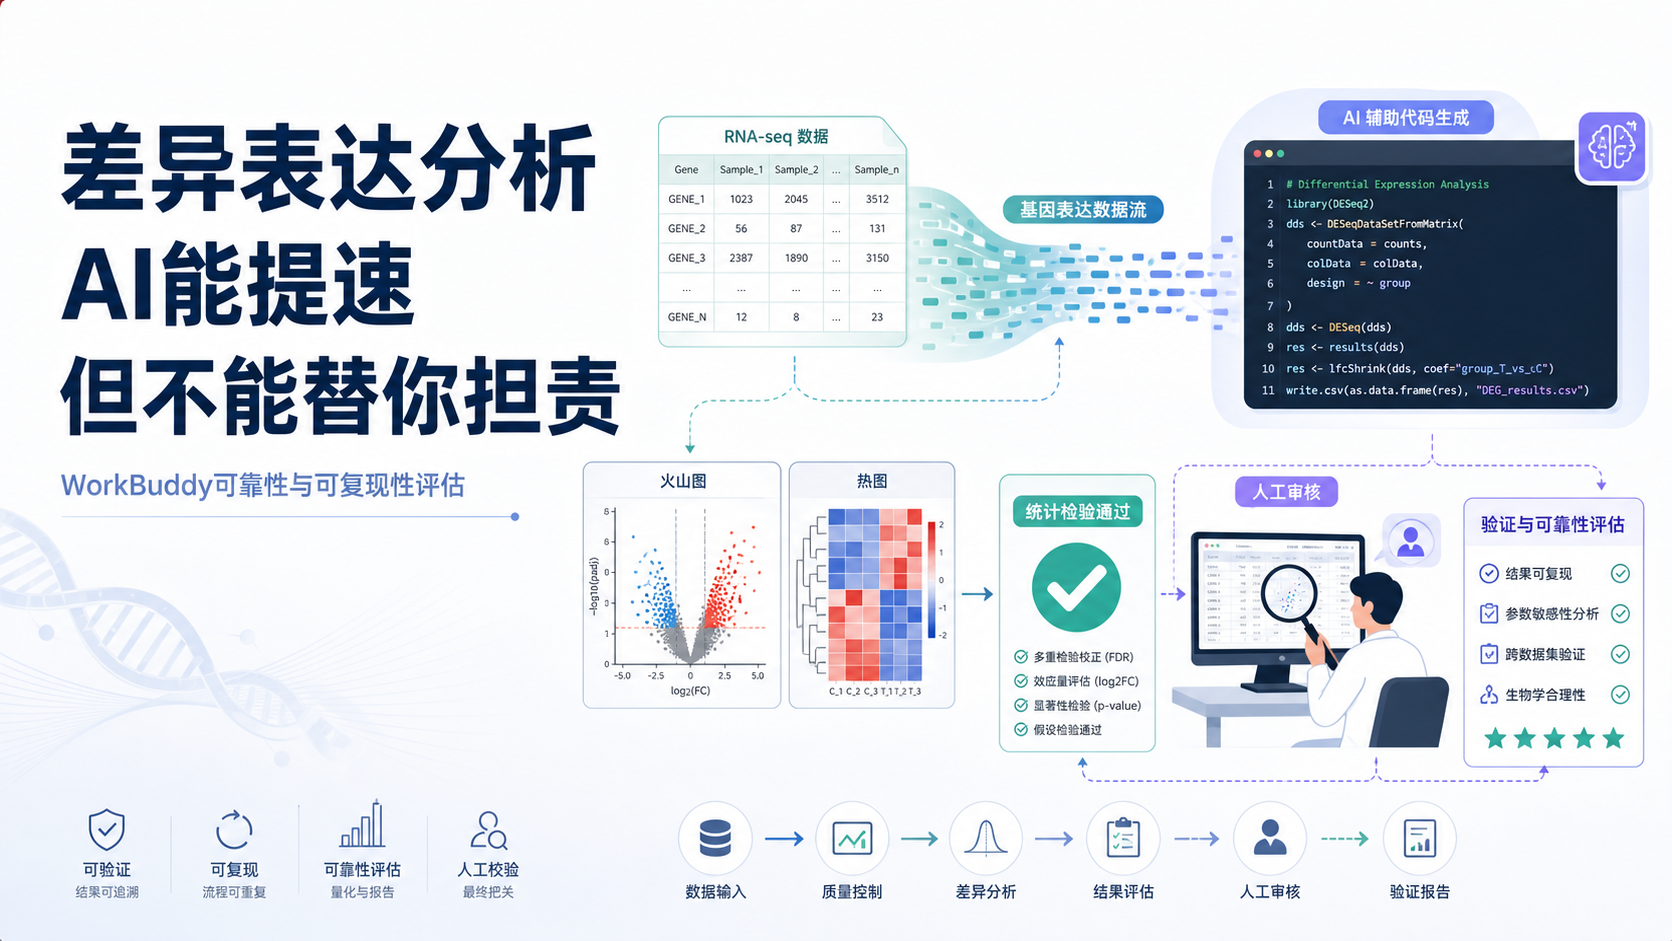
差异表达分析看似流程固定,实际最怕两件事。第一,代码生成前后不一致。第二,分析结果难以复现。对于医学生、医生和科研人员来说,如果工具不能被验证,就很难放心用于正式研究 。
1. 为什么差异表达分析最需要“可验证”
1.1 差异表达分析的核心不是“快”,而是“对”
差异表达分析常用于转录组、单细胞和临床样本研究。它的目标很明确,就是找出不同组别之间表达显著变化的基因。常见流程包括质控、标准化、分组比较、统计检验和结果可视化。
但这个流程里,任何一步出错,都会影响最终结论。比如分组标签错位、归一化方法不一致、阈值设置不当,都会导致假阳性或假阴性增加。因此,差异表达分析的首要标准不是生成速度,而是流程是否稳定、结果是否可复核。
1.2 传统AI现写代码,风险在于每次输出都可能不同
从知识库信息看,WorkBuddy目前的一个关键问题是,它在做数据分析时会自己现写代码。这里的风险很现实。大模型本身存在随机性,同样的提示词,两次生成的文本不一定一致,代码也可能不一致 。
对于不懂代码的人,这会放大风险。因为你无法仅凭输出判断代码是否真正正确。哪怕分析步骤看上去完整,只要某个参数、对象名或统计方法错了,后面的差异表达结果就可能全部偏离。
1.3 可复现性比“自动化”更重要
科研领域强调可复现。尤其是差异表达分析,建议优先使用固定流程、固定R包和固定脚本逻辑。知识库中也明确提到,分析流程中的代码本质上应该是固定的 。相比让AI临时编写代码,更严谨的方式是让AI调用成熟工具包和标准流程。
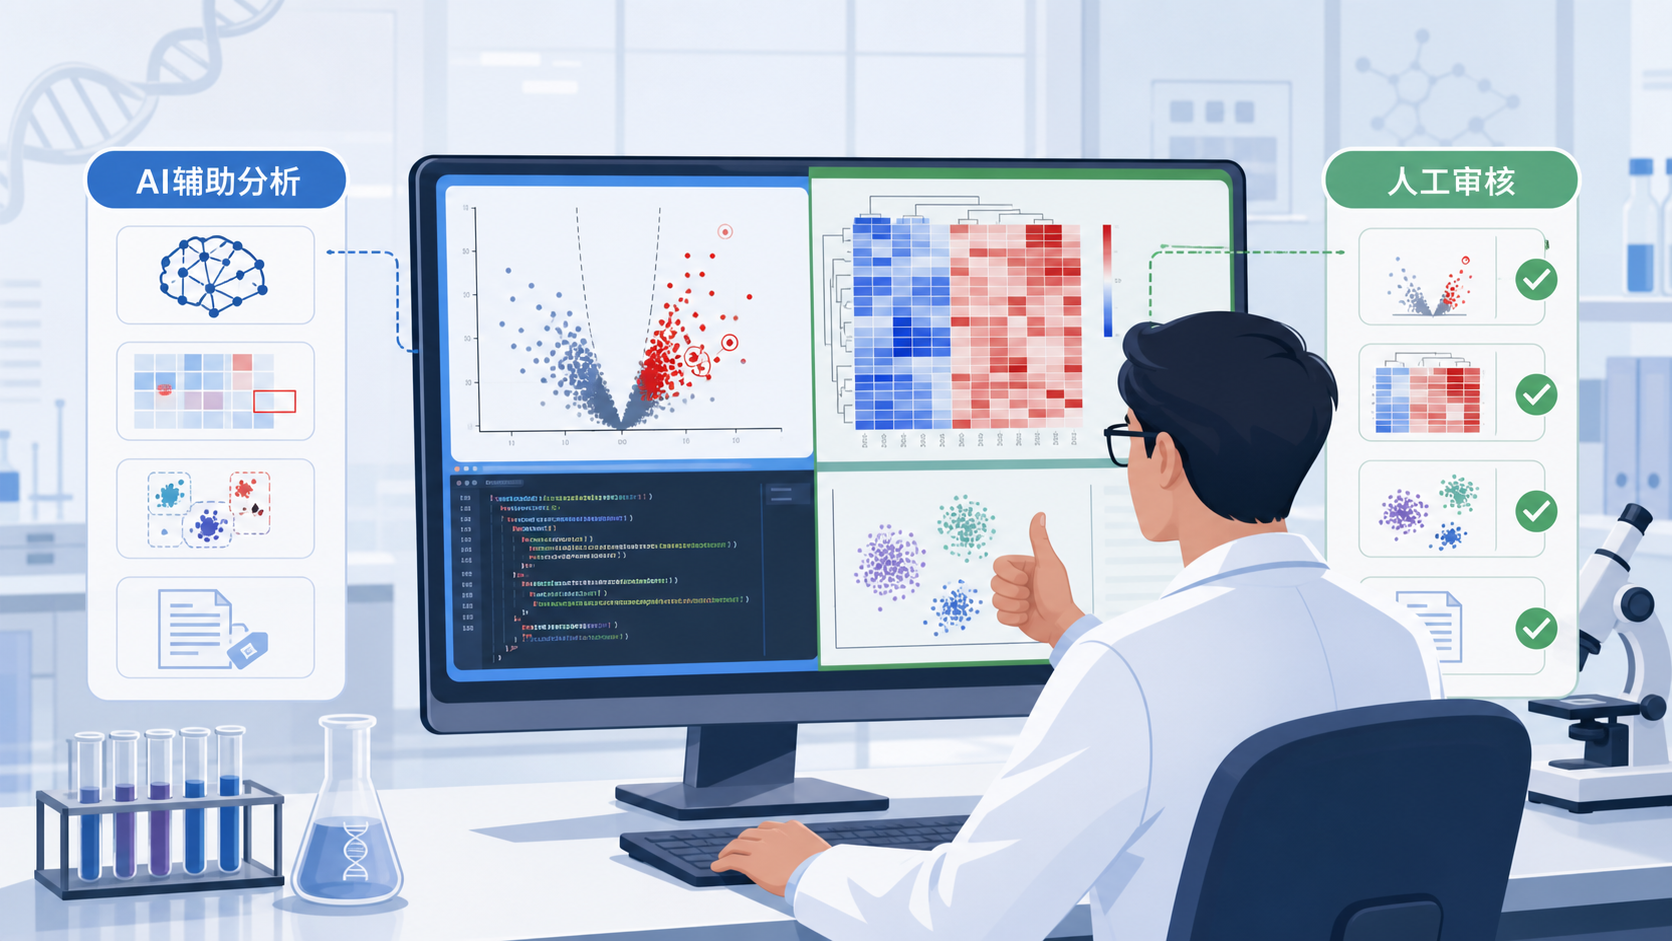
这意味着,WorkBuddy当前的价值,更适合被理解为“辅助执行”和“提高效率”,而不是“替代科研判断”。
2. WorkBuddy在差异表达分析中的实际表现
2.1 它的优势在于能缩短前期整理时间
从现有反馈看,WorkBuddy在科研写作和数据分析场景中,已经能明显缩短部分准备时间。比如在国自然相关任务里,演示流程大约只用了5到7分钟。这说明它在任务拆解、文本组织和流程驱动上,效率是有优势的。
放到差异表达分析中,这种优势主要体现在:
- 帮助整理分析步骤。
- 辅助调用工具和脚本。
- 提高重复性工作的执行速度。
- 减少初稿阶段的时间消耗。
但要注意,效率提升不等于统计结果自动正确 。尤其在正式科研中,任何自动化输出都要经过人工复核。
2.2 真实瓶颈在初筛和数据抽取,不在生成一句代码
知识库提到,工作台使用中有两个关键慢点。一个是初筛,尤其在文献量大时。另一个是数据抽取,需要上传全文并转换格式。这个逻辑对差异表达分析同样成立。
如果输入数据本身不规范,或者样本注释不准确,再强的工具也无法直接得到可靠结果。对于差异表达分析而言,真正耗时的往往不是生成图,而是:
- 样本信息清洗。
- 分组定义确认。
- 表达矩阵格式检查。
- 批次效应和异常值识别。
所以,WorkBuddy能加速流程,但不能替代前置的数据治理。
2.3 它更适合“会审核代码”的用户
知识库里有一个判断非常关键。如果使用者本身懂代码,就可以让AI辅助写代码,因为人可以审核并修改。 这句话对差异表达分析尤其重要。
例如,研究者可以检查:
- 输入对象是否正确。
- 统计检验是否匹配数据类型。
- 阈值是否符合研究设计。
- 可视化代码是否与结果表一致。
- 结果图是否对应标准输出。
如果用户完全不懂代码,就很难确认结果是否可靠。这样一来,AI输出反而可能成为“看起来很专业”的错误结论。
3. 如何评估WorkBuddy在差异表达分析中的可靠性
3.1 先看流程一致性,再看结果一致性
评估一个AI分析工具,不能只看一次成功案例。更合理的方法是看它在重复运行时是否保持一致。对于差异表达分析,建议从三个层面评估:
- 流程一致性 :是否每次都按同一逻辑执行。
- 参数一致性 :阈值、方法、包版本是否固定。
- 结果一致性 :差异基因列表、火山图、热图是否稳定。
如果同一批数据重复分析后,核心结果频繁变化,就说明工具可靠性不足。对临床研究和论文投稿而言,这种波动是不可接受的。
3.2 重点检查统计方法是否适配数据
差异表达分析并不是“套一个模板”就行。不同数据类型需要不同方法。比如RNA-seq、单细胞、微阵列,常用工具和统计思路并不完全相同。即使同样叫差异分析,实际处理也会有区别。
因此,评估WorkBuddy时,应该重点看它是否能够正确调用标准方法,而不是只关注它能不能写出代码。真正可靠的工具,必须理解数据类型、分组设计和统计假设。
3.3 人工校验仍然是必须环节
知识库明确指出,多线程处理可以提高效率,但仍做不到百分百准确,人工校验必不可少。这个结论对差异表达分析同样成立。
建议至少完成以下人工核查:
- 核对样本分组是否正确。
- 检查标准化前后表达分布是否合理。
- 复核差异基因筛选阈值。
- 查看火山图、热图是否与结果表一致。
- 对关键基因进行文献或实验验证。
只要涉及论文发表、基金申报或临床转化,人工审核都不能省。
4. 适合什么场景,不适合什么场景
4.1 适合的场景是辅助,不是最终定稿
根据目前信息,WorkBuddy更适合用于科研流程辅助,尤其适合已经具备一定方法学基础的人群。它可以帮助你更快完成:
- 代码草稿生成。
- 分析思路整理。
- 文献和结果摘要。
- 标准化流程执行。
对于经验较足的研究者,这类工具能明显节省重复劳动时间。但它仍然是助手,不是最终裁判。
4.2 不适合完全依赖的场景
以下场景不建议完全依赖WorkBuddy:
- 样本量大且批次复杂的正式队列分析。
- 需要严格可复现的方法学研究。
- 准备发表SCI论文的关键结果。
- 涉及临床决策依据的分析结论。
原因很简单。只要结果需要承担学术或临床责任,就必须确保每一步都能追溯。AI可以参与,但不能替代责任主体。
4.3 方法部分必须写清楚AI工具使用情况
知识库中提到,作者需对结果负责,并在方法中注明使用了哪些AI工具。这个要求非常重要。对于差异表达分析论文,建议在方法学部分说明:
- 是否使用了AI辅助工具。
- AI参与了哪些步骤。
- 哪些步骤由人工复核。
- 最终分析脚本由谁确认。
透明披露,既是科研诚信要求,也是提升审稿信任度的基础。
5. 结论:WorkBuddy能提速,但不能替你担责
综合来看,WorkBuddy在差异表达分析中的价值,主要在于提升效率和辅助流程,而不是完全自动替代分析。它的优点是能帮研究者更快进入分析状态。它的短板是,当前仍存在代码生成不稳定、流程自动化未完全成熟、人工校验不可省略等问题。
对医学生、医生和科研人员来说,最稳妥的使用方式是:把WorkBuddy当作标准流程的辅助工具,而不是结果的唯一来源。 先保证数据、流程和代码可验证,再谈效率提升,才符合科研规范。
如果你希望在保证可复现的前提下提升差异表达分析效率,可以关注和使用解螺旋的科研支持服务。解螺旋可以帮助你把复杂分析流程标准化、可视化,并尽量减少重复劳动,让你把更多时间留给真正的科研判断。
- 引言Introduction
- 1. 为什么差异表达分析最需要“可验证”
- 2. WorkBuddy在差异表达分析中的实际表现
- 3. 如何评估WorkBuddy在差异表达分析中的可靠性
- 4. 适合什么场景,不适合什么场景
- 5. 结论:WorkBuddy能提速,但不能替你担责