63
 分享
引言Introduction
生存预后危险因素分析常见一个核心问题。回顾性研究里,治疗组和对照组往往先天不平衡,年龄、分期、合并症都会干扰结论。如果不控制混杂,危险因素可能被高估或低估,甚至得出错误的独立预后判断。
1. 为什么生存预后分析容易出现偏倚
1.1 回顾性队列的天然局限
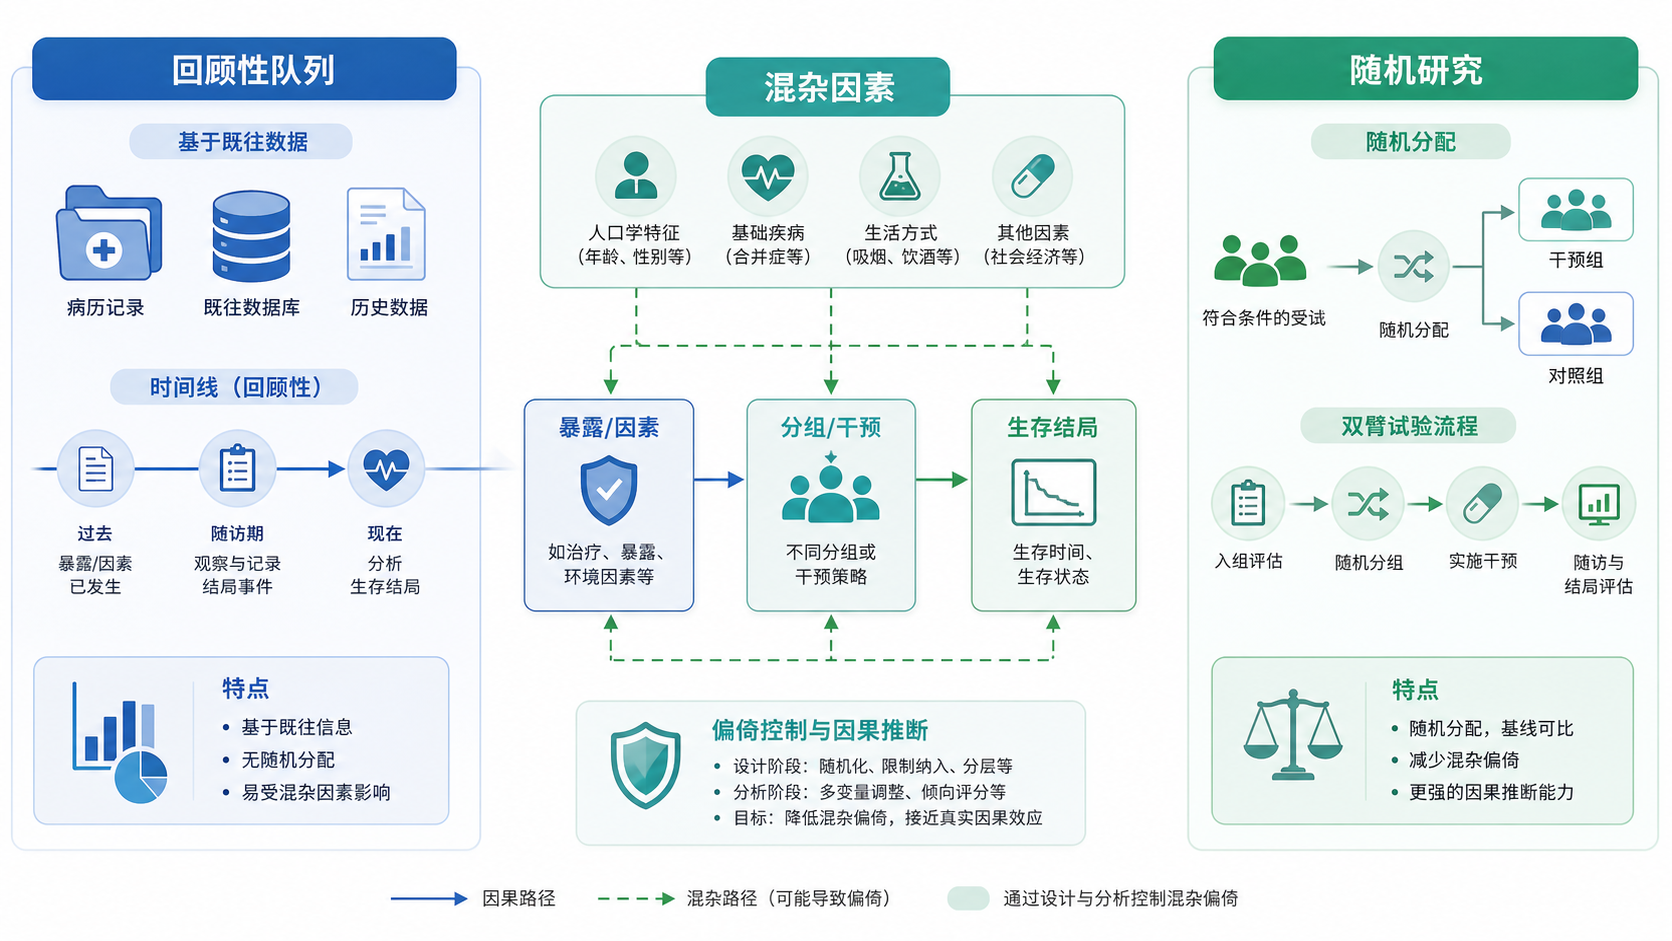
在生存预后危险因素分析中,最常见的是回顾性队列研究。研究者基于既往病例,比较暴露组与非暴露组的生存结局,如总生存期,疾病无进展生存期,或无病生存期。
问题在于,组间分布通常不是随机的。 接受某项治疗的患者,往往更年轻,病情更重,或分期更晚。这样的差异会直接影响生存结局。
这类偏倚会带来两个后果。
- 把真正无关的因素误判为危险因素。
- 把真实存在的危险因素效应掩盖掉。
1.2 混杂因素会如何扭曲结论
混杂因素的定义很关键。它与暴露因素相关,也与结局相关,但不在因果通路中间。
在生存分析中,常见混杂因素包括。
- 年龄。
- 性别。
- 分期。
- 病理分级。
- 合并症。
- 是否接受治疗。
当这些变量在组间不均衡时,Cox回归即使纳入多因素调整,也可能受到样本结构影响。 特别是在变量较多、样本量有限时,模型稳定性会下降。
1.3 随机化为什么更强
前瞻性随机研究之所以更可靠,核心在于随机化。它能让潜在混杂因素在组间尽量均衡。
但在很多预后研究场景中,随机化不可行。比如真实世界治疗选择、罕见病、伦理限制,都会阻碍随机分组。
这时,倾向性评分法就成为连接观察性研究和类随机比较的重要工具。
2. 倾向性评分法在生存分析中的核心逻辑
2.1 倾向性评分是什么
倾向性评分,指的是在给定协变量条件下,一个个体接受某种暴露或处理的概率。取值范围是0到1。
它不是结果变量,也不是因果效应值,而是“进入治疗组的可能性”。
多个混杂因素可以压缩成一个综合评分,这就是它在生存预后危险因素分析中的价值。
在实际研究中,研究者通常先基于年龄、性别、分期、病理特征等变量,估算每个病例的倾向性评分,再据此进行匹配、分层、加权或回归调整。
2.2 为什么它适合预后研究
倾向性评分法适用于现况调查、病例对照研究、队列研究和非随机干预研究。
在生存预后分析中,它尤其适合以下场景。
- 比较接受与未接受某治疗后的生存差异。
- 评估某暴露因素是否为独立预后因素。
- 在多协变量背景下,减少组间不平衡。
它的核心目标不是“制造显著性”,而是提高可比性。 当组间基线更接近时,后续Cox回归得到的危险因素结论更可信。
2.3 倾向性评分不能单独替代统计分析
要注意,倾向性评分法本身不是结局分析模型。
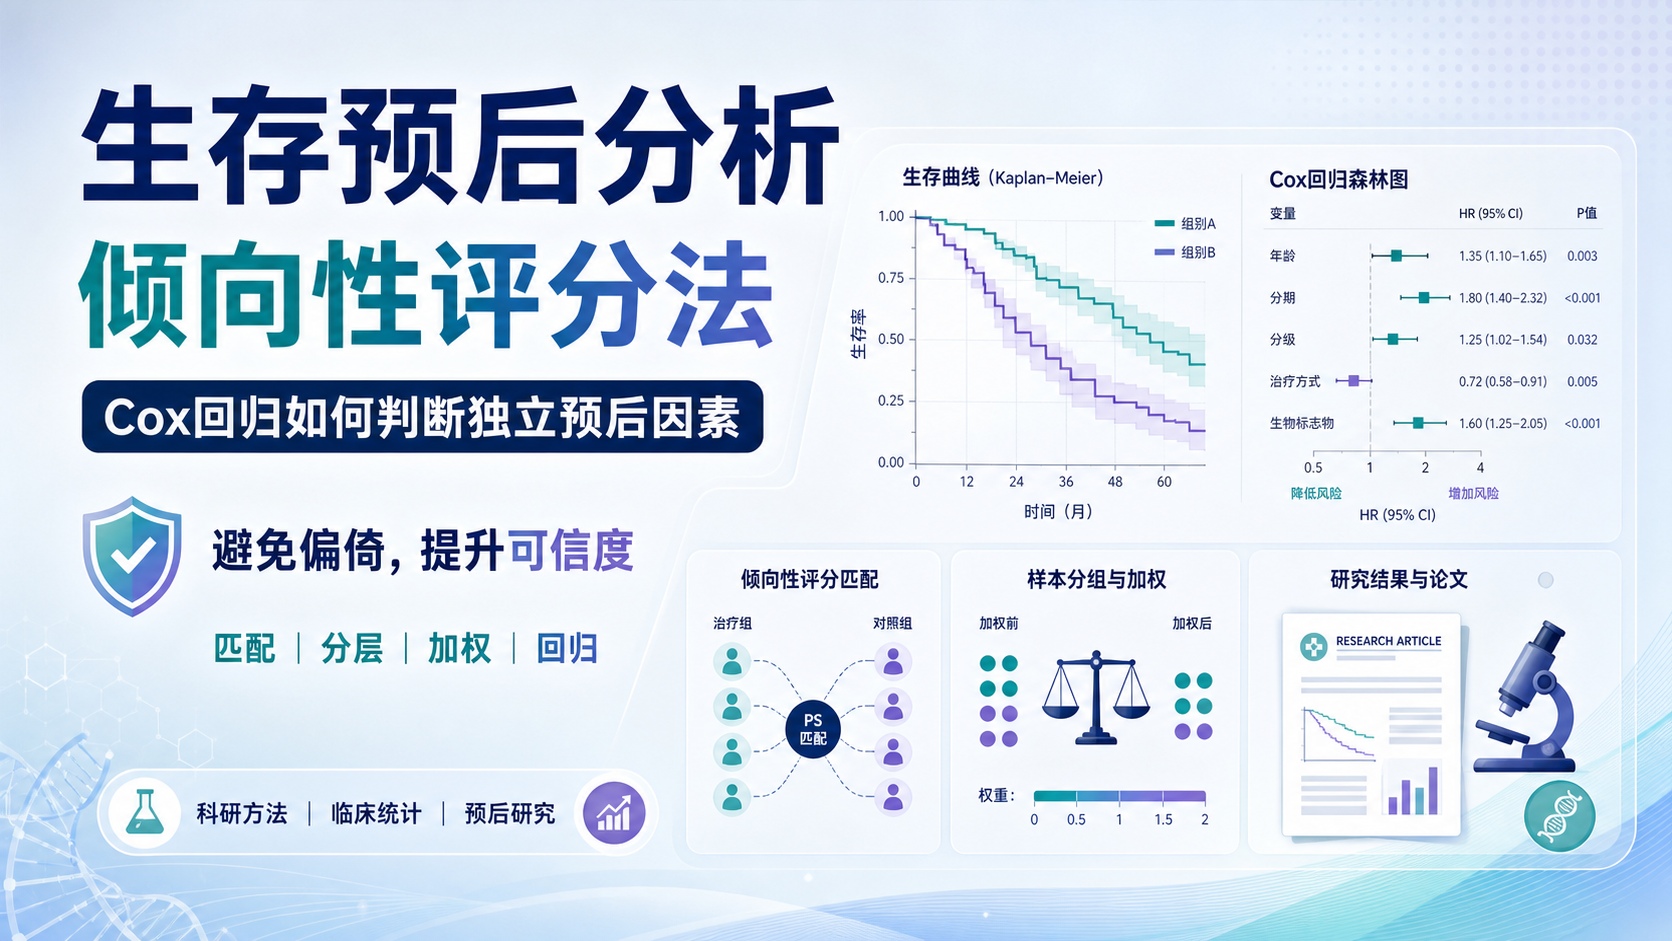
它的作用是先处理混杂,再进行生存分析。常见流程是。
- 计算倾向性评分。
- 进行1:1或1:n匹配,或加权。
- 检查平衡性。
- 再进入Kaplan-Meier或Cox回归。
如果跳过第3步,直接使用匹配结果,很容易忽略残余混杂。
标准化差异通常比单纯P值更适合评估匹配后平衡性。
3. 生存预后危险因素分析中常用的倾向性评分方法
3.1 倾向性评分匹配
倾向性评分匹配是最常用的方法。它会把治疗组和对照组中倾向性评分相近的个体配对,形成更均衡的比较样本。
常见匹配方式包括最近邻匹配、完全匹配和最优匹配。
实际研究中,很多人会设置卡钳值,避免差异过大的样本被错误匹配。
匹配后,组间基线变量应尽量达到平衡。 如果某些变量仍明显失衡,说明匹配质量不足,结论需谨慎解释。
3.2 倾向性评分分层与加权
除了匹配,还可以分层或加权。
分层是把不同倾向性评分水平的个体分到不同层内,再进行层内比较。
加权则是根据倾向性评分赋予个体不同权重,使样本接近目标人群的分布。
这些方法适合样本量较大、不能浪费病例的研究。
尤其是加权法,在保留全部样本方面有优势。
但其对模型设定更敏感,权重极端时还要关注稳定性。
3.3 倾向性评分进入回归模型
另一种做法是把倾向性评分直接纳入Cox回归。
这适用于协变量较多、而且不适合逐一纳入模型的情形。
需要强调的是,此时调整的是评分,而不是所有原始混杂变量本身。
它能减少模型维度,但前提仍然是评分构建合理。
4. 在Cox回归中如何判断“独立预后因素”更可信
4.1 匹配前后结果要一起看
在生存预后危险因素分析里,最有说服力的不是单一模型结果,而是匹配前后的一致性。
如果某变量在匹配前显著,匹配后不显著,说明它可能受混杂影响。
如果某变量在匹配前后都显著,且效应量稳定,则其独立预后价值更强。
这也是倾向性评分法的重要意义。
它帮助研究者区分“假危险因素”和“真危险因素”。
4.2 结局分析要结合HR而不是只看P值
生存分析中,HR值比单纯P值更重要。
HR大于1,提示风险上升。
HR小于1,提示风险下降。
但是否具有统计学意义,还要看95%CI是否跨越1。
例如,一个因素在匹配前HR明显升高,但匹配后HR接近1且CI跨1,往往提示其效应并不稳健。
因此,生存预后危险因素的判断应以“效应量+置信区间+平衡性”综合评估。
4.3 常见报告要点
规范的论文通常至少报告以下内容。
- 倾向性评分模型纳入了哪些协变量。
- 匹配方法与卡钳值。
- 匹配前后样本量。
- 基线平衡性指标。
- Cox回归中的HR、95%CI和P值。
- Kaplan-Meier曲线及log-rank检验。
这些信息缺一不可。 否则读者无法判断结果是否可靠。
5. 研究设计中最容易忽略的细节
5.1 协变量选择要有临床依据
协变量不是越多越好。
应优先纳入已知与治疗选择和结局都相关的变量。
例如年龄、性别、分期、病理分级、关键实验室指标、合并症等。
如果变量过多,容易出现匹配困难,样本大量丢失。
5.2 匹配不是越严格越好
过严的匹配会导致可用样本骤减。
最终虽然平衡性更好,但外推性下降。
因此,研究者要在平衡性和样本保留之间取得平衡。
这一步需要结合研究目的、样本量和疾病特点综合判断。
5.3 结果解释要避免过度推断
倾向性评分能缓解混杂,但不能消除未测量混杂。
它无法替代随机试验。
所以在论文讨论中,应避免把观察性结果写成确定因果。
更稳妥的表述是,某因素“与更差生存相关”或“可能是独立预后因素”。
6. 一个实际可操作的分析思路
6.1 推荐流程
做生存预后危险因素分析时,可按以下顺序展开。
- 明确主要暴露因素和结局。
- 选择有临床意义的协变量。
- 计算倾向性评分。
- 进行匹配或加权。
- 检查平衡性。
- 重新做Kaplan-Meier和Cox回归。
- 对比匹配前后结果。
6.2 结果解读框架
建议按“三看”原则解读。
- 看平衡性,组间是否接近。
- 看HR,效应方向是否一致。
- 看一致性,匹配前后结果是否稳定。
如果一个变量在多种分析框架下都保持稳定,作为生存预后危险因素的可信度就更高。
6.3 对医学生和科研人员的实用建议
对于初学者,最常见的错误有三类。
- 只做匹配,不检验平衡性。
- 只看P值,不看HR和CI。
- 忽略未测量混杂。
把这三点避开,文章质量通常会明显提升。
如果你想把倾向性评分法真正用好,关键不只是会跑软件,而是理解它如何服务于因果解释。
总结Conclusion
在生存预后危险因素分析中,倾向性评分法的价值很明确。它能改善组间可比性,减少混杂偏倚,让Cox回归和生存曲线更接近真实效应。它不能代替随机化,但能显著提升观察性研究的可信度。
如果你正在撰写临床论文、预后研究或真实世界研究,建议在设计、分析和结果解释阶段都加入倾向性评分思维。需要更高效的论文支持和方法学服务时,可以进一步了解解螺旋 ,帮助你把生存预后危险因素分析做得更规范、更稳健。
- 引言Introduction
- 1. 为什么生存预后分析容易出现偏倚
- 2. 倾向性评分法在生存分析中的核心逻辑
- 3. 生存预后危险因素分析中常用的倾向性评分方法
- 4. 在Cox回归中如何判断“独立预后因素”更可信
- 5. 研究设计中最容易忽略的细节
- 6. 一个实际可操作的分析思路
- 总结Conclusion