72
 分享
引言Introduction
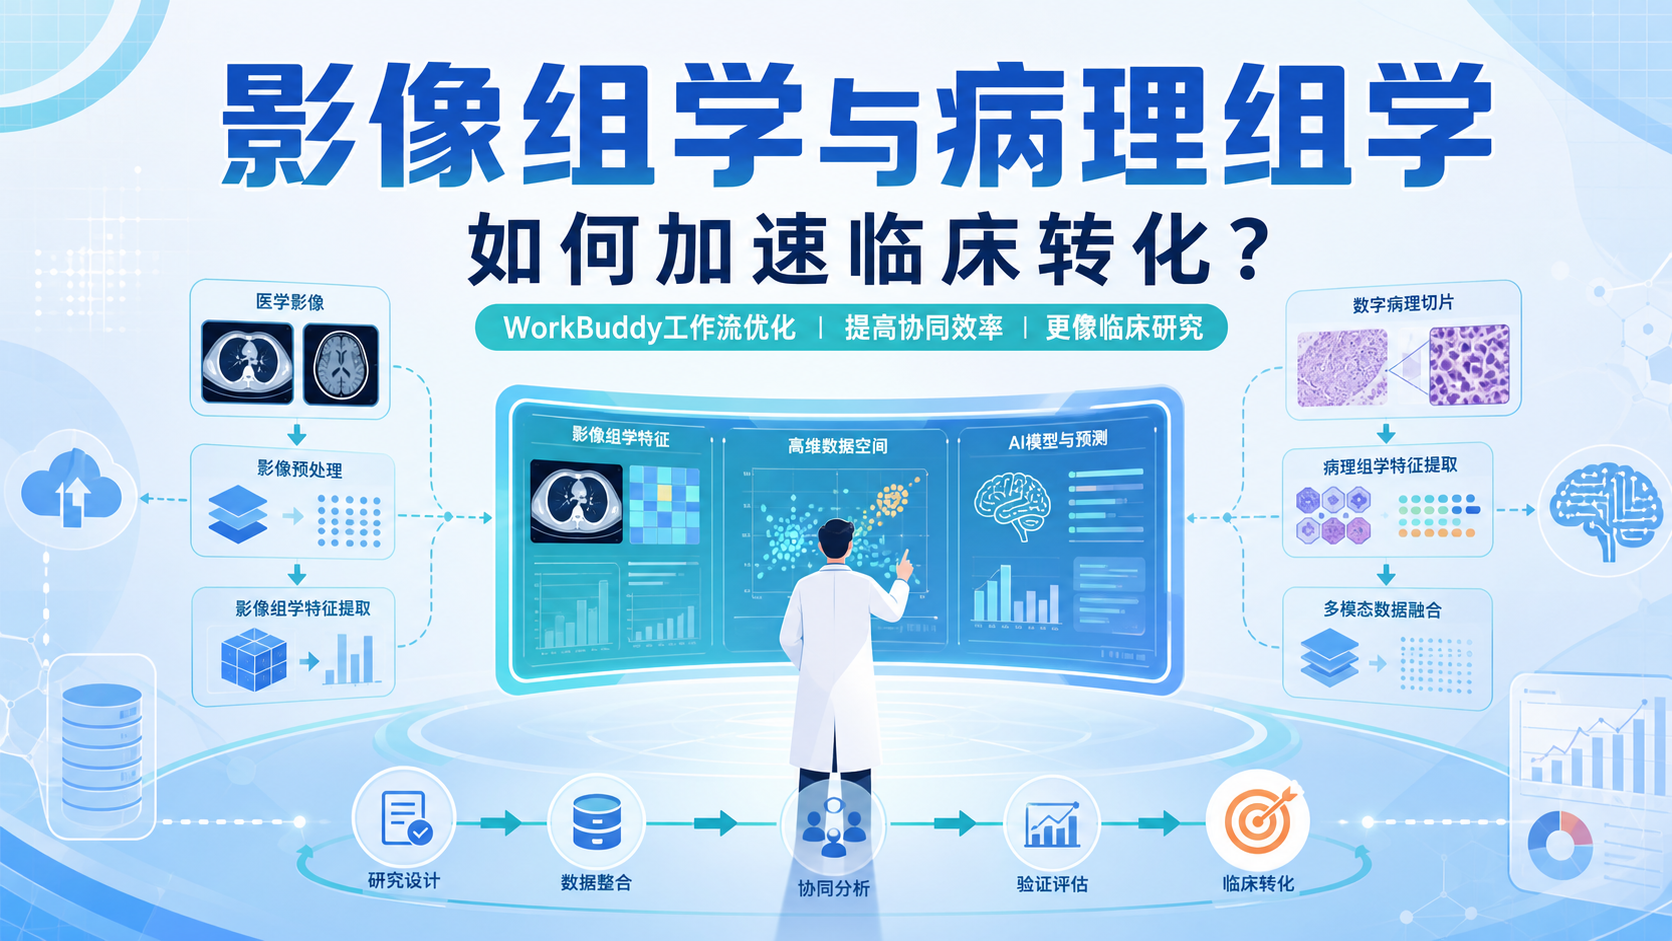
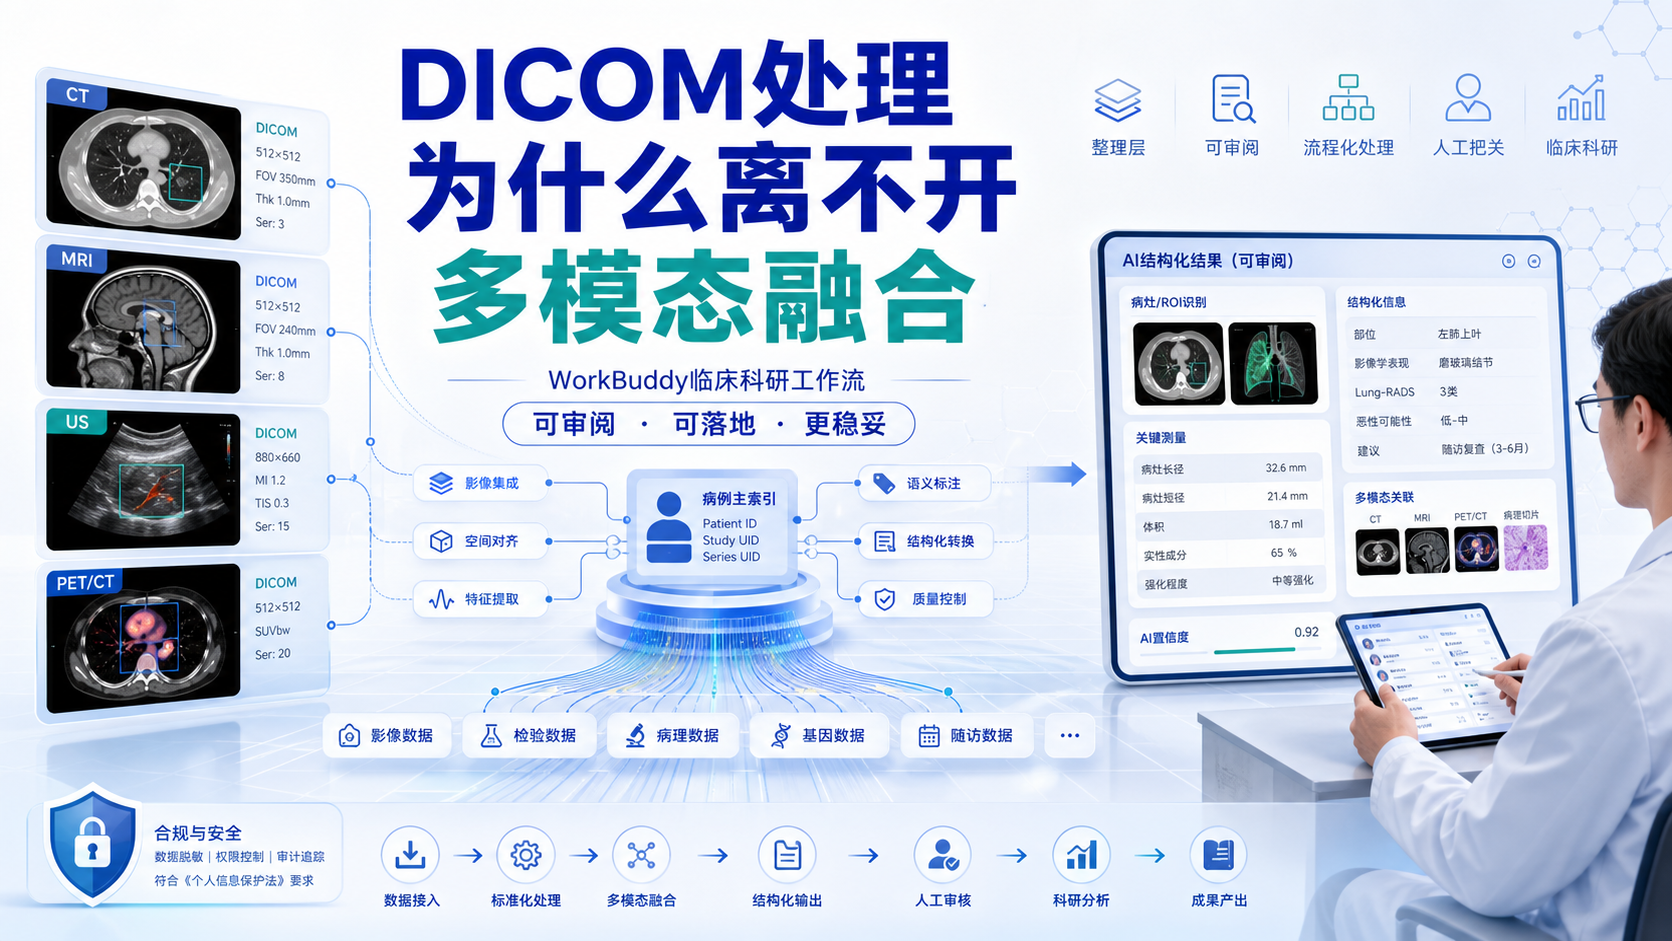
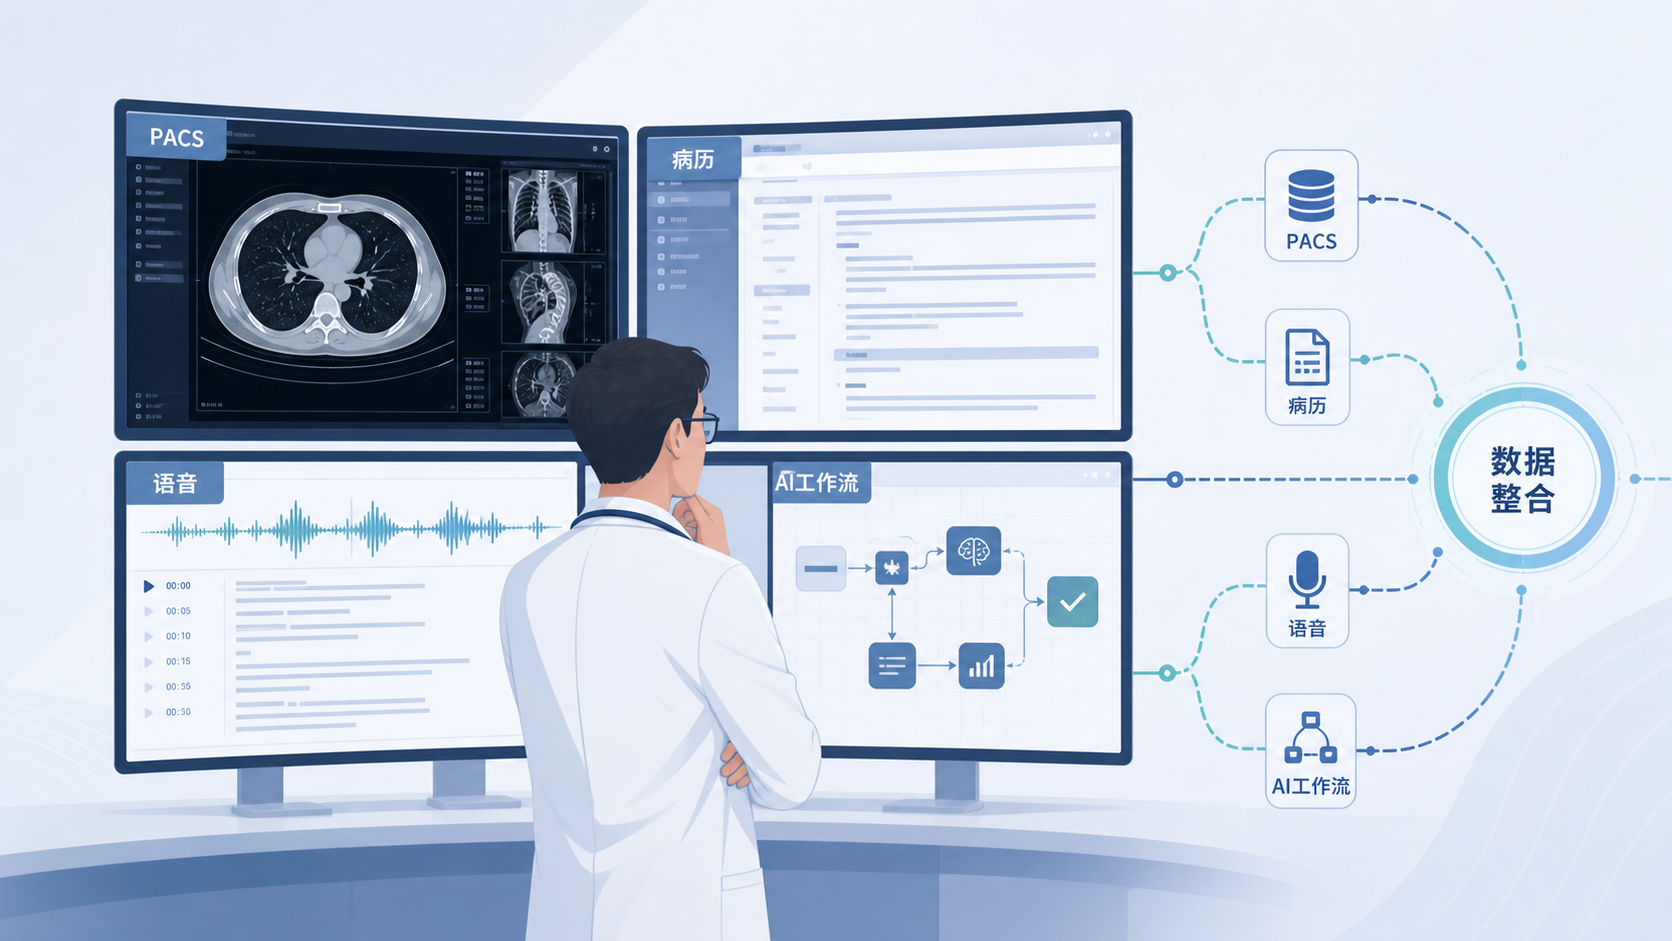
DICOM影像、临床文本、病历截图、语音记录,往往散落在不同系统里。医生想做研究、做随访、做自动化整理,最难的不是分析,而是先把数据接起来。WorkBuddy多模态融合DICOM处理,正是在解决这个临床真实痛点。
1. 为什么DICOM处理离不开多模态融合
1.1 单看影像,信息是不完整的
在临床研究中,DICOM只提供影像本身。它能告诉你病灶在哪里、大小如何、层面如何变化,但很难单独回答“这是不是最终诊断”“患者是否接受过治疗”“病理结果如何”等问题。影像结论如果脱离病历上下文,容易出现误判。
这也是为什么影像组学、临床预测模型和真实世界研究,都越来越强调多模态数据。常见输入不止影像,还包括:
- 结构化病历字段。
- 门诊和住院文本。
- 语音转写记录。
- 实验室检查结果。
- 病理与随访结局。
对于医学生和科研人员来说,真正的难点不是“有没有影像”,而是如何把DICOM和其他临床信息对齐到同一个病例、同一个时间点、同一个研究问题上。
1.2 多模态的核心,不是“更多”,而是“对齐”
多模态融合不是简单堆数据。研究设计里最重要的是一致性。比如同一个病例,CT扫描时间、术前病理时间、治疗开始时间、随访时间,必须清楚标注。否则再好的模型,也只能学到噪声。
临床实战中,至少要先明确三件事:
- 病例单位是否统一。
- 时间轴是否可追溯。
- 标签来源是否可靠。
如果这三点不清,后续无论是ROI提取、特征分析,还是AI建模,都会出问题。DICOM处理真正考验的是“数据治理能力”,不是单纯的图像打开能力。
2. WorkBuddy在临床场景中的价值
2.1 让医生从“手工整理”转向“流程化处理”
传统方式下,医生常要在PACS、HIS、LIS、EMR之间来回切换。影像要截图,病历要复制,结果要手动摘录,最后还要回填到表格里。这种工作模式最耗时间,也最容易出错。
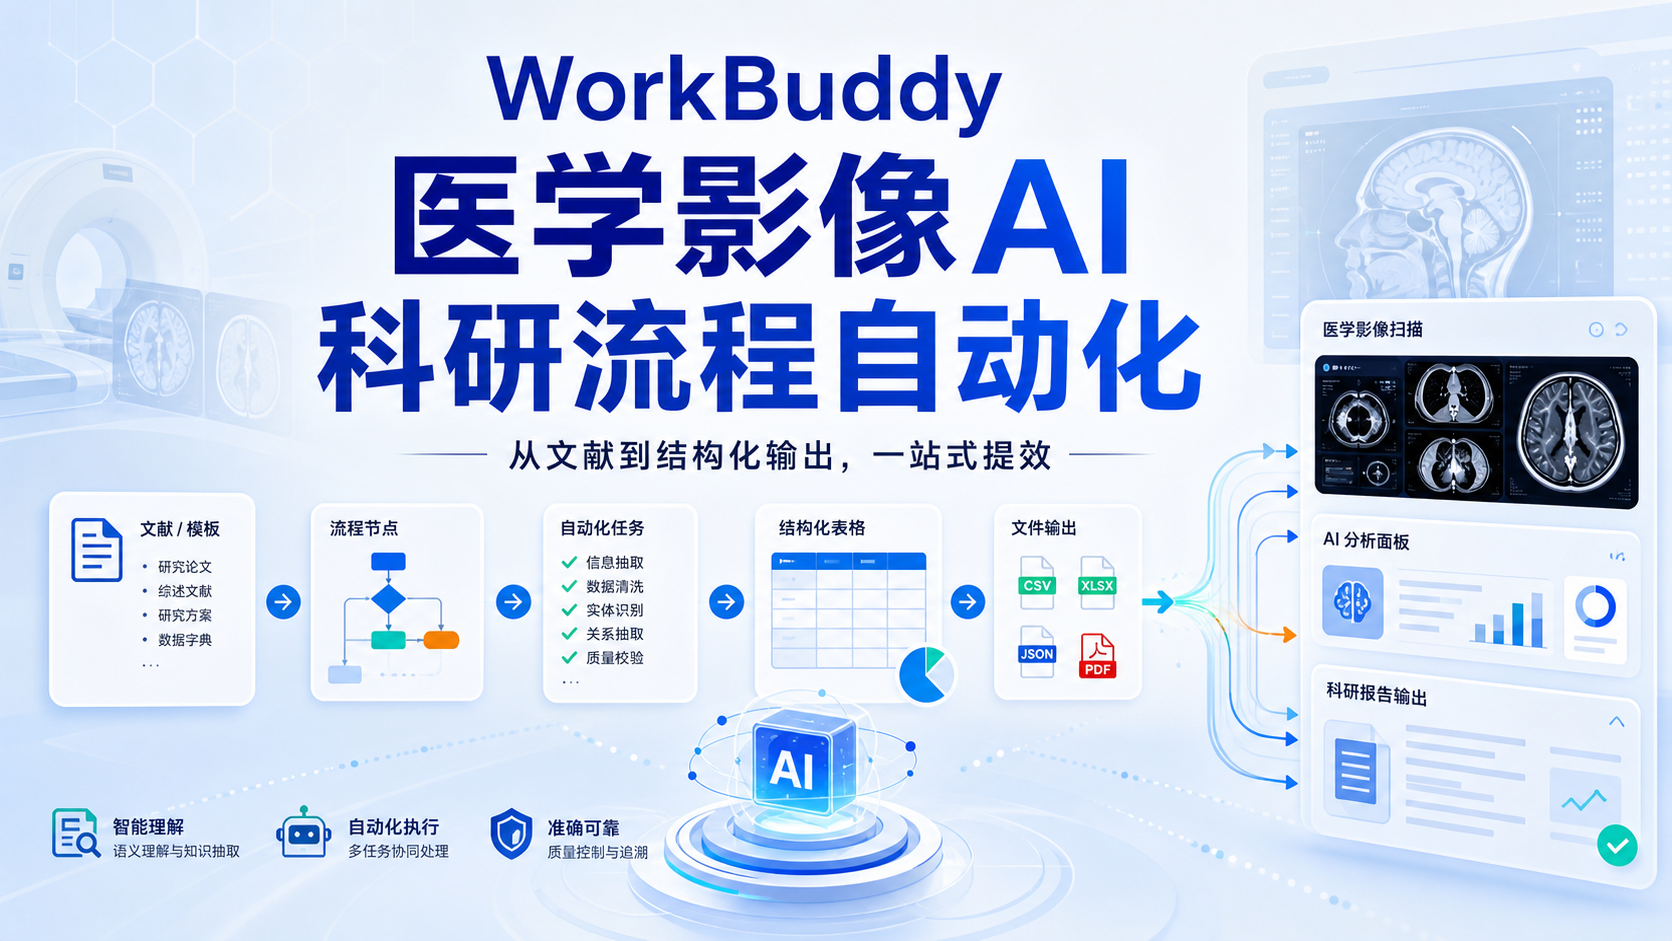
从公开讨论的工作流思路看,WorkBuddy这类工具的价值,在于把重复动作变成可调用流程。对临床人员而言,它更接近一个可配置的工作助手,而不是单一的软件功能。它可以承载的典型任务包括:
- 影像信息归档。
- 病历要点提取。
- 语音转文字后的结构化整理。
- 病例模板化输出。
- 研究字段初步汇总。
对于需要处理大量DICOM病例的人,节省的不是几分钟,而是整个项目周期。
2.2 多模态融合适合哪些研究场景
WorkBuddy这类多模态工作流,尤其适合以下场景:
- 影像组学研究中的病例初筛。
- 术前术后资料整合。
- 多中心回顾性队列整理。
- MDT病例摘要生成。
- 临床科研的病历质控。
这些任务有一个共同点。它们都不要求AI直接下诊断,而是要求AI先把信息整理好。先把DICOM和文本、语音、检验结果统一到同一研究框架,再进入人工审核,是更稳妥的路径。
2.3 医生更需要“可审阅”的AI,而不是黑箱
临床场景最看重可解释性。尤其是科研和教学场景,AI输出不能只给结论,还要能回溯来源。比如:
- 这条摘要来自哪份病历。
- 这个影像描述对应哪一层面。
- 这个标签是否经过人工确认。
如果系统做不到溯源,就不适合直接用于科研数据定稿。WorkBuddy的真正价值,应该体现在让每一步都可检查、可修正、可追踪。 这比“自动生成”更重要。
3. DICOM处理的临床实战流程
3.1 先统一格式,再谈融合
在医学影像处理中,DICOM是最常见的原始格式,但并不总是最适合研究分析。不同软件、不同脚本、不同平台,对DICOM序列的读取方式并不完全一致。实际工作中,通常要先完成格式整理,再进入ROI提取、分割或建模。
可操作的流程通常是:
- 核对病例文件夹是否按患者分组。
- 检查影像序列是否完整。
- 统一导出为研究常用格式。
- 保留原始DICOM作为溯源依据。
- 再进行后续分析。
格式统一是多模态融合的前提,不是可有可无的准备步骤。
3.2 ROI提取仍然需要人工把关
上游知识库强调,感兴趣区ROI可以通过手绘方式提取。这个步骤在临床研究里仍然非常重要。因为自动分割并不总能准确识别边界,尤其是边缘模糊、坏死区明显、伪影较多的病灶。
临床实战里,常见做法是:
- 先由有经验的医生定位病灶。
- 再在合适层面逐层勾画ROI。
- 保存mask文件用于后续分析。
- 必要时进行双人复核。
ROI不是画完就结束,而是研究质量控制的起点。
如果后续要做多模态融合,ROI还需要和文本标签、病理结果、治疗方案一起对应起来。
3.3 多模态数据最好建立统一病例主索引
很多研究失败,不是因为算法差,而是因为病例索引混乱。影像、病历、病理、检验各自有编号,最后却不能一一对应。解决办法是先建立一个统一主索引。
建议至少包含:
- 病例编号。
- 影像检查时间。
- 检查类型。
- 临床诊断。
- 病理结果。
- 随访结局。
- 数据来源系统。
这样做的好处很直接。后续无论是DICOM处理、病例筛选,还是模型训练,都能按同一个编号快速追溯。这一步越规范,后面的多模态融合越可靠。
4. 临床科研中如何把WorkBuddy用得更稳
4.1 把AI放在“整理层”,不要直接放在“决策层”
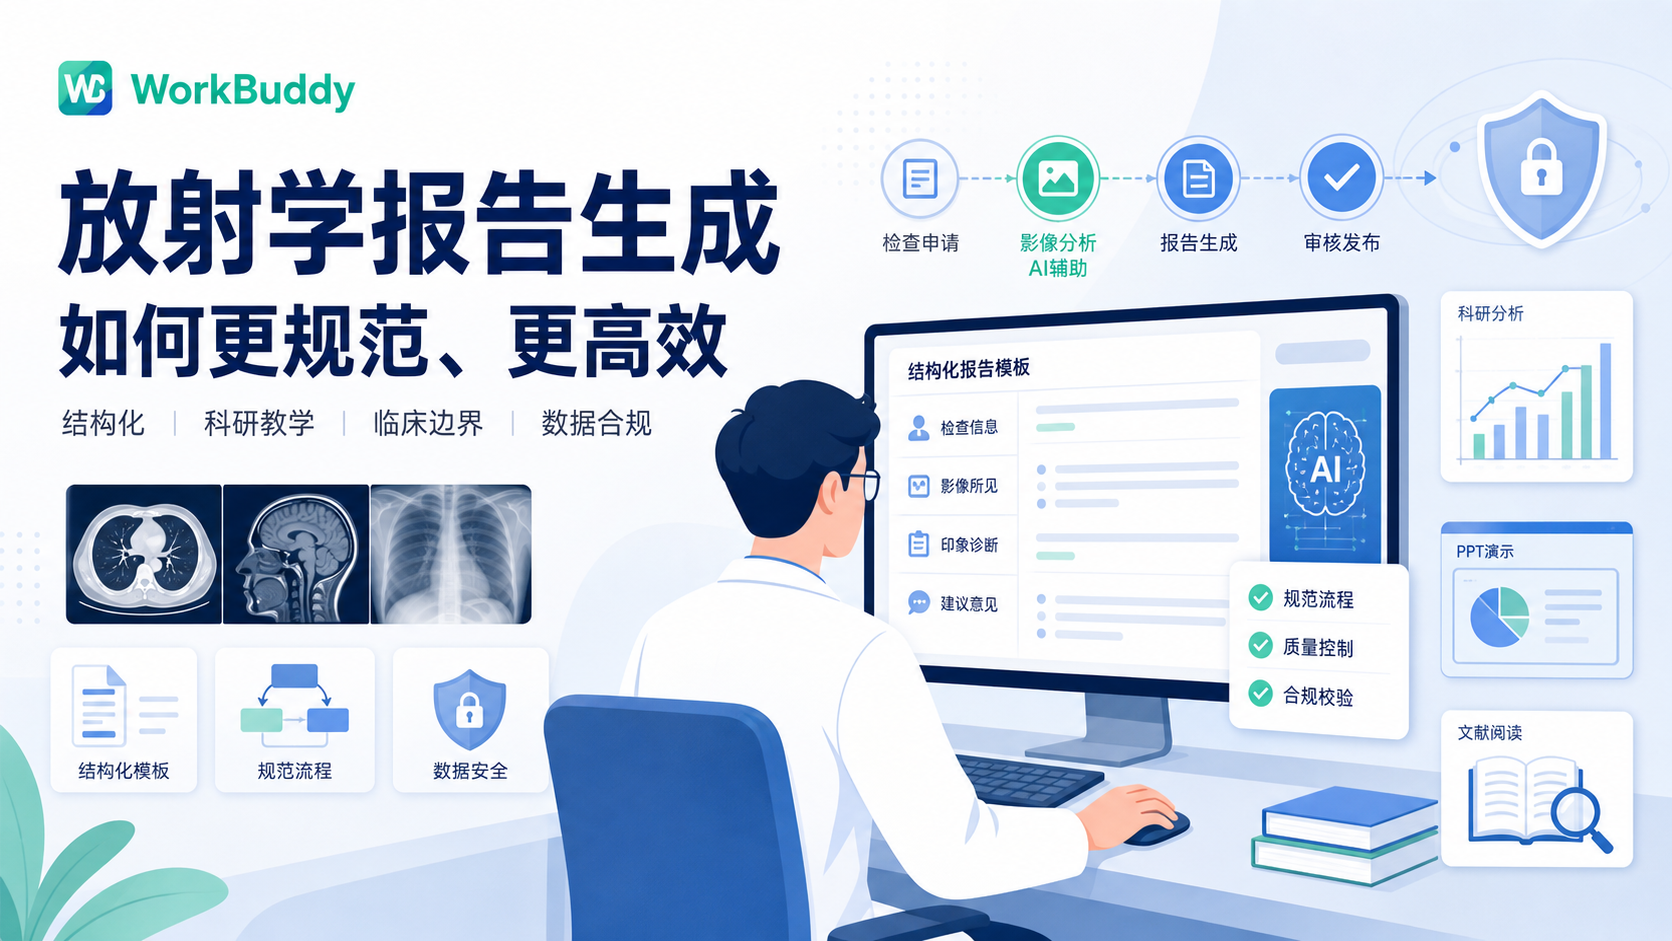
在当前阶段,更稳妥的定位是让WorkBuddy承担资料整理、摘要生成、字段提取和格式化输出。对于诊断、治疗决策、病理判断,仍然应由临床医生负责最终审核。
这意味着它适合做:
- 文本摘要初稿。
- 研究变量整理。
- 语音内容转写归档。
- 病历字段标准化。
- 影像与病历信息初筛。
AI最适合先替代重复劳动,而不是替代临床判断。
这是临床实战里最重要的边界。
4.2 数据安全和合规必须放在第一位
处理DICOM和病历数据时,隐私和合规问题不能回避。无论是本地部署还是云端调用,都要先确认:
- 是否去标识化。
- 是否保留最小必要信息。
- 是否满足机构伦理要求。
- 是否有授权和访问控制。
对于科研人员来说,最常见的错误是只关注效率,不关注数据流转。一旦合规性出问题,再好的工具也无法用于正式研究。
4.3 让输出格式服务于论文和临床工作
真正能提升效率的工具,输出必须贴近使用场景。比如科研人员需要的是表格、病例摘要、变量清单和可导入统计软件的数据。医生需要的是快速回顾、重点提示和可复核结果。
因此,多模态融合的最终目标不是生成一段漂亮文字,而是生成可用结果。理想输出应满足:
- 一页就能看懂病例要点。
- 关键字段可直接入表。
- 每条结论都有来源。
- 允许人工修订后再次保存。
这类输出才真正适合临床和科研场景。
5. 解螺旋式工作流,如何帮助解决真实痛点
5.1 从DICOM到多模态融合,关键是降低手工成本
对大多数团队来说,最耗时的不是模型训练,而是前期整理。DICOM导入、文件归档、病历摘录、病例对齐、ROI标注,这些步骤都很费人力。若没有稳定流程,研究很容易卡在数据准备阶段。
这也是为什么很多临床团队会希望有一个更贴近实战的工作流工具。像解螺旋这样的产品思路,核心就是把影像处理、文本整理和病例管理串起来。
如果能在一个流程里完成DICOM处理与多模态融合,研究效率会明显提升。
5.2 更适合临床人员的,是“可落地”的自动化
临床场景不缺概念,缺的是落地。一个真正好用的工具,应该帮助用户完成:
- 影像文件规范化。
- 病例信息快速归档。
- 多来源资料统一汇总。
- 输出结果可审核、可修正。
- 适配论文、教学和质控场景。
当工具能把这些环节串联起来,医生和科研人员才能把时间重新用回临床判断和学术思考。
总结Conclusion
WorkBuddy多模态融合DICOM处理的价值,不在于替代医生,而在于帮助临床人员把分散的数据变成可用信息。先统一格式,再做ROI和病例对齐,最后完成多模态整理,这是更符合真实科研场景的路径。对于需要高效处理影像、病历和随访信息的团队,解螺旋 这类工具化方案值得关注。它能帮助你减少重复整理时间,把更多精力留给分析、验证和发表。

- 引言Introduction
- 1. 为什么DICOM处理离不开多模态融合
- 2. WorkBuddy在临床场景中的价值
- 3. DICOM处理的临床实战流程
- 4. 临床科研中如何把WorkBuddy用得更稳
- 5. 解螺旋式工作流,如何帮助解决真实痛点
- 总结Conclusion