75
 分享

引言Introduction
临床指南更新快,检索却常常慢。医生、医学生和科研人员最耗时的,不是“找不到”,而是“找得全、找得准、还能复现”。如果没有稳定流程,指南检索很容易漏掉关键词、错过更新版本,甚至影响后续写作和证据总结。
1. 为什么临床指南检索总是低效
1.1 资料来源分散,入口不统一
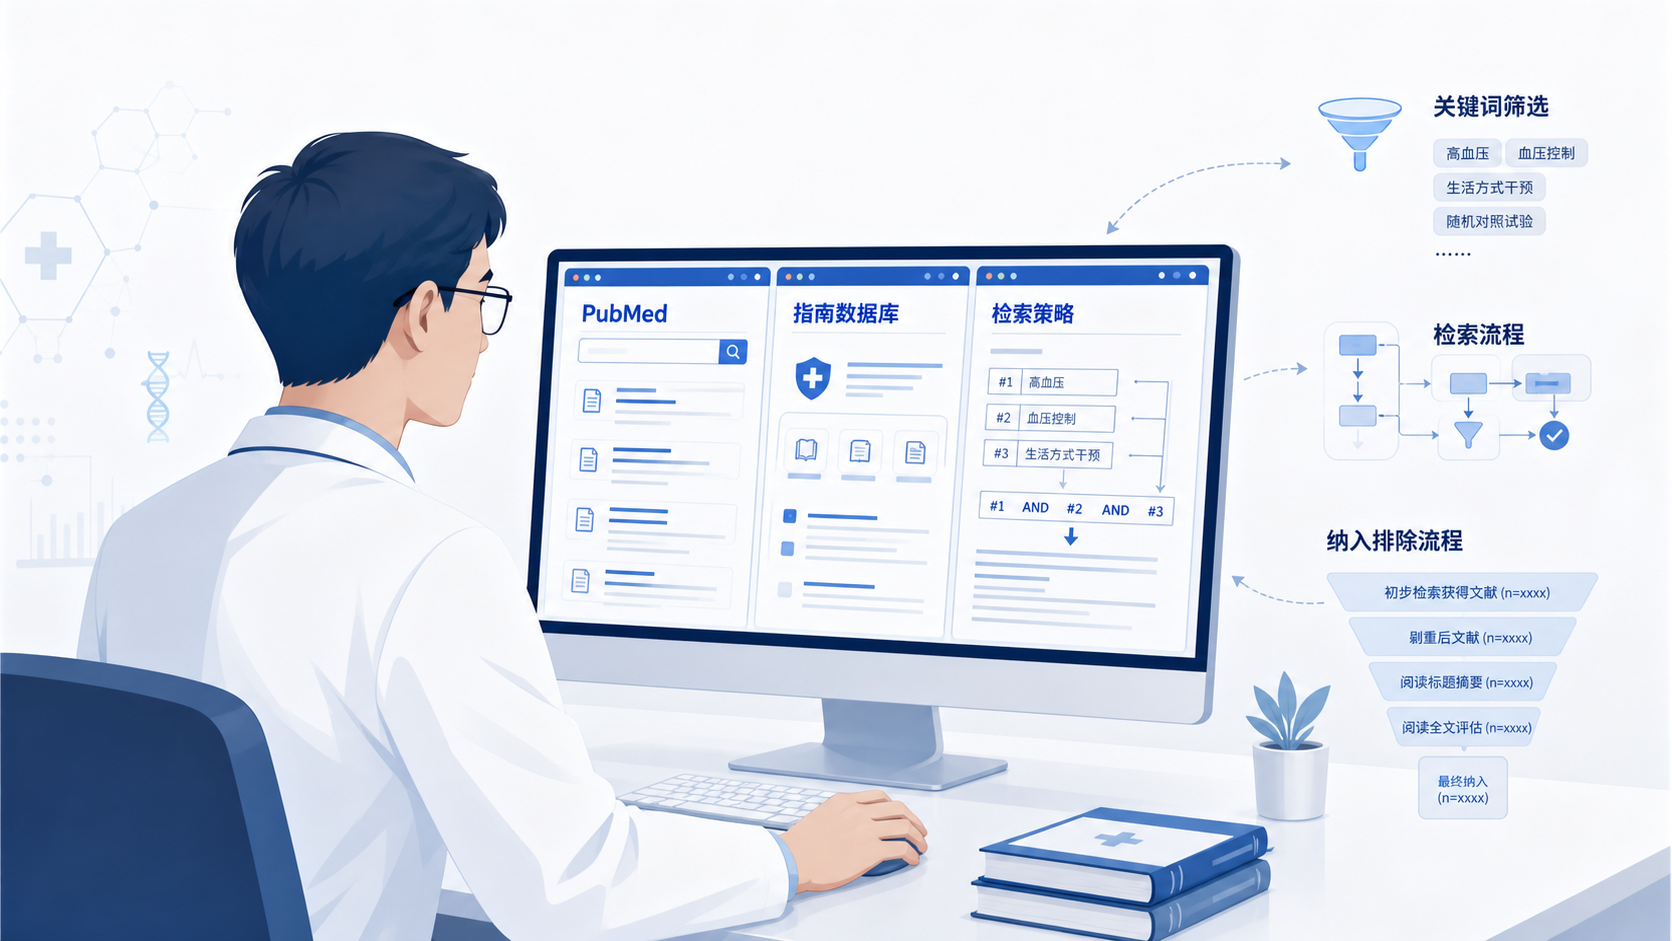
临床指南检索通常不只看一个数据库。常见来源包括 PubMed、Embase、指南官网、学会网站、国家数据库,以及综述文献中的参考文献链。问题在于,每个平台的检索逻辑不同,字段不同,筛选方式也不同。
结果就是,检索者往往在多个页面之间来回切换。
时间浪费在重复输入、反复修正、截图保存和版本比对上。对于临床工作者来说,这种流程很难长期坚持。
1.2 关键词不稳定,检索式难复用
指南检索不是简单搜一个病名。还要处理疾病同义词、缩写、干预措施、结局指标和人群限制。比如同一个主题,可能同时存在自由词、主题词、缩写词和不同指南写法。
如果没有标准化模板,检索式很容易写散。
今天能用,明天换人就接不上。科研协作中,这会直接影响可复现性。
1.3 人工筛选成本高,且容易漏检
临床指南的标题往往简洁,但核心信息未必完全体现在标题里。只看标题筛选,容易漏掉更新版、共识版、循证建议和补充文件。只看全文筛选,又会被无关信息拖慢。
检索效率低,不只是慢,更是会影响证据质量。
这也是 WorkBuddy 这类工具有价值的原因。它的重点不是替代判断,而是把重复劳动压缩到最少。
2. WorkBuddy如何重构临床指南检索流程
2.1 用Skill把检索动作标准化
WorkBuddy 的核心优势,在于可以围绕固定任务建立 Skill。对临床指南检索来说,Skill 相当于一个可复用的工作模板。你可以把本领域常见指南、纳排标准、关键词来源和字段要求交给它。
一旦模板成型,检索流程就从“人工临时拼接”变成“按规则执行”。
这对高频做文献检索的人尤其重要。
举个实用思路。先把一个主题拆成四类信息:
- 疾病名称及同义词。
- 干预或管理策略。
- 指南、共识、推荐、实践参数等文献类型。
- 时间和语言限制。
这样做的好处是,检索目标更明确,后续的筛选也更快。
2.2 用案例训练,比空泛描述更有效
根据上游知识库,实践中更适合把“原始病历资料”“几个检索案例”和“必须包含的字段”一起输入,让工具学习模式。临床指南检索也是同样逻辑。
与其只说“帮我找指南”,不如明确告诉它:
- 需要哪些数据库。
- 哪些术语必须保留。
- 哪些字段必须出现。
- 是否排除病例报告、原始研究或动物实验。
- 是否只保留最新版本。
这样生成的检索式,才更接近实际工作需求。
2.3 保持登录状态和工作连续性
知识库中提到,使用相关 Skill 时需要保持浏览器登录状态。这一点对临床指南检索也很关键。很多数据库或工作流工具都依赖会话状态。中途退出、切页或刷新过多,都可能打断流程。
连续性是效率的一部分。
真正节省时间的,不只是“生成一次检索式”,而是后续可以持续修改、复用和审校。
3. 临床指南检索的标准化步骤
3.1 先定义问题,再定义检索边界
临床指南检索不能先搜再说。正确顺序应该是先明确临床问题,再设定边界。最常用的是围绕 PICO 或类似框架展开。
可先写清楚:
- 人群,疾病分期、年龄、特殊人群。
- 干预,药物、操作、护理或随访策略。
- 对照,安慰剂、常规治疗、其他方案。
- 结局,死亡率、再入院率、并发症、生活质量等。
边界越清楚,后面的检索越稳定。
这一步决定了查全率和查准率的平衡。
3.2 从主题词、自由词和指南类型词三层入手
根据知识库中的课程思路,检索词来源通常有三种:
- 主题词。
- 自由词。
- 相似文献或相关文章中的关键词。
临床指南检索同样适用。建议优先建立三层词库:
- 疾病层词库。
- 指南类型词库,如 guideline、consensus、recommendation、practice guideline。
- 场景限制词库,如 diagnosis、screening、management、treatment。
这样可以显著减少漏检。
尤其在不同数据库之间切换时,这种结构化词库很有帮助。
3.3 用检索历史和版本管理保证可复现
PubMed 的检索历史在课程中被反复强调,原因很简单。它能复现每一步操作。临床指南检索也应当保留同样的思路。
建议固定记录:
- 检索日期。
- 数据库名称。
- 完整检索式。
- 限制条件。
- 纳入排除理由。
- 最终命中文献数。
可复现,是科研与临床证据工作的底线。
如果以后需要更新指南、补充证据或接受审稿,这份记录会非常重要。
4. WorkBuddy在真实场景中的提效点
4.1 减少重复输入
在传统流程里,很多时间消耗在反复复制、粘贴、改写和比对检索式。WorkBuddy 如果能根据设定 Skill 自动生成模板,就能直接减少这部分机械劳动。
对高频检索者来说,节省的不是几分钟,而是整段工作流。
尤其在多主题并行时,这种提升会更明显。
4.2 让初学者更快进入标准流程
医学生和刚入科研的人,最常见的问题不是不会搜,而是不知道怎么搜得规范。WorkBuddy 的价值,在于把复杂任务拆成更容易执行的步骤。
你可以先让它完成:
- 关键词初筛。
- 同义词扩展。
- 题录整理。
- 检索式草案生成。
然后再由人来判断是否保留、合并或删减。
人负责判断,AI负责加速。
这才是更稳妥的协作方式。
4.3 便于团队统一标准
指南检索常常不是一个人完成,而是研究组、课题组、临床团队一起做。不同人写出的检索式,风格差异很大。
如果用 WorkBuddy 固化模板,就更容易统一标准:
- 同一套字段要求。
- 同一套版本规则。
- 同一套筛选逻辑。
- 同一套导出格式。
团队协作越规范,后续修订成本越低。
5. 使用时要注意的边界
5.1 AI生成结果只能作为草案
无论是 WorkBuddy 还是其他工具,生成内容都应该先审校。尤其是临床指南检索,纳排标准和字段限制如果写错,结果会明显偏离目标。
不要把模型输出直接当最终检索式。
至少要做三步检查:
- 是否包含核心疾病概念。
- 是否遗漏指南类型词。
- 是否误排除关键年份或关键语种。
5.2 纳排标准要符合临床原则
知识库明确提到,workflows 和纳排标准具有主观性,但不能出现明显临床原则性错误。这个原则非常重要。
例如:
- 不应把所有观察性证据一概排除。
- 不应把最新指南因为标题略有差异就漏掉。
- 不应因字段设置过窄导致查全率严重下降。
标准化不是机械化。
最终仍要由专业人员把关。
5.3 数据库差异要单独处理
不同数据库对主题词、字段、过滤器的支持不同。PubMed 适合主题词和自由词组合,其他平台可能更适合高级筛选和指南类型过滤。
同一套思路可以复用,但不能机械复制。
每个平台都要做一次本地化校正。
6. 结论与行动建议
临床指南检索真正的难点,不是“有没有工具”,而是“能不能形成稳定、可复现、可复用的流程”。从问题定义、词库构建、检索式生成,到历史记录和版本管理,标准化流程能明显降低人工成本。
如果你经常做指南检索,建议把重复性工作交给工具,把专业判断留给自己。
WorkBuddy 的意义就在这里。它可以帮助你把检索模板、字段要求和工作流程沉淀下来,减少低价值重复劳动,让你更快得到可审校、可复现的结果。想把临床指南检索做得更稳、更快,可以进一步了解解螺旋的相关工具与工作流方案。

- 引言Introduction
- 1. 为什么临床指南检索总是低效
- 2. WorkBuddy如何重构临床指南检索流程
- 3. 临床指南检索的标准化步骤
- 4. WorkBuddy在真实场景中的提效点
- 5. 使用时要注意的边界
- 6. 结论与行动建议