60
 分享
引言Introduction
差异表达分析最怕什么。不是样本少,也不是结果不显著,而是流程不统一,代码每次重写,参数每次变动,最后难以复现。对医学生、医生和科研人员来说,这会直接影响课题推进、结果审核和论文投稿。当分析链条不能标准化,数据再好也可能被流程拖累。
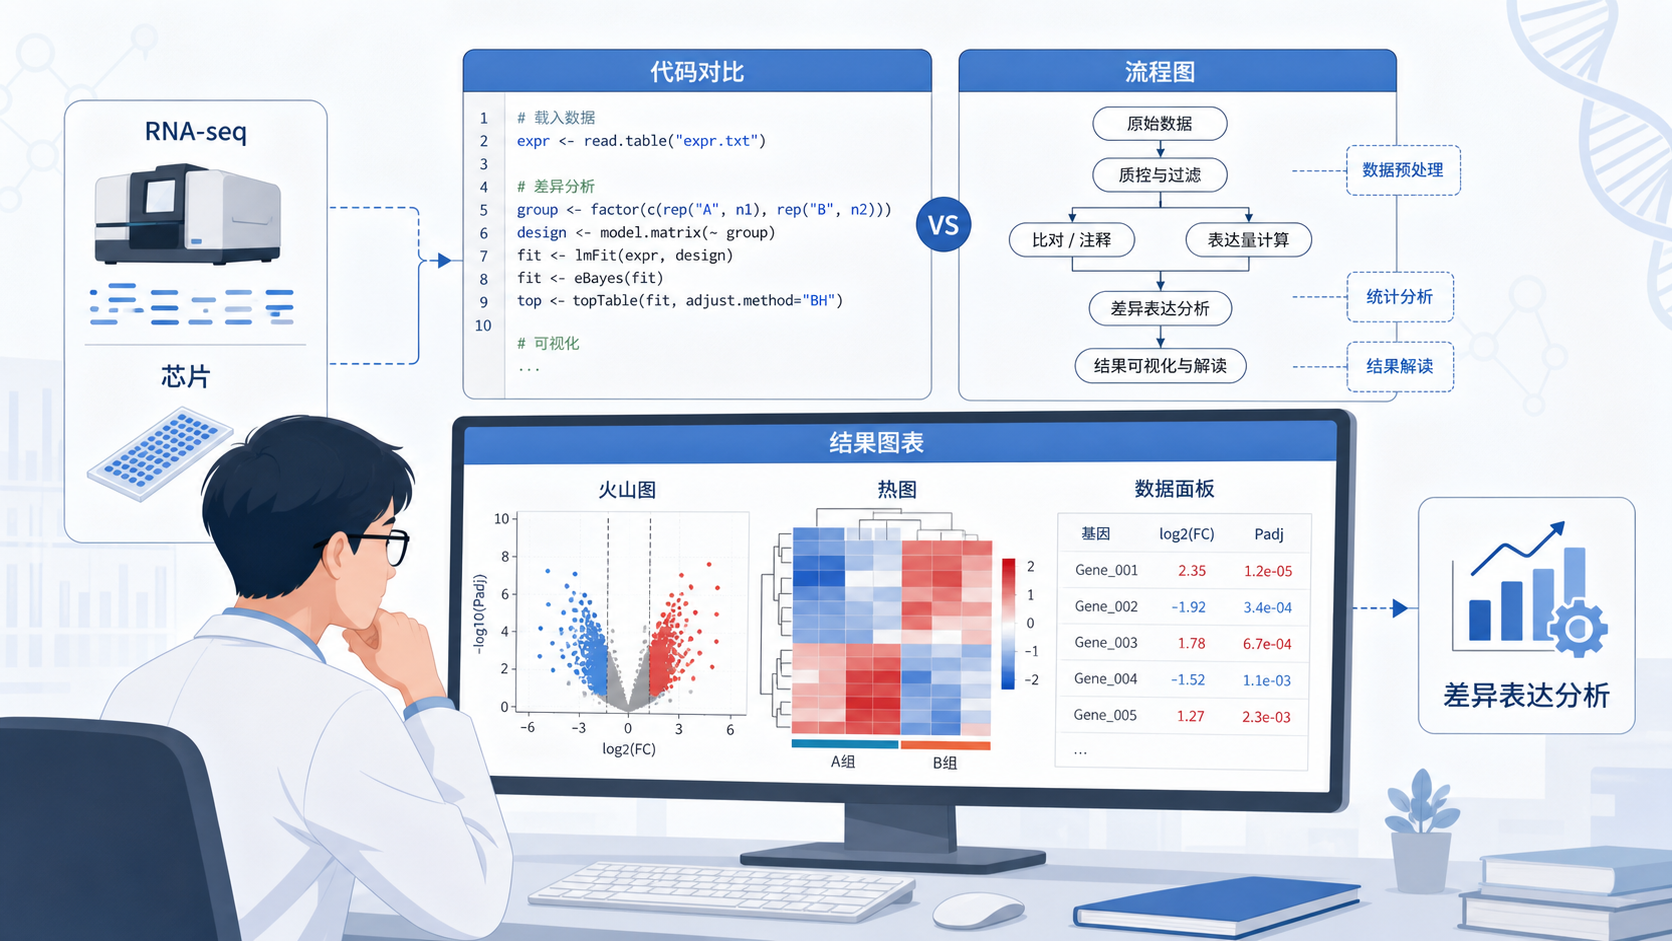
1. 差异表达分析为什么总被“手动代码”拖慢
1.1 手写代码的核心问题,不是慢,而是不稳定
差异表达分析常见流程包括数据导入、质控、标准化、分组确认、建模、统计检验和结果导出。任何一步手工改动,都可能让结果偏移。尤其在数据量较大时,参数一旦写错,后续火山图、热图和富集分析都会跟着出问题。
问题不只是效率低,而是可重复性差。
同一批数据,不同时间运行,若代码版本、包版本或参数设置不同,结果可能不一致。对临床科研来说,这种不一致会放大解释风险。
1.2 差异表达分析真正需要的是标准流程
从方法学上看,差异表达分析不是“会跑代码”就够了,而是要保证输入、过滤、建模和校正逻辑一致。比如两组独立样本分析,通常要先判断数据分布,再决定使用参数检验还是非参数检验。RNA-seq场景中,又要考虑归一化、离散度估计和多重检验校正。
标准化流程的价值在于把“经验操作”变成“固定步骤”。
这样做有三个好处。
- 结果更可复现。
- 审稿人更容易接受。
- 团队协作成本更低。
2. workbuddy如何把差异表达分析变成可复用流程
2.1 从“现写代码”转向“调用固定工具”
根据上游知识库中的方法思路,差异分析最稳妥的方向,不是让模型每次重新生成一段新代码,而是让它调用成熟、固定、可验证的工具链。原因很简单。数据是固定的,分析流程也应该尽量固定。对懂代码的人,可以审核和修正;对不懂代码的人,现写代码就存在不可控风险。
workbuddy的意义,正在于把分析任务标准化。
它更接近“流程编排”,而不是“临时写脚本”。这对差异表达分析尤其重要,因为分析步骤本身高度重复。
2.2 标准化流程应至少包含哪些环节
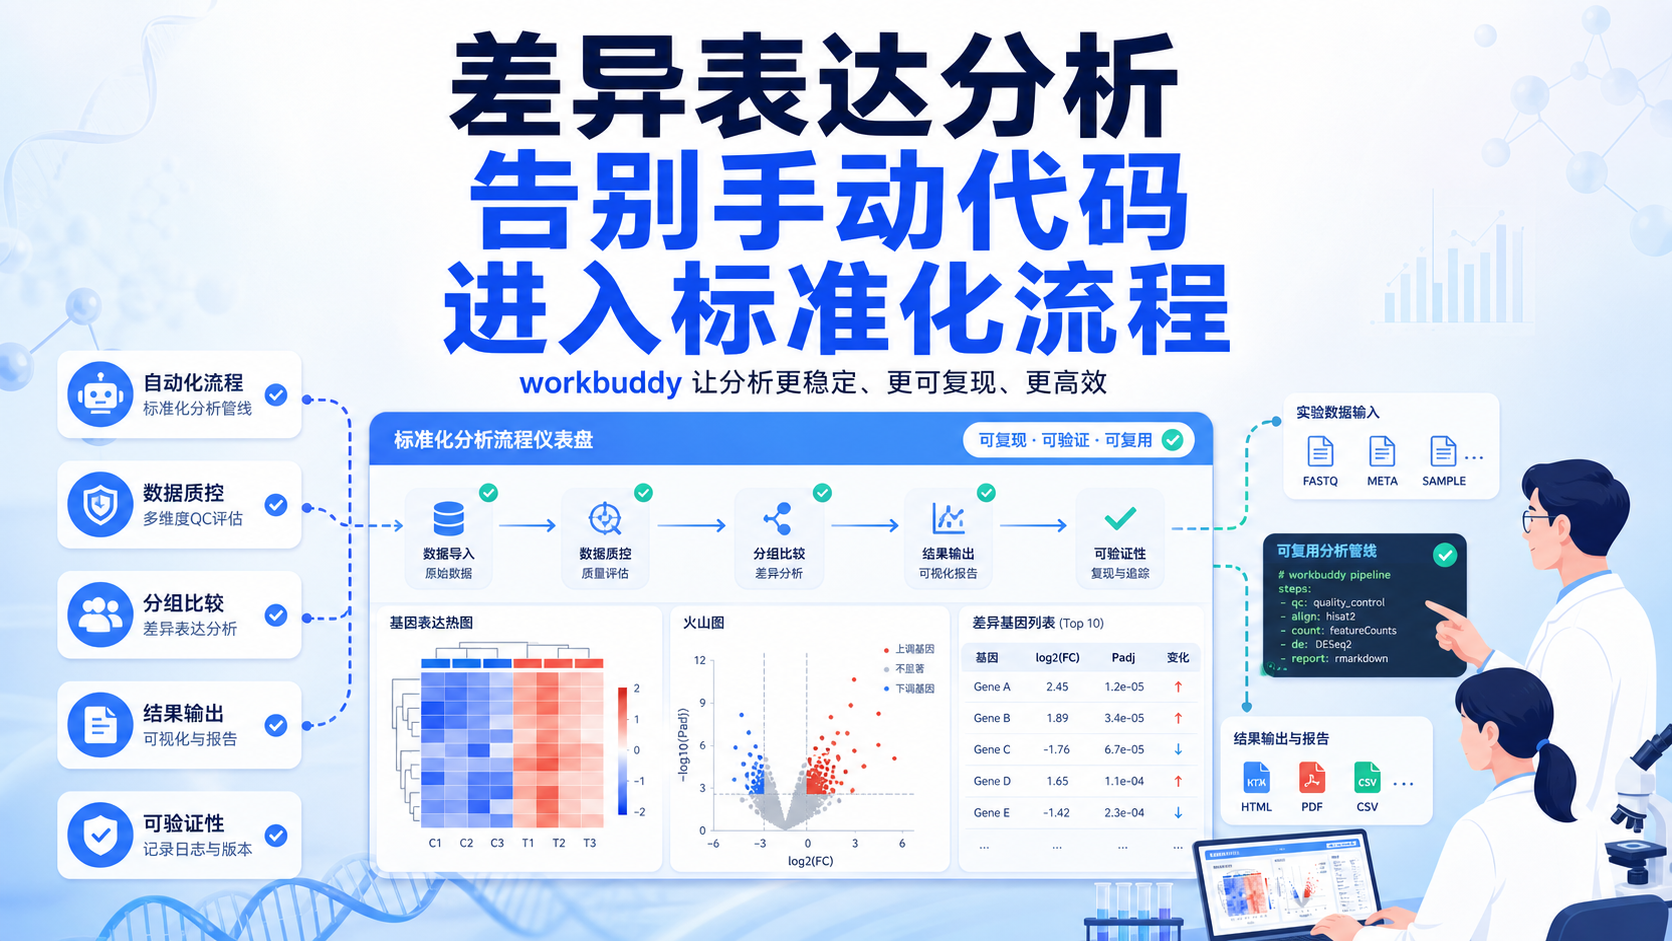
一个合格的差异表达分析流程,至少要覆盖以下步骤。
- 数据导入和样本信息整理。
- 质量控制,识别离群样本。
- 标准化处理,减少技术偏差。
- 分组检查,确保表达矩阵与metadata一致。
- 构建设计矩阵,明确比较关系。
- 线性建模或统计检验。
- 多重检验校正,输出差异基因表。
- 可视化和结果归档。
如果这些步骤能被固定下来,分析就从“个人经验活”变成“团队标准流程”。
这也是 workbuddy 这类工具最有价值的地方。
2.3 为什么“可验证”比“会生成”更重要
上游内容反复强调一点,代码如果不是固定流程,就算能生成,也可能因为每次输出不一样而带来结果波动。差异表达分析不同于纯文本生成,它最终要落到统计结果和生物学解释上,必须能检查。
对科研工作流来说,至少要满足三点。
- 输入可追溯。
- 中间步骤可检查。
- 结果可复核。
只有可验证的流程,才适合用于正式科研分析。
这也是 workbuddy 适合嵌入差异表达分析场景的原因。
3. 标准化差异表达分析应如何落地
3.1 先把数据质量关住
在差异表达分析前,先做质控很关键。无论是芯片数据还是测序数据,都可能存在离群样本、批次效应和低质量信号。上游知识库中提到,样本数不多时,离群点的影响会被放大,因此质控不能省略。
实践中建议优先检查以下内容。
- 样本间聚类关系。
- PCA或PC图分布。
- boxplot是否一致。
- 检测值或低表达过滤。
- 分组标签是否与表达矩阵列名一致。
样本分组一旦错位,后面的差异结果就没有意义。
3.2 再把比较关系固定下来
差异表达分析最常见的错误之一,是分组设计不规范。比如两组比较时,design matrix或分组变量顺序不一致,就会导致比较方向错误。论文里经常看到“control vs disease”,但真正跑模型时,如果对比方向写反,解释也会反。
因此,标准流程应明确记录。
- 哪一组是参考组。
- 哪一组是比较组。
- 是否配对。
- 是否存在批次因素。
- 是否需要协变量校正。
对临床研究来说,比较关系必须先定义,再建模。
不是先跑结果,再回头解释。
3.3 最后统一输出结果和图表
差异表达分析的结果,不能只停留在一张表。通常还需要配套输出:
- 火山图。
- 热图。
- PCA图。
- 差异基因列表。
- 富集分析输入文件。
如果这些图表都由同一流程自动生成,研究效率会明显提升。更重要的是,图和表来自同一套参数,结论更一致。
统一输出的本质,是让分析、作图和汇报同步化。
这对课题组内部讨论和论文补充材料都很重要。
4. 对医学生、医生和科研人员,workbuddy的价值在哪里
4.1 对初学者,降低差异表达分析门槛
很多医学生和临床医生并不缺研究问题,缺的是标准化分析路径。手工写代码往往会卡在包加载、函数参数、对象格式转换和图形输出这些细节上。workbuddy如果能把这些步骤封装成固定流程,就能显著降低上手难度。
这意味着更多人可以把精力放在研究设计和结果解释上,而不是反复调代码。
4.2 对有经验的研究者,提升复现和协作效率
对科研人员来说,最耗时间的不是第一次分析,而是重复分析。换数据集、换队列、换分组、换平台后,流程几乎要重新走一遍。如果有标准化工具,就可以直接复用配置。
上游知识库里提到,客户端换一个时,只需要拷贝配置文件。这个思路非常适合科研场景。分析逻辑沉淀为配置,研究就从“人盯人”转向“流程驱动”。
4.3 对发表和答辩,减少方法学争议
论文审稿和答辩中,方法部分经常被追问。比如:
- 为什么用这个标准化方法。
- 为什么过滤这个阈值。
- 为什么选这个对比。
- 为什么不用另一种统计检验。
如果流程本身标准化,回答会更清楚。因为每一步都有固定逻辑,也更容易补充说明。
方法透明,结论才更可信。
5. 未来的差异表达分析,会越来越像“标准化流水线”
5.1 从人工编排到自动化分析是趋势
上游知识库提到,未来差异分析可能会大幅实现自动化。这不是夸张判断,而是生信和临床数据分析的自然演进方向。随着工具链成熟,研究者不需要每次从头写脚本,而是通过流程化工具完成固定任务。
对差异表达分析来说,这种变化尤其明显。因为它的核心步骤成熟、重复度高、适合封装。越标准,越容易自动化。
5.2 workbuddy更适合做什么
如果把差异表达分析看作一条生产线,workbuddy更像是流程管理层。它的价值不在于“替代专业判断”,而在于把固定环节交给可靠工具,把复杂判断留给研究者。
它适合处理的痛点很明确。
- 减少重复写代码。
- 固化常用分析步骤。
- 提高结果一致性。
- 降低协作和交接成本。
对临床科研团队来说,这种效率提升会直接转化为项目推进速度。
5.3 用解螺旋,解决流程碎片化的问题
如果你现在做差异表达分析,还在反复切换脚本、手动改参数、靠经验拼接流程,那么最需要的不是更多零散工具,而是一套能串起数据处理、建模、统计和出图的标准化方案。解螺旋可以帮助你把这些碎片化步骤整合到更清晰的工作流中,让差异表达分析更稳定、更可复现,也更适合团队协作。
总结Conclusion
差异表达分析的关键,不只是得到一组差异基因,而是让整个过程可控、可复现、可审查。手动代码适合探索,不适合长期标准化生产。workbuddy的价值,在于把差异表达分析从临时写脚本,推进到固定流程化分析。
如果你希望减少重复劳动,提高结果一致性,并让课题推进更高效,可以进一步了解并使用解螺旋 ,把你的差异表达分析流程真正标准化。
- 引言Introduction
- 1. 差异表达分析为什么总被“手动代码”拖慢
- 2. workbuddy如何把差异表达分析变成可复用流程
- 3. 标准化差异表达分析应如何落地
- 4. 对医学生、医生和科研人员,workbuddy的价值在哪里
- 5. 未来的差异表达分析,会越来越像“标准化流水线”
- 总结Conclusion