100
 分享
引言Introduction
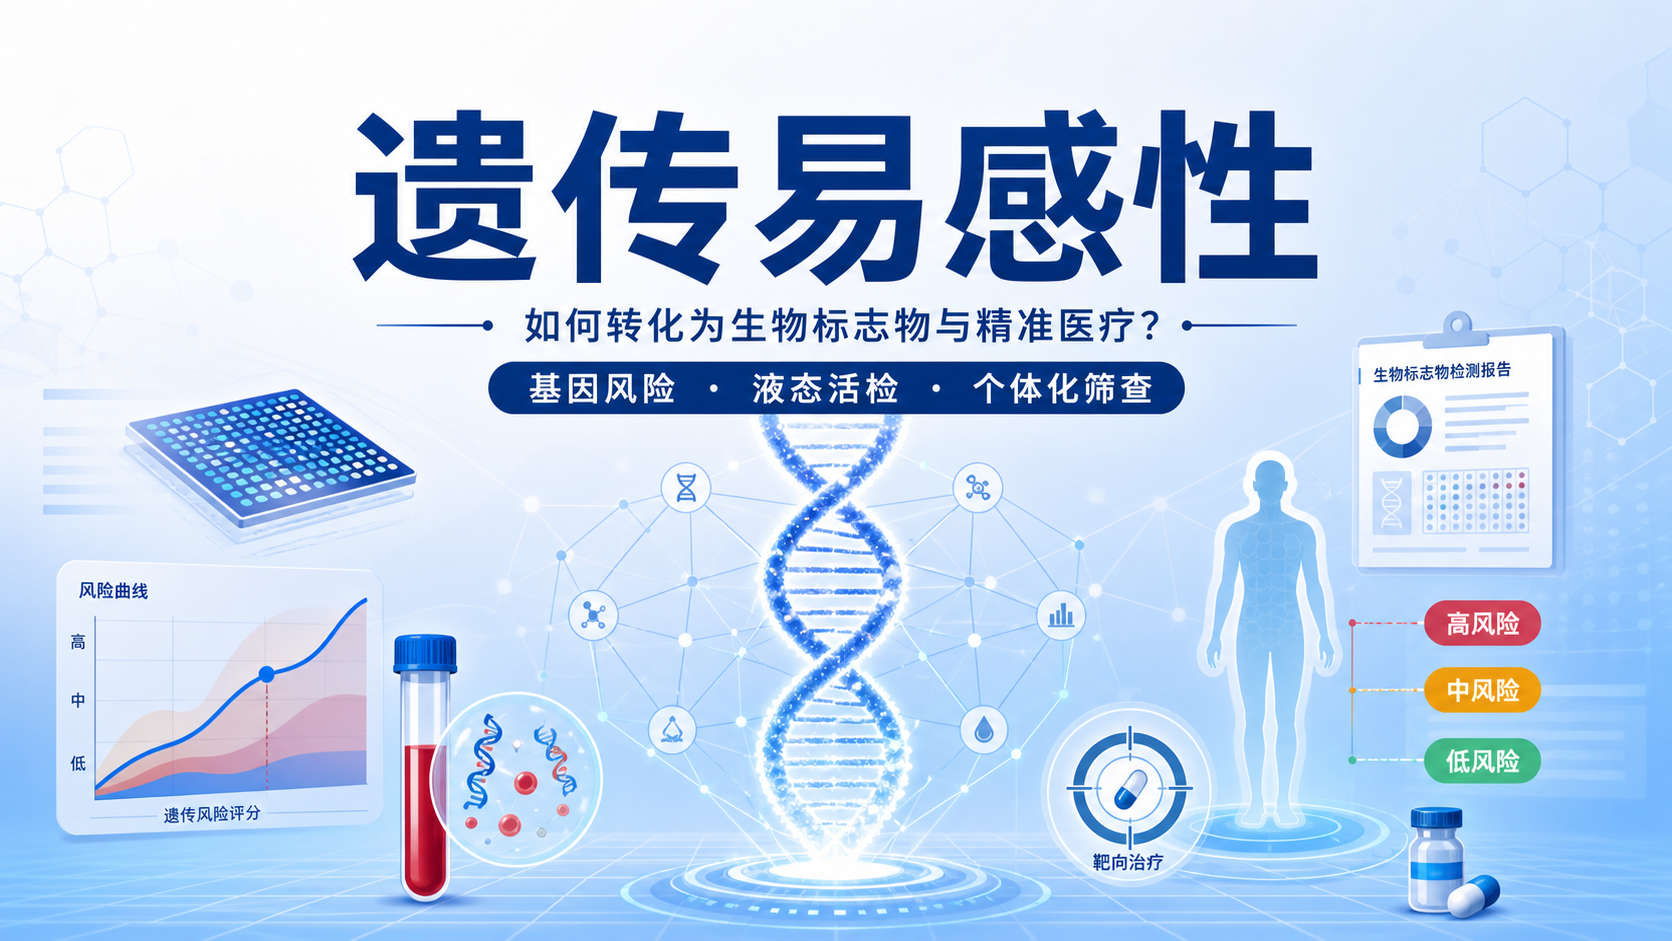
遗传易感性不是“会不会发病”的简单判断,而是“在什么条件下更容易发病”的风险画像。 对医学生、医生和科研人员来说,真正的难点不在于发现风险,而在于把风险转化为可检测、可干预、可分层的临床决策。遗传易感性正是连接基因信息与精准医疗的重要入口。
1. 遗传易感性的核心概念
1.1 什么是遗传易感性
遗传易感性,指个体因遗传背景不同,在相同环境暴露下表现出不同发病概率的现象。它不是单一基因决定的“命运论”,而是遗传因素、环境因素和生活方式共同作用的结果 。
在复杂疾病中,这种差异尤其明显。比如肿瘤、糖尿病、冠心病、自身免疫病,都常见家族聚集现象,但并不符合单基因遗传病那种明确的孟德尔模式。也就是说,遗传易感性更适合用来解释“高风险人群”,而不是直接给出“必然患病”的结论。
1.2 为什么它重要
遗传易感性的价值,在于把“疾病已经发生”前移到“疾病尚未发生之前”。这对临床和科研都有直接意义。
它可以帮助我们做三件事。
- 识别高风险人群。
- 提前干预环境因素。
- 优化筛查和随访策略。
对于医生而言,这意味着更早的预警。对于科研人员而言,这意味着可以从风险位点、表达特征和分子通路中寻找新型生物标志物。
2. 遗传易感性如何转化为生物标志物
2.1 从基因变异到风险信号
遗传易感性并不等于“某个基因异常”这么简单。更常见的是一组微小效应的累积。包括单核苷酸多态性,拷贝数变异,结构变异,以及调控区变异等。这些改变本身未必致病,但会影响基因表达、蛋白功能或细胞稳态。
当这些变异在统计学上与疾病发生显著相关时,就可能成为生物标志物。 这类标志物的价值在于可用于风险评估、分层诊疗和预后预测。
在肿瘤研究中,研究者常通过病例对照队列、GWAS、转录组和多组学整合,筛出与疾病相关的候选位点,再进一步验证其与临床分期、治疗反应和生存结局的关系。这个过程的关键,不只是“找到差异”,而是证明差异具备稳定性和可重复性。
2.2 液态活检让易感性研究更接近临床
近年,cfDNA、ctDNA、CTC等液态活检标志物迅速发展,让遗传信息的临床转化更快一步。以ctDNA为例,它反映的是肿瘤细胞释放到外周血中的DNA信息,能提供突变、拷贝数变异和结构异常等线索。虽然它主要用于肿瘤监测,但其背后的逻辑与遗传易感性高度一致,都是通过可检测分子识别高风险状态。
对于临床工作来说,这类标志物的意义在于动态监测。
比如:
- 评估疗效变化。
- 监测复发风险。
- 辅助判断是否需要加强治疗。
对于科研来说,这类分子标志物也更容易形成从机制到临床的闭环。因为它们既能做发现,也能做验证。
3. 遗传易感性在精准医疗中的应用
3.1 风险分层与个体化筛查
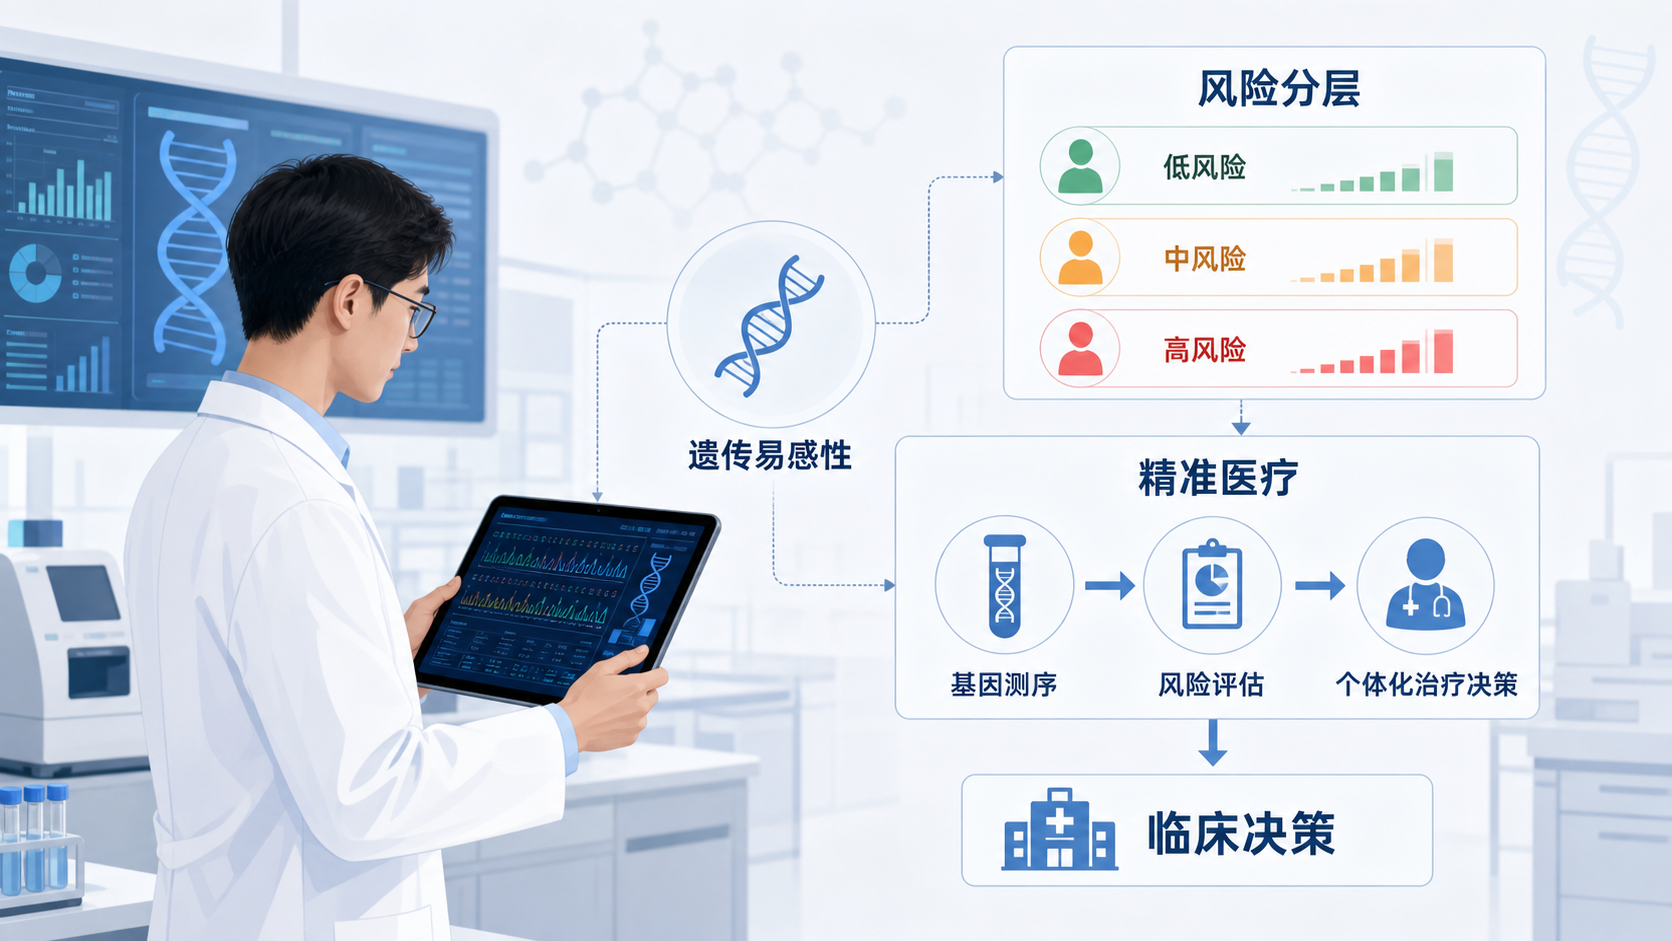
精准医疗的核心,不是“给所有人同样的方案”,而是“根据不同风险给出不同策略”。遗传易感性正是风险分层的重要依据。
在临床实践中,常见的应用路径包括:
- 家族史提示高风险时,提前启动筛查。
- 遗传检测提示高危时,缩短随访间隔。
- 多基因风险评分较高时,联合环境因素进行综合管理。
这类策略尤其适合慢病、肿瘤和遗传背景复杂的疾病。其真正优势在于把资源集中到最需要的人群。 这不仅提高筛查效率,也降低漏诊风险。
3.2 指导治疗选择和预后判断
遗传易感性不仅用于“发病前”,也可用于“发病后”。某些遗传背景会影响药物代谢、药效反应和毒副作用风险。对肿瘤患者而言,基因变异还可能决定靶向药物是否有效,是否容易耐药,是否适合联合治疗。
在这个层面上,遗传易感性已经不只是风险概念,而是治疗决策的一部分。如果能把易感位点、表达签名和临床结局连接起来,就可能形成真正可用的精准医疗工具。
例如,基因签名可以作为分型依据,帮助判断患者属于高危亚型还是低危亚型。再结合生存分析、治疗反应和免疫微环境数据,就能构建更实用的预测模型。这样的研究框架在转化医学中非常常见,也更容易产出高质量结果。
4. 研究遗传易感性的关键方法
4.1 不是只看一个基因,而是看系统
复杂疾病的遗传易感性,往往不能靠单个基因解释。更可靠的方法是多层次分析。
常见研究路径包括:
- 候选基因分析。
- 全基因组关联研究。
- 转录组与差异表达分析。
- 多组学整合。
- 机器学习建模与验证。
其中,多组学整合和独立队列验证是提升可信度的关键。 只有发现、验证、再外推,结果才更接近临床可用。
4.2 评价一个易感性标志物是否可靠
科研中最容易出现的问题,是“统计显著”不等于“临床有用”。一个真正有价值的遗传易感性标志物,应至少满足以下条件:
- 具有明确的生物学基础。
- 在独立队列中可重复。
- 与临床终点相关。
- 具备较好的敏感性和特异性。
- 能解释或预测干预结果。
如果一个标志物只能在单一数据库里成立,却无法在真实样本中复现,它的转化价值就很有限。 这也是E-E-A-T原则在医学内容中的核心要求,证据链必须完整。
4.3 从科研到论文的常见路径
对医学生和青年科研人员来说,遗传易感性研究也有较强的发表潜力。常见思路是把公共数据库、临床样本和功能验证结合起来,完成一个相对完整的故事线。
典型流程是:
- 用公共数据发现候选位点或基因签名。
- 在临床队列中验证与疾病分层、预后或治疗反应的关系。
- 结合通路富集、免疫浸润或细胞通讯分析解释机制。
- 必要时补充实验验证。
这样的设计既符合当前生物医学研究趋势,也更容易形成清晰主线。
5. 遗传易感性研究的现实挑战与未来方向
5.1 目前最大的难点
遗传易感性研究最大的难点,不是数据少,而是数据“复杂但分散”。不同队列、不同平台、不同人群背景,都会影响结论稳定性。再加上疾病本身受环境、年龄、性别和共病影响,单一模型往往难以覆盖所有场景。
另一个难点是临床转化慢。很多结果停留在相关性层面,缺少机制验证和真实世界应用评估。因此,未来研究必须更重视可重复性、分层分析和临床终点。
5.2 未来更有前景的方向
从趋势看,遗传易感性研究会越来越依赖以下几个方向:
- 多组学联合分析。
- 单细胞和空间组学。
- 液态活检。
- 机器学习和风险预测模型。
- 基于人群的长期随访数据。
这些方向的共同特点是,能够把静态风险变成动态管理。也就是说,不只是知道“谁更容易生病”,而是知道“何时更容易、如何更早干预、怎样更精准治疗”。
这也是遗传易感性真正进入精准医疗的标志。
总结Conclusion
遗传易感性不是抽象概念,而是连接基因、环境和临床结局的关键桥梁。它既可以作为疾病风险评估的基础,也可以发展为生物标志物,进一步服务于筛查、分层、治疗和预后判断。对医学生、医生和科研人员来说,真正有价值的不是停留在“发现差异”,而是把差异变成可验证、可解释、可应用的精准医疗工具。
如果你正在做遗传易感性相关研究,想把公共数据、临床验证和机制分析系统串联起来,解螺旋 可以帮助你更高效地完成从选题到成果转化的闭环。
- 引言Introduction
- 1. 遗传易感性的核心概念
- 2. 遗传易感性如何转化为生物标志物
- 3. 遗传易感性在精准医疗中的应用
- 4. 研究遗传易感性的关键方法
- 5. 遗传易感性研究的现实挑战与未来方向
- 总结Conclusion