61
 分享
引言Introduction
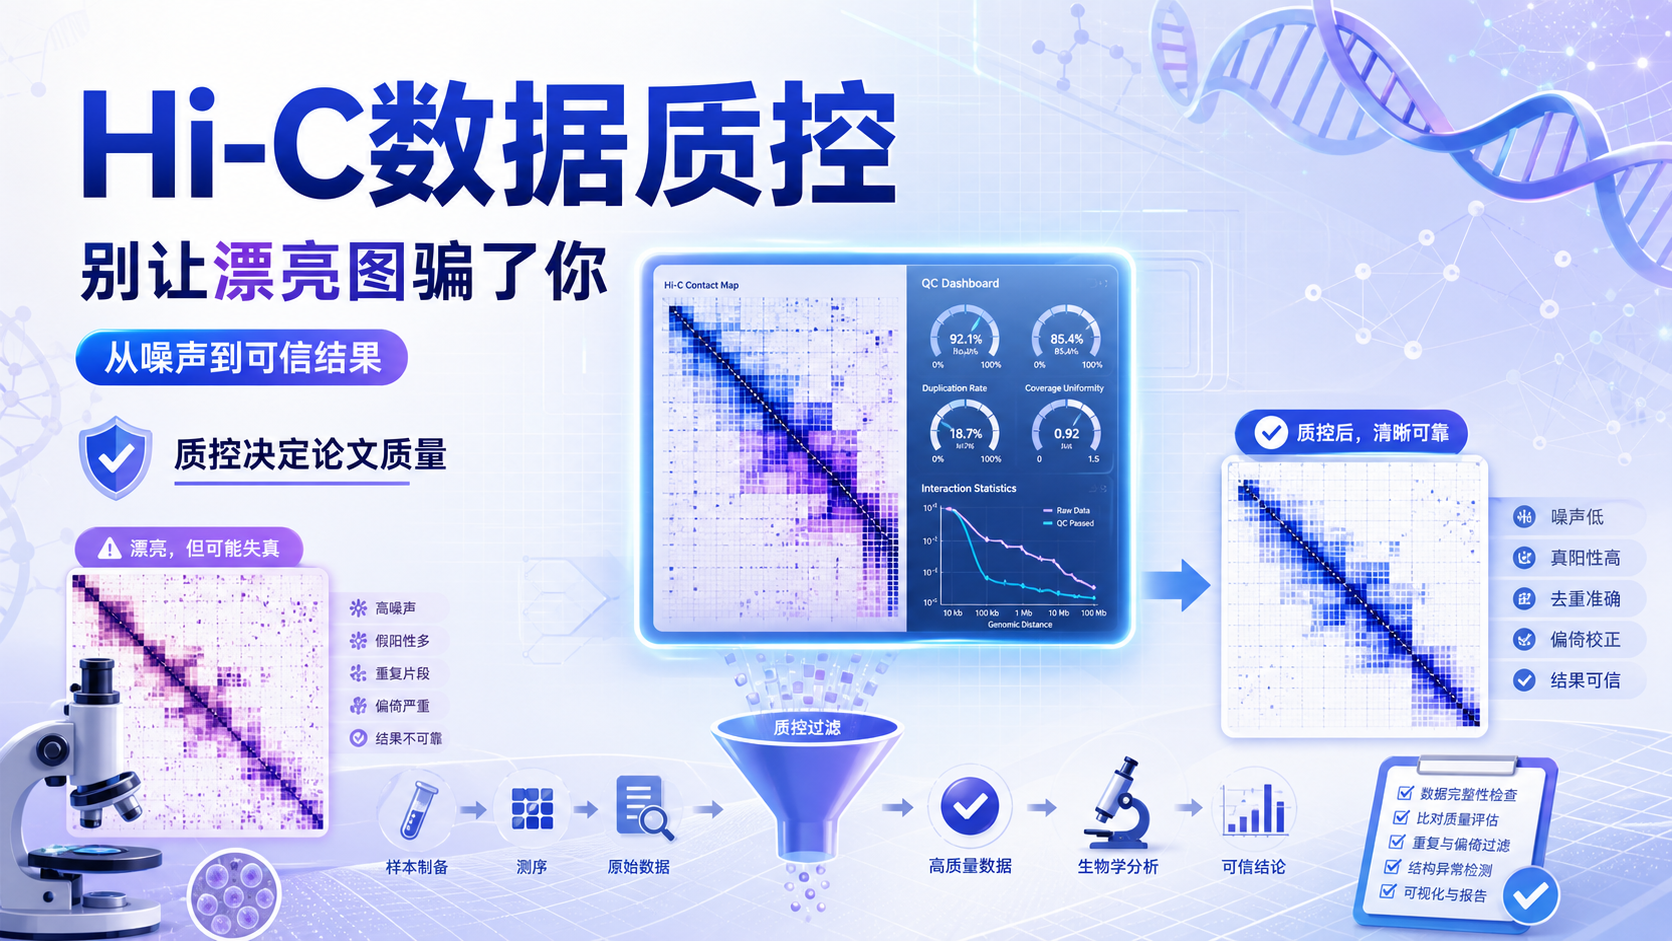
Hi-C数据看似“高通量”,但真正决定结果可信度的,往往不是测序深度,而是质控是否到位。文库复杂度低、有效比对率差、接触矩阵偏倚、重复率高,都会让后续TAD、loop和A/B compartment分析失真。Hi-C数据质控不是附加步骤,而是结果能否发表的前提。 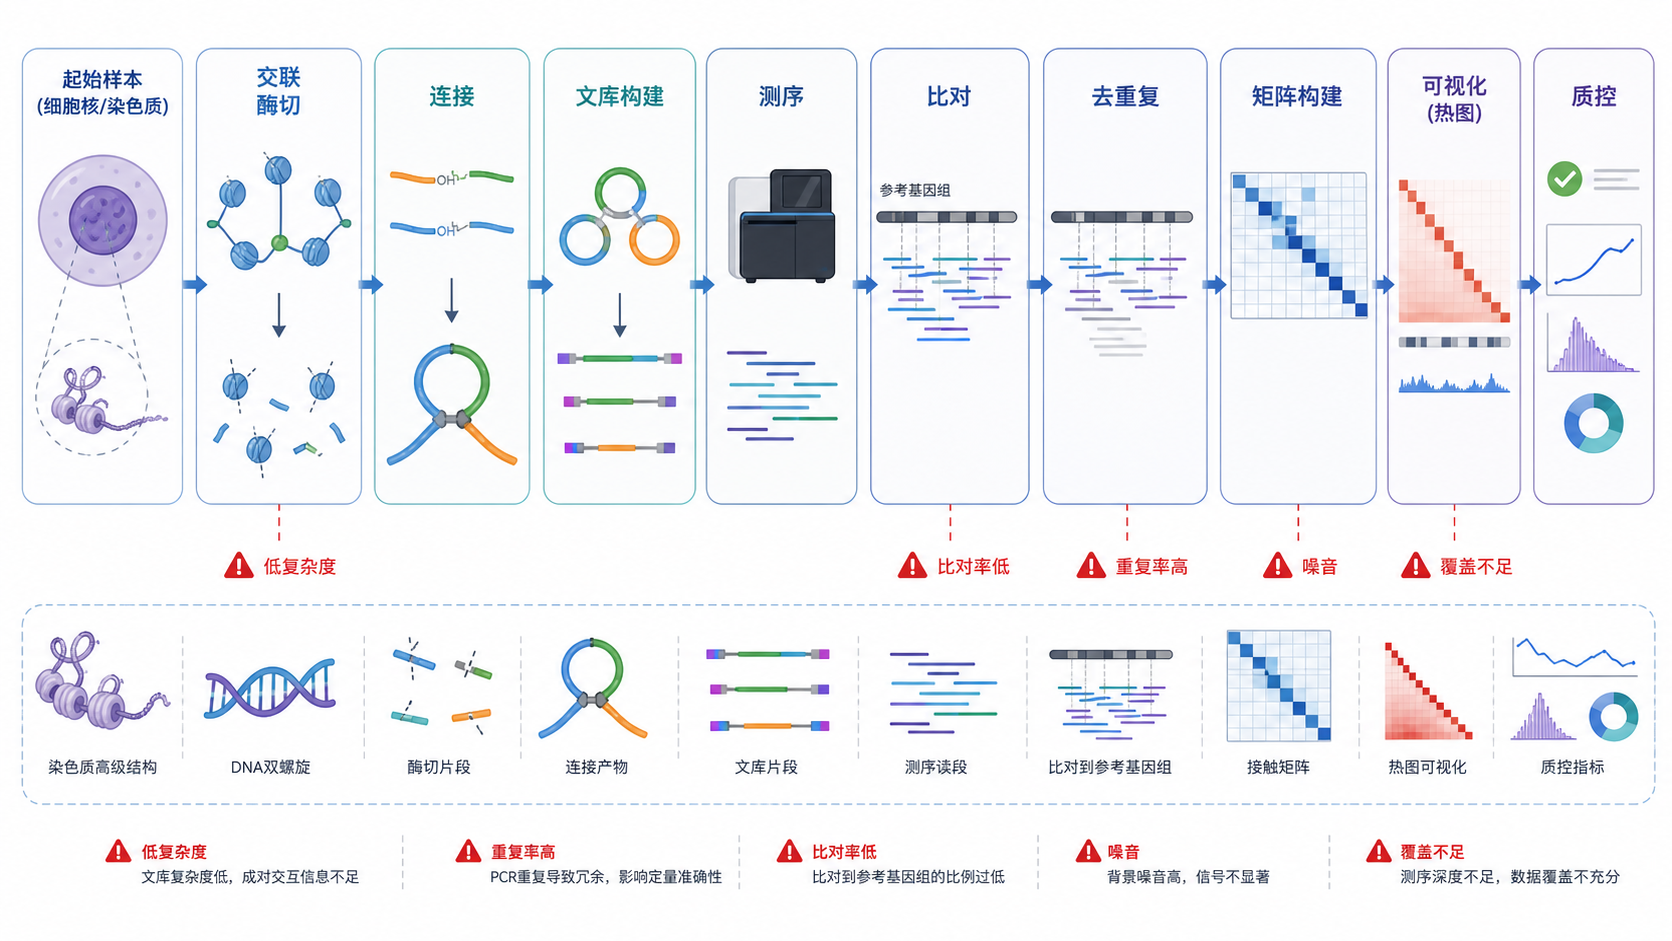
1. Hi-C数据质控为什么最容易被忽视
1.1 Hi-C结果的“漂亮图”,不等于“好数据”
Hi-C最常见的误区,是只看热图是否清晰。事实上,一张分辨率高的contact map,并不能证明数据质量合格。 如果片段连接率低,或者重复片段过多,热图仍可能“看起来不错”,但生物学解释已经偏离真实结构。
对医学生和科研人员来说,Hi-C的核心不是画图,而是证明三维基因组结构变化可靠。尤其在比较肿瘤、药物处理或发育阶段差异时,任何技术偏差都会被误判为“结构重塑”。
1.2 质控缺失会直接放大假阳性
Hi-C数据最怕的是系统性偏差。比如:
- 接触频率受GC含量影响
- 酶切位点分布不均
- 片段长度差异带来覆盖偏倚
- 测序深度不足导致远距离互作丢失
这些问题一旦叠加,TAD边界、loop强度和compartment切换都可能被夸大。最终得到的不是生物学信号,而是技术噪音。
2. Hi-C数据质控的常见陷阱
2.1 只看测序量,不看有效数据比例
很多人第一步就关注测序量是否达标,但Hi-C真正关键的是有效reads比例。原始reads多,并不等于可用于下游分析的reads多。若大量reads属于self-ligation、dangling ends、PCR duplicates或未比对片段,数据利用率会明显下降。
一般来说,质控应先判断:
- 原始reads数量是否充足。
- 比对率是否合理。
- 有效互作reads占比是否过低。
- 重复率是否异常升高。
如果有效reads占比偏低,继续加测序深度往往只能“放大低质量”。
2.2 只做标准流程,不做样本层级检查
Hi-C分析常见流程是比对、去重复、过滤、建矩阵,但很多研究者忽略了样本层级的异常检查。例如不同样本的cis/trans比例差异过大,可能提示建库失败、核酸降解或细胞核完整性差。
还要特别注意:
- 酶切效率是否一致
- 片段长度分布是否异常
- 文库复杂度是否过低
- 样本间测序覆盖是否不均衡
流程跑通不代表数据可靠。 样本级指标才是第一道门槛。
2.3 忽视重复序列和比对偏差
Hi-C数据来自全基因组范围,重复序列区域比普通测序更难处理。若参考基因组注释不充分,或者比对参数设置不合理,重复区域会造成大量多重比对,降低矩阵准确性。
在实际分析中,这类偏差会表现为:
- 局部接触富集异常
- 某些染色体区域信号断裂
- 边界识别不稳定
- 不同软件输出结果差异明显
比对质量不稳,后续标准化再精细也难以补救。
3. 质控应重点关注哪些指标
3.1 从原始数据到有效互作的四个层级
Hi-C质控建议按层级推进,而不是只看一个总分数。可重点关注以下指标:
- 原始reads数量
- 比对率和唯一比对率
- 有效互作比例
- PCR重复率
- cis/trans比例
- short-range与long-range互作分布
这些指标能较完整反映文库质量、测序质量和结构可信度。其中,唯一比对率和有效互作比例,通常比单纯测序深度更有判断价值。
3.2 接触矩阵前后的偏差检查
建矩阵后,还要看偏差是否集中在特定距离范围。典型Hi-C数据应呈现随基因组距离增加而逐渐衰减的规律。如果短距离互作异常偏高,或远距离互作过少,都提示建库或过滤存在问题。
建议至少检查:
- 距离衰减曲线是否符合预期。
- 染色体内互作是否高于染色体间互作。
- 不同染色体之间是否存在异常热点。
- 是否存在明显批次效应。
距离衰减曲线是Hi-C质控中非常关键的“体检单”。
3.3 分辨率不要盲目追高
很多研究者误以为分辨率越高越好。实际上,分辨率取决于数据深度和文库复杂度。若reads不足,强行做10 kb甚至更高分辨率,只会得到稀疏矩阵,增加噪音。
更稳妥的做法是:
- 先评估数据覆盖度
- 再根据bin size选择分析层级
- 低深度数据优先做compartment
- 中等深度数据再考虑TAD
- 高深度数据才适合稳定识别loop
分辨率是资源与问题之间的平衡,不是越细越先进。
4. 提升Hi-C数据可信度的对策
4.1 实验端先把偏差降到最低
最有效的质控,不是在分析阶段“补救”,而是在实验阶段减少误差。实验端建议重点控制:
- 细胞状态一致
- 交联条件稳定
- 酶切和连接效率可重复
- DNA回收过程尽量减少损失
- 文库扩增周期不过度
尤其是交联和酶切,这两个步骤对Hi-C信号影响最大。实验条件越标准化,后续数据越容易解释。
4.2 分析端用统一标准筛除低质量样本
分析阶段应建立明确阈值,而不是凭经验判断。对于低质量样本,建议优先排除以下情况:
- 唯一比对率持续偏低
- PCR重复率明显异常
- cis/trans比例严重失衡
- 距离衰减曲线偏离正常趋势
- 复现实验间相关性差
对于比较研究,最好在同一批次、同一建库体系和同一分析流程下完成。统一标准是减少假差异的核心。
4.3 先做可重复性,再谈生物学结论
Hi-C最容易被忽视的一点,是复现性。单个样本即使图形“很好看”,也不够支持结论。建议至少从以下角度验证:
- 生物学重复间相关性
- TAD边界一致性
- loop信号重复性
- compartment切换方向是否一致
如果重复样本结果不一致,优先怀疑技术偏差,而不是急于提出新机制。可重复性是Hi-C研究可信度的底线。
5. 如何让质控真正服务于论文产出
5.1 质控结果要能进入方法学与结果部分
很多文章把Hi-C质控写得过于简单,只交代测序量和软件名称,缺少关键指标。这会削弱审稿人对数据可靠性的判断。更好的写法应明确说明:
- 质控标准
- 过滤规则
- 保留数据比例
- 重复样本一致性
- 下游分析的分辨率依据
把质控写清楚,本身就是增强论文说服力。
5.2 让流程规范化,减少“人为解释空间”
Hi-C数据处理环节多,任何一步都可能影响结论。要提升可信度,最重要的是建立可复用流程:
- 原始数据统一检查。
- 统一比对和过滤参数。
- 统一标准化策略。
- 统一可视化和统计口径。
- 保留完整质控记录。
这样不仅便于论文复核,也便于项目组内部积累标准化经验。规范化流程,比事后修补更重要。
5.3 用专业工具把复杂流程变简单
对于医学生、医生和科研人员来说,Hi-C质控最大的难点不是概念,而是流程复杂、指标繁多、结果难汇总。若缺少成熟的分析支持,很容易在比对、过滤、可视化和报告整理上耗费大量时间。
这时,借助像解螺旋 这样的专业科研支持平台,可以更高效地完成文献梳理、分析思路整理、结果表达和质控报告规范化输出。把重复性工作交给工具,把精力留给科学判断,才能真正提升Hi-C研究质量。
总结Conclusion
Hi-C数据质控的核心,不是把流程跑完,而是识别那些会扭曲三维基因组结论的关键陷阱。原始reads多不代表有效,热图清晰不代表可信,分辨率高也不代表更优。真正可靠的Hi-C研究,必须同时控制实验偏差、过滤标准、复现性和分析一致性。
如果你正在做Hi-C项目,建议从今天开始建立一套可复用的质控框架。这样不仅能减少返工,也能显著提升论文通过率。若你希望更高效地完成Hi-C分析整理、质控报告和论文表达,可以关注解螺旋 ,把复杂流程变成可执行的标准化方案。
- 引言Introduction
- 1. Hi-C数据质控为什么最容易被忽视
- 2. Hi-C数据质控的常见陷阱
- 3. 质控应重点关注哪些指标
- 4. 提升Hi-C数据可信度的对策
- 5. 如何让质控真正服务于论文产出
- 总结Conclusion