48
 分享
引言Introduction
TAD识别算法正在成为基因组3D结构研究的关键入口。对医学生、医生和科研人员来说,真正的难点不是“有没有数据”,而是如何从Hi-C等高维数据中准确定位TAD边界,并把结构变化解释为疾病机制 。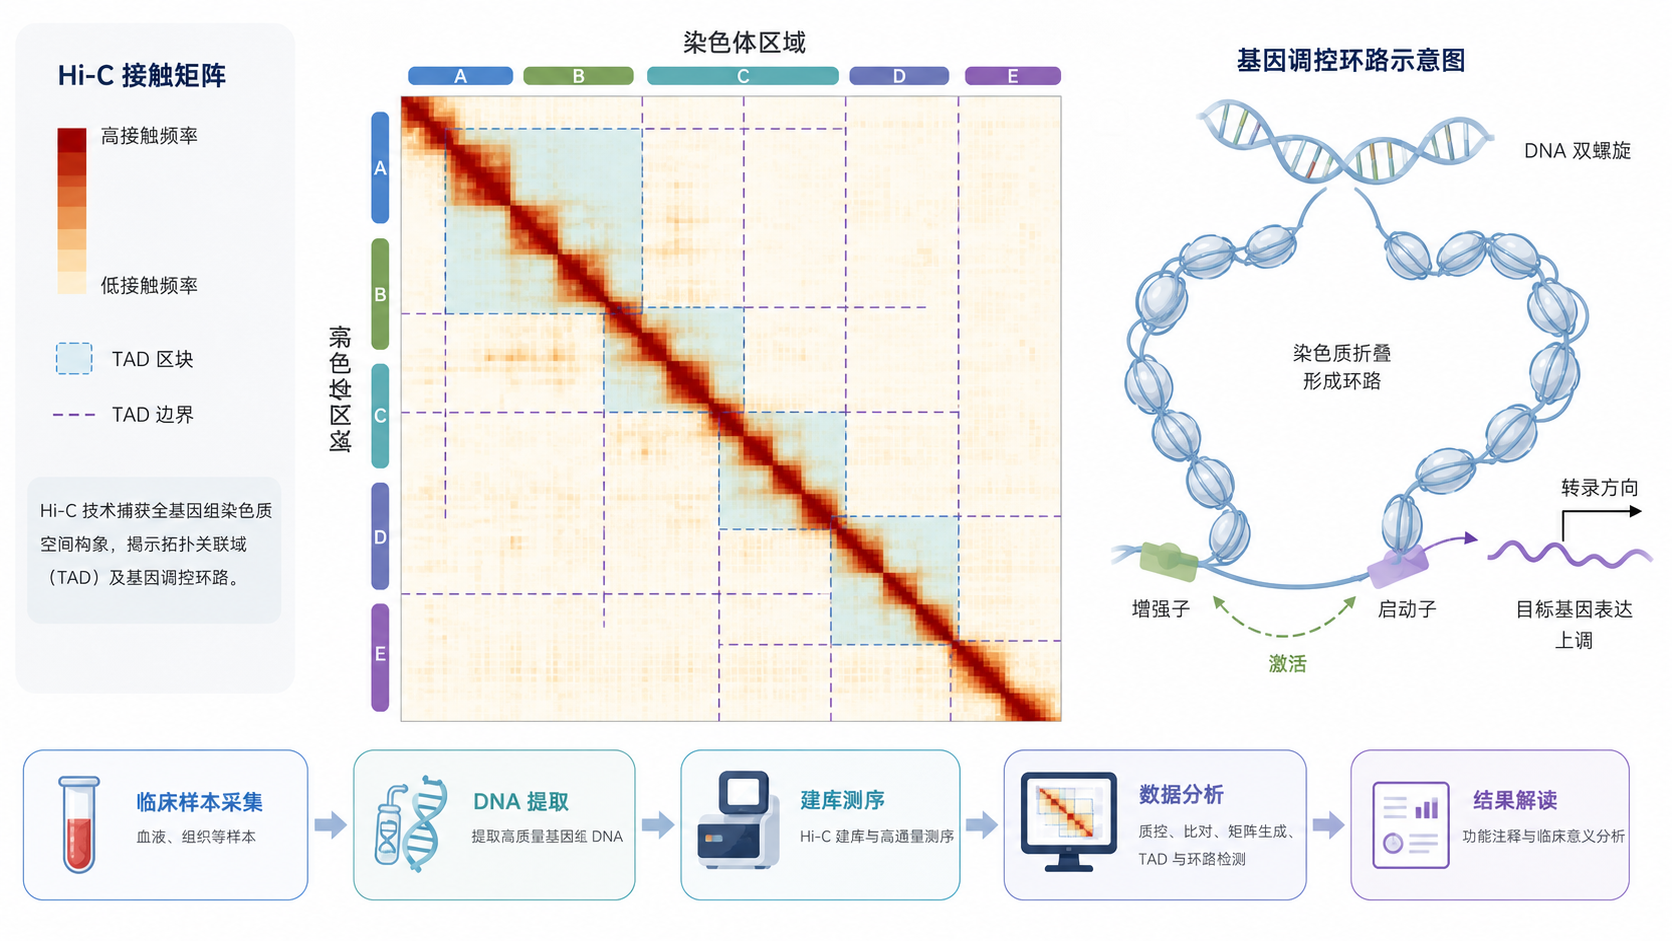
1.TAD识别算法为什么重要
1.1 TAD是基因组功能组织的基础单元
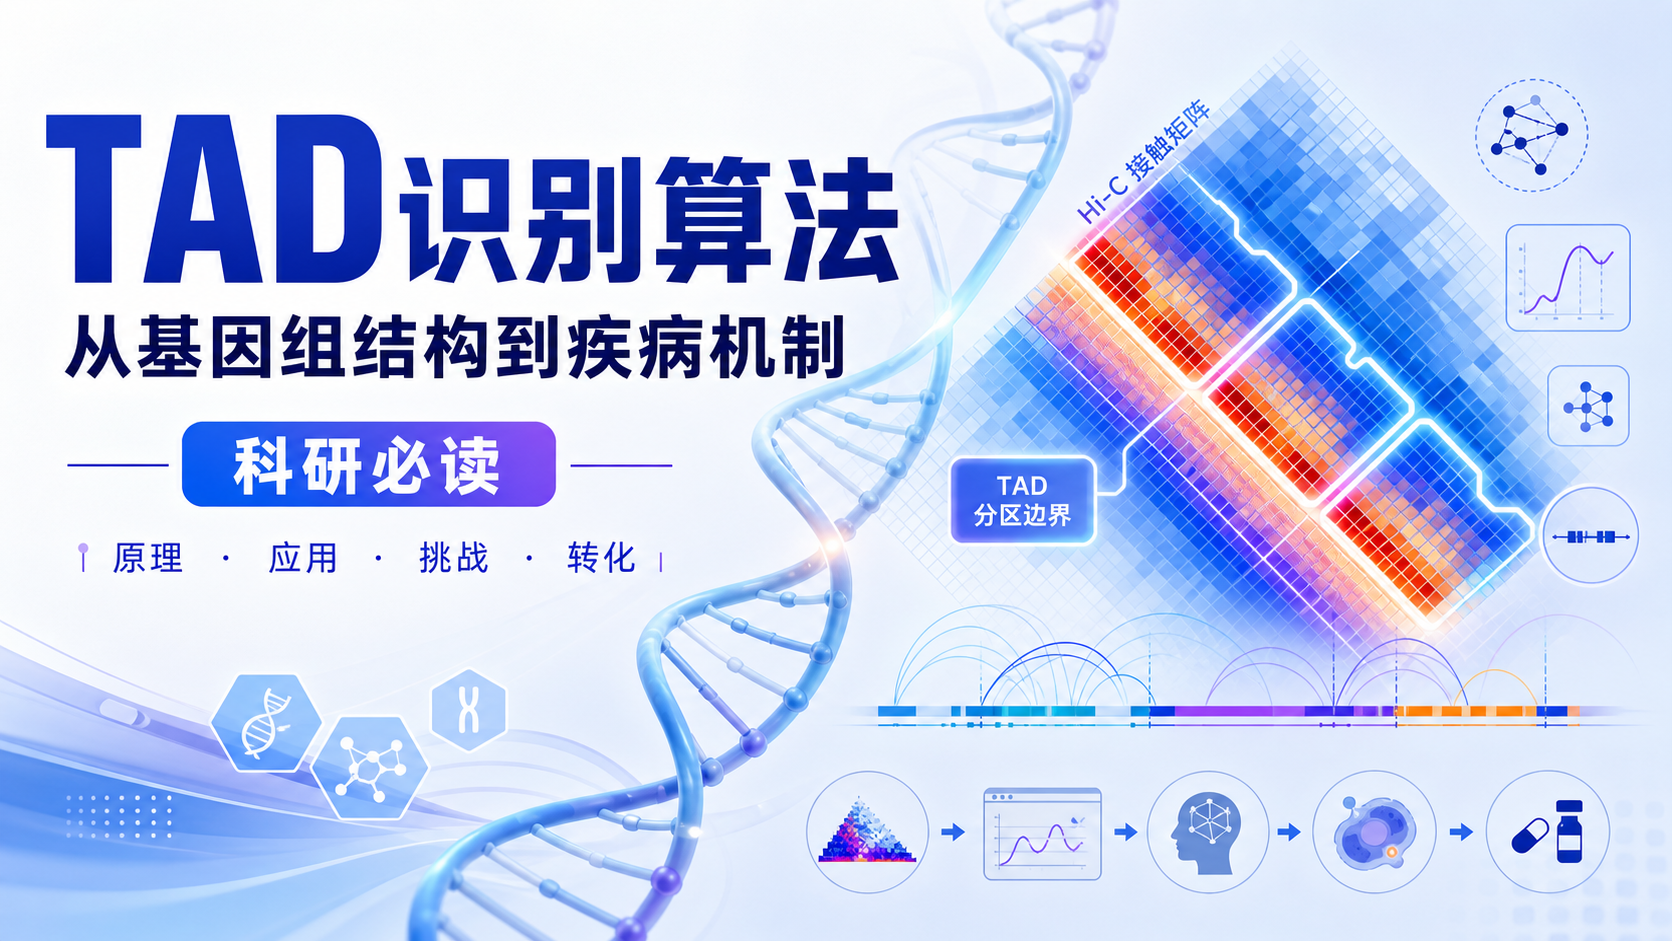
TAD,指拓扑关联结构域。它是染色体在三维空间中形成的局部折叠单元。同一TAD内的增强子和启动子更容易发生互作,跨TAD的调控通常受到边界限制。 这意味着,TAD不是纯结构概念,而是直接影响转录调控的功能单元。
在发育、肿瘤和遗传病研究中,TAD边界异常常与基因错误激活相关。经典现象包括结构变异破坏边界后,增强子“越界”激活致癌基因。对临床研究而言,这类信息比单纯差异表达更接近病因层面。
1.2 TAD识别算法决定下游分析质量
Hi-C、Micro-C和相关染色质构象捕获数据可以揭示三维结构,但原始矩阵噪声大、分辨率差异明显。TAD识别算法的核心任务,是把矩阵中的局部富集信号转化为可解释的边界和区段。 如果算法不稳定,下游的差异TAD、边界保守性、疾病相关重编程分析都会失真。
目前常见算法思路包括:
- 基于绝缘分数的边界检测。
- 基于方向性指数的区段划分。
- 基于图模型或动态规划的分域方法。
- 结合多尺度信息的聚类和递归分割方法。
不同算法对分辨率、测序深度和噪声敏感度不同。没有一种算法在所有数据集上都绝对最优。 因此,选择算法时必须结合数据类型和研究问题。
2.TAD识别算法的核心原理与常见框架
2.1 从接触矩阵到边界定位
TAD识别首先依赖接触矩阵。矩阵中,对角线附近的高接触频率代表局部空间邻近。算法会搜索这种连续富集区域,并判断边界位置。常用思路是比较某一窗口左右两侧的接触强度差异,或计算局部绝缘程度。
边界本质上是“局部互作下降”的位置。 这与实验分辨率密切相关。比如10 kb与40 kb分辨率下,同一边界的精确位置可能有偏移。若输入数据覆盖不足,边界会被平滑掉。若过度去噪,也可能损失真实信号。
2.2 统计判定比“看图圈块”更可靠
很多初学者会直接在Hi-C热图上肉眼划分TAD,但这种方式主观性强。算法则会引入统计阈值和显著性判定。常见步骤包括:
- 对接触矩阵做归一化,消除测序深度和技术偏差。
- 计算局部指标,如绝缘分数、方向性指数或局部富集评分。
- 结合滑动窗口找边界。
- 用阈值、峰谷检测或模型分割定义TAD。
- 对不同重复样本进行一致性验证。
真正有价值的TAD识别,不只是“划出块”,而是能重复、可比较、可解释。
2.3 多尺度TAD是现实问题
TAD不是固定不变的单层结构。不同分辨率下,可能同时存在大尺度域和小尺度亚结构。研究中常见情况是:
- 宏观上观察到较大的染色体分区。
- 局部上存在更细的嵌套TAD。
- 疾病状态改变的是边界强度,而不一定是单个边界的“有无”。
因此,越来越多算法开始关注多尺度识别。只看单一分辨率,容易漏掉关键调控层级。
3.TAD识别算法如何服务疾病机制研究
3.1 肿瘤中的边界重塑
肿瘤研究中,TAD改变常与染色体重排、扩增、缺失和甲基化异常相关。边界蛋白如CTCF、cohesin相关改变,会影响染色质环路稳定性。结果可能是原本被隔离的增强子重新接触癌基因启动子。
这类研究的价值在于把“突变”与“表达异常”连接起来。TAD识别算法能帮助研究者定位结构层面的病理起点。 对精准医学而言,这比仅做差异表达更进一步。
3.2 遗传病与发育异常中的结构解释
不少发育异常并不源于编码区突变,而是调控区或结构边界异常。此时,TAD识别算法可用于:
- 定位边界缺失或弱化区域。
- 比较患者与对照的TAD一致性。
- 追踪增强子错配导致的异常表达。
- 解释表型与非编码变异之间的联系。
这对临床基因组学很重要。 因为许多VUS,单靠序列层面难以解释,若结合3D结构信息,诊断证据会更完整。
3.3 免疫与代谢疾病中的调控网络重排
TAD变化也可能影响免疫细胞活化、炎症因子表达和代谢通路切换。尤其在单细胞组学逐步普及后,研究者开始关注不同细胞状态下的3D结构差异。虽然单细胞Hi-C仍存在稀疏性问题,但它提示了一个方向:TAD识别不应只停留在群体平均,而应走向细胞类型特异性解析。
4.算法落地时最常见的三个问题
4.1 数据质量不足
Hi-C数据常受测序深度、文库质量和批次效应影响。对于低覆盖样本,TAD边界识别会显著不稳定。很多“新算法”性能优于旧算法,并不一定来自方法本身,而是测试数据更干净。
因此,分析前必须先做:
- reads质控。
- 比对与重复序列处理。
- 去除低质量片段。
- 矩阵归一化和分辨率选择。
没有高质量输入,再好的算法也只能输出高噪声结果。
4.2 阈值设置过于随意
TAD识别常依赖阈值,比如绝缘分数阈值、显著性阈值或最小域长度。若阈值过松,会产生大量假阳性。若过严,则会漏掉弱边界。研究中应尽量报告参数来源,并进行敏感性分析。
建议至少比较:
- 不同窗口大小。
- 不同分辨率。
- 不同边界阈值。
- 生物学重复一致性。
4.3 结果解释脱离生物学背景
TAD不是终点。边界变化是否真正影响基因表达,必须结合RNA-seq、ATAC-seq、ChIP-seq或功能实验验证。 单独一个TAD图,不能直接推出机制。更稳妥的做法是把结构变化与差异表达、转录因子结合位点、增强子状态联合分析。
5.从科研到临床转化,TAD识别算法下一步怎么走
5.1 与多组学整合是趋势
未来的TAD识别不会孤立存在,而是嵌入多组学分析流程。典型组合包括:
- Hi-C结合RNA-seq,分析结构与表达耦联。
- Hi-C结合ATAC-seq,观察可及性变化。
- Hi-C结合ChIP-seq,定位边界蛋白和活性标记。
- 结合WGS或WES,解释结构变异与调控异常。
只有把3D结构放进多组学框架,TAD才真正具备临床解释力。
5.2 算法需要更强的可重复性和可追溯性
临床研究对可追溯性要求高。每一步参数、阈值和版本都要可记录。AI和自动化工具未来可以帮助处理大规模数据,但目前仍需要研究者参与判断。尤其在几十GB级别数据、复杂分支分析和云计算任务中,人工审阅依然不可替代。
这也是为什么现在很多团队开始采用可复现分析流程。能保存中间文件、记录执行步骤、回溯参数的工作流,才更适合发表和转化。
5.3 未来一年内,AI会先改变“流程”,再改变“结论”
从现阶段看,AI更适合辅助数据清洗、代码生成、图形美化和文献整理。它可以先帮你跑基础流程,再由研究者判断关键节点。比如在TAD研究中,AI可以协助完成:
- Hi-C矩阵预处理。
- 边界候选区筛选。
- 火山图、热图、环路图绘制。
- 结果摘要和文献结构化整理。
但AI还不能完全替代专业判断 。尤其是涉及阈值设置、算法选择和生物学解释时,仍需要专家介入。
总结Conclusion
TAD识别算法正在把基因组3D结构研究从“看图”推进到“可量化、可比较、可验证”的阶段。它不仅能帮助解析增强子-启动子互作、边界异常和染色质重塑,还能为肿瘤、遗传病和发育异常提供更接近机制层面的证据。对医学生、医生和科研人员来说,真正重要的是把算法结果放回生物学问题中,结合多组学和实验验证,形成完整链条。
如果你希望更高效地完成Hi-C分析、结果整理、图形优化和文献梳理,可以借助解螺旋 来提升流程效率。它适合帮助你把复杂数据处理步骤标准化,把TAD识别结果更快转化为可发表、可汇报、可临床讨论的内容。
- 引言Introduction
- 1.TAD识别算法为什么重要
- 2.TAD识别算法的核心原理与常见框架
- 3.TAD识别算法如何服务疾病机制研究
- 4.算法落地时最常见的三个问题
- 5.从科研到临床转化,TAD识别算法下一步怎么走
- 总结Conclusion