112
 分享
引言Introduction
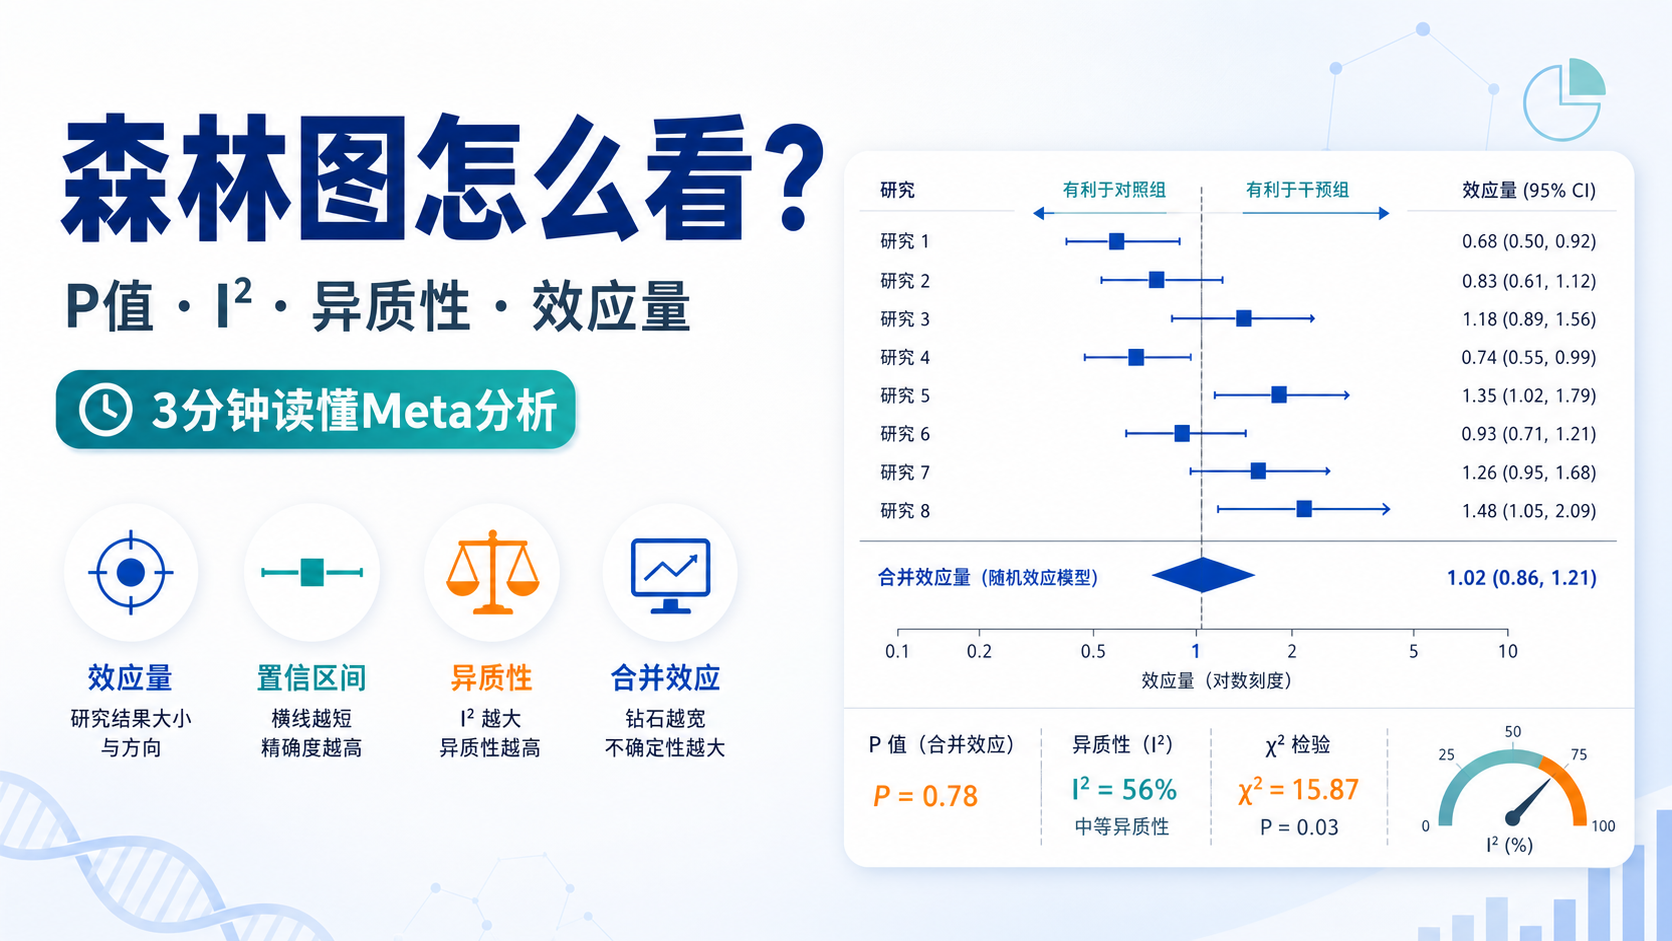
森林图是Meta分析里最常见的结果图,但很多人只盯着P值,却忽略了效应量、95%置信区间和异质性。P值统计学意义不是“结果好不好”的全部答案 ,读错一步,结论就可能偏差很大。
1. 森林图到底在表达什么
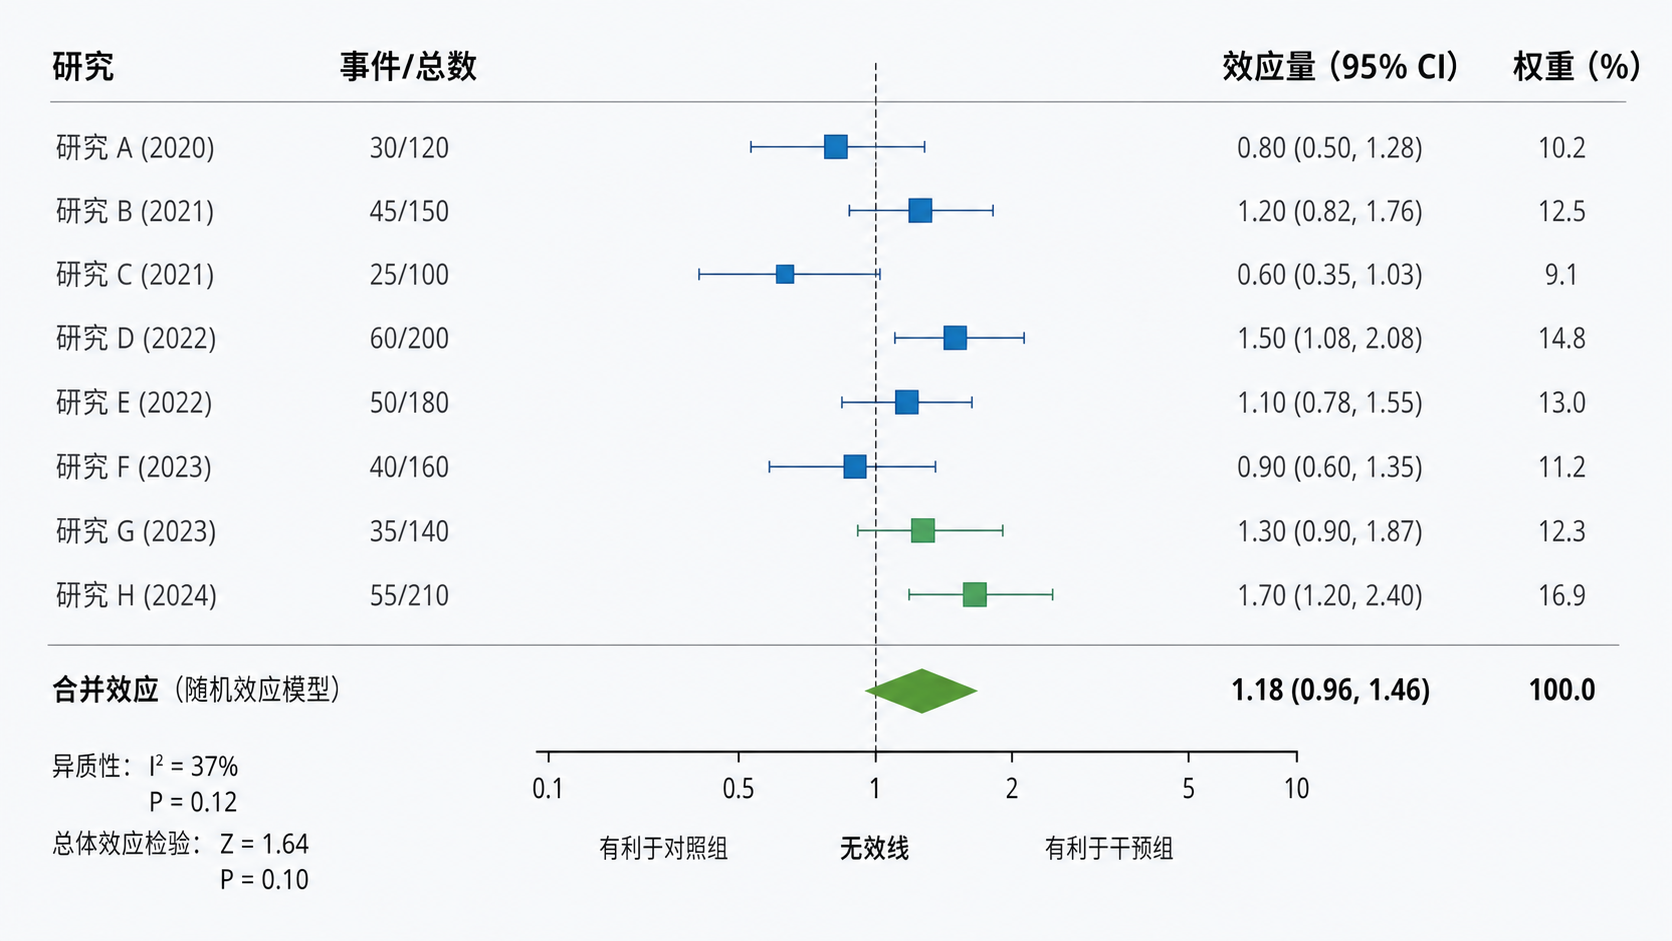
1.1 中线、方块和横线分别代表什么
森林图的核心信息其实很直接。中间参考线表示无效值 ,通常是“无差异”位置。
方块代表单个研究的效应量,方块越大,通常说明该研究权重越高。横线则是该研究效应量的95%置信区间。
如果横线跨过中线,说明该研究的结果在统计学上通常不显著。
如果横线没有跨过中线,才提示该研究可能存在统计学意义。
1.2 合并效应量怎么看
森林图最下方通常是总效应。它综合了所有研究的信息。
总效应的P值统计学意义,依赖于合并效应量及其95%置信区间是否跨越无效值。
常见判断逻辑有两点:
- 合并效应量的95%CI不跨越无效线,通常提示有统计学意义。
- 合并效应量对应的P值小于0.05,通常提示差异有统计学意义。
但要注意,P值小于0.05不等于临床上一定有意义 。还要看效应量大小和研究背景。
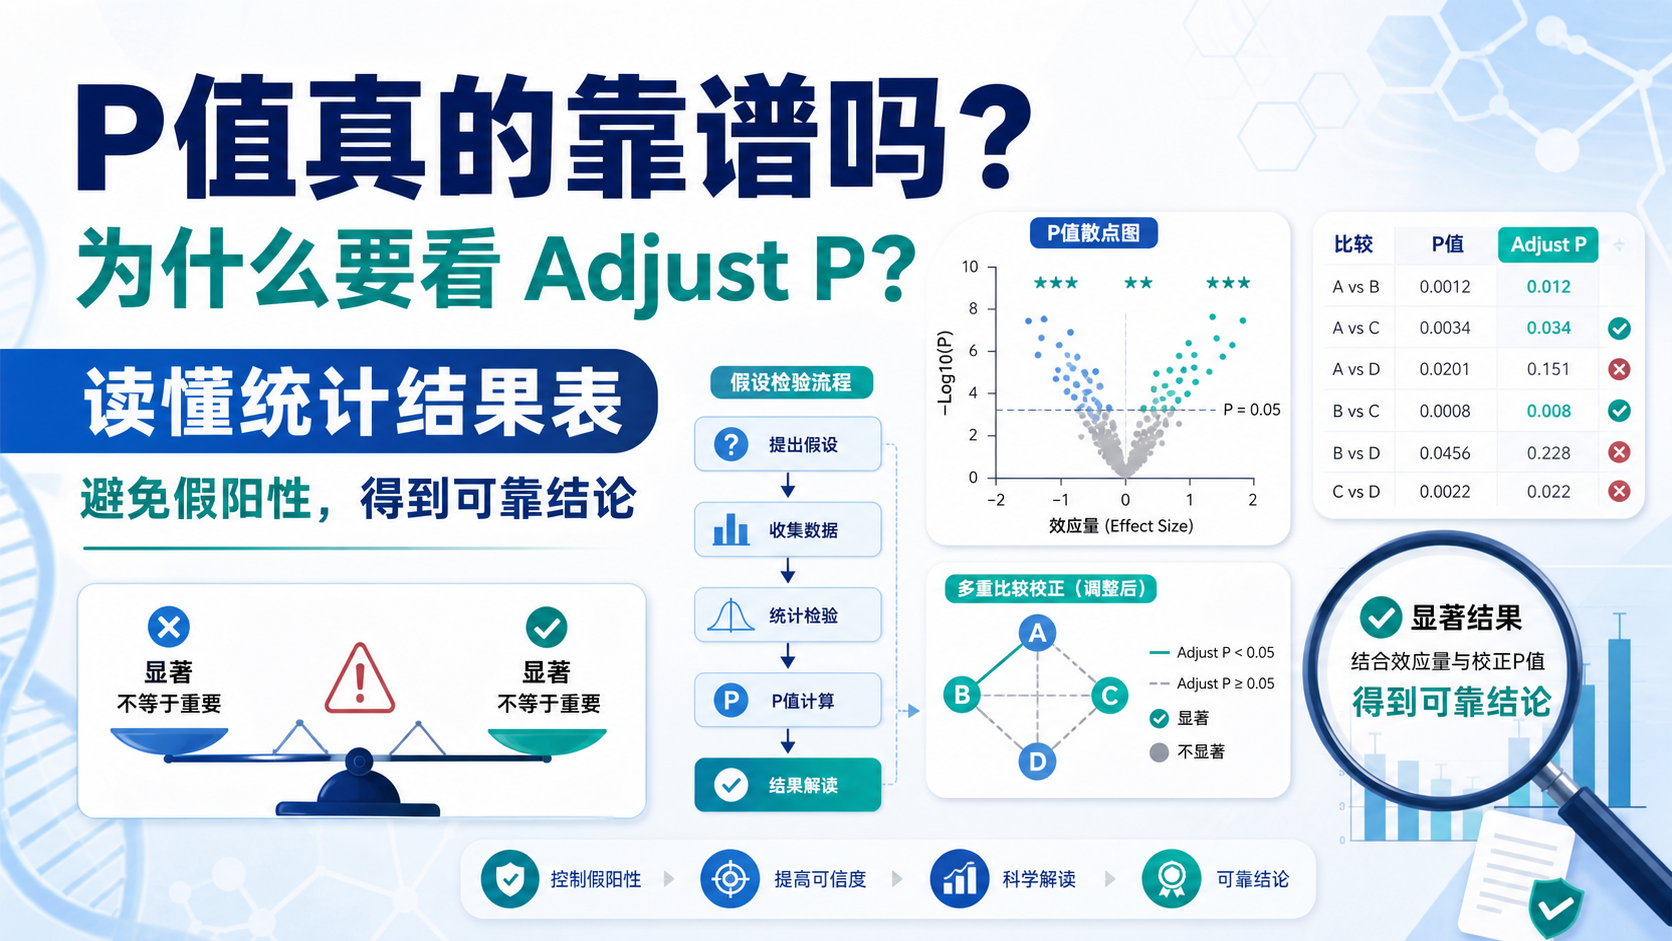
2. P值在森林图里怎么判断
2.1 P值和置信区间是同一问题的两种表达
很多初学者会把P值单独拿出来看。其实在多数Meta分析中,P值和95%置信区间是在回答同一个问题 ,即“效应是否偏离无效值”。
例如:
- 若95%CI不包括1,常对应比值比、风险比等结果的显著性。
- 若95%CI不包括0,常对应均数差、标准化均数差等结果的显著性。
对应地,P值通常会小于0.05。
因此,森林图里看P值,本质上是在看“结果是否跨越无效线” 。
2.2 不同效应量的无效值不同
这一点很重要。不同指标的判断标准不一样。
- RR、OR、HR等比值类指标,无效值通常是1。
- MD、SMD等差值类指标,无效值通常是0。
所以,看森林图时不能只问“有没有P值”。
必须先确认图中效应量类型,再判断它对应的无效值是什么。否则很容易误读。
2.3 不能只看P值大小
P值统计学意义受样本量影响很大。
样本量很大时,哪怕效应差异很小,也可能出现P<0.05。
样本量较小时,即使效应量看起来不小,也可能因为统计功效不足而P>0.05。
所以,判断森林图时建议同时看三项:
- P值。
- 效应量大小。
- 95%置信区间。
只有三者合起来看,才更接近真实结论。
3. 异质性在森林图里怎么看
3.1 I²和χ²分别代表什么
Meta分析不只是看“有没有差异”,还要看“研究之间是否一致”。
这就是异质性。
异质性主要看卡方检验(χ²)和I²。
其中,I²更常用于描述不同研究结果间的差异程度。
一般可这样理解:
- I²≤50%,异质性较小或可接受。
- I²在50%到75%之间,提示中等偏高异质性。
- I²>75%,说明异质性很高。
χ²检验的p值也会呈现,但它受研究数量影响较大。
研究数少时,χ²检验不容易检出异质性。研究数多时,又可能过于敏感。
3.2 I²高低意味着什么
I²高,说明研究结果之间差异较大。
这时即使总效应有统计学意义,也不能直接下结论说“所有研究都支持同一方向”。
常见原因包括:
- 研究人群不同。
- 干预方案不同。
- 结局指标不同。
- 随访时间不同。
- 方法学质量不一致。
异质性高时,P值统计学意义的解释要更谨慎。
因为合并后的结果可能被某些研究特征拉偏。
3.3 异质性高时该怎么处理
如果发现I²偏高,常见处理方法包括:
- 先检查纳入研究的临床和方法学差异。
- 尝试亚组分析。
- 做敏感性分析,观察是否由单篇研究主导结果。
- 必要时采用随机效应模型。
这里要强调,模型选择不能只看习惯。
固定效应模型假设研究真实效应相近,随机效应模型更适合异质性较高的情况。
4. 统计学意义不等于研究结论成立
4.1 统计学显著和临床显著不是一回事
这是最常见的误区。
P值统计学意义只能说明“观察到的差异不太像是随机误差”。
它不能自动说明干预值得推广。
例如,某个结局P<0.05,但效应量极小,实际临床获益可能有限。
反过来,P>0.05也不代表完全没有价值,可能只是样本量不足。
所以,解读森林图时,至少要同时回答三个问题:
- 差异有没有统计学意义。
- 效应方向是否一致。
- 效应大小是否有临床意义。
4.2 发表偏倚也会影响你对P值的理解
除了异质性,还要关注发表偏倚。
通常可用漏斗图判断。
原则上,研究点应大致落在漏斗图两侧并相对对称。
如果明显偏斜,提示可能存在发表偏倚。
这意味着阳性结果更容易被发表,Meta分析的P值可能被高估。
因此,森林图和漏斗图要结合看。
单看森林图里的P值,不能完整评估证据质量。
4.3 敏感性分析能验证结论稳不稳
敏感性分析通常是逐一剔除研究,观察总效应是否变化明显。
如果去掉某篇研究后,P值从显著变成不显著,说明总体结论可能不稳定。
这类结果提示:
- 某篇研究权重过大。
- 研究间异质性来源明显。
- 合并结论需要进一步验证。
对于临床研究和毕业课题来说,这一步非常重要。
它直接影响结果是否可信。
5. 实际读图时的标准流程
5.1 先看效应量,再看P值
建议按这个顺序读图:
- 看效应量类型,是RR、OR、HR,还是MD、SMD。
- 找无效值,是1还是0。
- 看95%CI是否跨线。
- 看P值是否小于0.05。
- 再看I²和χ²,判断异质性。
- 最后结合临床背景解释结果。
这个顺序比“先找P值”更稳妥。
因为P值只是结果的一部分。
5.2 一个简单的判断模板
你可以直接套用这个思路:
- P<0.05,且95%CI不跨无效线,提示有统计学意义。
- I²≤50%,说明结果一致性较好,结论相对更稳。
- I²>75%,即便P<0.05,也要警惕合并结果是否受异质性影响。
- P>0.05,不代表没有效应,可能是样本量或异质性导致检验不足。
这套逻辑适合论文结果部分、答辩汇报和文献阅读。
6. 读森林图时最容易犯的3个错误
6.1 把P值当成唯一标准
只看P值,会忽略效应量和研究质量。
这是最常见的错误。
P值统计学意义只能作为判断依据之一,不能替代整体证据。
6.2 忽略I²和χ²
如果异质性很高,直接下结论很危险。
尤其是纳入研究少、干预差异大时,更要谨慎。
6.3 混淆统计学显著和临床价值
一项结果即便统计学显著,也可能缺乏实际意义。
研究结论要能回到临床问题。
这才是Meta分析的最终目标。
总结Conclusion
森林图不是只看一个P值就够了。正确的解读顺序是效应量、95%CI、P值、I²和χ²一起看。
其中,P值统计学意义回答的是“差异是否可能由随机误差造成”,异质性回答的是“研究结果是否一致”。
如果你在论文写作、Meta分析结果汇报或文献复现中,常常卡在读图和解释上,可以借助解螺旋的专业支持,把复杂的统计结果转化为清晰、可发表的研究表达。
- 引言Introduction
- 1. 森林图到底在表达什么
- 2. P值在森林图里怎么判断
- 3. 异质性在森林图里怎么看
- 4. 统计学意义不等于研究结论成立
- 5. 实际读图时的标准流程
- 6. 读森林图时最容易犯的3个错误
- 总结Conclusion