48
 分享
引言Introduction
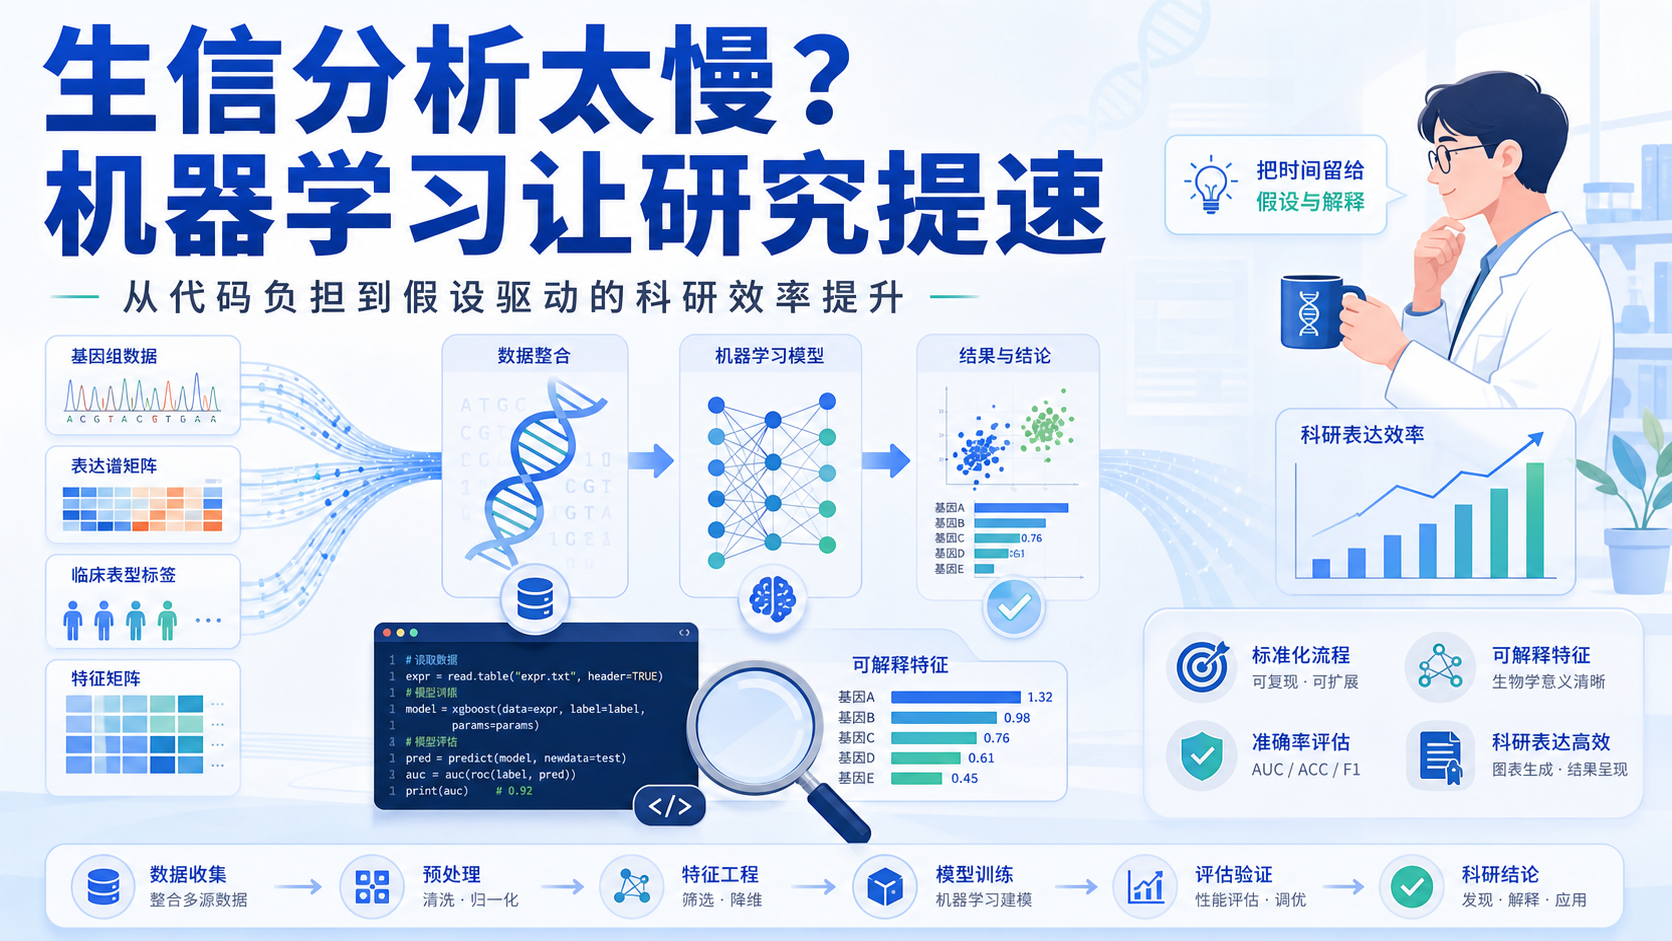
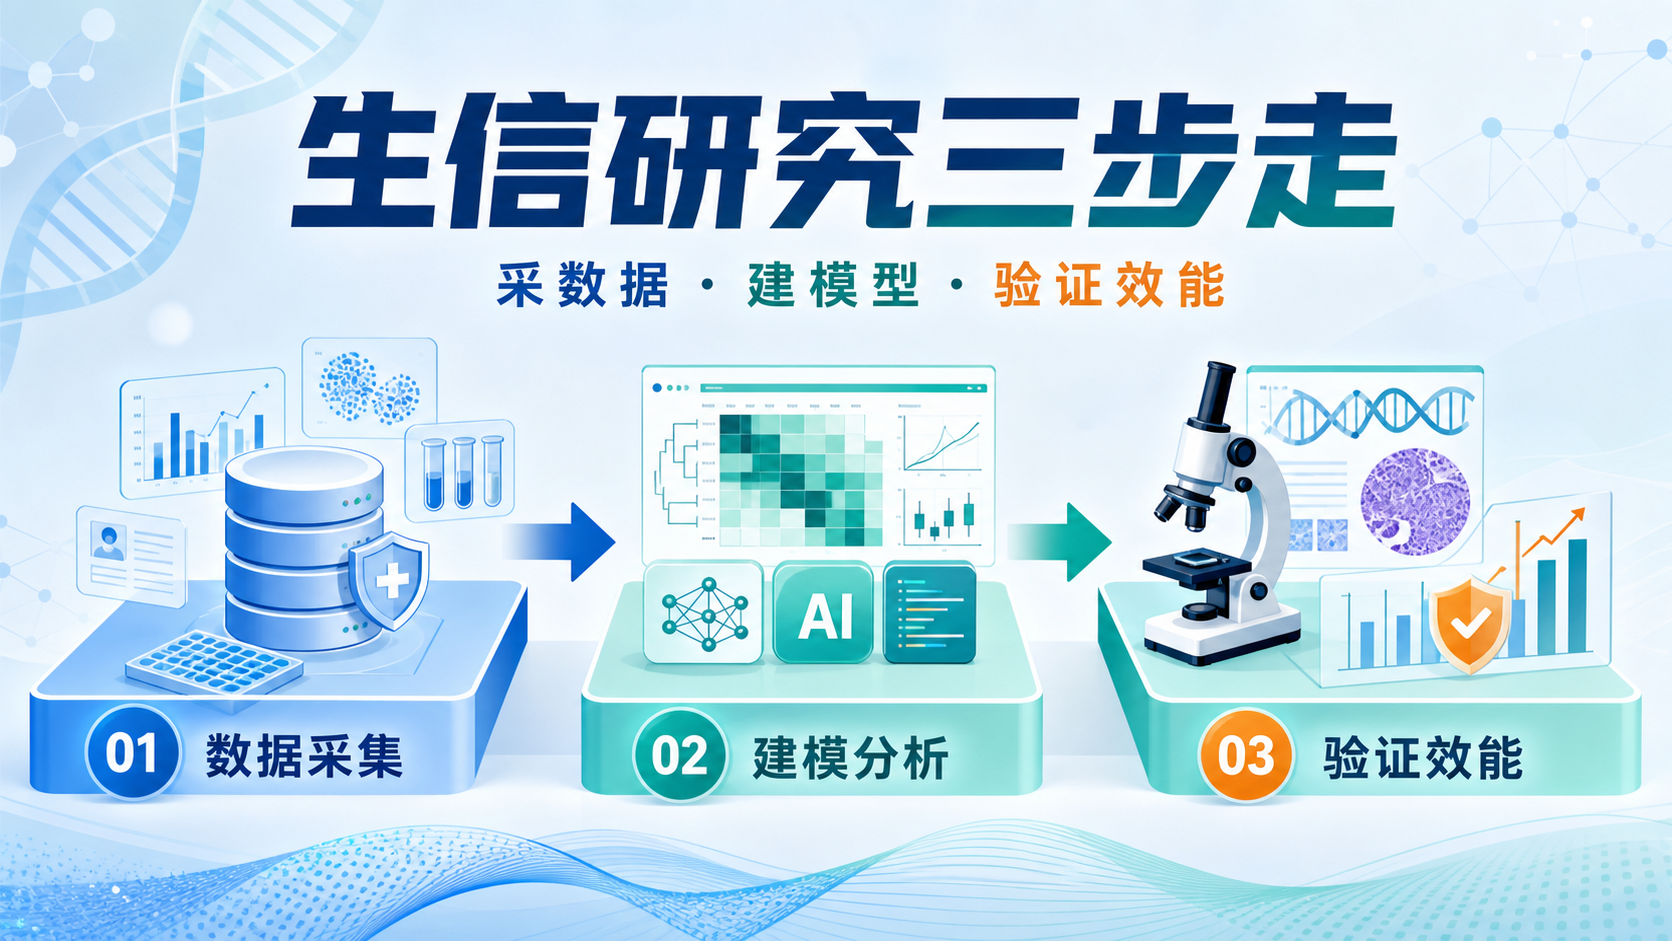
生信研究越来越像标准化工程。很多人卡在两点,数据不够规范,模型也缺少外部验证。结果就是,图做出来了,文章却站不稳。真正能提升发表质量的,不是堆分析,而是把“采数据、建模型、验证效能”做成闭环。
1. 为什么生信研究必须走“三步走”范式
1.1 生信研究的核心,不是单个分析,而是数据逻辑
生信分析本质上是利用生物信息学工具,对高通量数据进行处理、挖掘和解释。它的优势很明确。一旦数据获取到位,分析速度通常快于传统实验。
这也是它受医生和科研人员欢迎的原因。尤其在实验经费有限、临床样本难获取的场景中,公共数据库成为重要入口。
但生信研究也有明显门槛。数据来源、检测平台、分子类型不同,结论就可能不同。只做单点分析,容易停留在“有结果”,却难以形成“有证据链”的文章。
1.2 三步走范式解决的是“可发表性”和“可重复性”
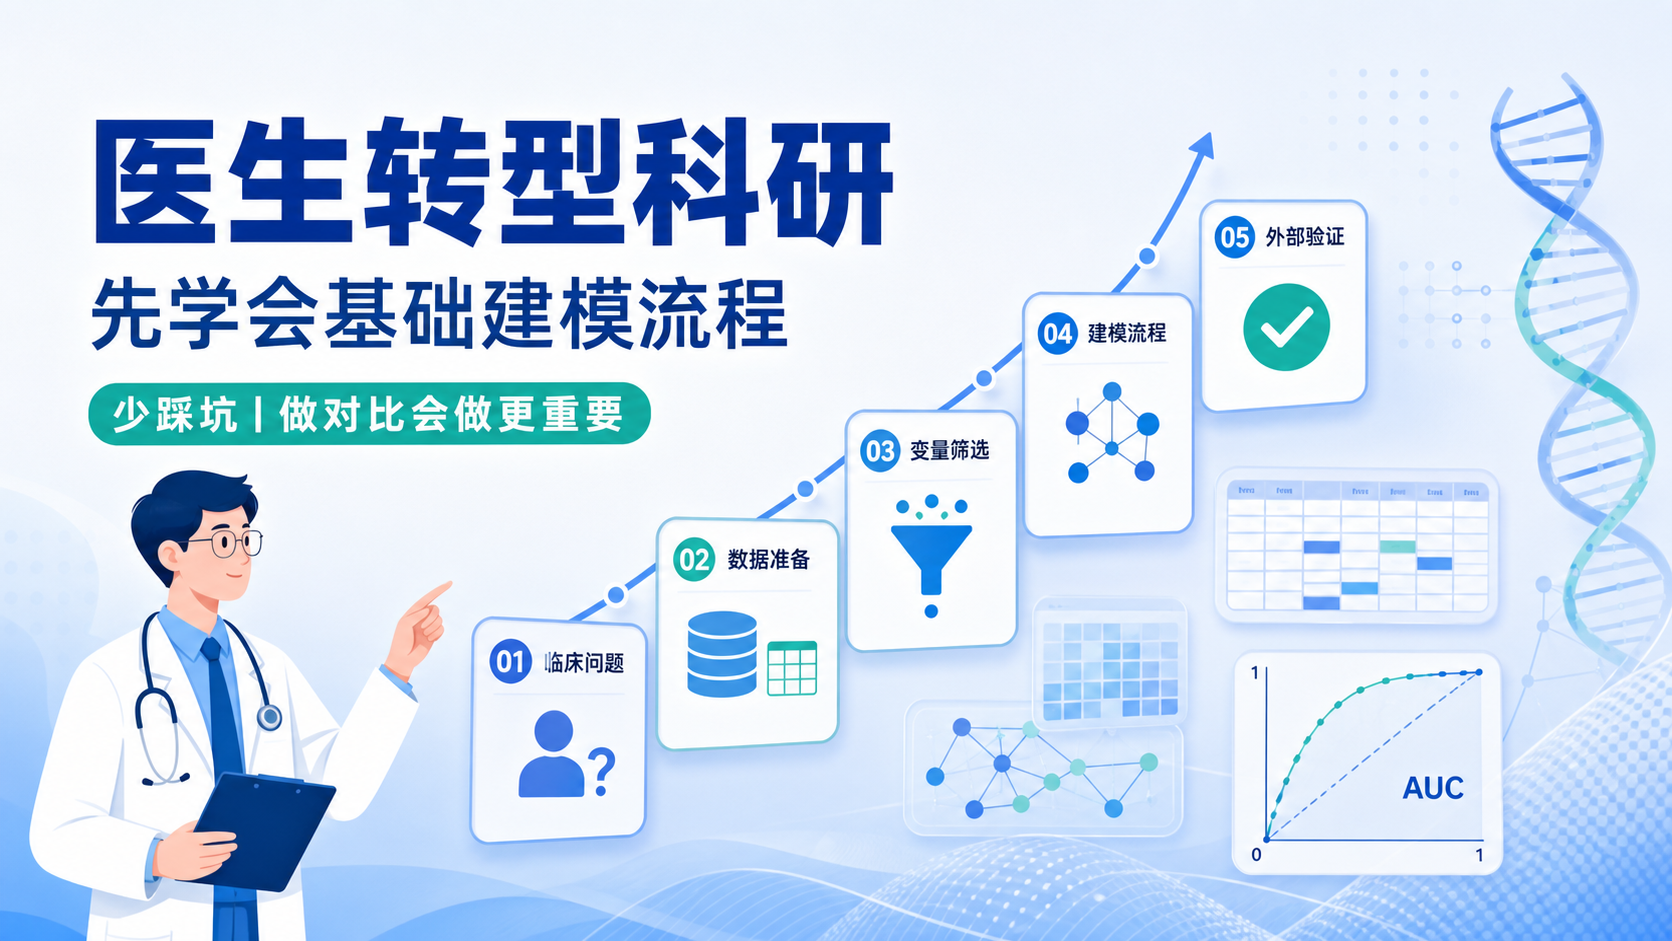
生信研究要解决的,不只是发现差异,而是回答三个问题。
- 数据从哪里来,是否可信。
- 模型怎么建,是否合理。
- 效能如何验证,是否可推广。
这三个问题分别对应采数据、建模型、验证效能。
它们构成了一个完整闭环,也更符合当前高质量医学研究对可重复性和外部一致性的要求。
1.3 适合医学生、医生和科研人员的原因
对临床人员来说,时间有限,不能把精力耗在无效试错上。
对科研人员来说,文章质量取决于设计是否清楚,而不是图表数量是否多。
因此,三步走范式的价值在于,它把复杂生信研究拆成可执行模块。先把问题定义清楚,再围绕数据和模型逐层推进,效率会更高。
2. 第一步,采数据,先决定研究上限
2.1 数据来源决定研究边界
生信研究常见的数据来源有两类。
一类是公共数据库,如 GEO、TCGA、ArrayExpress。
另一类是本地实验或临床数据。
如果数据来源不清,后续分析再漂亮,也很难让审稿人信服。
因为数据特征会直接影响研究对象、统计功效和结论外推范围。
2.2 采数据不是下载而已,前处理更关键
很多初学者把“采数据”等同于“下数据”。其实不是。
真正影响质量的是前处理,包括:
- 样本筛选。
- 分组标准统一。
- 缺失值和异常值处理。
- 批次效应评估。
- 统一命名与格式化。
没有规范化的数据,后面的模型很容易失真。
尤其是多队列整合时,如果样本注释不一致,最后的差异信号可能只是技术噪音。
2.3 数据层面的创新,往往来自“组合”
对于很多非原创平台方法来说,创新不一定来自新算法。
更常见的是:
- 换数据来源。
- 换疾病场景。
- 换分子类型。
- 换验证队列。
这也是为什么同样的分析框架,在不同疾病中能产出不同文章。
生信研究的关键,不是创造方法,而是选择适合的问题和数据。
3. 第二步,建模型,把相关性变成结构化证据
3.1 建模的前提,是先明确研究终点
模型不是为了“好看”,而是为了回答临床或生物学问题。
常见终点包括:
- 诊断。
- 预后。
- 分型。
- 机制解释。
如果研究目标不明确,模型就会变成堆变量。看起来复杂,实际上解释力很弱。
3.2 无监督降维,是模型探索阶段的重要工具
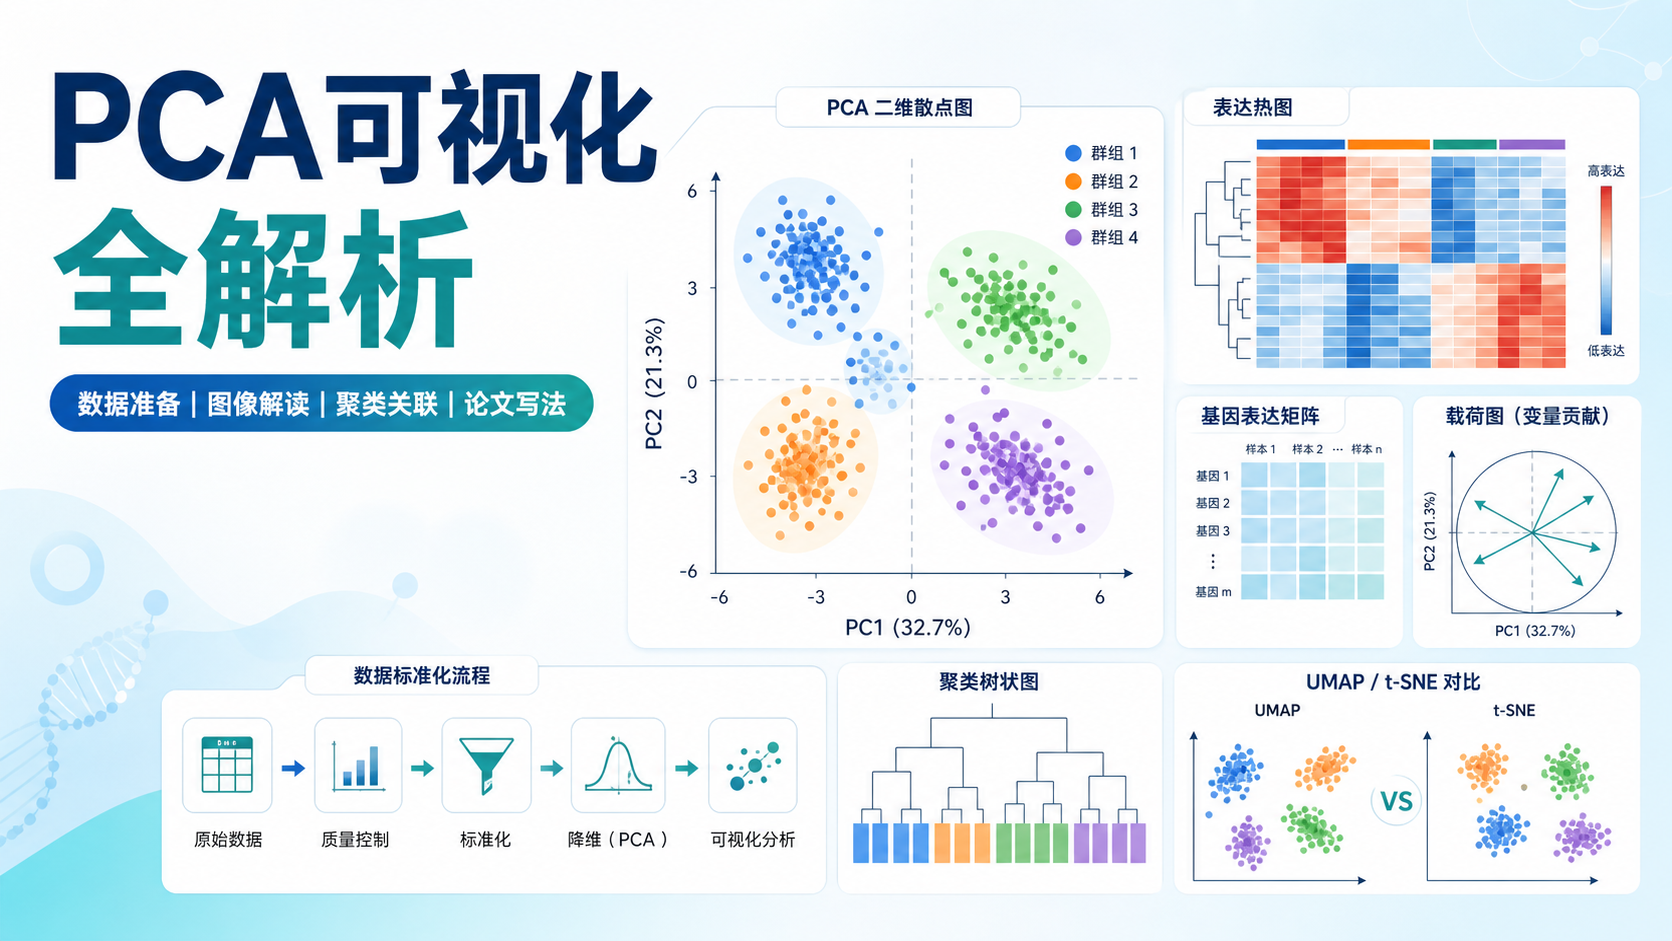
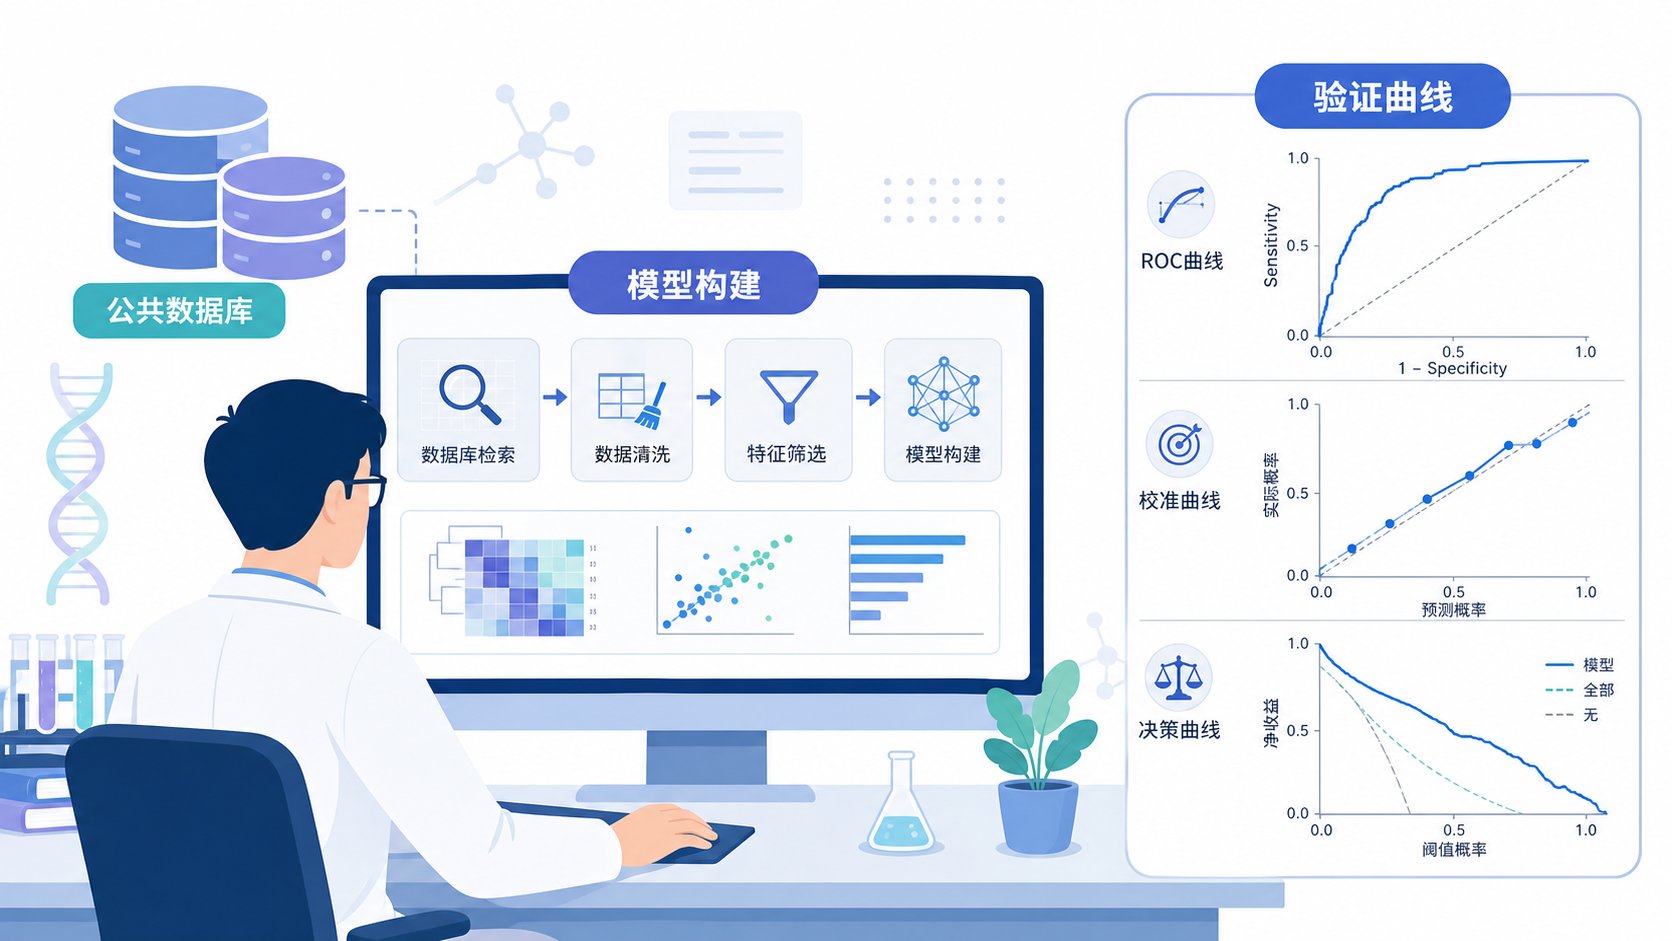
在建模前,很多研究会先做无监督降维 。它的作用不是直接给出结论,而是帮助识别样本结构和潜在分群。
常见方法包括 PCA、t-SNE、UMAP 等。
无监督降维适合做三件事:
- 看样本是否自然分离。
- 检查数据是否存在批次偏移。
- 为后续分型或特征筛选提供线索。
它的价值在于“先看结构,再谈模型”。
这比直接上监督模型更稳妥,也更符合探索性分析的逻辑。
3.3 模型构建要避免两个常见误区
第一个误区,是变量太多,样本太少。
这会导致过拟合。训练集效果很好,验证集明显下降。
第二个误区,是只看AUC,不看校准和临床实用性。
一个模型如果只是区分能力高,但校准差、决策价值低,临床意义仍然有限。
因此,建模阶段至少要关注三类指标:
- 区分度。
- 校准度。
- 临床净获益。
模型不是“能跑出来”就够了,而是要能解释、能迁移、能落地。
4. 第三步,验证效能,决定文章能走多远
4.1 验证不是附属步骤,而是研究质量的分水岭
很多文章的问题,不在于模型不新,而在于没有验证。
没有验证,结果只能停留在单队列内部。
有验证,才有跨数据集的稳定性证据。
验证通常分三层:
- 内部验证。
- 外部验证。
- 功能或机制验证。
验证越完整,研究的可信度越高。
4.2 效能验证要匹配研究目标
如果研究目标是诊断,就要看敏感度、特异度、ROC 曲线和校准情况。
如果研究目标是预后,就要看生存分析、风险分层和一致性。
如果研究目标是机制关联,就不能只停留在统计相关。
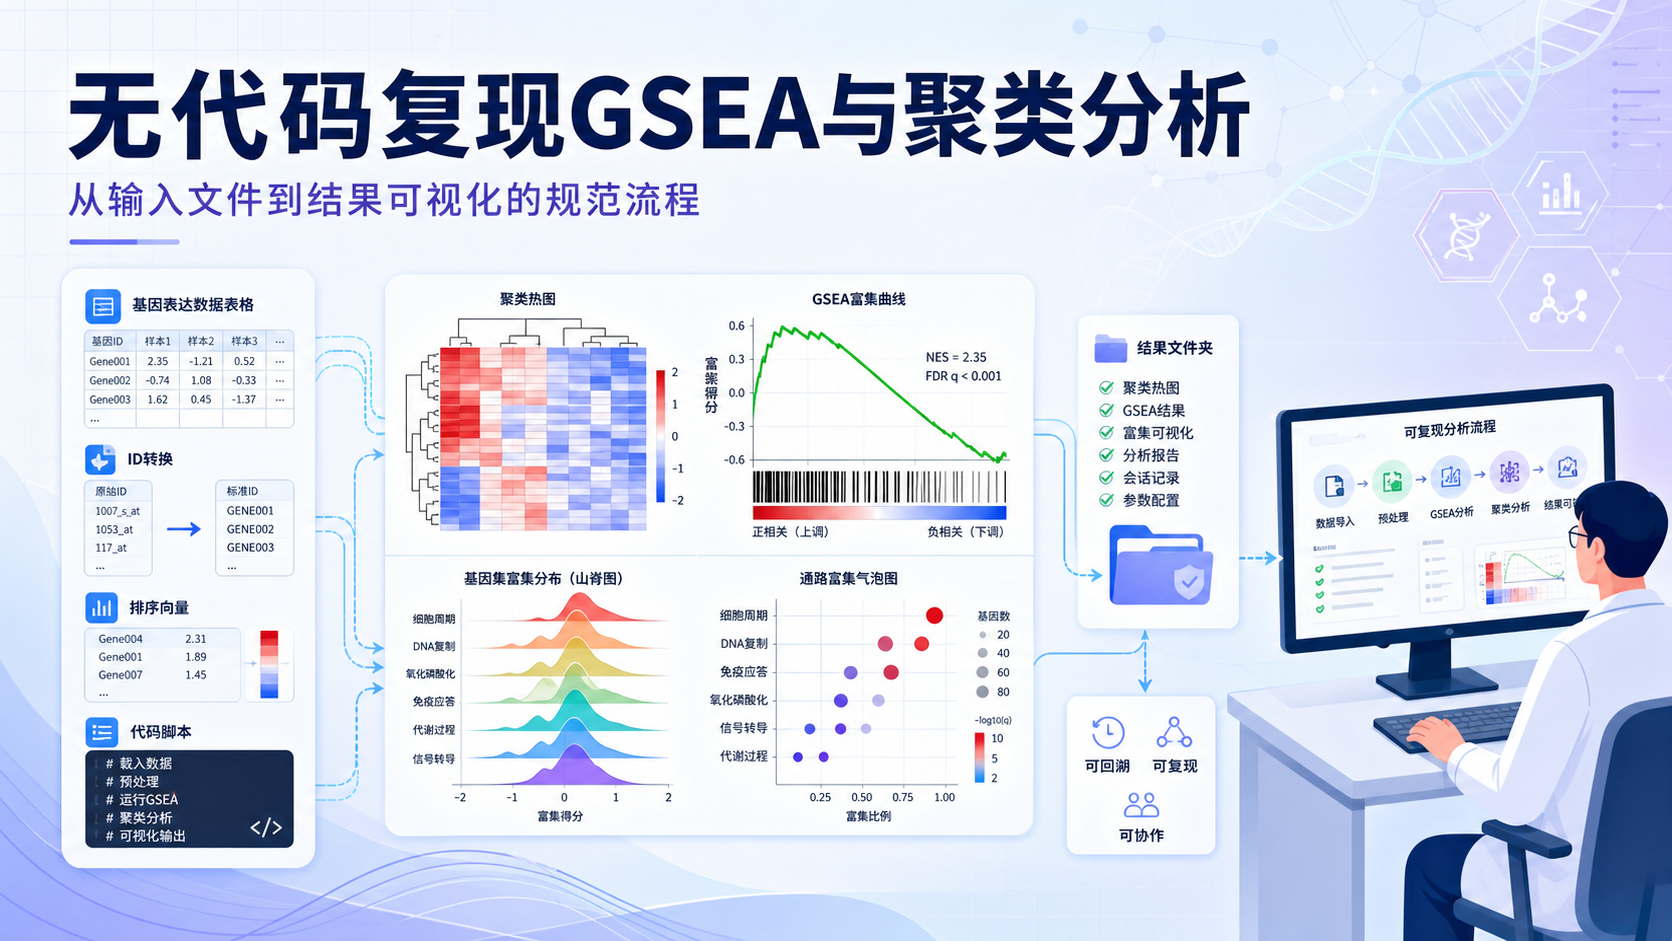
还要看通路富集、交互网络,甚至结合实验验证。
这类设计能把“相关”推进到“可能机制”。
4.3 数据集外验证,是提升文章层级的关键
单一数据集能完成初步发现,但难以支撑高稳定性结论。
如果能在独立队列中重复观察到同样趋势,文章说服力会明显提高。
外部验证的意义,不是多做一步,而是把偶然性降下来。
这对临床转化尤其重要。因为临床问题最怕的,就是“在本队列有效,换队列失效”。
5. 从套路到策略,如何把三步走真正落地
5.1 先做问题拆解,再选分析模块
生信研究最怕的不是不会分析,而是方向选错。
建议先按以下顺序拆解:
- 疾病问题是什么。
- 数据特征是什么。
- 终点是什么。
- 需要哪类验证。
然后再决定是做差异分析、功能聚类、交互网络,还是临床模型。
不要先选工具,再倒推问题。
5.2 复现成熟套路,比盲目创新更高效
对于初学者,最稳妥的方法是先复现成熟文章。
重点不是照抄结果,而是理解其逻辑链条:
- 用了什么数据。
- 怎么清洗。
- 怎么筛特征。
- 怎么建模。
- 怎么验证。
把这些步骤拆开,你会更容易形成自己的研究模板。
这也是很多高产研究者常用的路径。
5.3 解螺旋可以帮助你把流程做顺
如果你希望把“采数据、建模型、验证效能”变成标准流程,关键在于少走弯路。
解螺旋的价值,就在于帮助研究者更高效地完成数据整理、分析思路梳理和结果呈现。
对于想提升生信研究效率的人来说,这类工具能明显缩短前期摸索时间,把更多精力放在问题设计和结果解释上。
总结Conclusion
生信研究的新范式,不是单纯多做几张图,而是建立起从数据到模型、再到验证的完整闭环。采数据决定下限,建模型决定结构,验证效能决定上限。
对医学生、医生和科研人员来说,掌握这一逻辑,比记住某个单独算法更重要。先把研究设计做稳,再谈复杂分析,文章质量才会真正提升。若你希望进一步提升生信研究效率,可以结合解螺旋的工具和方法,把这套三步走流程落到实处。
- 引言Introduction
- 1. 为什么生信研究必须走“三步走”范式
- 2. 第一步,采数据,先决定研究上限
- 3. 第二步,建模型,把相关性变成结构化证据
- 4. 第三步,验证效能,决定文章能走多远
- 5. 从套路到策略,如何把三步走真正落地
- 总结Conclusion