35
 分享
引言Introduction
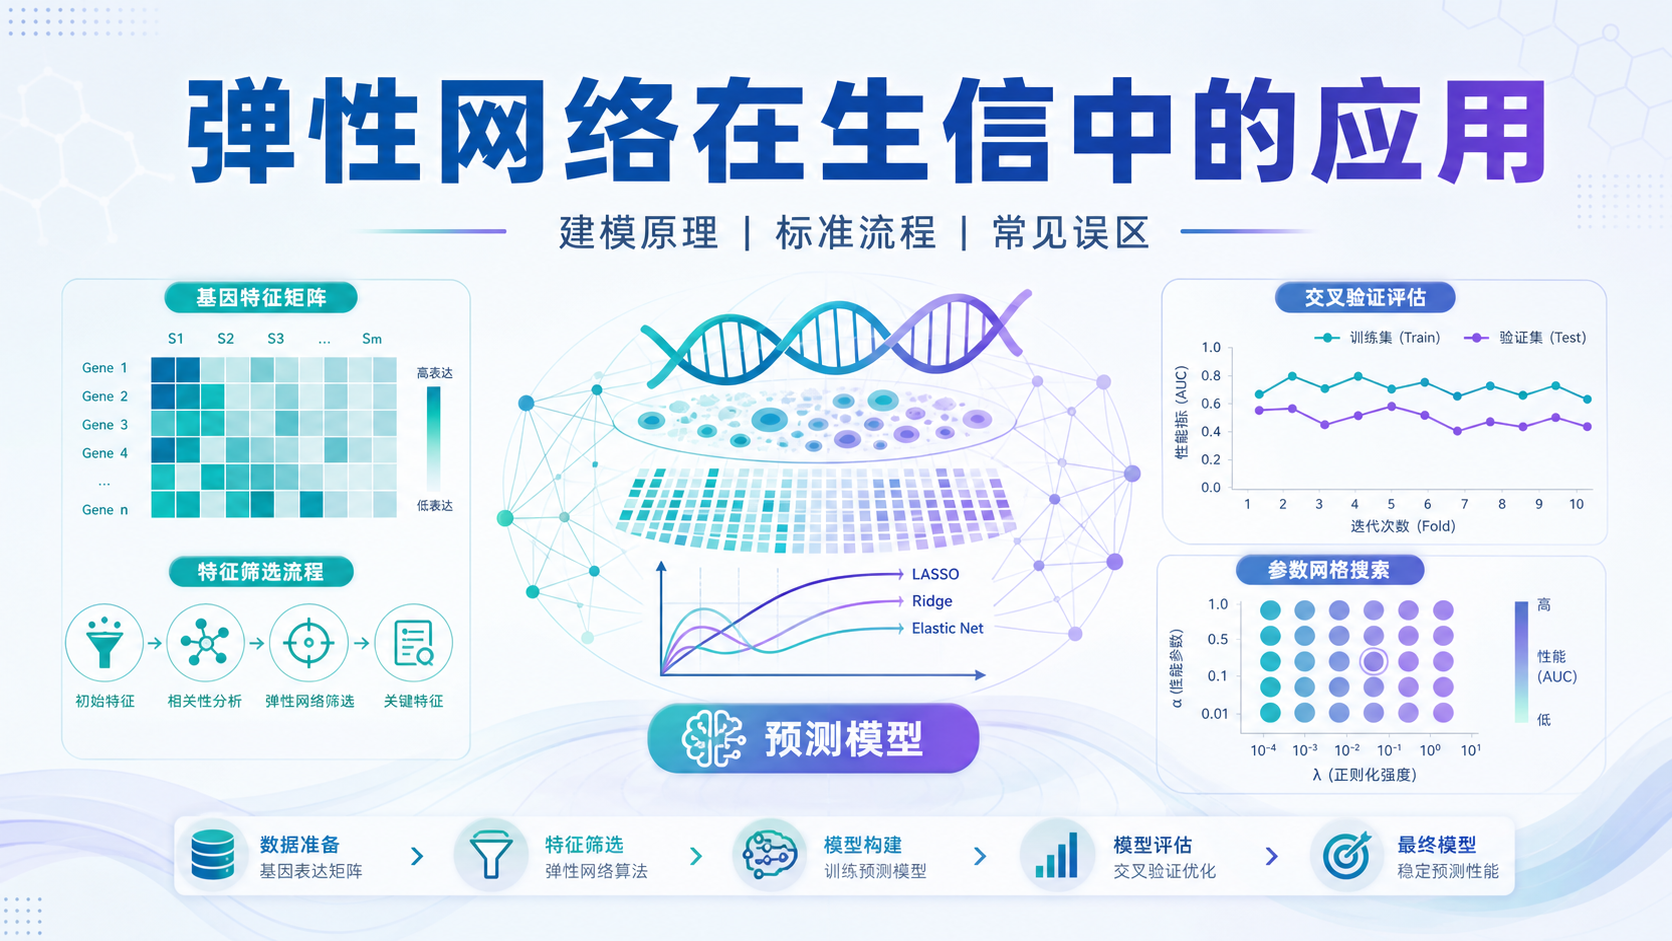
在生信数据分析中,自变量多、共线性强、样本少,是最常见的难题。普通回归容易不稳定,LASSO会过度筛选,岭回归又不够稀疏。弹性网络建模 正好处在两者之间,适合基因筛选、分类建模和特征压缩。
1. 弹性网络建模为什么适合生信数据
1.1 高维小样本是生信的常态
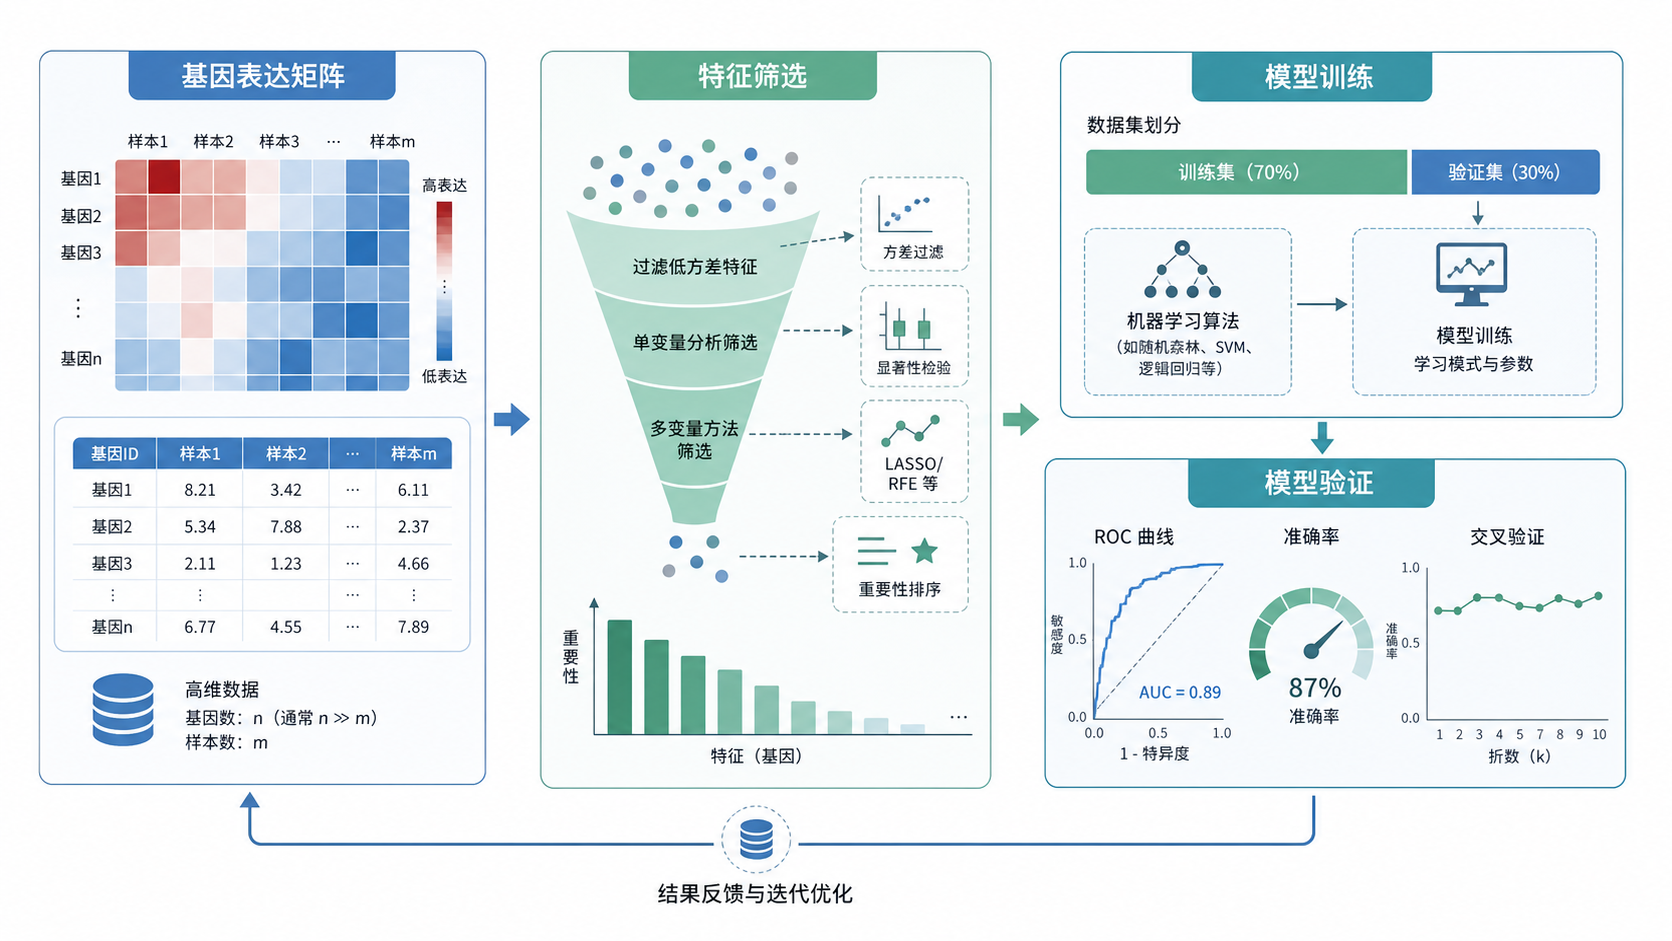
在转录组、甲基化、蛋白组和单细胞数据中,常见情况是“变量远多于样本”。例如,几百个样本对应上千甚至上万个特征。此时如果直接做普通线性回归,模型很容易出现过拟合。
弹性网络建模的价值,在于同时处理“筛变量”和“保稳定”两个目标。
它把岭回归的L2惩罚和LASSO的L1惩罚结合起来,既能压缩系数,又能保留一部分相关特征。
1.2 比单一正则化更适合相关基因成组出现的场景
生信数据里,基因之间往往存在共表达或功能耦联。LASSO在强相关特征之间容易“只留一个”,结果不稳定。
弹性网络则更容易保留一组相关变量。这对通路分析、分型建模、预后特征筛选都更友好。
1.3 适合做分类,也适合做特征压缩
在临床分组、疾病状态识别、二分类预测中,弹性网络常作为第一轮筛选工具。
它尤其适合以下任务:
- 高维表达矩阵的初筛。
- 二分类结局建模。
- 与后续机器学习联用。
- 降低冗余变量带来的噪声。
对生信研究来说,它不是终点,而是高质量特征选择的起点。
2. 弹性网络的核心原理
2.1 alpha 和 lambda 分别控制什么
弹性网络的关键参数有两个。
- alpha :控制L1与L2的混合比例,取值在0到1之间。
- lambda :控制惩罚强度,数值越大,系数压缩越明显。
当 alpha 接近0时,更像岭回归。
当 alpha 接近1时,更像LASSO。
弹性网络的本质,就是在 alpha 和 lambda 的组合空间中寻找最优解。
2.2 为什么要同时搜索两个参数
只调 lambda,模型空间不够完整。
只固定 alpha,也可能错过更优组合。
因此常见做法是先建立一个参数网格,再做交叉验证筛选。
例如,可以用 alpha 在0到1之间按0.1递增,lambda 在某个范围内按步长扫描。这样会形成多个候选组合。
模型比较的不是单个参数,而是“参数组合 + 交叉验证表现”。
2.3 结果评价不能只看系数,还要看验证指标
在分类任务中,常见评价指标包括:
- Accuracy,准确率。
- Kappa,一致性指标。
- AUC,曲线下面积。
- 灵敏度和特异度。
在训练阶段,最优模型通常不是系数最少的那个,而是验证表现最稳定的那个。
这也是弹性网络比简单手工筛选更可靠的原因。
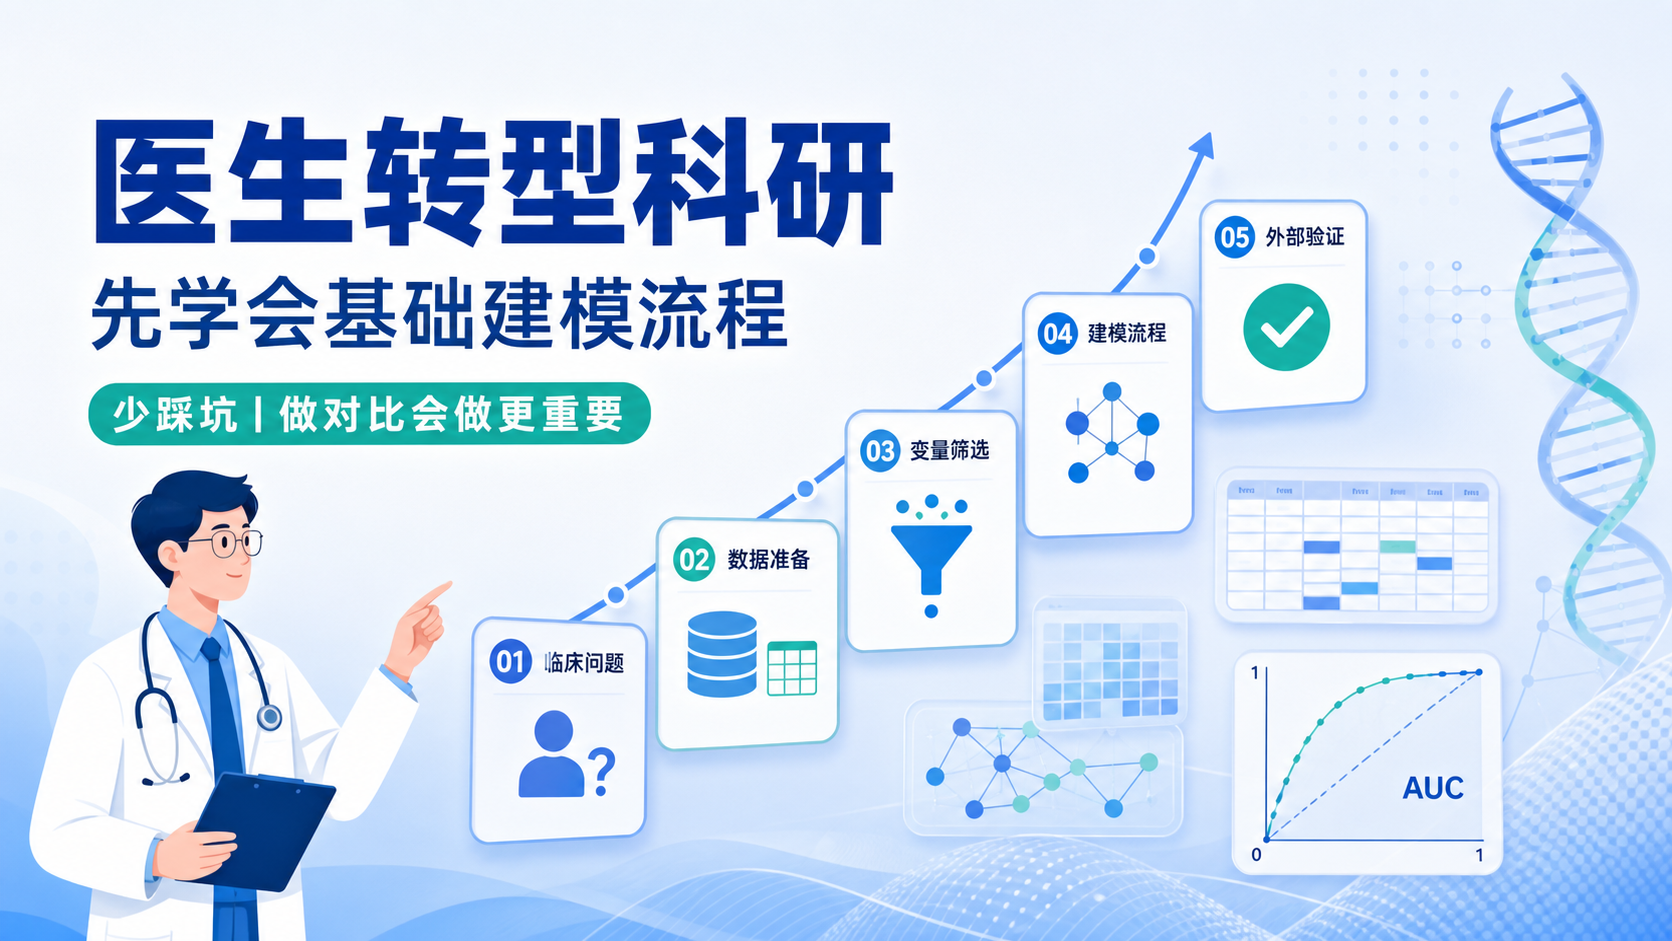
3. 生信中弹性网络建模的标准流程
3.1 先明确因变量类型
在建模前,先检查结局变量。
如果做的是二分类任务,因变量必须处理为因子型。
如果把分类结局误当作连续变量,结果会失真。
这一点在生信分析中很重要。尤其是病例对照分组、是否复发、是否转移这类结局,必须先规范编码。
3.2 再准备自变量矩阵
自变量通常来自表达矩阵、差异基因、WGCNA模块基因或文献候选基因。
建模前建议完成以下步骤:
- 去除缺失严重的变量。
- 去除低方差特征。
- 必要时进行标准化。
- 保证样本与特征顺序一致。
弹性网络对变量尺度敏感,标准化几乎是必做步骤。
3.3 用交叉验证寻找最优参数组合
常见做法是采用交叉验证,甚至留一法。
在样本量不大时,留一法能充分利用每个样本,但计算量更高。
样本较多时,5折或10折交叉验证通常更高效。
模型训练后,可以比较不同 alpha 和 lambda 下的验证结果。
筛选标准要基于交叉验证表现,而不是主观判断。
3.4 用最优参数重新拟合模型
找到最优组合后,再用该组合重新拟合最终模型。
随后提取非零系数变量,作为候选标志物或建模特征。
在论文写作中,这一步通常对应:
- 特征压缩结果。
- 最终模型公式。
- 候选基因列表。
- 后续外部验证对象。
4. 弹性网络在生信研究中的常见应用场景
4.1 生物标志物筛选
在差异分析后,候选基因常常仍然很多。
弹性网络可进一步压缩变量,保留最有解释力的一组特征。
这类结果常用于疾病诊断、分型预测和风险评估。
4.2 预后模型构建
对于生存相关研究,弹性网络常与Cox回归联用。
先通过正则化筛变量,再进入多因素模型,可减少共线性影响。
这比直接把全部候选基因扔进多因素模型更稳健。
4.3 模块基因与临床表型关联
在WGCNA得到模块后,可以把模块基因导入弹性网络。
这样做的优点是,既保留模块层面的生物学意义,又减少冗余变量。
它适合从“相关模块”进一步走向“可解释的候选特征”。
4.4 多组学整合建模
在整合转录组、蛋白组和临床特征时,变量维度会更高。
弹性网络可作为特征压缩层,帮助保留稳定信号,减少噪声干扰。
在多组学场景下,它特别适合做第一轮统一筛选。
5. 实操中最容易出错的地方
5.1 把分类结局当连续变量
这是最常见错误之一。
尤其在二分类任务中,如果结局变量没有正确转为因子型,模型含义会偏离。
建模前必须检查变量类型。
5.2 忽略标准化
不同量纲会影响惩罚项。
如果不标准化,系数惩罚会偏向尺度大的变量。
这会导致模型选择失真。
5.3 过度依赖单次划分结果
一次训练测试拆分不能代表真实泛化能力。
更稳妥的做法是交叉验证、重复抽样,或外部数据集验证。
没有验证的模型,不能称为稳定模型。
5.4 只看准确率,不看类间平衡
如果样本类别不平衡,准确率可能虚高。
这时还应关注 Kappa、AUC、灵敏度和特异度。
对医学研究而言,漏诊和误诊的代价通常不同,不能只看一个指标。
6. 解螺旋视角下的实用建议
6.1 先筛大类,再做精细建模
在真实课题中,建议先用差异分析、WGCNA或文献证据缩小范围,再进入弹性网络。
这样能降低噪声,提高模型解释性。
不是所有变量都值得直接进入正则化模型。
6.2 让模型服务于问题,而不是反过来
生信建模的目标,不只是得到一个“好看”的结果。
更重要的是回答临床问题:
- 哪些变量最关键。
- 这些变量是否稳定。
- 是否有外部验证。
- 能否形成可复现的分析链条。
6.3 想提高效率,可以借助标准化分析流程
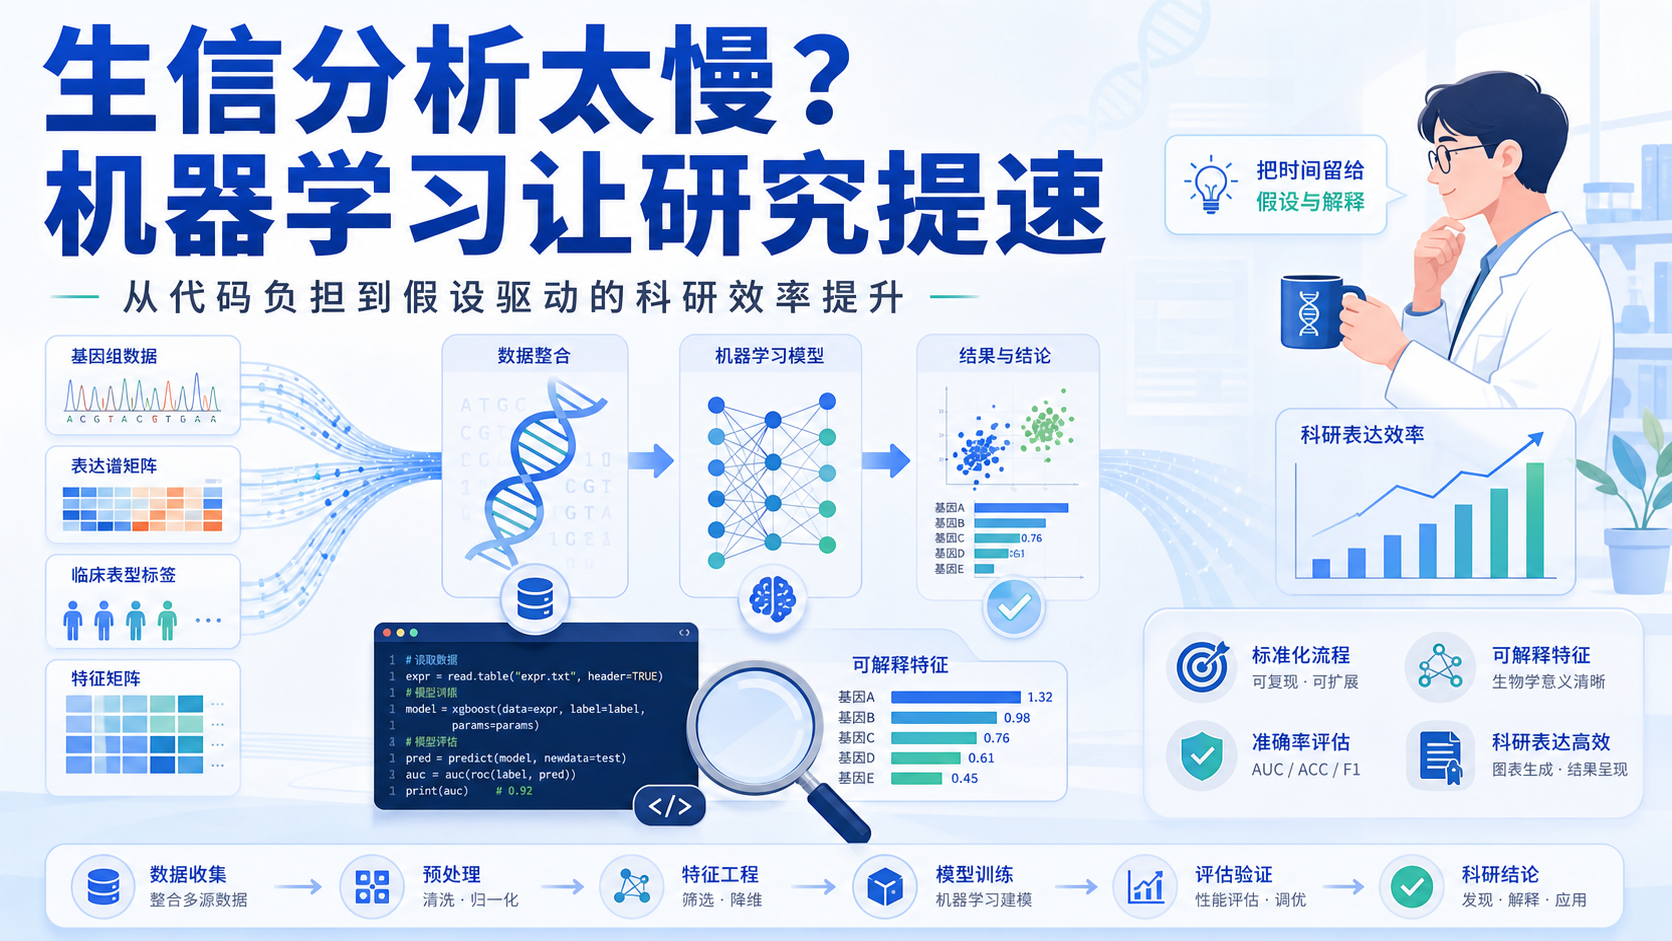
对于医学生、医生和科研人员来说,最耗时的往往不是建模本身,而是前期整理和参数选择。
如果你希望把弹性网络建模、特征筛选、交叉验证和结果展示串成一套更高效的流程,可以借助解螺旋提供的生信分析支持,减少重复试错,把精力集中在课题设计和结果解释上。
高质量生信分析,核心是流程规范、参数合理、结果可复现。
总结Conclusion
弹性网络建模是生信数据分析中的高阶工具。它兼顾变量筛选与模型稳定性,特别适合高维、小样本、强相关的研究场景。对于基因筛选、分型建模和预后分析,它都能提供更稳健的特征压缩方案。
如果你正在做生信课题,想提升建模效率和结果可信度,可以进一步了解解螺旋的专业支持,让分析流程更规范,输出更接近发表标准。
- 引言Introduction
- 1. 弹性网络建模为什么适合生信数据
- 2. 弹性网络的核心原理
- 3. 生信中弹性网络建模的标准流程
- 4. 弹性网络在生信研究中的常见应用场景
- 5. 实操中最容易出错的地方
- 6. 解螺旋视角下的实用建议
- 总结Conclusion