44
 分享
引言Introduction
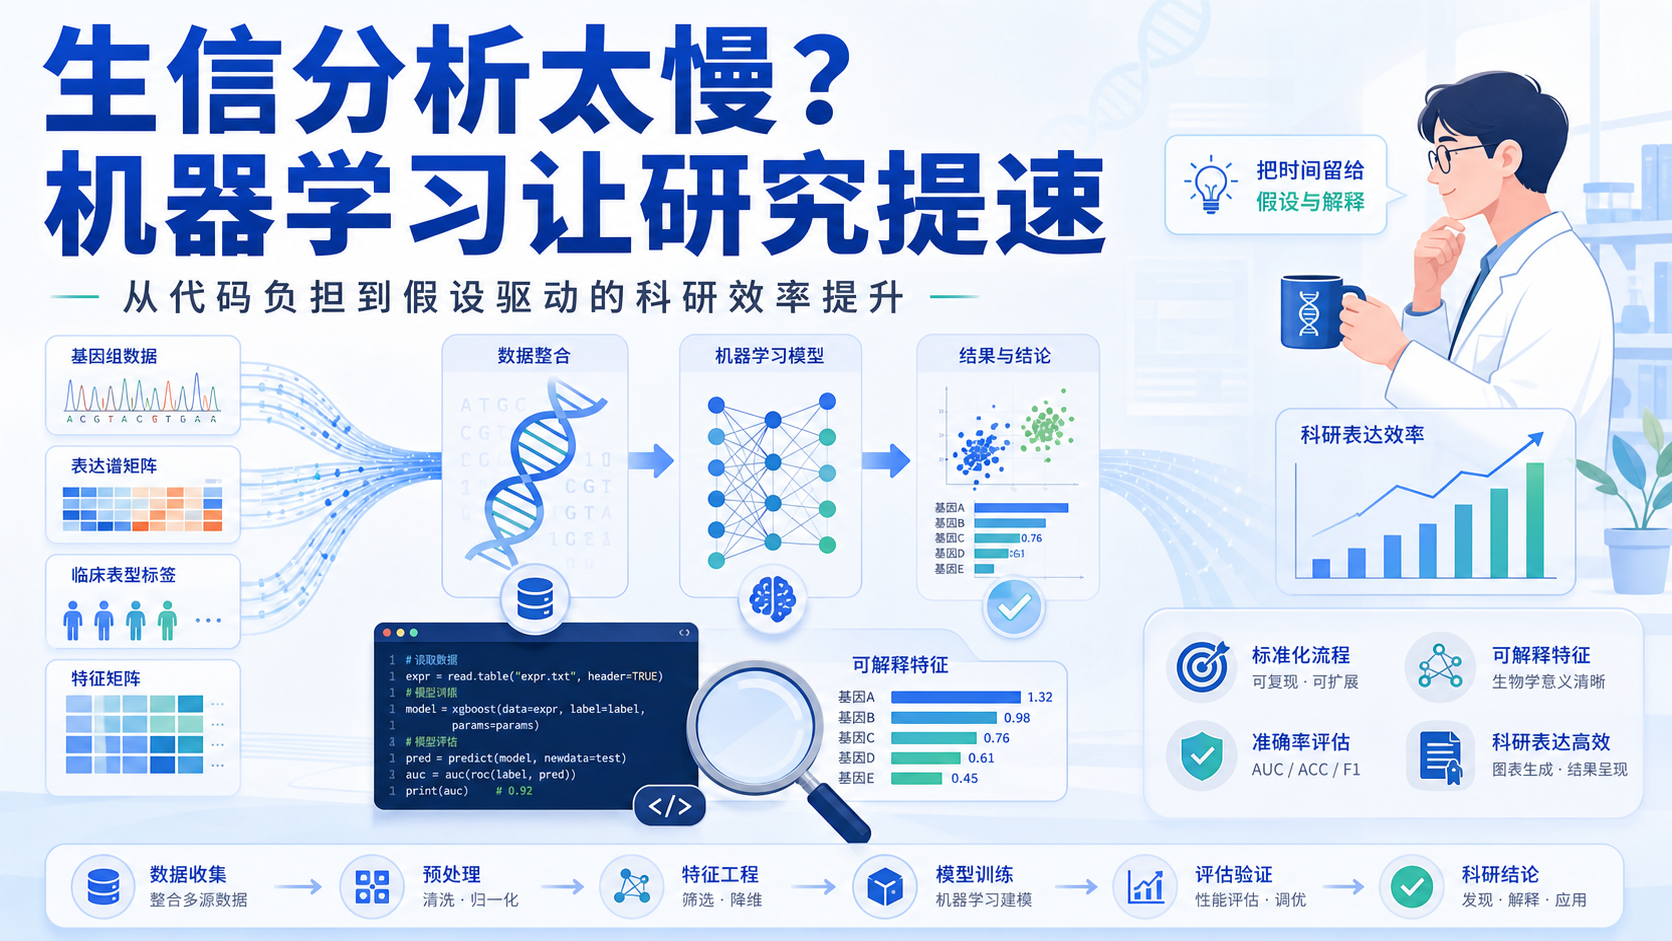
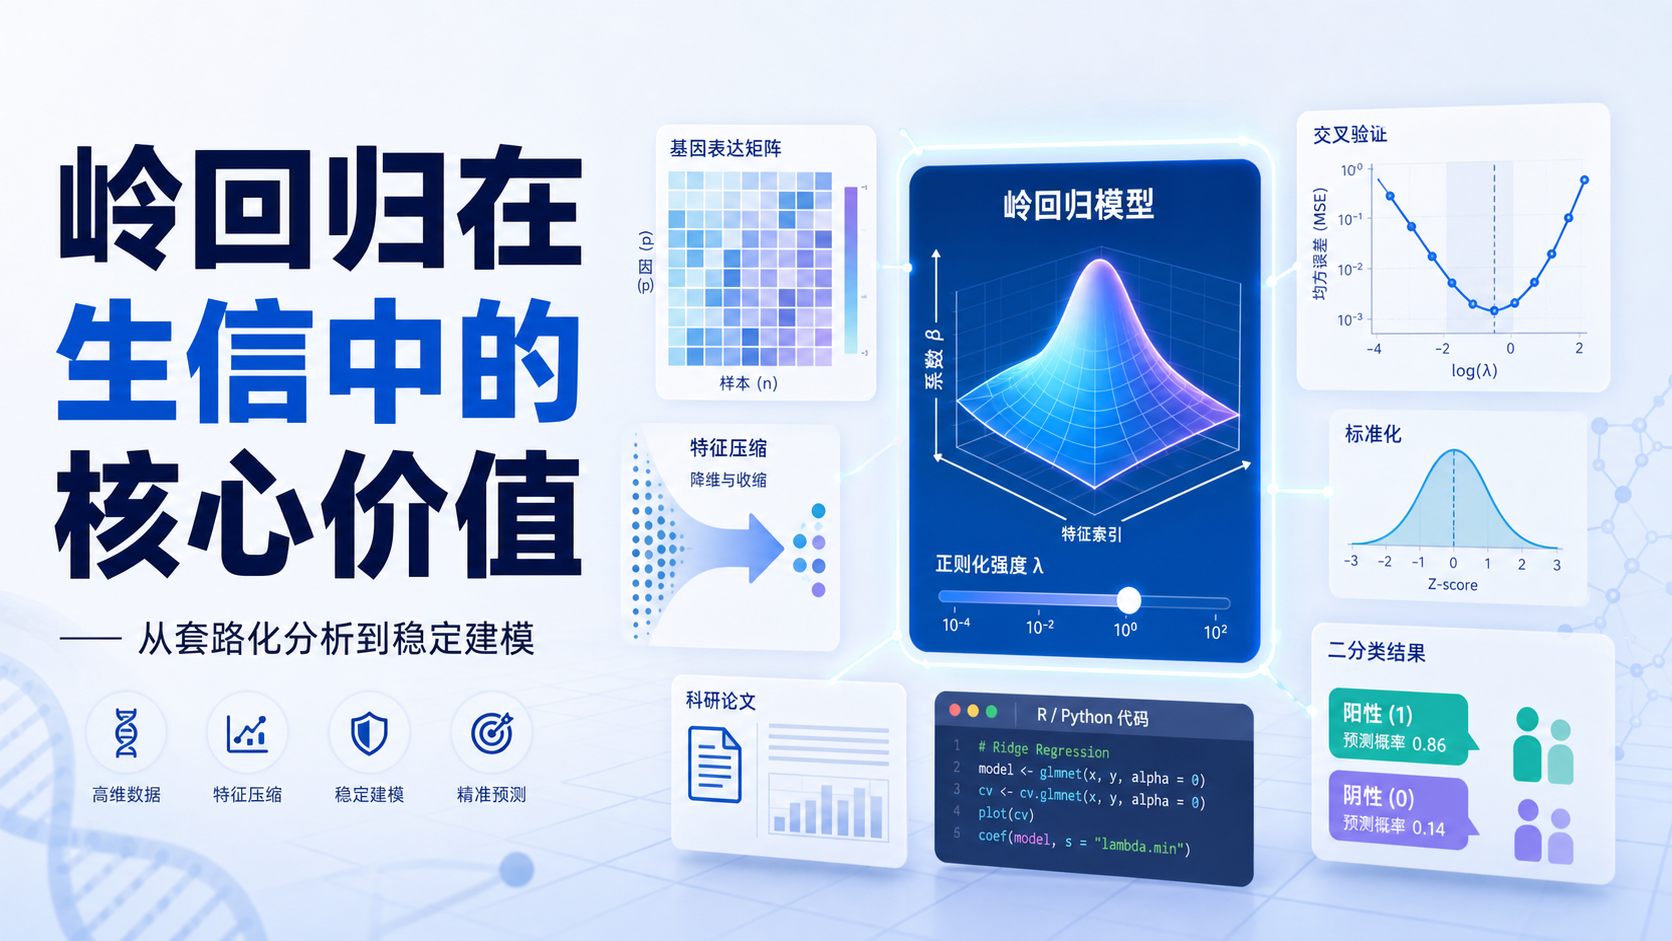
生信文章越来越卷,套路化建模正在快速贬值。如果只会套现成流程,没有自己的数据和真正的变量筛选能力,研究很难形成竞争力。 岭回归建模,正是在高维、共线、噪声多的场景下,帮助研究者把模型做稳、做实的关键方法。
1. 为什么生信套路化研究越来越难发文章
1.1 数据获取门槛正在抬高
现在真正难的,不只是会不会跑代码,而是能不能拿到有价值、可验证、可复现的原始数据 。公开数据库可以做很多分析,但同质化也最严重。大家都用相似队列,相似流程,相似指标,最后结果高度重复。
更现实的问题是,很多研究缺少自己的结局信息、临床随访信息,甚至缺少稳定的样本来源。这样一来,模型即使跑出来,也只是“看起来能用”,很难形成学术创新。
1.2 只做模板化分析会被自动化替代
生信里有一类工作,已经非常接近全流程自动化。比如标准化的数据下载、清洗、差异分析、富集分析、可视化,都可以被脚本和AI快速完成。当流程被自动化之后,套路化研究的边际价值会明显下降。
真正还能拉开差距的,是两类能力。
- 稀缺数据来源。
- 高阶原创方法和更严谨的建模思路。
岭回归建模之所以重要,就是因为它不是简单地“跑一个结果”,而是帮你在复杂变量中建立更稳健的解释框架。
2. 岭回归建模在生信中的核心价值
2.1 适合高维共线场景
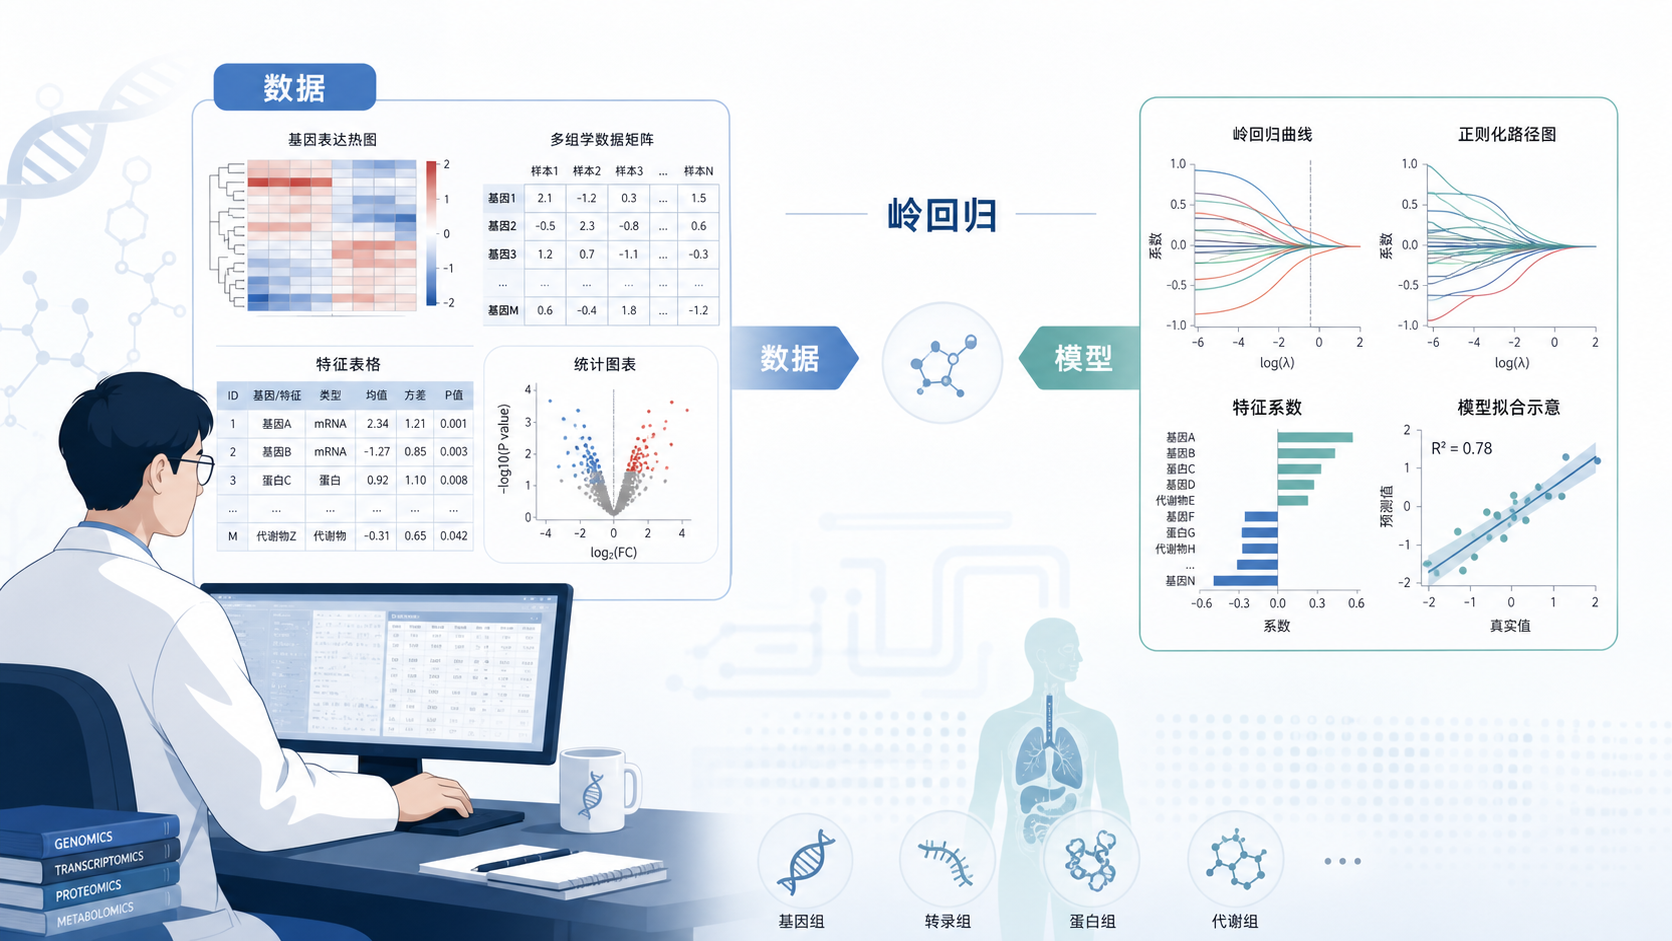
组学数据常见一个问题,变量多,相关性强。比如基因表达矩阵中,多个基因之间可能高度共表达。直接做普通最小二乘回归,系数会不稳定,标准误会被放大,模型泛化能力也差。
岭回归的核心作用,是通过L2惩罚项收缩系数,缓解多重共线性。
它不会像某些方法那样把变量直接压到零,而是保留所有变量,再通过系数大小控制贡献度。
这对生信尤其有意义。因为在真实项目里,很多候选基因都可能有生物学相关性,不能粗暴删掉。
2.2 比“只看显著性”更稳健
很多初学者在做生信建模时,习惯先做单因素筛选,再挑P值最小的变量进入模型。这样做的问题很明显。变量之间的联合效应没有被充分考虑,且结果对样本波动非常敏感。
岭回归更强调整体预测能力,而不是单个变量的孤立显著性。
这使它更适合用于:
- 高维特征筛选。
- 共线性明显的临床和组学联合建模。
- 预测模型的初筛阶段。
从方法学角度看,这种思路更接近“先稳住模型,再谈解释”。
3. 岭回归在生信项目中的典型应用
3.1 基因筛选与特征压缩
在基因表达研究中,候选基因往往几十个、上百个,甚至更多。此时最怕的不是变量少,而是变量太多、噪声太大。岭回归可以在不丢失过多信息的前提下,压缩特征权重,帮助研究者找到更稳定的候选集合。
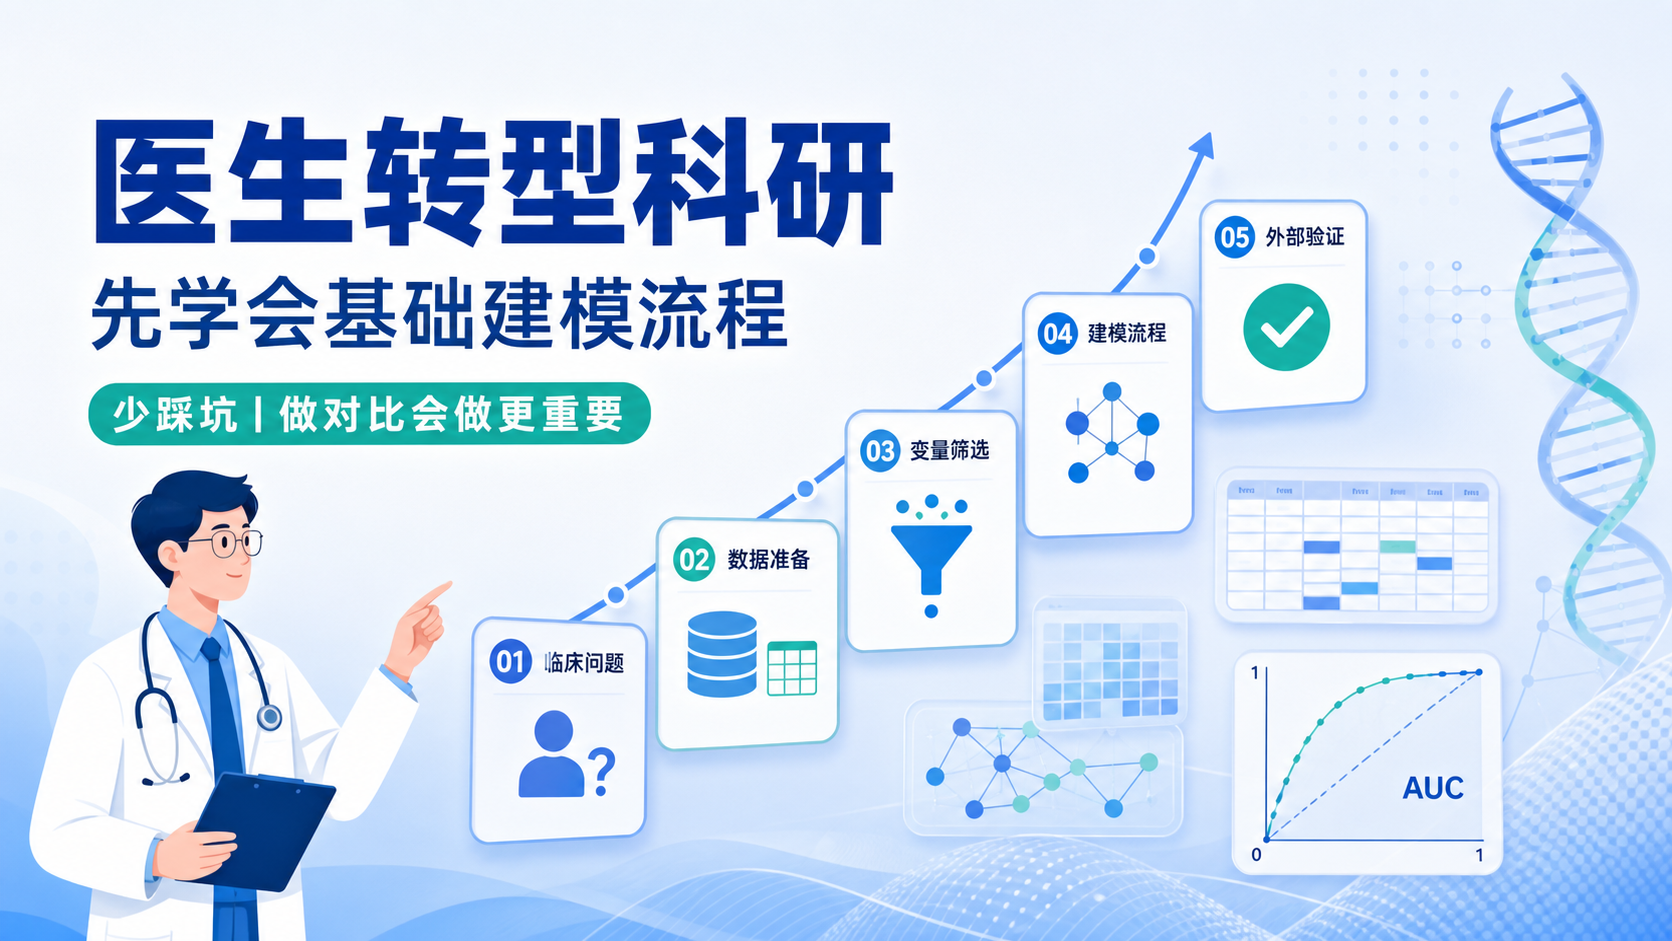
一个常见流程是:
- 准备表达矩阵X。
- 明确结局Y。
- 进行标准化处理。
- 用交叉验证选择最佳lambda。
- 提取系数并构建风险评分或预测模型。
这套流程比单纯依赖P值筛选更适合高维生信数据。
3.2 二分类结局也可以用岭回归
如果没有生存时间,只有结局事件,比如发病与不发病、并发症与无并发症、死亡与生存,这类研究同样可以做岭回归,只是模型形式需要调整。
这时常用的是二分类岭回归,也就是把结局设置为binomial类型。
在实际操作中,研究者需要注意几点:
- X通常仍然是特征矩阵。
- Y不再是Surv对象,而是二分类状态。
- 交叉验证依然很关键。
- 最终提取非零或重要系数后,可进一步构建评分公式。
这说明岭回归不仅适合生存分析,也适合大量非生存类生信课题。
4. 岭回归建模时最容易忽略的几个问题
4.1 标准化是前提,不是可选项
岭回归对变量尺度敏感。不同基因的表达范围可能差异很大,如果不标准化,系数收缩就不公平,模型结果也不稳定。
因此在正式建模前,必须先处理尺度问题。
常见做法包括:
- 对表达矩阵进行标准化。
- 检查异常值。
- 确认样本顺序与结局标签一致。
如果输入数据本身有问题,后面的lambda选择再精细,也只是“在错误数据上做精细化”。
4.2 交叉验证决定模型可信度
岭回归不是把数据一放进去就完事。交叉验证是判断模型是否过拟合的重要步骤。生信项目里常见10折交叉验证,它能帮助我们观察不同lambda下模型误差的变化,进而选择更合理的惩罚强度。
经验上,研究者要重点看两件事:
- 最小误差对应的lambda。
- 在误差更稳健、模型更简洁时是否存在可接受的替代lambda。
模型不是越复杂越好,而是要在拟合能力和泛化能力之间找到平衡。
4.3 不要把“结果图”当成“结论”
很多文章喜欢堆图。LASSO图、ROC图、风险图、热图、校准曲线,看起来很完整,但如果缺少合理的建模逻辑,图再多也只是装饰。
岭回归更强调的是:
- 为什么选择这个模型。
- 为什么这些变量应该进入模型。
- 为什么这个lambda能支持你的结论。
- 结果是否能在独立数据或临床场景中复现。
图是证据,不是结论本身。
5. 岭回归为何能帮助生信研究摆脱“同质化”
5.1 从“找显著”转向“建稳定模型”
过去很多生信文章追求的是“找到几个显著基因”。但现在,单纯显著已经不够了。更重要的是,模型是否稳、能否复用、是否具备解释和预测价值。
岭回归的优势就在这里。它允许研究者面对高维数据时不急于删变量,而是通过惩罚机制控制模型复杂度,最终形成更稳定的特征权重。
这类方法更适合做:
- 预后模型。
- 风险分层。
- 疾病预测。
- 临床辅助决策。
5.2 从公共流程转向真实创新
如果研究只停留在数据库下载、差异分析、GO/KEGG、PPI、再加一个回归模型,文章很容易被归类为套路化工作。
真正的突破点,是你是否掌握了自己的数据、自己的问题、自己的建模路径。
岭回归并不是“神奇算法”,但它提醒我们:
研究的重点不应只是流程是否完整,而应是数据是否真实,问题是否明确,模型是否合理。
对于想提升生信项目质量的团队来说,这种方法论转变非常关键。
6. 如何把岭回归真正用到生信项目里
6.1 先定义问题,再选模型
不要为了建模而建模。
先问清楚你要解决什么问题。
- 是预测生存?
- 是判断是否发病?
- 是筛选稳定特征?
- 还是构建临床评分体系?
问题不同,数据结构不同,模型选择也不同。岭回归适合高维共线场景,但它不是所有问题的第一答案。
6.2 让数据质量先于算法复杂度
一份可信的生信项目,通常先从数据质量入手。样本量、缺失值、分组一致性、标签准确性,这些都比单一模型技巧更重要。
建议优先检查:
- 样本是否匹配。
- 结局标签是否一致。
- 特征是否存在严重缺失。
- 是否存在批次效应。
- 是否需要标准化或去噪。
数据基础越扎实,岭回归的价值越容易发挥出来。
6.3 用可复现流程支撑结论
对医学生、医生和科研人员来说,最有价值的不是“会不会点按钮”,而是能不能复现、能不能解释、能不能迁移。
这也是当前生信竞争的核心。
如果你希望把岭回归建模真正落到项目里,建议使用更成熟的工具和结构化流程。像解螺旋 这类平台,可以帮助研究者更高效地完成数据整理、建模思路梳理和结果输出,减少重复试错,把精力集中在真正的科学问题上。
总结Conclusion
生信研究正在从“模板化分析”走向“方法与数据并重”。岭回归建模的价值,不只是筛变量,更是帮助研究者在高维、共线、噪声复杂的场景中建立更稳健的模型。 对医学生、医生和科研人员来说,真正的竞争力不在于流程跑得快,而在于数据是否真实、问题是否清晰、模型是否可靠。
如果你正在做高维组学、临床预测或特征筛选,岭回归建模值得成为你的基础工具。想让项目少走弯路、提高可复现性,并把分析真正转化为可发表、可解释的结果,可以进一步了解解螺旋 ,让专业流程帮助你把生信做得更稳、更准、更有创新性。
- 引言Introduction
- 1. 为什么生信套路化研究越来越难发文章
- 2. 岭回归建模在生信中的核心价值
- 3. 岭回归在生信项目中的典型应用
- 4. 岭回归建模时最容易忽略的几个问题
- 5. 岭回归为何能帮助生信研究摆脱“同质化”
- 6. 如何把岭回归真正用到生信项目里
- 总结Conclusion