107
 分享
引言Introduction
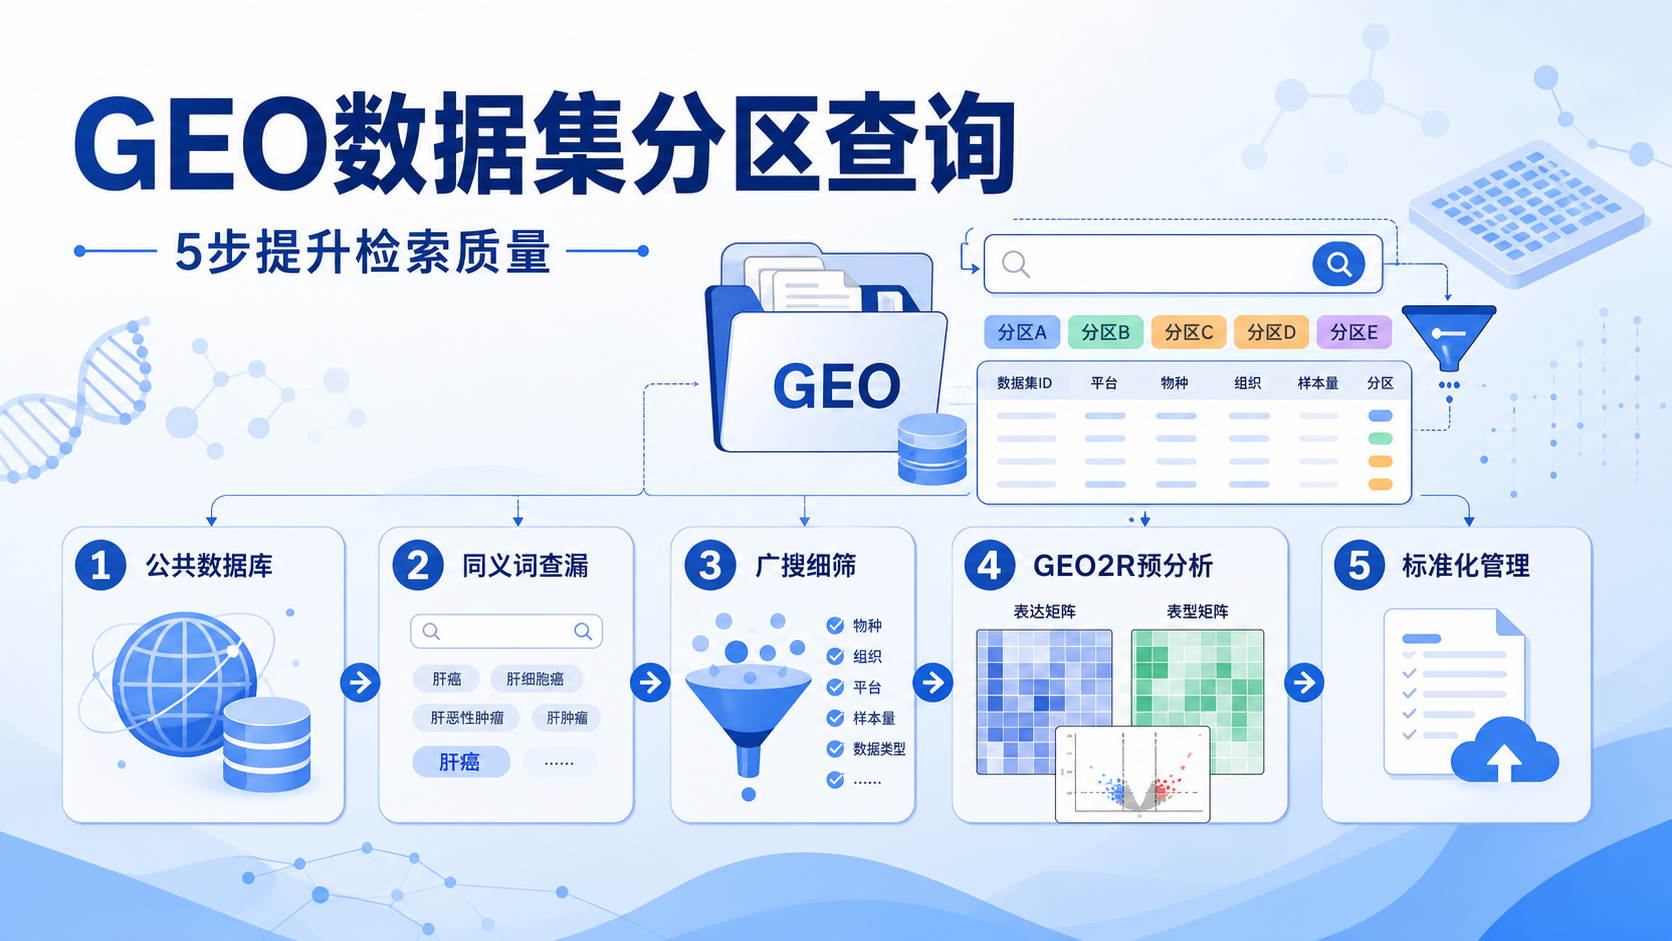
GEO数据量大,检索词多,重复结果也多。很多医学生和科研人员在找数据集时,常常卡在“找不全、筛不准、整理乱”这三步。分区查询工具的价值,就是把检索拆成可执行的分层流程,减少漏检,提高效率。

1. GEO数据集为什么需要分区查询
1.1 公共数据库的核心价值
GEO,全称是 Gene Expression Omnibus database,属于美国主导建立的公共数据共享平台。它的出现,本质上是为了降低重复测序和重复芯片分析带来的资源浪费。对于同一疾病方向,前人已积累大量样本和表达数据,直接利用这些数据,可以明显提升研究启动速度。
对研究者来说,GEO不是“随便搜几个GSE号”就结束,而是一个需要系统管理的资源库。 如果检索不分层,很容易出现两个问题。第一,漏掉关键数据集。第二,混入大量不相关样本,影响后续分析质量。
1.2 GEO数据结构决定了查询方法
GEO数据库常用的两类子库是 GEO DataSets 和 GEO Profiles。前者以数据集为单位,后者以基因为单位,适合查看某个基因在不同数据集中的表达谱。除此之外,GEO还包含 platform、Samples、Series、DataSets、Profile 等数据类型。
真正高效的做法,是先用 Series 级别找数据集,再逐步下钻到样本和表达矩阵。 这样既能保留全局视角,也方便后续做差异分析、交叉验证和文献比对。
2. 分区查询工具的核心思路
2.1 什么是分区查询
这里的“分区查询工具”,并不是单一软件名,而是一套查询策略。核心是把一次性检索拆成多个分区。每个分区负责解决一个问题,例如普筛、查漏、加限定词、补缺、文献核对。
这种方法的目标不是“最快得到一个结果”,而是“尽量得到一个完整且可复用的数据集列表”。 对医学生、医生和科研人员而言,这一点非常重要,因为后续很多课题都依赖同一批基础数据。
2.2 典型的5步查询流程
GEO检索一般至少分为5步:
- 普筛。 用宽泛词检索,例如 HCC。
- 查漏。 用同义词重复检索,例如 liver cancer、hepatocellular carcinoma。
- 添加限定词。 例如 HCC normal,用于锁定肿瘤和正常对照。
- 查缺补漏。 再检查未命中的数据集,补入列表。
- PubMed核对。 搜索疾病名加 GEO,检查已发表文章用过哪些数据集。
这个流程的意义在于,不同分区负责不同层面的召回率和准确率平衡。 先广后窄,再回看补全,才能降低漏检风险。
3. 最佳实践:如何用分区方式提升检索质量
3.1 先广搜,再细筛
第一步不要急着加太多条件。以肝细胞癌为例,可以先搜 HCC,再限定为 Series 和人类数据。然后先看题目是否相关,再看样本量是否足够。一般来说,低于6个样本的数据集通常不适合直接用于稳健的差异分析。
建议建立一个Excel表格,记录初筛通过的 GSE 编号。这样做的好处是,后面查漏、查缺补漏时可以直接比对,不会反复回到同一页面。
3.2 用同义词做查漏
很多人只搜一个词,结果漏掉大量可用数据。比如 HCC 之外,还可能写作 liver cancer 或 hepatocellular carcinoma。数据库作者的命名习惯并不统一,所以同义词扩展是提高召回率的关键步骤。
实际操作中,建议每个研究方向至少准备3到5个核心检索词。每次检索都把结果补进同一个列表里,再去重、再筛选。这样效率远高于“搜一次就定稿”。
3.3 限定词要服务研究问题
限定词的作用,是把范围从“疾病相关”进一步缩小到“可分析”。例如做肿瘤与正常对比时,可以加入 normal 作为限定词。这样更容易快速筛到符合实验设计的数据集。
但要注意,限定词不是越多越好。 过多限定会压低召回率,导致遗漏。最佳做法是先用最少限定词找到候选集,再逐步收窄,而不是一开始就把条件加满。
4. GEO2R在线工具与分区查询的衔接
4.1 GEO2R适合快速预分析
GEO2R 是 GEO 提供的在线差异分析工具,适用于支持 GEO2R 的 Series 数据集。判断方法很简单,进入对应 GSE 页面后,如果能看到 “analyze with GEO2R” 按钮,说明该数据集可直接进行在线分析。
GEO2R 的优势是快,适合预筛和验证。 你可以先定义实验组和对照组,再运行分析,查看火山图、密度图、韦恩图等可视化结果。
4.2 分组设置决定分析质量
在 GEO2R 中,分组是第一关键步骤。需要根据样本来源、组织类型和实验设计,把样本准确分入实验组和对照组。选样本时可结合 Ctrl 和 Shift 多选,提高效率。
完成后点击 Analyze,就能得到差异基因列表。结果页面通常会显示前250个差异基因,也可下载完整表格。对于正式分析,建议优先下载完整表格,再用 Excel 进一步筛选。 这样更利于控制阈值,也便于保留原始信息。
4.3 推荐从完整表格筛选
从实操经验看,直接从火山图页面下载显著基因,信息往往不够完整,且阈值调整不够灵活。更稳妥的方式是:
- 下载完整表格。
- 用 Excel 筛选校正后 p 值,小于0.05。
- 再按 logFC 设阈值,常用的是绝对值≥1。
- 根据结果数量再微调阈值。
如果结果太多,就提高阈值。如果结果太少,就适当放宽。 这比一次性锁死参数更符合科研实际。
5. 数据集管理的标准化方法
5.1 建立长期可复用的列表
当某个方向的数据集筛选完成后,不要只保存在浏览器记录里。建议固定保存 Excel 清单,包括 GSE 编号、疾病名称、样本类型、分组信息、样本量、是否支持 GEO2R 等字段。
这样做的价值很高。以后写综述、做meta分析、做验证实验,都可以直接复用。一个维护良好的数据集列表,往往比临时检索更有研究价值。
5.2 同步提取表达矩阵和表型矩阵
如果时间允许,最好把表达矩阵和表型矩阵一起整理出来。表达矩阵用于后续差异分析、富集分析和机器学习建模,表型矩阵用于分组、临床变量比对和亚组分析。
这一步看似繁琐,但会显著提升后续效率。尤其是多数据集整合时,提前整理好的矩阵可以减少重复下载和重复清洗。
5.3 解螺旋如何帮助提高效率
如果你希望把这些流程进一步标准化,解螺旋 可以帮助你更快完成 GEO 数据集的检索、整理和后续分析衔接。对于需要批量筛选、比对和沉淀数据集列表的课题,标准化工具和规范流程能明显减少重复劳动,让你把时间更多放在研究设计和结果解释上。
总结Conclusion
GEO数据集查询的难点,不在“能不能搜到”,而在“能不能搜全、筛准、管好”。分区查询工具的本质,是把一次模糊检索拆成普筛、查漏、限定、补缺和文献核对五个步骤。这套流程更适合科研场景,也更符合高质量数据挖掘的要求。
对于医学生、医生和科研人员来说,真正值得长期积累的,不只是某一次检索结果,而是一套可复用的数据集管理体系。建议从今天开始,建立自己的GEO列表,配合GEO2R和Excel筛选,形成稳定工作流。若你希望进一步提升效率,可以尝试使用解螺旋 ,把分散的查询和整理任务变成可持续复用的研究流程。
- 引言Introduction
- 1. GEO数据集为什么需要分区查询
- 2. 分区查询工具的核心思路
- 3. 最佳实践:如何用分区方式提升检索质量
- 4. GEO2R在线工具与分区查询的衔接
- 5. 数据集管理的标准化方法
- 总结Conclusion