93
 分享
引言Introduction
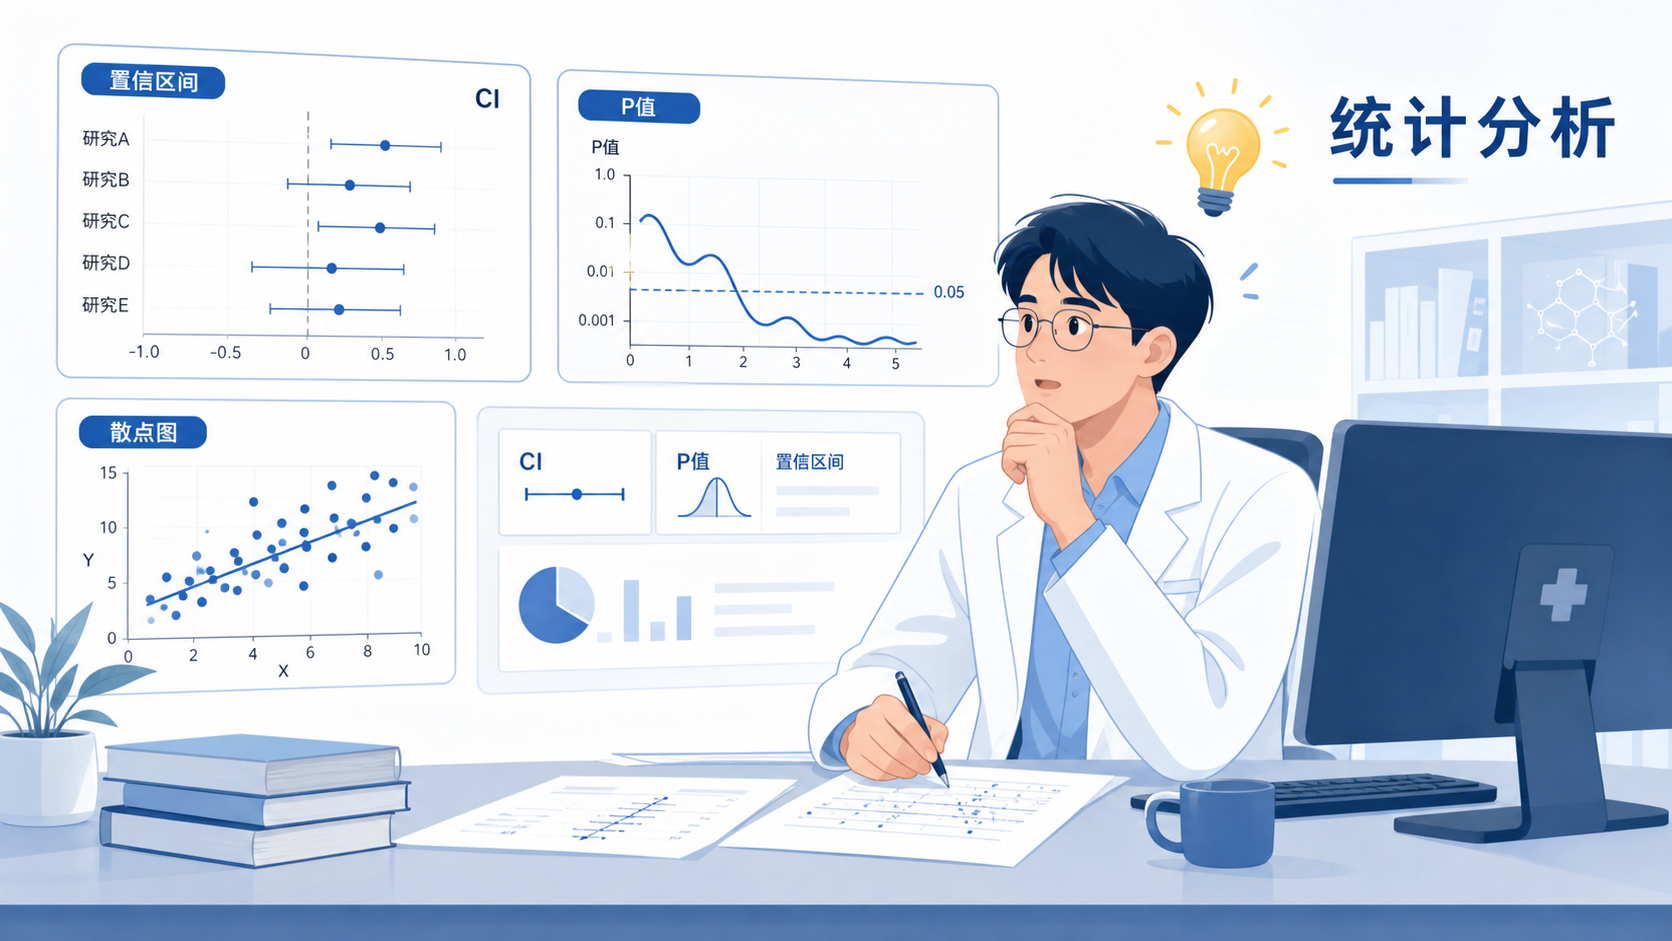
做统计时,很多人只会盯着一个P值。结果一到论文讨论,就开始心虚。真正容易被忽略的,是“这个结果到底稳不稳”。 置信区间就是干这个的。它不只是一个数字范围,更是在告诉你,结论有多靠谱,波动有多大。
1. 先把置信区间说人话
1.1 它不是“答案”,而是“答案的活动范围”
置信区间,英文是 confidence interval,简称 CI。它描述的是,如果重复抽样很多次,估计值可能落在哪个范围内 。最常见的是 95% CI。意思不是“真实值有95%概率在这个区间里”,而是长期重复研究时,95%的区间会覆盖真实参数。
这句话很关键。很多人第一次听都容易误解。
置信区间不是玄学,它是统计推断的边界。
它比单纯报告均值、OR、HR更完整,因为它把“估计值”和“不确定性”一起交代了。
1.2 为什么它比只看P值更重要
P值只能告诉你“有没有统计学差异”。但它不会告诉你差异大不大,稳不稳。
比如两组HR都是 0.78,P=0.04 和 P=0.20,读者的感受完全不同。可如果你看到 CI 是 0.60 到 1.01,你立刻知道,这个结果很接近无效边界,稳定性并不高。
一句话总结,P值回答“有没有”,CI回答“有多少,稳不稳”。
这也是为什么临床研究、基础研究、Meta分析都离不开置信区间。
2. 置信区间怎么算,别再把公式当黑魔法
2.1 最基础的计算逻辑
最常见的置信区间计算思路是:
估计值 ± 临界值 × 标准误
如果是95% CI,临界值通常接近 1.96。
也就是说,区间宽度和标准误有关。标准误越大,区间越宽。样本量越小,标准误通常越大。样本量越大,区间通常越窄。
你可以把它理解成。
样本少时,统计学也会“没底气”。
样本多时,说话就更稳。
2.2 一个简单例子,帮助你不再发懵
假设某研究中,某药物组血压下降均值为 8 mmHg,标准误为 2 mmHg。
那么95% CI大致可以理解为:
8 ± 1.96 × 2
结果约为 4.1 到 11.9 mmHg。
这意味着什么。
不是“真实下降值一定在这个范围”。
而是你对这个均值估计的把握范围,大概是这个区间。
区间越窄,说明估计越精确。
区间越宽,说明不确定性越大。
2.3 不同指标,算法会不一样
不是所有置信区间都能直接套“均值±1.96×SE”。
常见情形包括:
- 均值差,常用正态近似或t分布。
- 比值比 OR、风险比 RR、HR,通常先取对数再计算。
- 比例、率,可能用二项分布或其他方法。
- 小样本或偏态数据,常需要更稳健的方法。
所以,置信区间计算不是一个万能公式。
指标不同,分布不同,算法也不同。论文里如果没说明方法,最好不要直接照抄结果。
3. 置信区间怎么读,别让数字把你绕晕
3.1 看是否跨过“无效值”
这是最实用的一步。
不同指标的无效值不同:
- 均值差,通常看是否跨过 0。
- OR、RR、HR,通常看是否跨过 1。
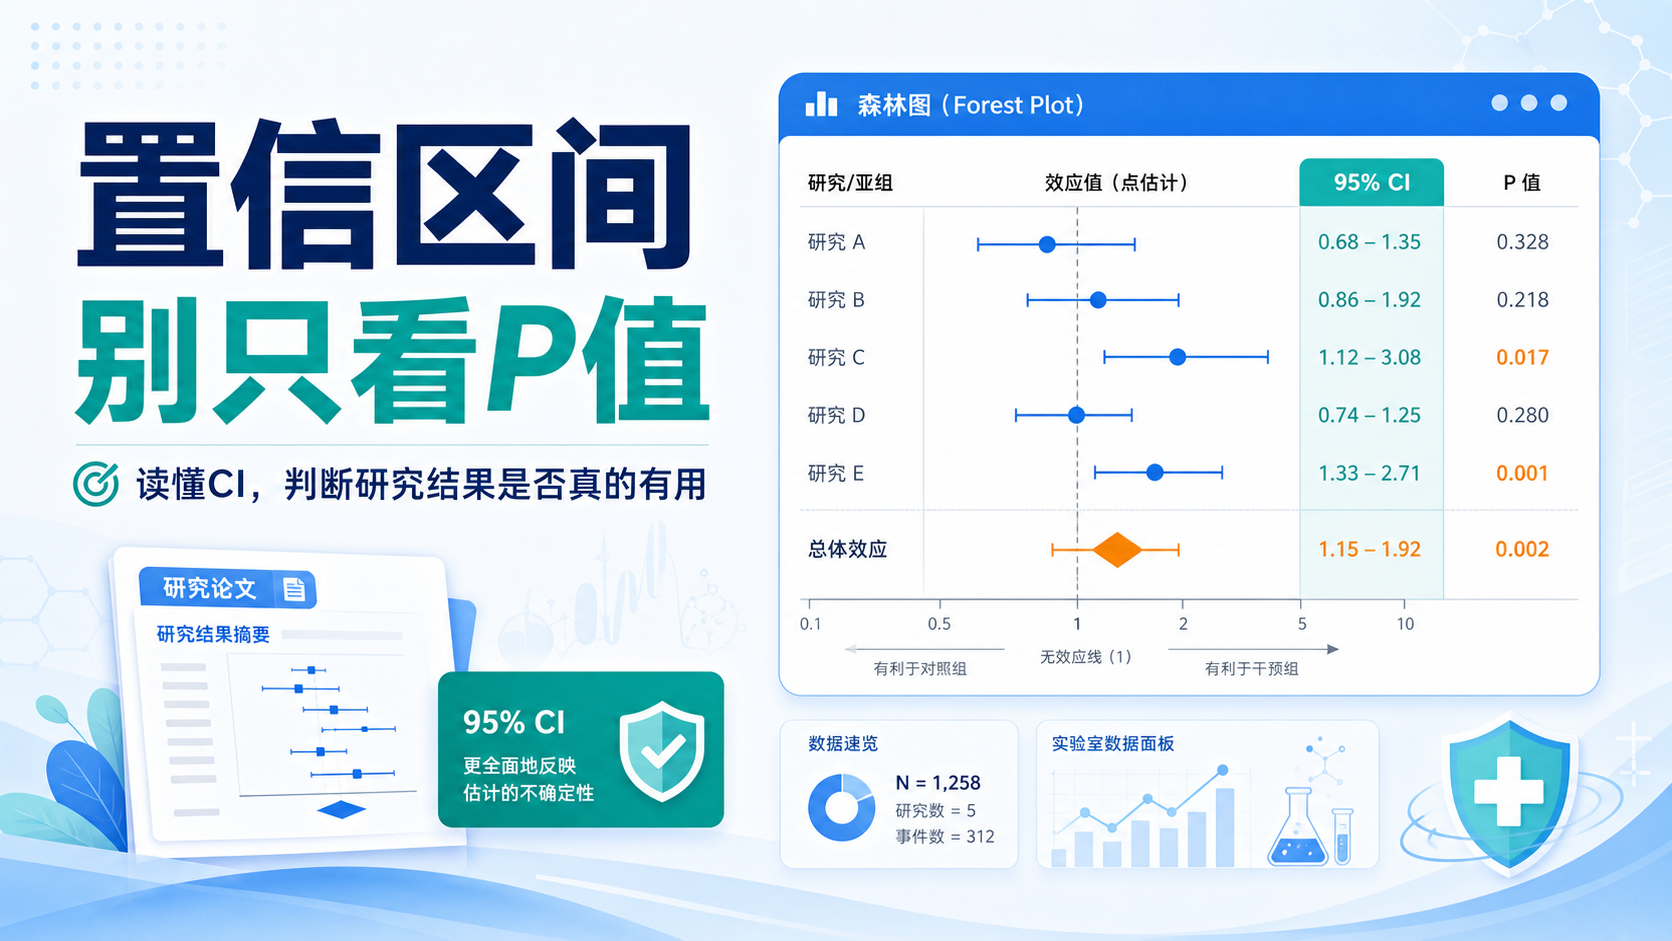
如果 95% CI 跨过无效值,往往提示统计学上不显著,或证据不够强。
比如 HR=0.72,95% CI 0.48–1.08。虽然点估计看起来有保护作用,但区间跨过1,就说明结论还不够稳。
点估计像主角,置信区间像配角,但配角决定剧情真不真。
3.2 区间宽窄,比你想象中更有信息量
一个窄区间,通常说明结果更精确。
一个很宽的区间,可能意味着样本量不足,或数据波动太大。
举个例子:
- A组 OR=1.2,95% CI 1.1–1.3。
- B组 OR=1.2,95% CI 0.6–2.4。
两个点估计一样,但A组明显更可信。
B组的区间太宽,既可能无效,也可能效应很强。这种结果最适合写进“还需扩大样本验证”里。
3.3 别被“显著”两个字冲昏头
统计学显著,不等于临床有意义。
如果一个治疗方案让某指标改善 0.2 分,95% CI 0.1–0.3,虽然P值很小,但临床价值可能很有限。
反过来,有些研究样本少,CI很宽,P值没过线,但区间仍提示潜在重要效应。
所以解释结果时,要同时看效应量、置信区间和临床背景。
这才像专业研究者。
4. 置信区间最常见的坑,踩过的人都懂
4.1 把95% CI理解成“真值有95%概率在里面”
这是经典误区。
严格来说,固定参数并不会“随机跑来跑去”。随机的是区间。
95% CI 的意思是,按同样方法重复很多次,95%的区间会包含真值。
听起来绕,其实就一句话。
区间是对真值的估计,不是真值的居住证。
4.2 只报P值,不报CI
这在投稿时很吃亏。
很多期刊更喜欢完整报告。因为 CI 能体现不确定性。
尤其在临床、流行病、基础转化研究中,单看P值很容易误导读者。
建议写法是:
- 效应值。
- 95% CI。
- P值。
三件套一起上,逻辑最完整。
4.3 样本太小,还硬要解释得很笃定
样本小,CI往往宽。
这不是丢人,这是事实。
真正专业的写法不是硬凹结论,而是客观说明局限性。
比如:
- 样本量有限。
- 置信区间较宽。
- 结果需在更大样本中验证。
研究的可信度,来自对不确定性的诚实。
5. 医学生、医生、科研人,分别怎么用
5.1 医学生,先学会读
你不需要一上来就背公式。
先学会看三件事:
- 点估计是多少。
- 95% CI 是否跨无效值。
- 区间宽不宽。
这三步就能帮你读懂大部分论文结果。
考试和汇报都够用。
5.2 临床医生,重点看“有没有用”
对临床医生来说,CI不只是统计语言,更是决策语言。
一个治疗方案如果效应值不错,但 CI 很宽,就意味着真实效果可能差很多。
这时,是否采用,要结合风险、成本、获益和患者偏好一起判断。
5.3 科研人员,重点看“怎么写得规范”
论文里,置信区间最好和效应量一起报告。
常见写法如下:
- OR = 1.45,95% CI 1.10–1.91。
- HR = 0.68,95% CI 0.50–0.92。
- 均值差 = 3.2,95% CI 1.4–5.0。
这种写法比单独报P值更符合国际期刊习惯。
也更容易通过审稿人挑剔的眼睛。
6. 会算,更要会用:从论文到图表的实战感
6.1 Forest plot 里最该盯什么
森林图就是置信区间的“主舞台”。
看森林图时,先看点估计,再看线段长度,再看是否跨无效值。
如果多个研究的CI都很宽,说明异质性或样本不足可能存在。
Meta分析里,CI比单个研究的P值更有整体判断价值。
6.2 结果解释要带上上下文
同样是一个HR 0.80:
- 在高危肿瘤研究里,可能很有意义。
- 在轻症管理里,可能临床意义有限。
所以解释CI时,不能只看数字。
还要看疾病背景、干预强度、样本量和终点类型。
这才是有上下文的科学表达。
6.3 工具用对,效率会高很多
现在很多软件都能自动算置信区间。
R、SPSS、GraphPad、Stata 都可以。
但工具只是工具。
真正的难点,不是点一下按钮,而是知道该用哪种方法,结果怎么解释。
如果你在做课题、写论文、看机制图,或者需要把统计结果讲给导师和审稿人听,建议把“会算、会看、会写”一起训练。像解螺旋这样的科研服务平台,就很适合在统计表达、论文图表和结果整合上提供支持,帮助你少踩坑,把置信区间讲清楚、用准确。
总结Conclusion
置信区间不是统计课里的装饰品。它是判断结果稳不稳、值不值、能不能写进论文讨论的关键工具。会看CI,才能真正读懂研究结果。
记住三句话就够了。
第一,看无效值有没有被跨过。
第二,看区间宽不宽。
第三,看效应量和临床背景是否匹配。
别再只盯着P值。
也别把置信区间算错后还强行装镇定。
把CI学明白,你的统计表达会立刻专业很多,论文也会更像科研,而不是像数学作业。
如果你想在论文写作、统计结果呈现和科研表达上少走弯路,可以关注解螺旋,让复杂问题变得更清楚。
- 引言Introduction
- 1. 先把置信区间说人话
- 2. 置信区间怎么算,别再把公式当黑魔法
- 3. 置信区间怎么读,别让数字把你绕晕
- 4. 置信区间最常见的坑,踩过的人都懂
- 5. 医学生、医生、科研人,分别怎么用
- 6. 会算,更要会用:从论文到图表的实战感
- 总结Conclusion