113
 分享

引言Introduction
标准误常被误读为“数据波动大不大”,但它真正回答的是“样本均值有多稳定”。在临床研究、论文写作和图表汇报中,把标准误和标准差混为一谈,会直接影响结果解释 ,甚至误导结论。
1. 先搞清楚标准误是什么
1.1 标准误描述的是“均值的抽样误差”
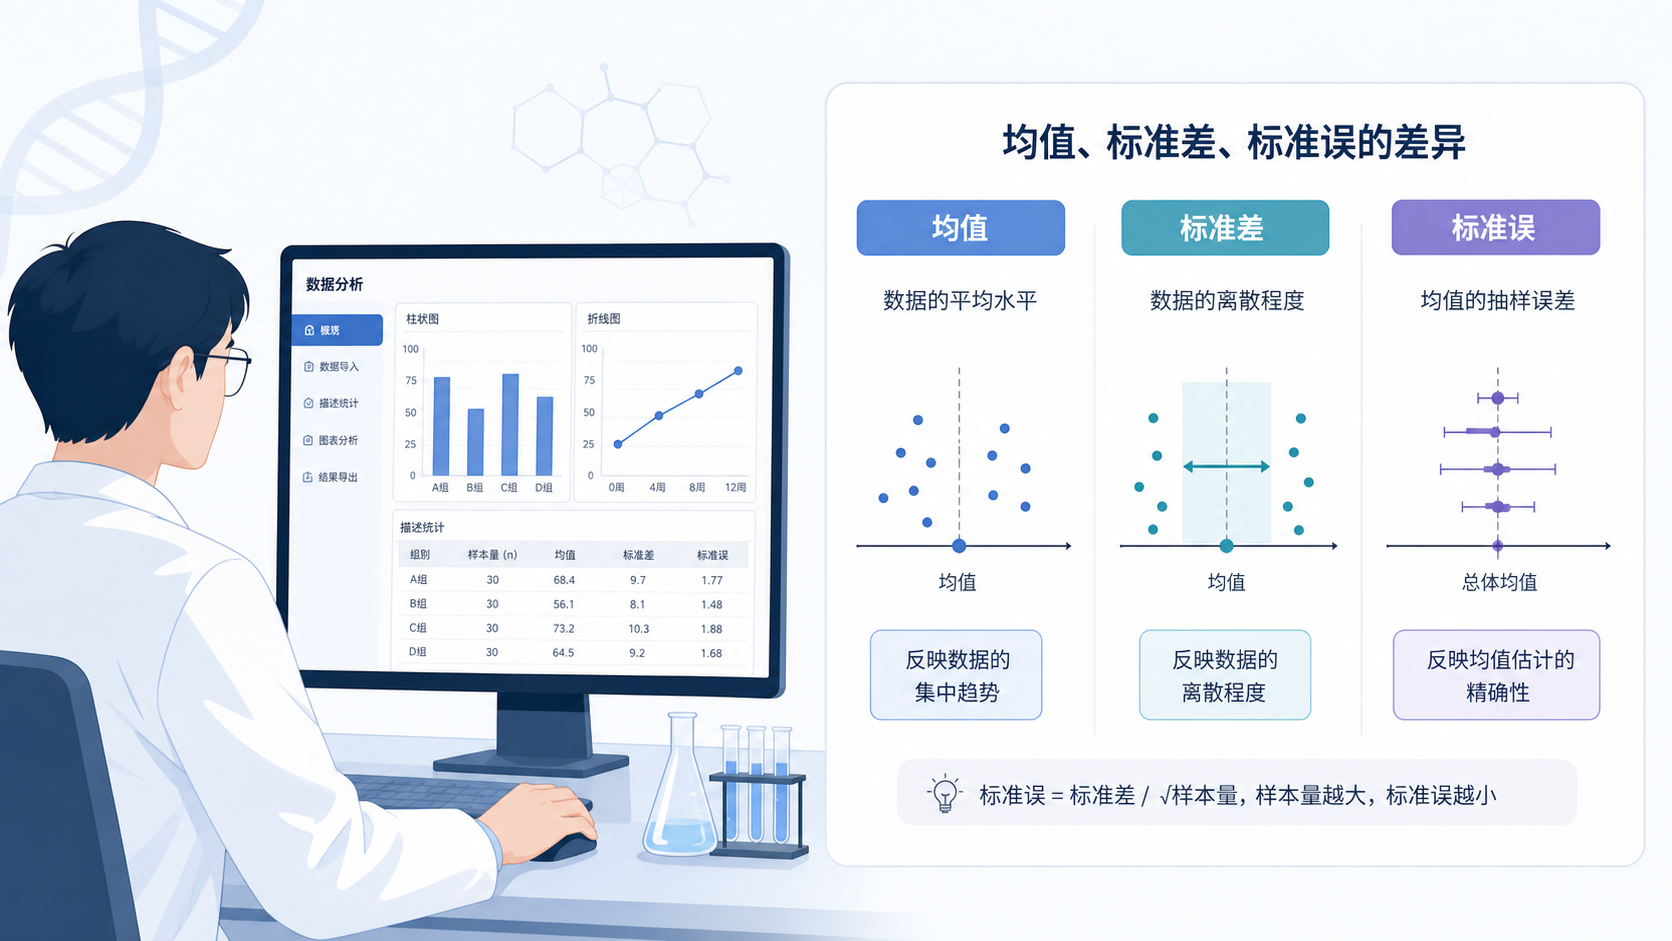
标准误,通常写作 SE,指的是样本统计量在重复抽样中的波动大小。临床研究里最常见的是均值的标准误,也就是均值估计值的不确定性。
它不是原始数据的离散程度,而是样本均值的稳定性指标。
如果同一研究重复抽样很多次,每次算出的均值会略有不同。标准误就是在描述这种“均值之间”的波动。
在实际应用中,均值标准误可用下面的关系理解:
- SE = SD / √n
- SD 是标准差,反映个体数据的分散程度
- n 是样本量
这意味着,样本量越大,标准误越小,均值估计越稳定。
1.2 为什么医学生和科研人员容易混淆
很多论文图表会同时出现“均值±标准差”和“均值±标准误”。如果不看图注,不看方法部分,很容易把两者当成一回事。
两者差异很关键:
- 标准差回答的是,个体数据分布有多散。
- 标准误回答的是,均值这个统计量有多稳。
例如,两组患者的血压均值都为 130 mmHg,但一组标准差较大,说明患者间差异大。另一组标准误较小,只能说明该组均值估计更稳定,不能说明患者本身更一致。
2. 标准误解读的核心场景
2.1 论文结果中的标准误
在医学论文中,标准误常见于回归分析、重复测量、meta 分析和某些图表展示。它通常配合均值、回归系数、差值或效应量出现。
解读标准误时,最重要的是先确认它对应的统计量是什么。
同样叫 SE,可能是均值的标准误,也可能是回归系数的标准误。它们的含义不同,不能混用。
常见解读方法:
- 看统计量类型,是均值、比例,还是回归系数。
- 看样本量,样本越大,SE 通常越小。
- 看置信区间,SE 越小,置信区间往往越窄。
2.2 图表中的误差线
很多柱状图、折线图会使用误差线。误差线可能代表 SD、SE 或 95%CI。如果图注没写清楚,图的科学性就会打折。
这是一个常见问题:
- 用 SE 画误差线,视觉上看起来更“紧”
- 用 SD 画误差线,更能反映个体差异
- 用 95%CI,更适合展示估计不确定性
因此,图表不是“画得越紧越好”,而是要和研究目的匹配。
如果你想展示样本均值的不确定性,SE 可以使用。
如果你想展示人群差异,SD 更合适。
如果你想强调推断结论,95%CI 往往更稳妥。
3. 标准误、标准差和置信区间的区别
3.1 三者分别回答什么问题
这三个指标经常一起出现,但用途完全不同。
- 标准差 SD:原始数据的离散程度。
- 标准误 SE:样本均值的抽样误差。
- 置信区间 CI:总体参数可能落入的范围。
举例来说,在一项 100 例高血压患者研究中,收缩压均值为 135 mmHg,SD 为 18 mmHg,SE 约为 1.8 mmHg。
这里的 18 说明患者之间差异较大,1.8 说明均值本身比较稳定。
不要用 SE 去替代 SD。
因为 SE 通常比 SD 小得多,容易让图看上去“波动不大”,但那只是均值估计稳定,不是数据本身集中。
3.2 什么时候更适合用置信区间
在临床研究写作中,置信区间往往比单独报告 SE 更有解释力。因为它直接告诉读者,效应量可能的真实范围。
例如:
- 均值差 = 5
- 95%CI = 2 到 8
这比只给出一个 SE 更容易理解,也更符合医学论文的表达习惯。
SE 更适合内部计算,CI 更适合结果呈现。
4. 标准误在统计分析中的实际用法
4.1 从描述统计到推断统计
标准误最常见的作用,是帮助完成从样本到总体的推断。它参与了很多统计量的构建,比如 t 值、z 值、回归系数检验和置信区间计算。
可以简单理解为:
- 估计值越稳定,SE 越小
- SE 越小,统计推断通常越可靠
- SE 越大,说明不确定性更高
在样本量较小时,SE 往往偏大。
这也是为什么小样本研究的结果更需要谨慎解读。不是均值不可信,而是均值周围的不确定性更大。
4.2 在回归模型中如何理解SE
在回归分析里,SE 通常出现在回归系数旁边。它用于计算显著性检验和置信区间。
例如,一个变量的回归系数为 0.8,SE 为 0.2,通常意味着该估计值相对稳定。
如果 SE 变成 0.8,说明不确定性明显增加,统计显著性也可能下降。
因此,回归结果不能只看 P 值。
还要看系数本身、SE、95%CI 和临床意义。
对医生和科研人员来说,这比单看“显著不显著”更重要。
5. 标准误图表怎么用才规范
5.1 画图前先写清楚图注
如果图中使用误差线,必须写明是 SD、SE 还是 95%CI。
这是最基本的规范。
建议图注至少包含:
- 指标名称
- 误差线类型
- 样本量
- 统计方法
例如:
“数据以均值±标准误表示,n=30。”
这句话虽然简单,但能显著减少误读。
5.2 不同图形的适用场景
不同图形对标准误的表达效果不同。
- 柱状图 :适合展示均值及误差线,但容易遮盖原始分布。
- 折线图 :适合展示时间趋势,常用于随访研究。
- 散点图叠加均值和误差线 :更推荐,能兼顾分布和总结信息。
如果条件允许,优先保留原始点。
因为只显示均值和误差线,容易掩盖样本内部差异。对医学研究来说,这会降低图表信息量。
6. 标准误常见误区
6.1 把SE当成“数据误差”
这是最常见的错误。
SE 不是单个数据点的误差,也不是测量仪器误差。它是统计估计的不确定性。
6.2 认为SE越小,数据越好
SE 越小,只能说明均值估计更稳定。
它不等于数据质量更好,也不等于效应更强。
6.3 用SE误导图表观感
有些图会故意用 SE,让误差线看起来更短。
这可能会让读者误以为组间差异很小或结果更精确。
专业写作中,图表选择必须服务于科学表达,而不是视觉包装。
7. 研究者如何快速判断是否该用标准误
7.1 先问三个问题
在决定是否使用标准误前,可以先问自己:
- 我要展示的是个体差异,还是均值不确定性?
- 读者最需要知道的是分布,还是推断结果?
- 图表是用于描述,还是用于统计推断?
如果目的是展示均值估计稳定性,SE 可用。
如果目的是展示样本离散程度,优先用 SD。
如果目的是支持结论,优先考虑 95%CI。
7.2 一个实用判断原则
描述分布,用 SD。
描述估计,用 SE。
描述结论,用 CI。
这个原则简单,但非常实用。
尤其适合临床课题、毕业论文和投稿初稿。
总结Conclusion
标准误的核心价值,不在于“看起来更精细”,而在于帮助研究者判断样本均值或回归结果的稳定程度。它最适合用于推断统计和结果不确定性的表达,不适合替代标准差。
在论文和图表中,务必写清楚误差线类型,避免读者误读。若你正在整理临床数据、制作结果图或准备投稿,建议把标准误、标准差和置信区间分开处理。需要更高效地完成数据整理、图表输出和科研写作,可以了解解螺旋的相关工具与服务,让标准化流程减少返工,提高论文产出效率。
- 引言Introduction
- 1. 先搞清楚标准误是什么
- 2. 标准误解读的核心场景
- 3. 标准误、标准差和置信区间的区别
- 4. 标准误在统计分析中的实际用法
- 5. 标准误图表怎么用才规范
- 6. 标准误常见误区
- 7. 研究者如何快速判断是否该用标准误
- 总结Conclusion