82
 分享

引言Introduction
转录组数据预处理后分析,往往卡在“能打开结果,却不知道下一步怎么做”。对医学生、医生和科研人员来说,真正的难点不是数据量,而是如何把聚类、降维、差异基因和可视化串成稳定流程。
1. 为什么预处理后分析要走自动化流程
1.1 从“手工点选”到“可复用分析”
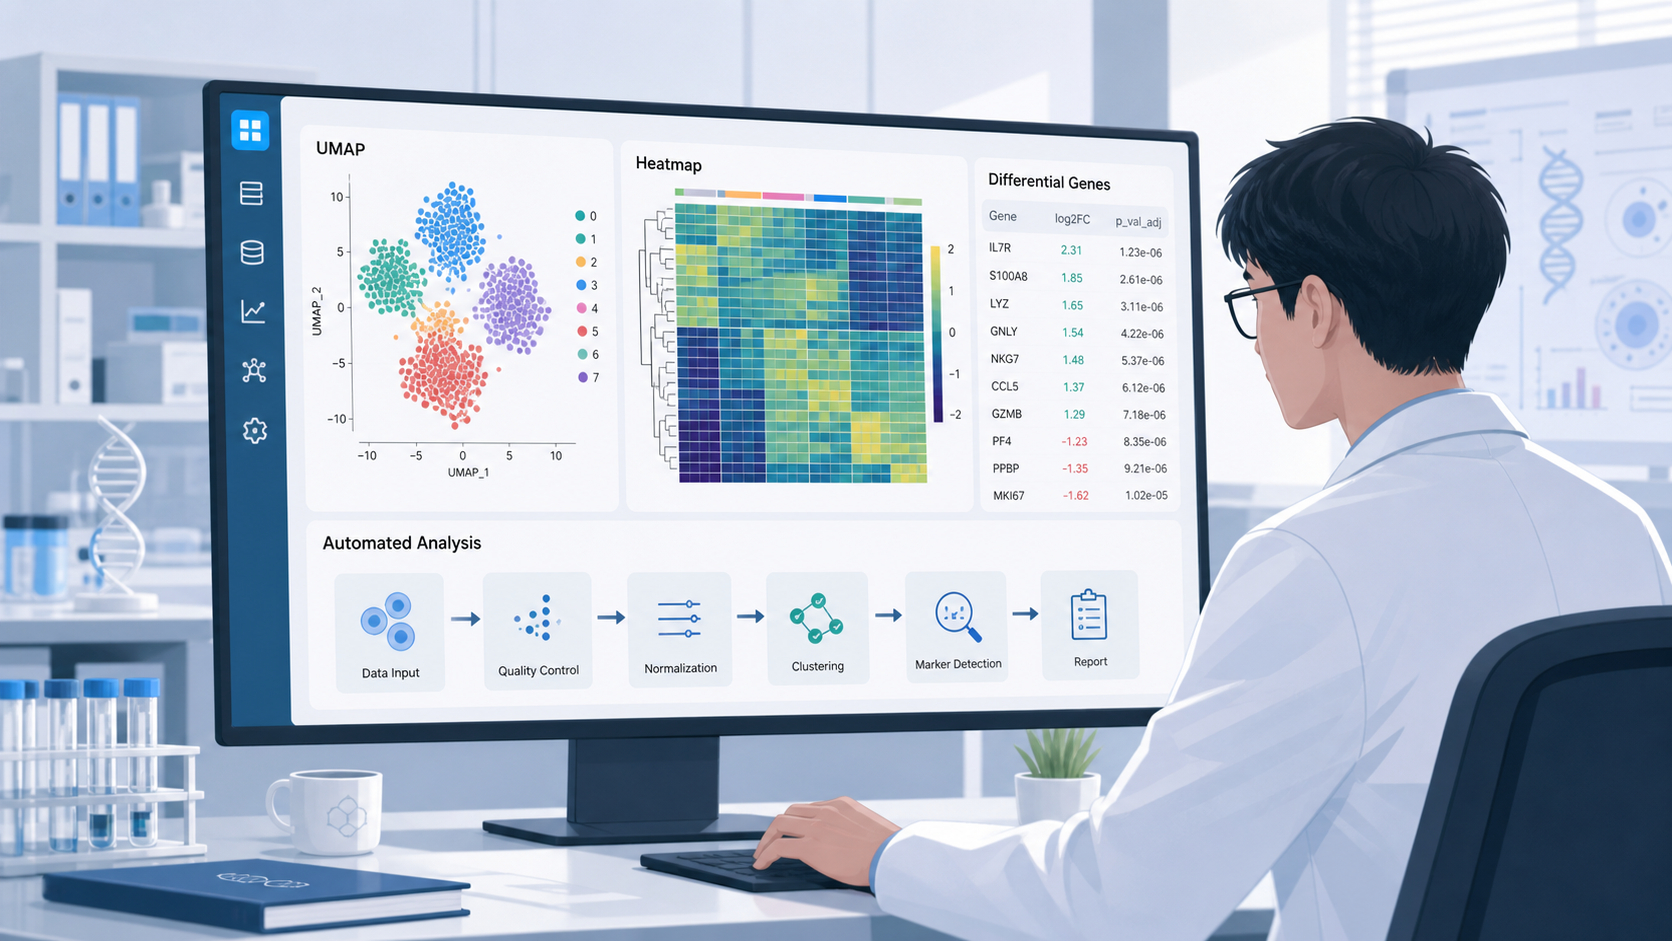
转录组数据预处理后分析的核心价值,是把重复操作标准化。像 Loupe Browser 这类可视化工具,可以直接打开下游生成的 cloupe 文件,快速查看聚类、基因表达和样本分组。对于初步探索,这种方式很高效。
但如果每个项目都手工重复筛选、截图、导出,就很容易出现版本不一致、参数不一致的问题。自动化流程的优势,是让同一批数据在同一套规则下得到可复现结果。
1.2 先看什么,再做什么
一个稳妥的顺序通常是:
- 检查样本分组是否合理。
- 查看 PCA、t-SNE 或 UMAP 降维结果。
- 评估聚类是否清晰。
- 再做差异基因分析。
- 最后导出图表和结果文件。
在 scater 和 scran 的流程中,通常会先挑选变异度较高的前 2,000 个基因,再进行 PCA、IRLBA 和 t-SNE 比较。这一步能减少计算量,也能提升后续聚类的稳定性。
2. 转录组数据预处理后分析的标准流程
2.1 基因变异性评估与降维
预处理后的第一步,通常不是直接做差异分析,而是先找高变异基因。提纲中明确提到,可以用平均 log 表达量和变异系数作图,并添加拟合曲线,筛选前 2,000 个高变异基因。
这一步的意义很直接。高变异基因更能反映细胞间真实差异。
如果数据量较小,可以先用 PCA。若数据较大,则可考虑 IRLBA 这类基于奇异值分解的方法,再结合 t-SNE 观察非线性结构。
2.2 聚类结果要先验证,再解释
在下游分析里,聚类不是终点,而是中间步骤。课程提纲中提到,先用层次聚类,再用动态剪切术重新聚类,最终得到 8 类细胞,并复制到样本对象中展示。
这说明一个关键原则。聚类结果必须先看“分得开不开”,再谈“这个簇代表什么”。
如果 t-SNE 上不同类型细胞基本没有重叠,通常说明分群效果更好。反之,则要回头检查标准化、选基因和距离度量。
2.3 差异基因分析决定后续解释质量
差异分析是转录组数据预处理后分析里最重要的一步之一。提纲中列出多种方法,包括 t 检验、威尔逊秩和检验、二项分布检验。结果会包含 top 排名、P 值、校正后 P 值、log FC 等指标。
这里最实用的做法是:
- 先看显著性。
- 再看 log FC。
- 再看基因是否符合生物学预期。
- 最后结合热图和小提琴图确认表达趋势。
只看 P 值不够。只看倍数变化也不够。
真正可靠的 marker,通常要同时满足统计显著和表达差异明显。
3. Loupe Browser 在自动化结果展示中的作用
3.1 适合做什么,不适合做什么
Loupe Browser 支持 Windows 和 Mac,主要用于查看已经生成的下游结果。它可以放大、缩小、自动缩放,还能截图保存为 PNG。还能切换深浅背景,方便论文作图前的预览。
它特别适合做三类事:
- 快速检查聚类是否合理。
- 浏览不同分组的样本分布。
- 查看特定基因在不同细胞群中的表达。
但它不适合替代完整的统计分析。它是可视化和初步探索工具,不是深度机制推断工具。
如果要做发育路径、细胞类型注释或更深入的统计建模,仍建议回到 R 中完成。
3.2 常见操作路径
根据课程内容,打开 cloupe 文件后,可以直接进入样本浏览界面。用户可切换不同分组,如按聚类、样本 ID 或基因表达查看结果。还可以创建、删除或导入分组,调整颜色和名称。
常见实操路径可以概括为:
- 打开 cloupe 文件。
- 查看默认 t-SNE 或 UMAP 图。
- 切换到聚类分组。
- 选定目标基因,如 CD3。
- 查看该基因在各簇中的表达。
- 导出热图、小提琴图或差异基因表。
这类操作的价值,在于把“结果检查”压缩到几分钟内完成。
3.3 输出文件能直接服务论文和汇报
课程中提到,软件可默认输出前 50 个结果,也支持导出全部差异基因表达结果。对于科研写作来说,这一点很实用。
因为你最终需要的往往不是“一个界面”,而是:
- 可用于补充材料的表格。
- 可用于汇报的图。
- 可追溯的参数和结果文件。
自动化分析真正提升效率的地方,不是替你思考,而是减少重复整理。
4. R 端自动化分析更适合科研场景
4.1 读取、标准化、聚类一体完成
课程提纲中的 reanalyzev 流程强调,重新分析命令需要 CSV 参数文件,适合大多数下游分析场景。对于 AGGR 合并后的样本,也可以直接进入重新分析流程,输出聚类、差异分析、PCA、TSNE 和 UMAP 等结果。
R 端流程的优势是可控性强。
你可以明确指定输入、过滤条件、降维方法和输出路径。这对需要批量处理多个样本的项目尤其重要。
4.2 资源占用和参数管理要提前规划
提纲明确指出,Loupe Browser 较耗费系统资源,建议使用 16G 内存电脑。R 分析也同样如此,尤其在样本较多、特征较多时,计算和内存压力都会上升。
因此,做转录组数据预处理后分析时,建议提前准备:
- 统一的参数模板。
- 固定的数据目录结构。
- 版本记录。
- 输出文件命名规则。
这会显著降低后期返工概率。
4.3 批量样本合并要注意细胞名重复
在公开数据分析中,课程示例提到批量读取多个样本后合并时,可能出现细胞名字重复。这说明批量分析不是简单拼接文件。
实际操作时,至少要确认:
- 样本名是否唯一。
- 细胞条码是否冲突。
- 合并后对象是否完整。
- 输出报告是否对应正确样本。
这些检查看似琐碎,但会直接影响下游分析可信度。自动化不等于跳过核对。
5. 如何把流程真正做快
5.1 用固定模板替代临时处理
对于医学生和科研人员来说,最省时间的方法不是“跑得更快”,而是“少改动”。
建议把转录组数据预处理后分析拆成固定模板:
- 输入检查模板。
- 质量控制模板。
- 聚类与降维模板。
- 差异分析模板。
- 导出与汇报模板。
每个项目只替换样本路径和参数。这样既能提高效率,也能提高一致性。
5.2 先探索,后深入
Loupe Browser 适合做快速探索。R 语言适合做更深层分析。两者并不冲突,而是互补。
实际工作中,可以先用浏览器确认:
- 聚类是否合理。
- 标记基因是否明显。
- 样本是否存在异常。
再回到 R 中完成:
- 更严格的差异分析。
- 更复杂的分组比较。
- 更系统的图表输出。
这样的组合,才是高效率且可发表的路线。
5.3 用解螺旋提升流程连续性
如果你希望把转录组数据预处理后分析真正做成“可复制、可汇报、可沉淀”的流程,可以借助解螺旋品牌的课程与实操资源。它把软件操作、R 分析和结果解读串成连续步骤,适合医学生、医生和科研人员快速上手。
尤其在单细胞与转录组场景中,有清晰的参数模板、标准化演示和结果解释,往往比单独学习某一个软件更省时间。
这能帮助你把精力集中在科学问题上,而不是反复处理格式和界面操作。
总结Conclusion
转录组数据预处理后分析的关键,不只是“跑出结果”,而是建立一套稳定、可复用、可解释的自动化流程。先做变异基因筛选,再做降维和聚类,随后进行差异分析,最后通过 Loupe Browser 和 R 工具完成可视化与输出,效率会明显提升。
对科研人员来说,真正节省时间的,是标准化流程和明确的分析顺序。
如果你希望更快掌握单细胞和转录组下游分析,可以继续关注解螺旋的实战课程与工具支持,把方法学训练变成可直接落地的科研能力。
- 引言Introduction
- 1. 为什么预处理后分析要走自动化流程
- 2. 转录组数据预处理后分析的标准流程
- 3. Loupe Browser 在自动化结果展示中的作用
- 4. R 端自动化分析更适合科研场景
- 5. 如何把流程真正做快
- 总结Conclusion