270
 分享
引言Introduction
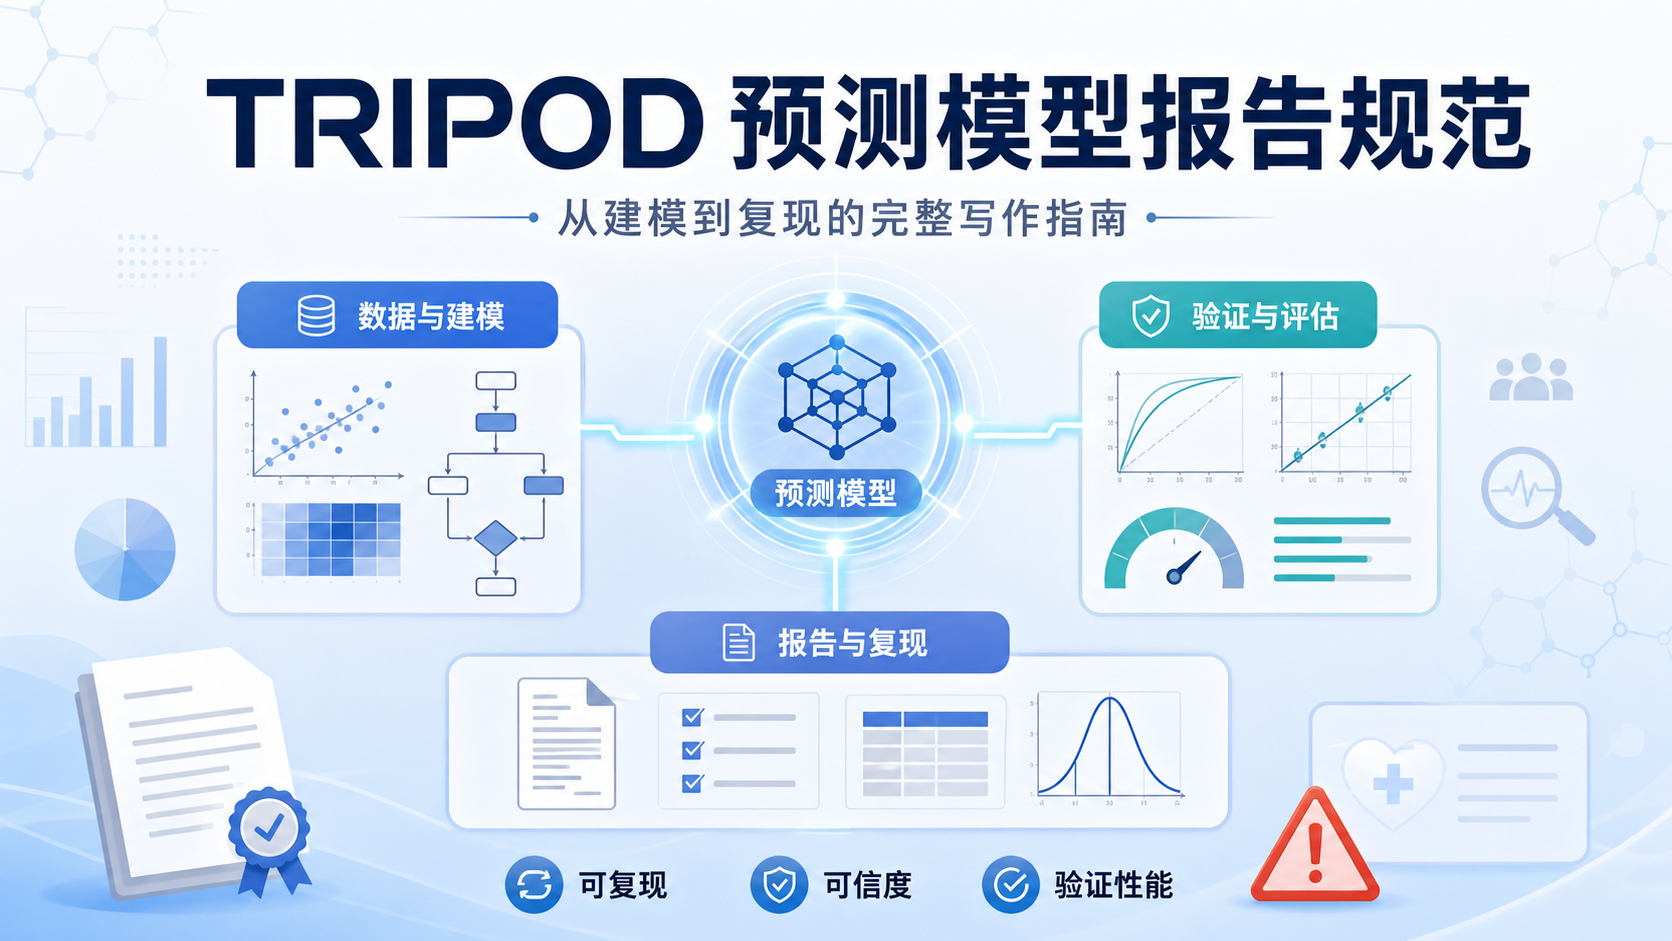
临床预测模型越来越多,但很多研究能建模,不能复现,能发表,不能落地 。问题往往不在算法,而在报告不完整、数据流程不透明、验证不足。TRIPOD报告标准正是为了解决这些痛点。
1. 为什么预测模型需要TRIPOD
1.1 预测模型的核心风险,不是“算不出来”,而是“说不清”
预测模型研究最常见的问题,是变量来源不明、结局定义模糊、样本处理缺失。结果是,读者看到了AUC,却无法判断模型是否可信。TRIPOD的价值,不是替代统计分析,而是把建模过程讲清楚。
TRIPOD全称是《Transparent Reporting of a multivariable prediction model for Individual Prognosis Or Diagnosis》。它关注的是报告透明度。也就是说,模型是否可复现,首先取决于研究者有没有把关键环节交代完整。
临床和科研场景里,很多模型只展示“结果”,不展示“过程”。但对医学生、医生和科研人员来说,真正重要的是:
- 数据从哪里来。
- 纳入和排除标准是什么。
- 缺失值如何处理。
- 变量筛选是否合理。
- 内部验证和外部验证是否完成。
1.2 只报结果,不足以支持模型可信度
一个看似漂亮的模型,如果没有报告训练集与验证集的划分方式、事件数与变量数比例、校准情况和临床净获益,通常很难判断其泛化能力。AUC高,不等于模型好。
尤其在小样本研究中,如果结局事件不足,却纳入过多候选变量,模型极容易过拟合。上游知识库中的案例就提示了这一点:200多例样本、不到100个结局事件,却纳入17个研究因素,这类设计会明显削弱检验效能,增加偶然发现的风险。
2. TRIPOD报告标准的核心内容
2.1 TRIPOD不是一份形式清单,而是一套报告逻辑
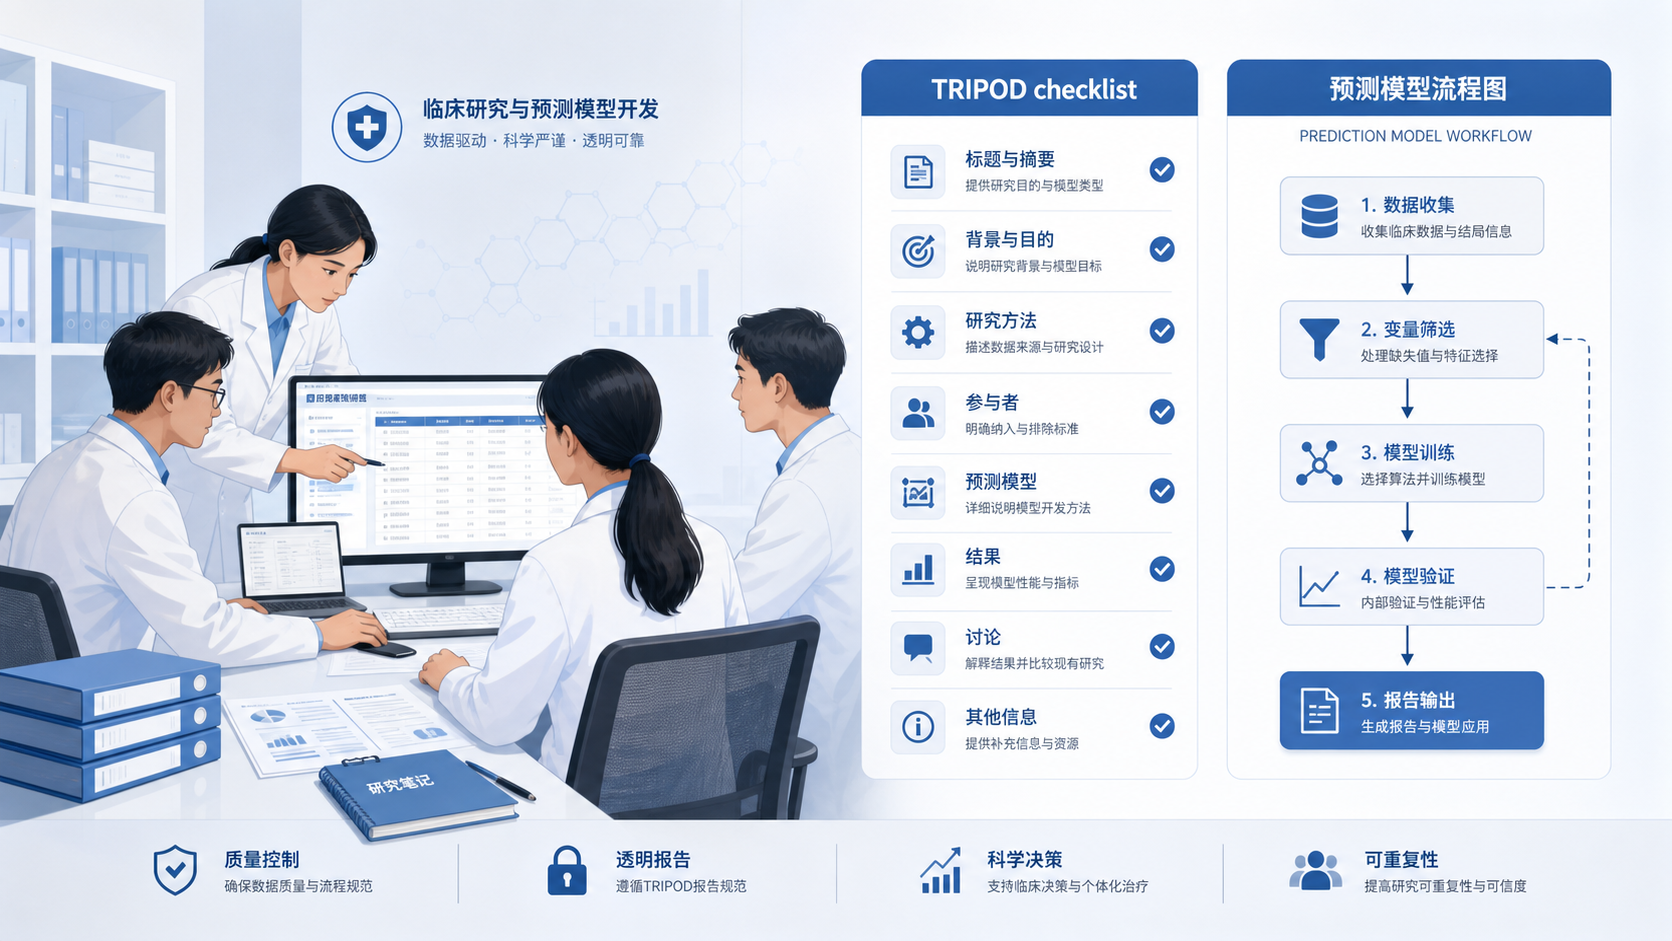
TRIPOD强调的是从研究背景到模型验证的完整链条。它要求作者说明:
- 研究对象和数据来源。
- 预测因子和结局定义。
- 缺失数据处理方式。
- 模型开发方法。
- 验证策略。
- 性能评价指标。
- 模型使用场景。
如果这些信息缺失,模型就很难被独立验证。
对预测模型研究来说,最容易被忽视的是“可重复实施性”。也就是别的团队能不能按照你的描述,拿到相似数据后重建同样模型。TRIPOD要求的正是这种可复现性。
2.2 报告中必须交代的关键统计信息
一篇合格的预测模型论文,至少应清楚呈现以下内容:
- 样本来源与时间范围。
- 纳入、排除标准。
- 结局事件数。
- 候选预测因子数量。
- 变量筛选方法。
- 模型类型,如Logistic回归、Cox回归、机器学习等。
- 内部验证方式,如交叉验证、Bootstrap。
- 外部验证数据是否独立。
- 校准曲线、区分度、临床决策曲线。
没有校准,就无法判断预测概率是否可靠。没有验证,就无法判断模型是否稳定。
2.3 事件数与变量数,决定模型是否站得住
预测模型常见误区之一,是“变量越多越好”。实际上,变量过多会提高过拟合风险。虽然具体阈值需要结合研究设计,但原则非常明确:事件数不足时,不应盲目纳入过多变量。
这也是TRIPOD强调透明报告的原因。读者需要知道模型是在什么数据条件下建立的,是否存在选择偏倚,是否经过合理降维。若变量筛选方法不清楚,模型的统计学意义就会大打折扣。
3. TRIPOD实操:从建模到报告的步骤
3.1 第一步,先定义清楚研究问题
预测模型不是为了“建一个模型”,而是为了回答一个明确问题。比如:
- 某疾病的术后复发风险是多少。
- 某治疗后不良结局的概率有多高。
- 某诊断路径下患者是否属于高风险人群。
问题越具体,模型越有临床价值。如果结局定义本身不稳定,后续统计再复杂也没有意义。
研究开始前,建议把以下内容先写清:
- 目标人群。
- 预测时间窗。
- 结局类型。
- 主要预测因子。
- 模型应用场景。
3.2 第二步,规范数据管理和缺失值处理
很多模型失败,不是建模失败,而是数据处理不透明。TRIPOD要求报告缺失数据的比例、处理方法,以及是否进行了敏感性分析。
常见做法包括:
- 完整案例分析。
- 多重插补。
- 基于模型的缺失处理。
但无论用哪种方法,都要写明理由。不能只写“缺失值已处理”,却不说明具体方法。
对于回顾性数据,建议同步报告数据清洗流程。包括重复记录、异常值、极端值是否剔除,是否存在时间断档。因为时间断档会引入病例选择偏倚,影响训练集和验证集的一致性。上游知识库中提到训练集和验证集之间断档2个月,这类设计就值得警惕。
3.3 第三步,选择合理的建模和验证策略
模型开发完成后,必须回答两个问题:
- 这个模型在当前数据里表现如何。
- 这个模型到了新数据里是否还能用。
因此,TRIPOD非常重视验证。常见验证方式包括:
- 内部验证,检验模型稳定性。
- 时间外验证,观察不同时间段表现。
- 外部验证,检验跨中心泛化能力。
只有验证,才能把“拟合得好”变成“真的可用”。
如果研究只做了训练集拟合,却没有验证,或者验证数据与训练数据来源过于接近,模型的真实性就会受到限制。独立验证数据越独立,结论越有说服力。
3.4 第四步,完整报告模型性能
预测模型不能只报AUC。TRIPOD要求报告多个维度:
- 区分度,判断模型能否区分高低风险。
- 校准度,判断预测概率是否接近真实发生率。
- 临床实用性,判断模型是否有决策价值。
AUC反映排序能力,校准反映概率可信度,决策曲线反映临床获益。
例如,两个模型AUC相近,但一个校准良好,另一个明显高估风险,临床意义完全不同。若论文只展示单一指标,就无法体现模型的真实价值。
4. 常见误区与审稿人最关注的问题
4.1 只做单因素显著性筛选,不足以支持建模
很多研究习惯先做单因素分析,再把P值显著的变量放进多因素模型。这个思路并不总是最优。因为P值受样本量影响明显,且可能遗漏具有临床意义但单因素不显著的变量。
变量选择应结合临床知识、统计策略和模型稳定性,而不是只看P值。
上游知识库中提到的“单指标演员”与“组团成团”的比喻,实际上对应了一个核心问题:把多个指标组成模型,不应只是为了凑结果,而要证明组合优于单独指标。否则,模型的增益就没有被真正证明。
4.2 没有比较基线模型,难以证明模型获益
一个新模型要有说服力,至少应与已有方法、单指标或传统评分体系比较。否则,读者无法知道新模型到底提升了多少。
建议报告:
- 与单个预测因子的性能比较。
- 与传统评分系统比较。
- 与临床经验判断比较。
- 与简化模型比较。
没有对照,就没有增益证据。
4.3 训练集与验证集的划分要有原则
训练集和验证集不能随意切分。尤其是存在时间断档、病例来源变化、检查策略变化时,模型表现可能被夸大或扭曲。
审稿人通常会关注:
- 是否按时间顺序划分。
- 是否存在中心差异。
- 是否有选择偏倚。
- 验证集是否真正独立。
这些细节,直接决定模型结论的可信程度。
5. 让模型真正可复现的写作要点
5.1 用清晰结构替代模糊描述
写预测模型论文时,建议按“数据来源、变量定义、建模过程、验证方法、性能评估、临床意义”顺序展开。这样不仅符合TRIPOD,也便于审稿人快速定位关键信息。
可复现的模型报告,通常有三个特征:
- 变量定义明确。
- 分析流程完整。
- 结果可追溯。
5.2 图表要服务于复现,而不是只服务于美观
建议至少包含:
- 纳入排除流程图。
- 候选变量表。
- 模型系数或权重表。
- 校准曲线。
- 决策曲线。
- 验证结果表。
图表不是装饰,而是复现工具。
如果条件允许,还应在补充材料中提供更详细的数据字典、代码逻辑和模型参数。这样,其他研究者才有机会真正重复你的工作。
5.3 借助规范工具提升写作效率
对临床研究者来说,TRIPOD的难点不在“知道标准”,而在“落到文字”。很多论文在方法部分遗漏了关键项,导致返修反复。
这时可以借助标准化写作工具辅助整理框架。比如,解螺旋品牌的科研内容工具就更适合把预测模型的报告结构整理成清晰模板,帮助作者按TRIPOD条目逐项补全内容,减少遗漏,提高一致性。对于需要投稿、标书或方法学规范输出的团队,这类工具能显著提升初稿质量。
总结Conclusion
TRIPOD的核心,不是让预测模型“看起来更正规”,而是让它可理解、可复现、可验证 。对医学生、医生和科研人员来说,真正高质量的预测模型,必须同时回答三个问题:数据是否透明,方法是否合理,结论是否可信。
如果你正在撰写预测模型报告,建议直接按TRIPOD逐项核对:样本来源、变量定义、缺失处理、建模方法、验证策略和性能评价。这样写出来的研究,更容易通过审稿,也更有临床转化价值。若你希望进一步提高模型报告的完整性和表达效率,可以结合解螺旋品牌的工具与方法框架,帮助你把复杂研究写得更规范、更可复现。
- 引言Introduction
- 1. 为什么预测模型需要TRIPOD
- 2. TRIPOD报告标准的核心内容
- 3. TRIPOD实操:从建模到报告的步骤
- 4. 常见误区与审稿人最关注的问题
- 5. 让模型真正可复现的写作要点
- 总结Conclusion