177
 分享
引言Introduction
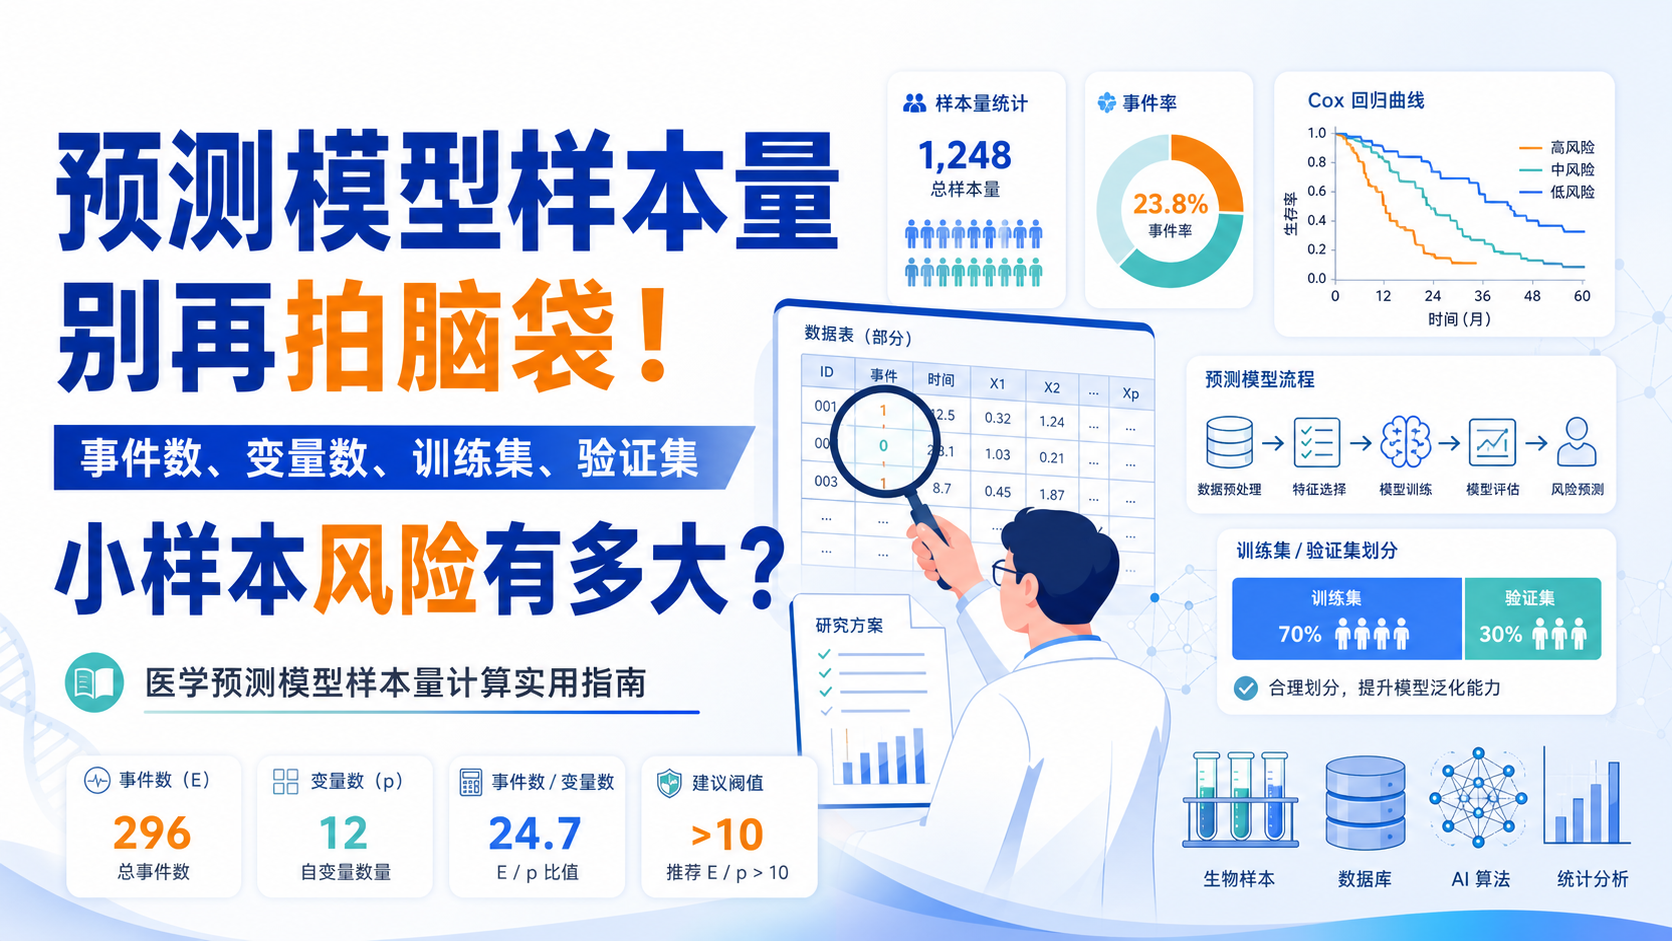
预测模型最常见的失败,不是算法不够复杂,而是样本量不够。样本太少,模型容易过拟合,外推性能差,结论也不稳。对医学生、医生和科研人员来说,先把样本量算对,往往比盲目加变量更重要。 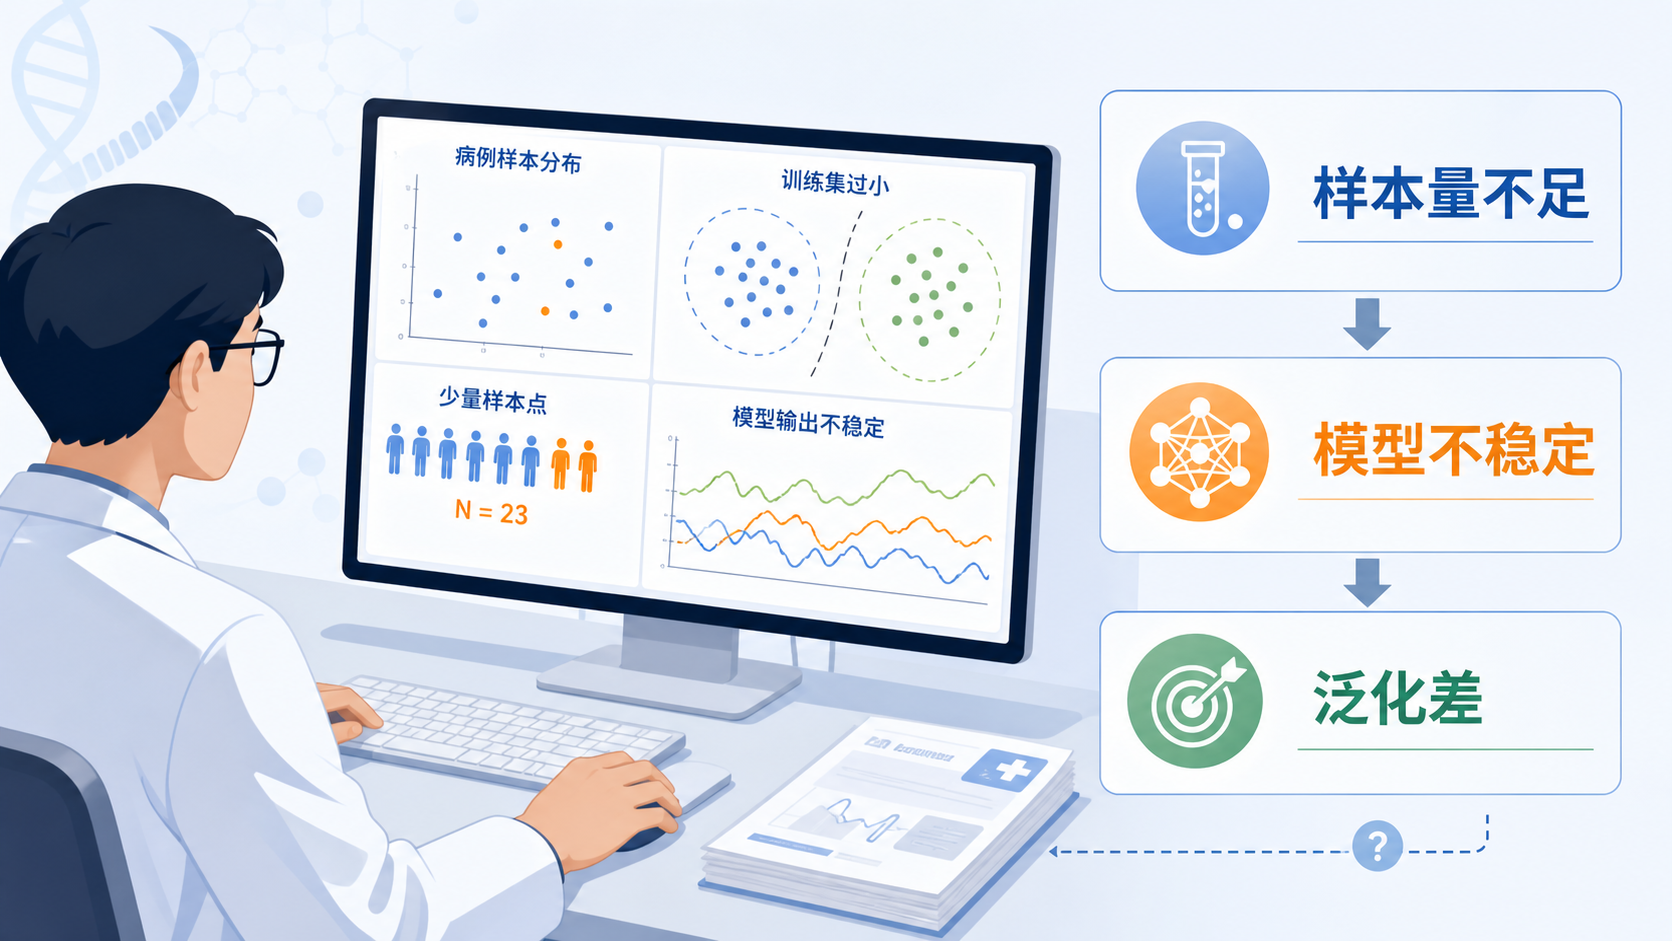
1. 为什么预测模型的样本量不能随便拍脑袋
1.1 预测模型和普通回归不一样
生物医学预测模型常见于Logistic回归、线性回归和Cox回归。它们的目标不是单纯解释关联,而是尽量稳定地预测结局。
因此,样本量不仅要满足统计学检验,还要兼顾模型稳定性、变量筛选和泛化能力。这就是预测模型样本量计算比一般研究更敏感的原因。
很多人会直接套“每个自变量10个样本”这类经验法则。它有参考价值,但不是万能公式。因为不同模型、不同结局类型、不同事件率,样本需求差异很大。
1.2 样本量不足会带来什么后果
样本不足时,常见问题有三类。
- 回归系数波动大。
- 显著性结果不稳定。
- 训练集表现很好,外部验证明显变差。
尤其是二分类结局和生存结局,如果事件数太少,模型很容易“学到噪声”。 这会直接影响临床可用性,也影响论文可信度。
1.3 黄金法则的核心不是“越多越好”
样本量不是越大越好,而是要和研究问题匹配。
对预测模型来说,核心是让模型有足够的信息量去估计参数,而不是只追求总例数。
这也是为什么很多方法会强调“事件数”或“有效信息量”,而不是只看总样本数。
2. 传统经验法则:可以参考,但不能机械照搬
2.1 自变量倍数法的基本思路
在多因素分析中,经验性样本量估计最常见。常见建议是,样本量设置为自变量个数的5倍、10倍或20倍。
例如有10个自变量,按1:10计算,至少需要100例。按1:20计算,至少需要200例。
这类方法适合研究早期快速估算,但不适合作为最终方案。 因为它没有充分考虑事件率、变量相关性和模型复杂度。
2.2 Cox回归要看终点事件数
如果是Cox多因素回归,重点不只是总例数,而是终点事件数。
经验法则通常也是按事件数与自变量个数的比例估算。例如10个自变量,若按1:10,至少需要观察到100个终点事件。
这意味着,如果随访时间短,或者死亡、复发等事件发生率低,即使总样本很多,也可能不够。
2.3 为什么BMJ文献强调经验估计
相关BMJ文献指出,多元回归、Logistic回归、因子分析等多因素分析,没有绝对可靠的统一样本量公式,只能做经验性估计。
这个结论很重要,因为它提醒我们:预测模型样本量计算,本质上是“约束条件下的最优近似”,不是精确到个位数的数学题。
3. 预测模型样本量计算的实用原则
3.1 先明确结局类型
样本量估计前,先判断你的模型属于哪一类。
- 连续结局,常用线性回归。
- 二分类结局,常用Logistic回归。
- 时间结局,常用Cox回归。
不同结局对应不同的样本量逻辑。
如果结局是二分类或时间结局,事件数往往比总例数更关键。
3.2 再明确自变量数量
不要把所有可能变量都塞进模型。
变量越多,对样本量要求越高。若样本量有限,应优先保留临床上有明确意义的变量。
建议在建模前先做三步:
- 依据文献和机制筛选候选变量。
- 检查变量间共线性。
- 明确最终入模数量。
变量选择越清晰,样本量估计越可控。
3.3 关注事件率,而不是只看总样本
对于Logistic回归和Cox回归,事件率很关键。
例如某二分类结局发生率只有10%,总样本1000例,实际有效事件只有100例。
如果你有15个自变量,事件数就可能偏紧。
这也是为什么预测模型研究中,经常需要先估算事件数,再反推总样本量。
4. 一个更稳妥的实操思路
4.1 用“最少需求”和“稳健需求”双层估算
建议把样本量估计分成两层。
- 最少需求:满足基础建模。
- 稳健需求:留出变量筛选、缺失值和验证空间。
例如按1:10估计得到100例,不代表100例就足够发表高质量模型。
如果考虑缺失数据、内部验证和外部验证,实际需要往往更高。
对生物医学预测模型而言,1:10可以作为起点,但不应视为终点。
4.2 预留缺失值和无效样本
临床研究里,缺失值很常见。
如果预计10%数据缺失,样本量应额外上调。若问卷或检验依从性较差,修正比例还要更高。
举个简单思路:
- 理论需求100例。
- 预计10%缺失。
- 实际招募约111例以上更稳妥。
如果研究设计更复杂,比如多中心、长期随访、重复测量,预留空间应更大。
4.3 训练集和验证集要分开考虑
很多预测模型研究还要做内部验证或外部验证。
如果直接把全部样本都用于建模,模型表面上很好,实际稳定性未必可靠。
因此,样本量计算时要把验证需求一并考虑进去。
尤其是需要分训练集、验证集时,实际建模样本会被切分,单独用于建模的样本数会减少。
5. 常见误区:为什么很多模型“看起来能跑,实际上不稳”
5.1 误区一,变量越多越好
这是最常见的错误。
在样本量有限时,盲目增加变量只会增加方差和不稳定性。模型可能在开发集表现漂亮,但无法复制。
5.2 误区二,只看总样本,不看事件数
对于生存模型和二分类模型,这是致命问题。
总样本充足,不代表事件数充足。
事件太少时,回归系数会偏移,置信区间也会变宽。
5.3 误区三,完全依赖软件自动计算
PASS等软件对基础设计类型的样本量估计很强,但多因素分析、特别是复杂预测模型时,软件并不能替代研究者的判断。
很多时候,仍需要结合经验法则、预实验数据和临床知识综合决定。
6. 对研究者最实用的建议
6.1 建模前先回答三个问题
- 结局是什么类型。
- 自变量有几个。
- 事件率大概多少。
这三个问题回答清楚,样本量就不会偏得太离谱。
6.2 优先减少变量,而不是硬追求样本
如果实际招募困难,不要强行保留过多变量。
可通过以下方式优化:
- 合并临床意义相近的变量。
- 删除低质量或重复信息变量。
- 使用预实验和文献支持的核心变量。
6.3 有条件时进行预试验
预试验可以帮助估计事件率、变量分布和缺失率。
这些信息会直接影响预测模型样本量计算的合理性。
预试验不是正式结果,但它能显著提高正式研究的设计质量。
7. 结论:最优样本量不是一个数,而是一套逻辑
7.1 结论总结
生物医学预测模型的样本量计算,不能只靠单一公式。
它要同时考虑结局类型、自变量数量、事件率、缺失率和验证需求。
经验法则如1:5、1:10、1:20仍有价值,但更适合作为起点,而不是唯一答案。
真正的“黄金法则”,是让样本量和模型复杂度、事件信息量、研究目标三者匹配。
7.2 让样本量设计更稳妥
如果你正在做预测模型研究,建议在设计阶段就把样本量、变量数和事件数一起规划。这样可以减少返工,也能提升论文通过率和模型可信度。
如果你希望把样本量估计、变量筛选和建模流程一次性做得更规范,可以借助解螺旋的科研方法支持与建模工具,把复杂问题拆成可执行步骤,帮助你更高效地完成预测模型样本量计算与后续分析。
- 引言Introduction
- 1. 为什么预测模型的样本量不能随便拍脑袋
- 2. 传统经验法则:可以参考,但不能机械照搬
- 3. 预测模型样本量计算的实用原则
- 4. 一个更稳妥的实操思路
- 5. 常见误区:为什么很多模型“看起来能跑,实际上不稳”
- 6. 对研究者最实用的建议
- 7. 结论:最优样本量不是一个数,而是一套逻辑