100
 分享

引言Introduction
SCI选题难,往往不是没思路,而是变量太多,创新点太散。很多课题卡在“疾病模型已经有人做过,分子也不新,药物也难找”的阶段。真正高效的做法,是先把研究拆成恒量和变量,再用组合逻辑去筛选。
1. 先把SCI选题拆成“恒量”和“变量”
1.1 恒量决定课题边界
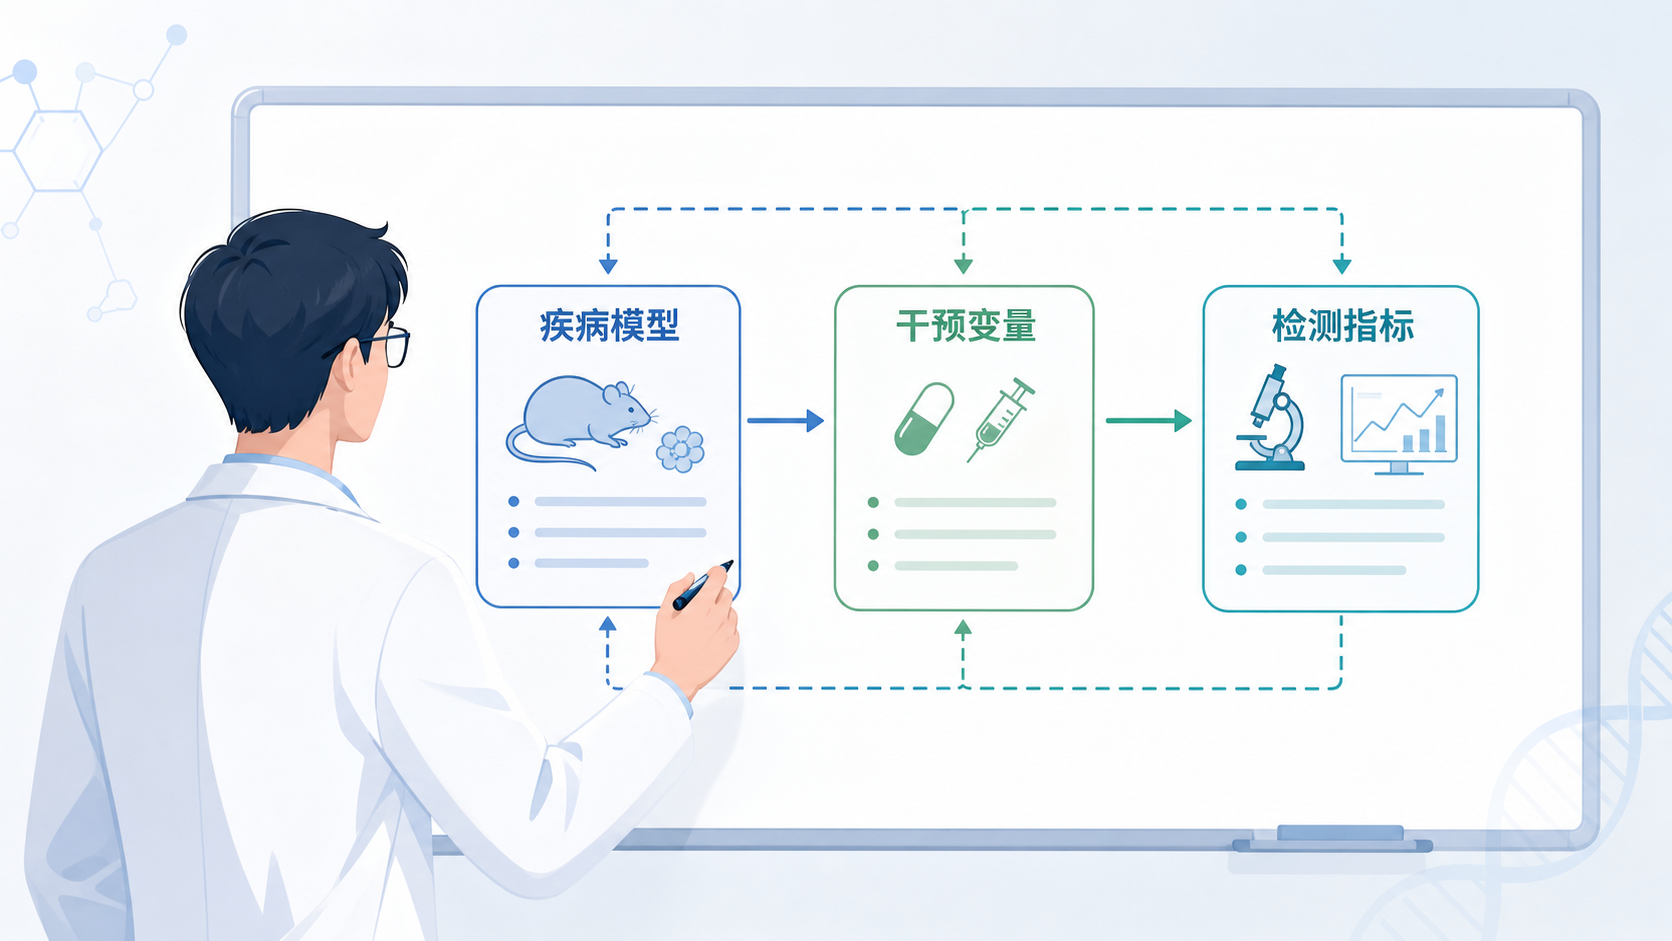
在生物医学研究里,很多因素其实是不变的。比如疾病类型、研究模型、核心实验流程,通常都属于恒量。它们决定了课题的基本框架。如果恒量不清楚,选题就会变成无目标的发散。
对于骨与软骨相关研究,这一点尤其重要。因为同类文章的逻辑结构往往很像,都是“干预因素作用于疾病模型,再通过机制验证获得诊断或治疗结论”。换句话说,先确定研究对象,再谈创新点,顺序不能反。
1.2 变量才是文章创新的核心
变量通常分为两类。
- 外源性变量 ,也就是药物、材料、抗体、纳米体系、水凝胶等。
- 内源性变量 ,也就是蛋白、miRNA、lncRNA、代谢中间产物等。
这两类变量都可以作为创新点。关键不在于它们“新不新”,而在于它们是否能和既定疾病模型形成合理的生物学闭环。选题的本质,不是找一个最炫的分子,而是找一个最能解释疾病过程的变量。
1.3 把实验设计从“简答题”变成“填空题”
当你先确定恒量,再锁定变量,课题设计就不再是从零开始发散,而是按结构填空。
你只需要回答三个问题:
- 研究什么疾病模型。
- 选什么变量作为干预点。
- 用什么实验验证其作用机制。
这种方法能明显降低选题试错成本,也更适合医学生、医生和科研人员快速形成可投稿的课题框架。
2. 变量组合法为什么更适合SCI选题
2.1 先有逻辑,再谈创新
很多人做选题时,只盯着“最近谁最热”。但热度不等于可发表。SCI选题技巧的关键,是让变量和疾病之间存在可解释的因果链。
比如炎症性疾病之间可以类比,退行性疾病之间也可以类比。这个“类比”不是生搬硬套,而是基于病理过程相似性的合理推断。
2.2 常见的变量组合思路
变量组合的核心,是把已有知识重新排列。常见思路包括:
- 疾病类型类比 :炎症性肠病的药物,能否迁移到骨关节炎的炎症环境中。
- 退行性疾病类比 :腰椎间盘退变中有效的分子,是否也适用于骨软骨退变。
- 发育与退化对照 :促进骨骼发育的因素,是否能用于逆转骨量下降。
- 修复场景迁移 :创面修复药物的促血管和促迁移作用,是否能服务于骨再生。
- 材料场景改造 :用于心脏或胃肠修复的水凝胶,能否通过改性后用于骨或软骨组织工程。
这类组合的价值,在于把“已有证据”转换成“新应用场景”。 这比凭空找全新分子更稳,也更容易形成完整故事线。
2.3 为什么它比盲目追新更有效
追新有风险。太新的变量往往文献少,背景薄,机制链条不完整。太旧的变量又容易撞题。变量组合法的优势是平衡两者。
它让你利用已有基础做迁移验证,既保留创新性,又降低失败概率。对于时间和经费都有限的团队,这是更现实的SCI选题路径。
3. 药物创新:从师门传承到文献类比
3.1 师门传承是最稳的起点
如果课题组已经在某类药物上积累了数据,最优先考虑的不是“完全换方向”,而是“换疾病场景”。
例如,前期如果已经证明某药物在骨质疏松中有效,就可以进一步推测它在骨关节炎、骨修复或软骨损伤中的作用。这种延伸式选题通常更容易接上前期基础。
3.2 文献类比可以快速找到候选药物
如果没有师门基础,也可以从文献类比入手。思路很简单。
- 某药物在炎症性肠病有效,能否迁移到骨关节炎的炎症环境。
- 某药物在创面修复中促进血管生成,能否用于骨组织再生。
- 某材料在软组织修复中表现稳定,能否改性后支持骨软骨再生。
这种“照猫画虎”的方法,本质上是基于病理相似性做合理迁移。它不是抄袭,而是基于生物学逻辑的再开发。
3.3 热门药物适合做起步课题
对新手而言,二甲双胍、姜黄素、大黄素、小檗碱这类泛靶点药物,往往是不错的起点。
原因很简单。它们的已有研究较多,基础信息完整,实验设计更容易搭建。只要疾病场景和机制链条成立,就有机会做出新的适应症故事。
4. 分子创新:从内源性变量中找突破口
4.1 同家族分子值得优先考虑
分子创新不一定非要从零开始。很多时候,同一家族分子之间存在功能重叠或机制相似性。
比如已经研究了某个组蛋白去甲基化酶对骨关节炎的作用,就可以进一步看看同家族成员是否参与类似病理过程。这样的选题更容易延续已有技术路线。
4.2 热门通路适合承接机制文章
mTOR、AMPK这类经典通路之所以常被研究,不是因为“老”,而是因为它们位于能量代谢和细胞命运调控的核心位置。
如果你的疾病模型涉及代谢重编程、炎症应答或细胞衰老,这些通路往往可以提供稳定的机制支点。关键不是追逐通路热度,而是判断它是否真的解释得了你的表型。
4.3 选分子时要避开两个误区
第一,不要只看差异倍数最大。差异大,不一定有研究价值。
第二,不要优先选择超级管家基因。它们虽然重要,但往往广泛表达,临床样本难获得,验证难度高。
更合理的做法是先看生物学过程,再看候选分子。先通路,后分子,通常比先分子,后硬套机制更稳。
5. 组学与数据库:让变量筛选更高效
5.1 公共数据库能显著缩短选题周期
在选题阶段,组学数据和公共数据库是非常重要的工具。
常见策略包括差异表达分析、富集分析、网络分析和文献联合验证。它们的作用不是替代实验,而是帮助你缩小范围。一个好的筛选过程,能把几十个候选变量压缩到2到3个可验证靶点。
5.2 富集分析比单看差异基因更可靠
如果只盯着差异倍数,容易误判。更稳妥的方法是先做富集分析。
因为一个生物学过程通常由一组基因共同参与。当某条通路富集显著时,说明它在疾病中更可能是真正的关键环节。
常用分析包括:
- GO。
- KEGG。
- Reactome。
这些分析的价值,在于把“单个基因”放回“系统过程”中理解,减少误选风险。
5.3 数据筛选的推荐顺序
更实用的流程是:
- 先从公共数据库找差异表达基因。
- 再做富集分析,找到关键通路。
- 再结合文献筛候选分子。
- 最后做体外或体内验证。
这种流程比直接凭感觉挑基因更符合SCI选题技巧,也更利于后续文章结构展开。
6. 变量组合法的落地步骤
6.1 先定疾病,再定场景
不要先找变量,再硬找疾病。正确顺序是先确定疾病模型,再找最适合解释该疾病的变量。
例如骨关节炎、软骨损伤、骨质疏松、骨再生,这些方向都可以围绕“炎症、退变、修复、代谢”展开。只要逻辑闭环清楚,就具备可做性。
6.2 再定变量,再定验证方式
变量定下来以后,要同步考虑验证路径。
- 细胞层面,看增殖、凋亡、炎症、迁移、成骨或成软骨能力。
- 动物层面,看组织结构、功能恢复、免疫染色和分子变化。
- 机制层面,看上下游关系、通路抑制和救援实验。
选题不是只决定“研究什么”,更决定“怎么证明”。 这一步设计得越早,后面返工越少。
6.3 最后再看可发表性
一个好选题,至少要同时满足三点。
- 有明确疾病场景。
- 有可解释的变量。
- 有可落地的验证路径。
如果这三点成立,文章结构就比较完整,后续写作、实验和投稿都会更顺。这也是变量组合法最实用的地方。
总结Conclusion
生物医学SCI选题,真正难的不是“有没有题目”,而是“能不能快速筛出既新又稳的题目”。变量组合法的核心价值,就是把选题从发散搜索变成结构化筛选。 先定恒量,再找变量。先做类比,再做验证。先看通路,再看分子。这样更符合生物医学研究的逻辑,也更适合医学生、医生和科研人员高效启动课题。
如果你希望把选题思路进一步落地到具体项目设计、变量筛选和文章框架搭建,可以借助解螺旋的专业服务,把“想法”更快变成“可执行方案”。
- 引言Introduction
- 1. 先把SCI选题拆成“恒量”和“变量”
- 2. 变量组合法为什么更适合SCI选题
- 3. 药物创新:从师门传承到文献类比
- 4. 分子创新:从内源性变量中找突破口
- 5. 组学与数据库:让变量筛选更高效
- 6. 变量组合法的落地步骤
- 总结Conclusion