74
 分享
引言Introduction
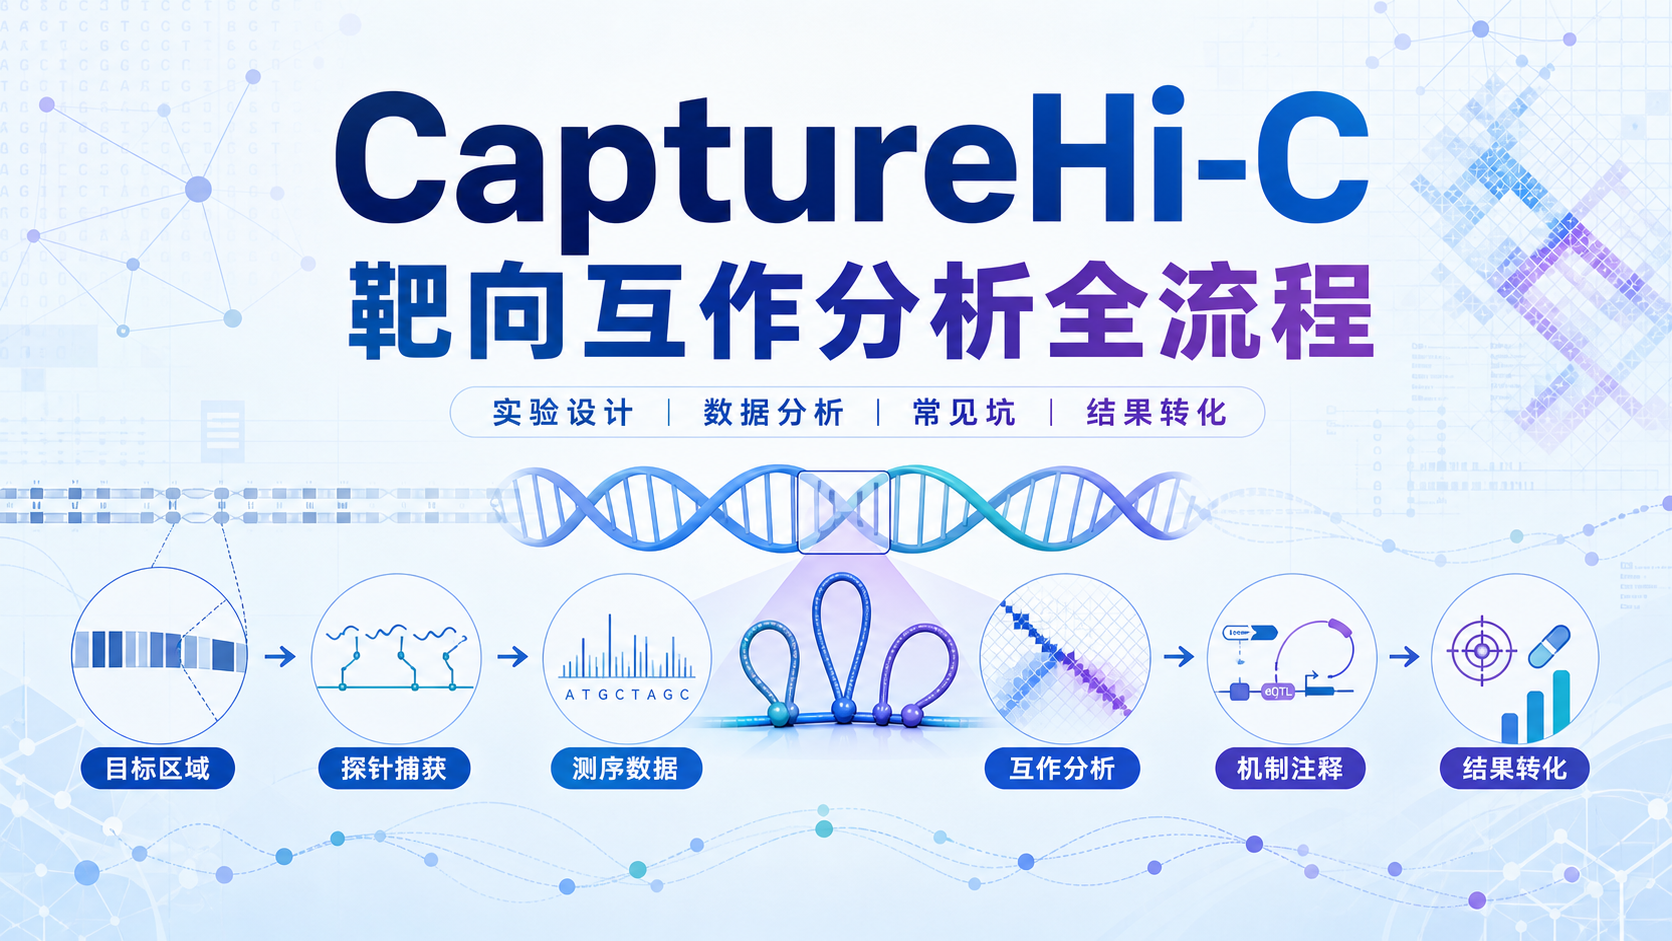
CaptureHi-C把“看全景”变成“盯重点”。它专门解决目标区域互作弱、背景噪声高、传统Hi-C成本高的问题。对医学生、医生和科研人员来说,真正的难点不是拿到数据,而是如何把靶向互作信号做准、做稳、做可解释 。
1. CaptureHi-C是什么,适合解决什么问题
1.1 从全基因组扫描,转向靶向深挖
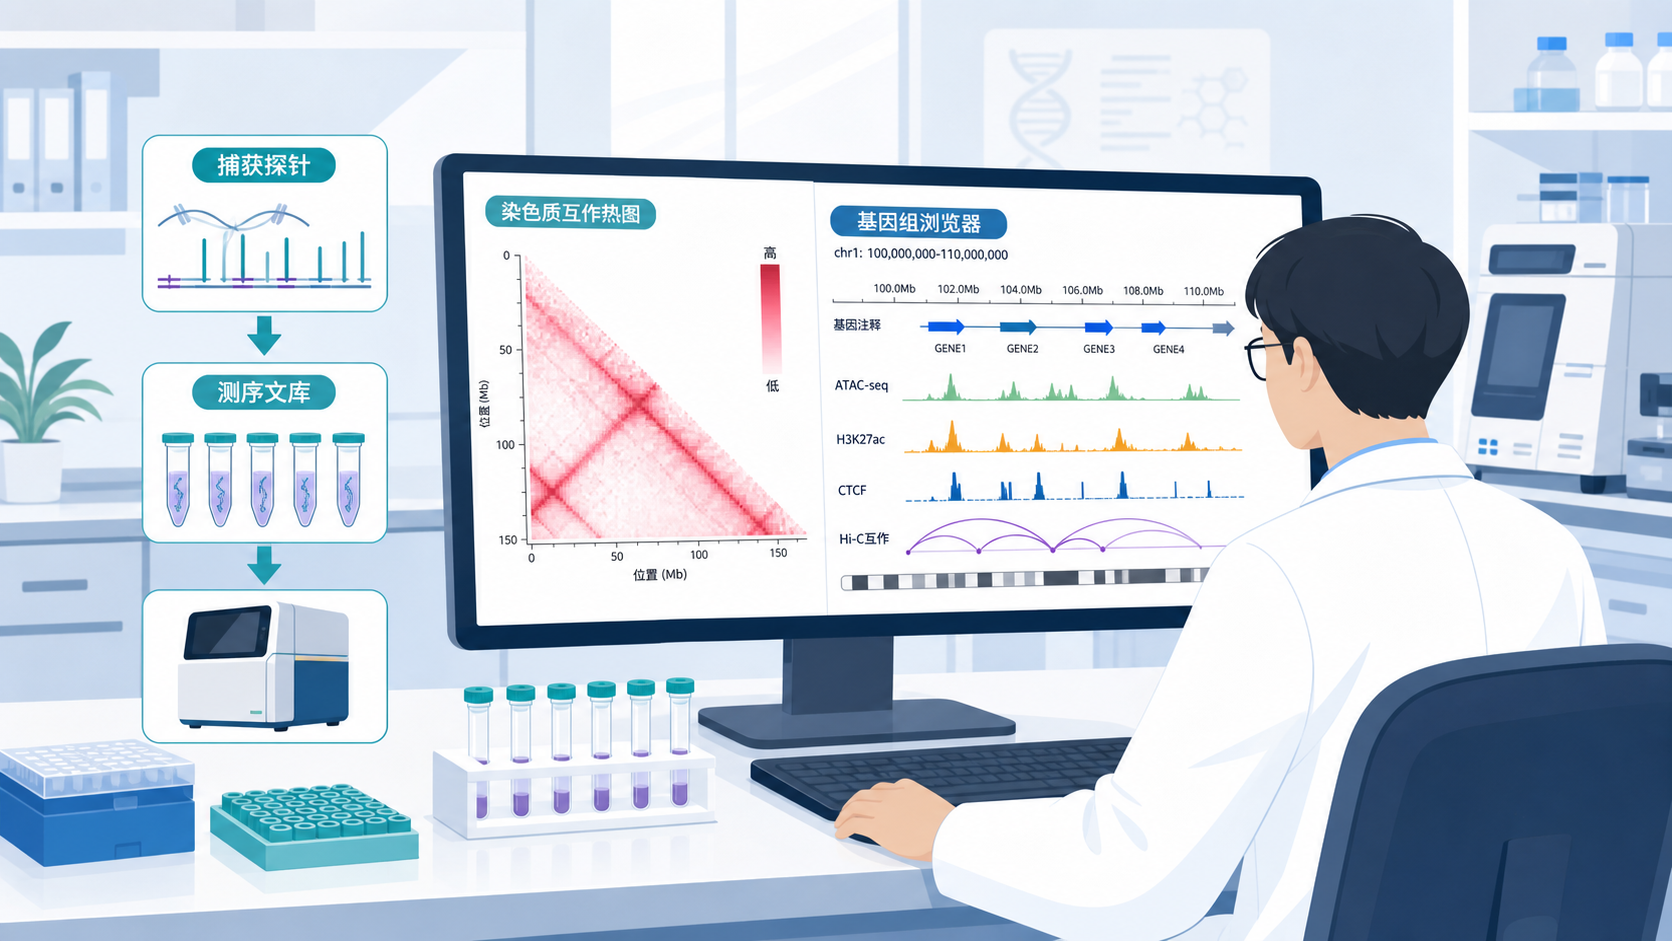
CaptureHi-C本质上是在Hi-C框架上加入捕获步骤。先构建染色质互作文库,再用探针富集特定区域。这样可以把测序资源集中到感兴趣的基因座、启动子、增强子或疾病关联位点上。
它的价值在于“提高局部分辨率”。 对于一个候选位点,普通Hi-C可能只能看到粗粒度互作。CaptureHi-C则能在相同测序量下,获得更密集的局部连接信息。
1.2 哪些研究最适合用
CaptureHi-C常用于以下场景:
- 疾病相关SNP的功能定位。
- 启动子与远端增强子的配对分析。
- 候选基因调控网络构建。
- 特定染色质区域的互作验证。
在肿瘤、免疫、发育和罕见病研究中,这类问题非常常见。当你已经有明确候选区,但想知道它“连着谁、调控谁”时,CaptureHi-C比全局探索更合适。
1.3 它和Hi-C、4C、5C的差别
简单理解:
- Hi-C偏全局,适合发现大范围结构。
- 4C偏单点,围绕一个视角位点做互作。
- 5C偏区域,适合特定片段网络。
- CaptureHi-C介于全局和靶向之间,兼顾广度和深度。
如果研究目标是“一个区域内多个候选位点的互作网络”,CaptureHi-C的平衡性最好。
2. 实验设计的核心:先把问题定义清楚
2.1 先选捕获区域,再决定探针策略
CaptureHi-C的成败,往往在设计阶段就定了。捕获区域不能只凭直觉选。要结合:
- GWAS位点或差异峰。
- 染色质开放性数据。
- H3K27ac、H3K4me1等增强子标记。
- RNA表达和eQTL信息。
捕获区域越清楚,后续互作解释越有生物学意义。 探针设计时,还要避免重复序列过高、GC极端偏倚和低复杂度区域。
2.2 文库质量决定下限
无论后续分析多漂亮,基础文库不过关,结果都不稳。需要重点关注:
- 交联是否充分。
- 酶切是否均匀。
- 连接效率是否合格。
- 文库片段大小是否合适。
- 测序深度是否足够。
经验上,靶向互作分析对局部富集很敏感,但对文库复杂度和重复率同样敏感 。重复率过高会直接压低有效信号。
2.3 分组和重复不能省
做机制研究时,至少要考虑生物学重复。不同样本间互作背景会有差异,尤其是不同细胞类型、不同处理条件和不同疾病状态。
建议在设计时提前想清楚:
- 对照组与实验组是否可比。
- 每组是否存在批次效应。
- 是否需要分细胞类型分析。
- 是否要联合表达组学验证。
没有重复的CaptureHi-C,更多像展示性数据,不适合做强结论。
3. 数据分析流程:CaptureHi-C靶向互作分析怎么做
3.1 原始数据先过质控,再谈互作
分析第一步不是找环,而是做数据清洗。常见流程包括:
- 测序质量控制。
- 接头去除和低质量序列过滤。
- 比对到参考基因组。
- 去除PCR重复。
- 识别有效互作对。
这一步的目标很明确:把能解释为真实染色质接触的片段对留下来。 任何低质量读段、异常比对和重复文库都会放大假阳性。
3.2 互作信号识别要考虑背景校正
CaptureHi-C不是简单数reads。因为捕获区域本身会带来富集偏差,必须进行背景建模。常见关注点包括:
- 距离衰减效应。
- 捕获效率差异。
- 区域可比性。
- 技术噪声与随机碰撞。
靶向互作分析的关键不是“有没有峰”,而是“这个峰是否显著高于背景”。 所以统计模型和归一化方法非常重要。
3.3 结果输出通常看这几类图
分析完成后,常见结果形式有:
- 柱状图,展示不同区域互作强度。
- 气泡图,突出显著互作对。
- 互作热图,直观看空间联系。
- 基因组浏览器轨道图,方便对照注释。
对于医学生和科研人员,最有用的不是图本身,而是图背后的结论:
- 目标增强子连向哪个基因启动子。
- 这个连接是否与表达变化一致。
- 是否支持疾病位点的调控机制。
3.4 从互作到机制,需要再做一层注释
CaptureHi-C只能告诉你“谁和谁接触”。真正的机制推断,还要结合:
- RNA-seq表达变化。
- ChIP-seq或ATAC-seq开放性证据。
- 转录因子结合位点。
- 功能实验,如敲低、CRISPR干预和救援实验。
没有功能验证的互作结果,只能算候选机制,不能直接等同于因果关系。
4. 实操中最常见的坑
4.1 只看显著性,不看生物学合理性
很多人拿到结果后,第一反应是筛最显著的互作。问题是,显著不等于有意义。远端高信号可能来自高重复区域、局部富集偏差,或者与研究主题无关。
更稳妥的做法是:
- 优先关注与目标基因表达一致的互作。
- 看互作是否落在已知调控元件上。
- 看是否跨样本重复出现。
- 看是否与文献和公开数据库一致。
统计显著性要和生物学证据一起用。
4.2 探针设计不合理,后面很难补救
探针覆盖不足,会直接导致目标区域漏检。覆盖过密,又可能增加成本和背景。设计时要在分辨率、成本和可解释性之间平衡。
尤其要注意:
- 避开高重复序列。
- 避免探针过度集中在单一片段。
- 结合目标区域长度和研究假设。
4.3 注释层级不够,结论会偏浅
很多分析停留在“某区域与某基因有互作”这一步。但文章写作和课题申报更需要进一步回答:
- 这个互作是否解释表型。
- 该基因是否位于同一路径。
- 是否存在上游转录调控链条。
CaptureHi-C的价值,最终体现在把一个位点连接到一个机制链条。
5. 让CaptureHi-C结果更容易转化为文章和课题
5.1 最佳写法是“位点-互作-表达-功能”四步走
高质量论文通常不会只展示互作图,而是串起完整逻辑:
- 某疾病位点或差异峰被捕获。
- CaptureHi-C发现其与候选基因启动子互作。
- 表达组学显示该基因发生变化。
- 功能实验验证该基因参与表型。
这条证据链越完整,文章说服力越强。
5.2 课题设计上,先假设后验证更高效
对于基金申请或科研立项,建议先明确一个核心问题:
- 这个位点是否通过远端调控影响目标基因。
- 这个互作是否在疾病状态下增强。
- 这个互作是否能解释某个表型改变。
然后再倒推实验路径。这样比“先做数据再找故事”效率高得多。
5.3 结果复用也很重要
CaptureHi-C数据不仅能服务当前项目,还能沉淀为长期资源。后续可继续用于:
- 候选基因筛选。
- 通路富集分析。
- 多组学整合。
- 新药靶点优先级排序。
这也是很多团队重视靶向互作分析的原因。一次实验,可能支撑多个后续课题。
5.4 用解螺旋产品把分析流程做顺
如果你在CaptureHi-C靶向互作分析中常卡在数据整理、结果注释和图表输出,解螺旋的科研工具和支持体系可以帮助你更快完成从原始数据到可发表结论的转化。对于需要频繁处理基因列表、结果归档和文献联动的团队,这类工具能明显减少重复劳动,让你把时间放回到实验设计和机制判断上。当分析链路更顺,CaptureHi-C的价值才真正落到科研产出上。
总结Conclusion
CaptureHi-C适合解决“明确靶点、深入机制”的问题。它比全局Hi-C更聚焦,比单点验证更系统。真正做好CaptureHi-C,不只是拿到互作图,而是把实验设计、背景校正、统计分析和功能验证串成一条证据链。只有这样,靶向互作分析才能从数据变成结论,从结论变成文章和课题。 如果你希望把这类分析做得更高效、更稳定,可以进一步了解解螺旋品牌的科研支持方案。
- 引言Introduction
- 1. CaptureHi-C是什么,适合解决什么问题
- 2. 实验设计的核心:先把问题定义清楚
- 3. 数据分析流程:CaptureHi-C靶向互作分析怎么做
- 4. 实操中最常见的坑
- 5. 让CaptureHi-C结果更容易转化为文章和课题
- 总结Conclusion