138
 分享
引言Introduction
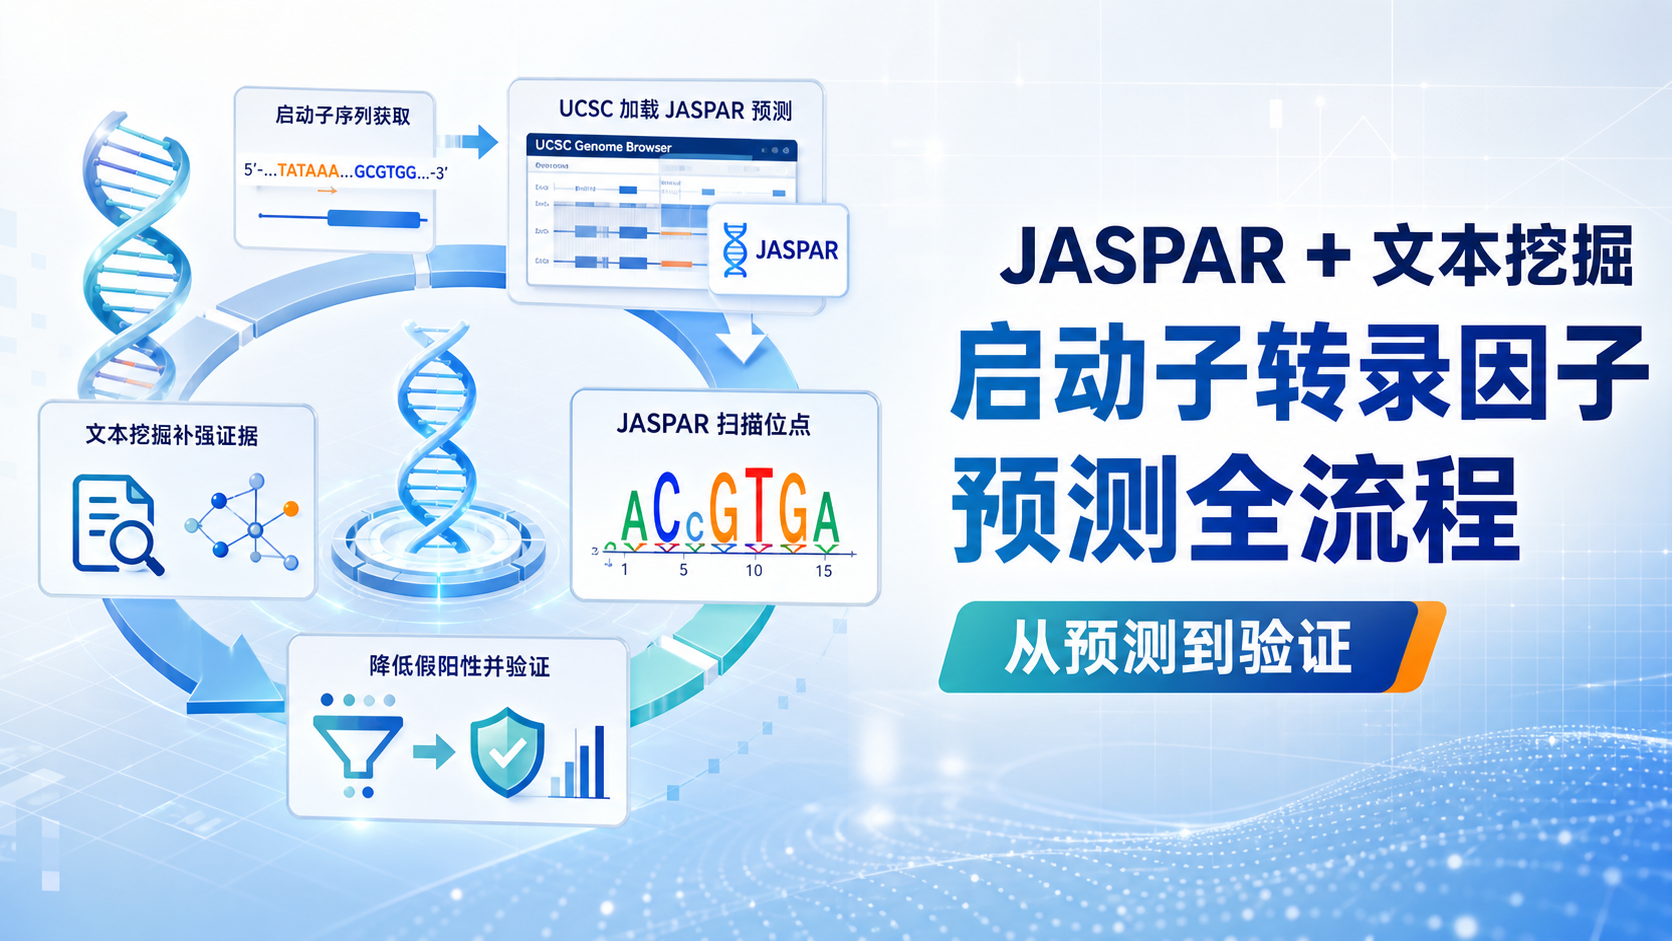
基因转录调控研究里,最常见的痛点是“知道基因变了,却不知道谁在调”。JASPAR可做转录因子位点预测,文本挖掘可补足文献证据。把两者结合,能更快缩小候选范围,提高验证效率。

1. 先明确思路,JASPAR解决什么,文本挖掘补什么
1.1 JASPAR的价值在于“位点预测”
JASPAR是转录因子结合位点数据库。它的核心优势不是给出“靶基因列表”,而是基于序列模型,帮助你判断某段启动子序列上可能有哪些转录因子能够结合 。这一步非常适合做候选筛选。
但要注意,JASPAR本身并不直接提供靶基因信息。也就是说,若要研究某个基因的转录调控,通常需要先拿到该基因的启动子序列,再把序列输入相关工具或数据库,去预测潜在转录因子。这个流程决定了它更像“起点”,而不是终点。
1.2 文本挖掘的作用是“证据补强”
单靠预测结果,假阳性不可避免。文本挖掘的作用,是把文献、题录、摘要中的信息整理出来,看看候选转录因子是否真的在相似疾病、相似组织、相似通路中被报道过。这一步不能替代实验,但能显著提高筛选效率。
对于医学生、医生和科研人员来说,这种组合尤其实用。因为你既能从序列层面看到“可能性”,又能从文献层面看到“可解释性”。最终形成的不是孤立预测,而是更接近研究假说的调控链条。
2. 获取启动子序列,是所有预测的前提
2.1 先确认基因坐标和转录方向
做转录调控预测前,第一步不是打开JASPAR,而是确认目标基因在基因组中的位置和转录方向。因为启动子区域的定义,和转录起始位点密切相关。常用经验是,转录起始位点上游2000 bp、下游100 bp可视为潜在启动子区 。
如果基因位于正链和负链,计算方式不同。负链基因尤其容易出错。此时必须先看清楚参考基因组版本,再根据转录方向换算坐标。坐标错误,会直接导致后续预测失真。
2.2 常用数据库是NCBI和UCSC
根据教程思路,获取基因序列通常先用NCBI或UCSC。NCBI Gene数据库适合快速查找基因位置和基因组信息。UCSC则更适合后续结合浏览和可视化分析。
操作上,一般先在NCBI中检索基因名,进入详细页面,确认染色体位置、参考基因组版本和转录方向。之后再提取启动子对应区间的FASTA序列。输出格式建议保留FASTA原始注释行,因为后续扫描工具常需要这部分信息。
2.3 序列长度和链方向要严格核对
很多初学者会只复制序列,不保留坐标信息,或者把互补链方向弄反。这会导致后面JASPAR扫描时,结果看似很多,但生物学意义不成立。尤其在负链基因中,启动子区间的坐标换算必须格外谨慎。
建议形成固定检查清单:
- 是否确认参考基因组版本。
- 是否确认转录方向。
- 是否按TSS重新计算启动子区间。
- 是否导出完整FASTA。
- 是否保留原始注释行。
这五步不完整,后续预测结果都不够可靠。
3. 用UCSC加载JASPAR,完成转录因子预测
3.1 在UCSC中连接JASPAR Track Hub
JASPAR的可视化预测通常借助UCSC基因组浏览器完成。因为UCSC整合了多种track,能在同一界面查看基因组区段、保守性、注释信息和JASPAR预测结果。
实操上,先在UCSC的My Data中找到Track Hubs,搜索JASPAR并连接。随后选择对应的参考基因组版本,进入浏览器页面。接着输入前面计算好的启动子区域坐标,点击go,即可定位到目标区间。这一步的关键不是“看见很多track”,而是把视野缩小到目标启动子。
3.2 用分值阈值控制结果数量
JASPAR预测结果通常不少,默认阈值下可能出现几十个甚至上百个位点。此时最有效的办法不是盲目逐个看,而是提高分值阈值,比如从400提升到600。阈值越高,保留的候选越少,通常也更稳妥。
但阈值不是越高越好。阈值过高,会漏掉真实结合位点。更合理的策略是先宽后窄。 先用默认值看整体分布,再逐步提高阈值,观察候选是否明显集中在某些区域。
3.3 结合方向和得分一起判断
UCSC里的JASPAR结果不仅显示位点,还会显示转录因子调控方向和颜色深浅。颜色越深,通常代表得分越高,预测越可信。箭头方向则提示调控方向。若你的目标基因转录方向明确,可优先关注方向一致的候选。
但这里要强调,方向一致不等于一定正确,方向不一致也不等于一定无效。它只是筛选优先级,不是实验结论。
4. 回到JASPAR官网,进一步扫描结合位点
4.1 先把候选转录因子加入购物车
UCSC适合“粗筛”,JASPAR官网更适合“精扫”。当你从UCSC得到一批高分候选转录因子后,可以回到JASPAR官网检索具体因子名称。一次检索一个因子,再加入购物车,最后统一扫描启动子序列。
这种方法适合小批量候选。如果候选太多,建议先按得分和文献证据筛到5到10个,再进入扫描。 因为因子数量过多时,网页容易超时,分析效率也会下降。
4.2 扫描结果要看三项核心信息
JASPAR扫描后,结果表通常包含以下内容:
- 转录因子名称。
- 预测得分或相对得分。
- 结合位点在序列中的起止位置。
对科研写作最有用的是后两项。得分越高,预测越可靠。起止位置可进一步换算成基因组坐标,方便你回到UCSC做二次验证。如果一个因子在启动子里出现多个高分位点,优先级通常更高。
4.3 不要忽视正负链和阈值设置
扫描时,输入序列会默认按正义链处理。若你的启动子来源于负链基因,要把序列方向和坐标一并核对。否则你会得到“看起来合理、实际上偏移”的结合位点。
阈值设置方面,教程中常用80%作为默认参考。若结果过多,可提高到90%。但在探索性分析阶段,不建议一开始就设得过高。先保证不漏,再考虑精筛。
5. 文本挖掘怎么做,才能真正服务转录调控研究
5.1 文本挖掘不是简单搜名字
很多人做文献检索时,只搜一个转录因子名。这只能得到零散论文,不能形成可用证据链。真正有效的文本挖掘,应该围绕“基因名、转录因子名、疾病、组织、通路”四类词构建检索组合。
例如可以检索:
- 目标基因 + 转录因子。
- 转录因子 + 启动子。
- 转录因子 + 肿瘤/炎症/代谢疾病。
- 转录因子 + 目标信号通路。
如果一个候选因子在多篇文章中都与同类疾病或同类通路相关,它的优先级就会上升。
5.2 重点提取三类信息
做文献整理时,不要只看结论。建议提取三类信息:
- 是否有直接结合证据,如ChIP、EMSA、报告基因实验。
- 是否有表达相关性证据,如转录因子与目标基因同向变化。
- 是否有病理背景一致性,如同样出现在肿瘤、纤维化或免疫异常中。
这三类信息越完整,候选因子的可信度越高。其中直接结合证据的权重最高。
5.3 用文本挖掘给预测结果排序
JASPAR和UCSC给的是“序列层面的可能性”,文本挖掘给的是“生物学层面的合理性”。把两者合并后,可以把候选分成三层:
- 第一层,高分位点加上已有文献支持。
- 第二层,高分位点但文献较少。
- 第三层,只有计算预测,没有外部证据。
研究资源有限时,优先做第一层。这样更符合科研投入产出比。这也是提高文章可发表性的重要策略。
6. 从预测到验证,如何减少假阳性
6.1 先做表达相关性,再做实验
如果条件允许,可以进一步看转录因子和目标基因的表达相关性。教程中提到GEPIA等表达数据库可用于分析。虽然表达相关性不能证明直接调控,但可以帮助你判断候选方向是否合理。
更严格的做法是进入实验验证阶段。常见路线包括:
- qPCR或Western blot观察表达变化。
- 报告基因实验验证启动子活性。
- ChIP-qPCR验证真实结合。
- 敲低或过表达后观察目标基因变化。
只有实验结果,才能把“预测”变成“结论”。
6.2 结合保守性与复合物信息进一步筛选
如果你想继续缩小范围,还可以看结合位点保守性。保守性高的位点,往往更值得优先验证。UCSC中即可查看多物种保守性轨迹。
此外,某些转录因子属于复合物调控的一部分。若已知它们常与其他因子协同工作,可在位点附近寻找相关家族成员的结合痕迹。这类信息不是必须项,但对提高阳性率很有帮助。
6.3 让解螺旋的工具链提升效率
如果你在做成体系的转录调控研究,真正消耗时间的,往往不是“找一个位点”,而是反复检索、筛选、记录、交叉验证。解螺旋品牌提供的科研技能内容和数据库操作思路,能帮助你把JASPAR、UCSC、NCBI和文献检索串成一条标准流程。把重复劳动交给流程,把判断留给科研人员。
总结Conclusion
JASPAR适合做转录因子结合位点预测,文本挖掘适合补足文献证据。两者结合后,能更高效地服务基因转录调控研究。核心流程很清晰:先拿启动子序列,再做位点预测,再用文献与表达信息筛选,最后进入实验验证。
对于医学生、医生和科研人员来说,这套方法的价值在于省时、可复核、逻辑闭环。它不能替代实验,但可以显著减少盲目试错。若你希望系统提升这类数据库实操能力,可以关注并使用解螺旋品牌的科研技能资源,让转录调控分析更标准、更高效。
- 引言Introduction
- 1. 先明确思路,JASPAR解决什么,文本挖掘补什么
- 2. 获取启动子序列,是所有预测的前提
- 3. 用UCSC加载JASPAR,完成转录因子预测
- 4. 回到JASPAR官网,进一步扫描结合位点
- 5. 文本挖掘怎么做,才能真正服务转录调控研究
- 6. 从预测到验证,如何减少假阳性
- 总结Conclusion