93
 分享
引言Introduction
SCI生存曲线图看似简单,但分组、检验、标注和图例规范 一旦出错,就会直接影响结果可信度。对医学生、医生和科研人员来说,真正难点不在“画出图”,而在“画得对、说得清、能复现”。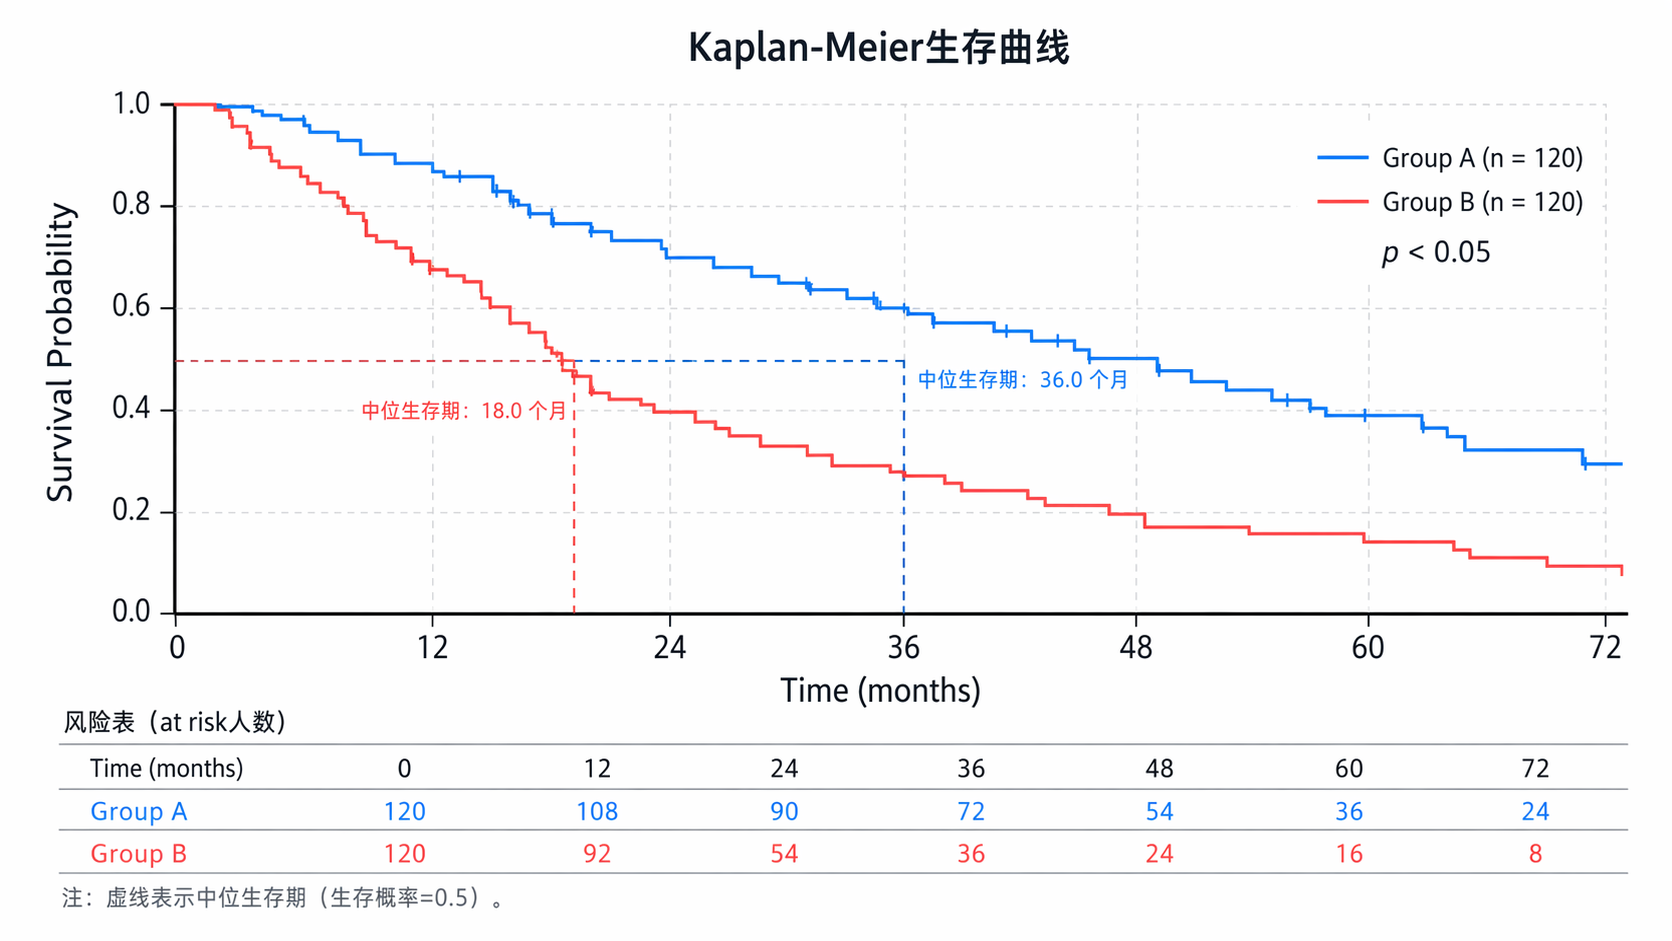
1. 生存曲线图在SCI中的核心价值
1.1 先回答“为什么要画”
生存曲线最常用于比较不同组别的生存概率随时间变化 。在肿瘤、预后标志物、治疗反应和风险分层研究中,它是最直观的结果展示方式之一。它不是装饰图,而是统计结论的可视化表达。
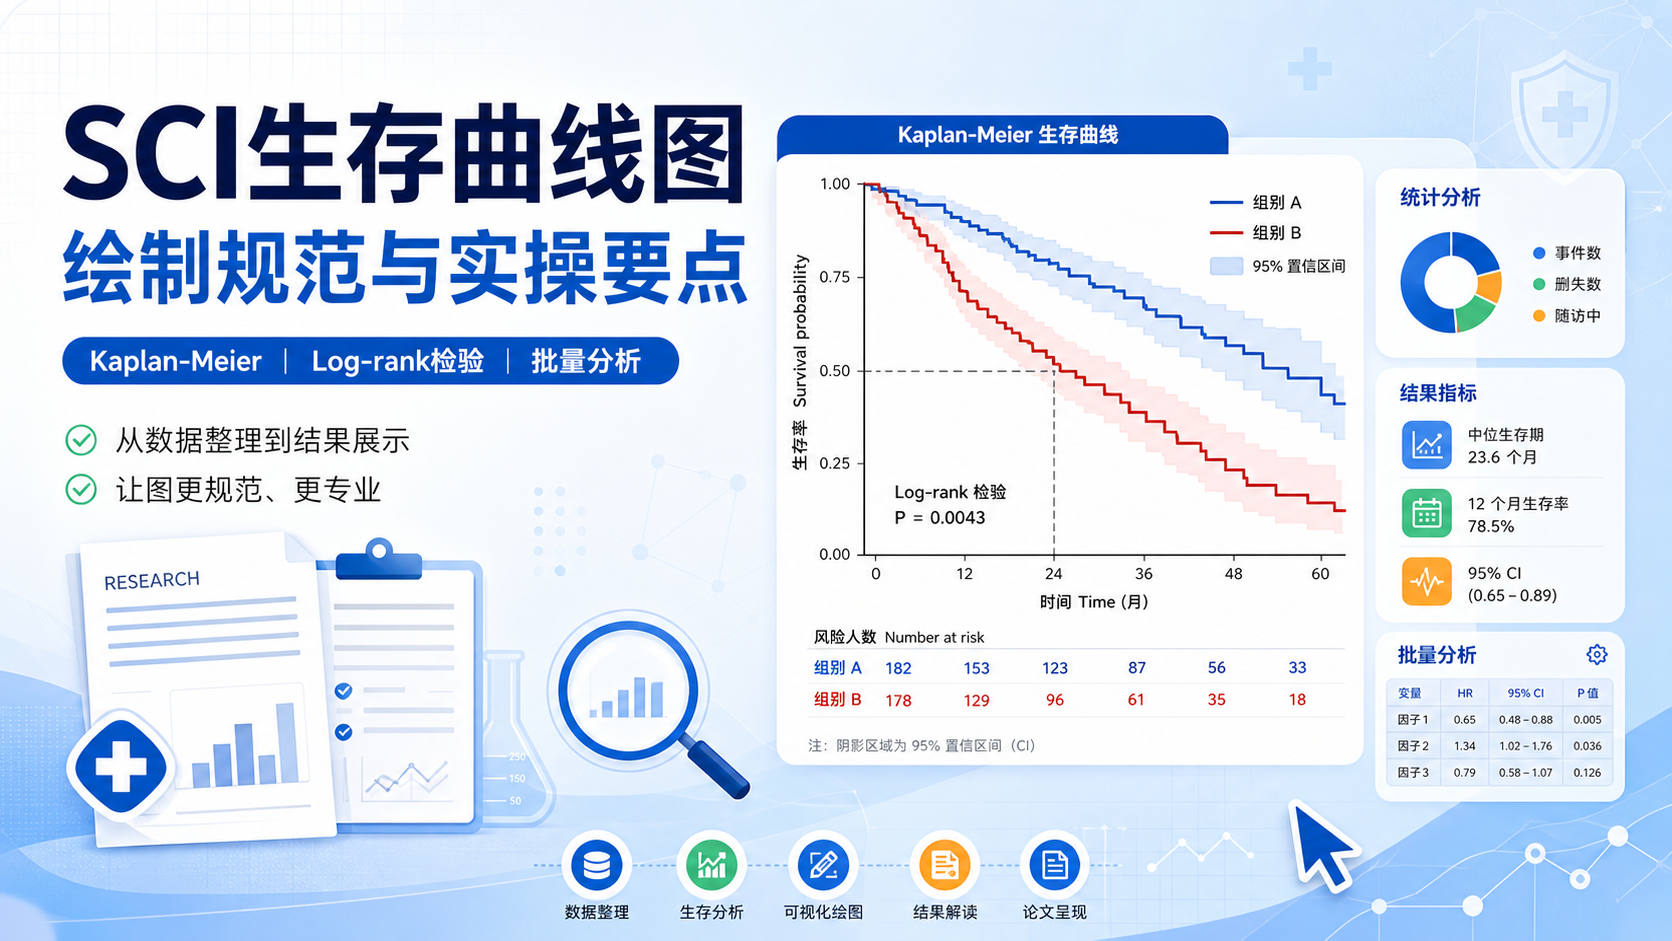
Kaplan-Meier曲线的优势是清晰、易读,适合展示两组或多组样本的生存差异。常见指标包括总生存期、无进展生存期、无病生存期等。图中通常还会配合Log-rank检验,给出组间差异的P值。
1.2 SCI审稿人最关注什么
审稿人通常会看四点。
- 分组依据是否合理。
- 统计检验是否匹配。
- 图中是否包含风险表、置信区间、中位生存线。
- 图例和坐标是否清楚、规范。
如果分组逻辑不清,或者图例与正文不一致,整张图的说服力会明显下降。
尤其是生物标志物研究,表达量按中位数二分法、最佳截点法、临床阈值法,三者的适用场景并不相同,不能混用。
1.3 统计原则先于作图
很多问题不是出在美化,而是出在分析前。生存分析至少要有两个核心变量。
- 时间变量,表示随访时长。
- 结局变量,表示事件是否发生。
在R中通常使用Surv(time, status)构建生存对象,再用survfit()拟合模型。没有正确的时间和事件定义,曲线再漂亮也没有统计意义。
2. 生存分析前的数据整理原则
2.1 变量编码必须统一
生存分析中最常见的错误,是事件编码混乱。比如有的数据用1表示死亡,0表示删失;有的数据正好相反。若不先核对原始数据字典,后续结果可能完全颠倒。
建议在分析前固定检查以下内容。
- 时间单位,是天、月还是年。
- status编码,哪一个值代表事件。
- 分组变量是否为因子。
- 是否存在缺失值和异常值。
分组变量一定要显式设置水平顺序。 例如高表达组和低表达组,若不处理因子顺序,图例顺序和曲线颜色可能与预期不一致。
2.2 常见分组策略要用对
生存曲线常见分组方式包括。
- 中位数分组。
- 四分位数分组。
- 临床阈值分组。
- 联合分组。
知识库中的示例就采用了中位数分组。比如某基因表达量高于中位值定义为高表达组,低于或等于中位值定义为低表达组。这个方法简单、可复现,也便于批量分析。
但要注意,中位数分组不等于最佳生物学切点 。如果研究目标是机制探索,可以接受;如果目标是临床预测,则需要进一步验证阈值稳定性。
2.3 先拟合,再解释
拟合生存模型后,建议先查看模型摘要。常见信息包括。
- 事件数。
- 中位生存期。
- 95%置信区间。
这些信息能帮助判断样本是否足够、组间是否平衡。样本量过小、删失过多、事件数不足,都会降低曲线结论的稳定性。
3. SCI生存曲线图规范的绘图要点
3.1 单因素生存曲线的标准配置
对单因素Kaplan-Meier图,建议至少保留以下元素。
- 生存曲线。
- p值。
- 风险表。
- 中位生存时间线。
- 坐标轴标题。
在ggsurvplot()中,pval = TRUE可显示P值,risk.table = TRUE可显示number at risk。风险表非常重要,因为它能告诉读者每个时间点仍有多少样本处于风险集中。
知识库中还提到可加入50%中位生存线。这个做法有助于读者快速判断中位生存时间。对医学论文来说,这是一个很实用的规范化标注。
3.2 颜色和线型要服务于阅读
颜色不是越多越好。一般两组比较时,红蓝配色最直观。多组比较时,颜色数不要超过可辨识范围。建议使用对比明显、色盲友好的配色。
线型也要统一。
- 实线用于主曲线。
- 虚线用于中位生存线。
- 统一线宽,避免视觉失衡。
图例名称必须和分组名称一致,不能出现“high/low”和“case/control”混用。 如果正文写的是高表达组,图例却显示治疗组,读者会立刻产生疑问。
3.3 图例制作要点
SCI中图例不是补充项,而是图的一部分。建议写清楚以下内容。
- 分组依据。
- 颜色对应关系。
- 检验方法。
- 样本量信息。
如果是双因素联合分组,图例更要规范。知识库中双因素生存曲线的思路是先将两个基因按中位数二分,再合并成四组,例如11、12、21、22。这类图最容易出错的地方,是组别命名和颜色顺序。
建议在图例中明确写出。
- 低低组。
- 低高组。
- 高低组。
- 高高组。
不要只保留数字编码,否则读者很难直接理解生物学含义。
4. 统计检验与结果解释不能忽略
4.1 Log-rank检验怎么用
Kaplan-Meier曲线最常配合Log-rank检验,用于比较组间生存分布是否存在差异。它回答的是“曲线整体是否不同”,而不是“某一时点是否不同”。
P值小于0.05,只能说明存在统计学差异,不能直接等于临床意义显著。 还要结合HR、置信区间和样本量综合判断。
4.2 曲线交叉时要谨慎
知识库特别提醒,生存曲线出现交叉时不能简单下结论。若P值大于0.05,通常不再强调组间差异。若P值小于0.05但曲线交叉,应进一步考虑。
- 是否存在非比例风险。
- 是否需要分层分析。
- 是否存在亚组效应。
不建议为了“好看”去截掉交叉后数据。 这种做法不符合统计原则,也不适合SCI发表。
4.3 多组比较要控制展示复杂度
双因素联合分析常会得到四组结果。若四组都放在同一张图里,图面会很拥挤。更合理的做法是先做整体比较,再展示重点组间的两两比较。
知识库中提到两种策略。
- 四组整体一次性比较。
- 关键组之间进行两两比较。
推荐先整体,后局部。 这样逻辑更清晰,也更符合论文叙事顺序。
5. 批量生存曲线绘制的实操思路
5.1 为什么批量分析更常见
在转录组、蛋白组或多基因候选筛选中,常常需要一次分析多个基因。逐个手工绘图效率很低,也不利于统一格式。此时应使用循环或列表批量生成图像。
知识库中的做法是。
- 提取基因列表。
- 对每个基因按中位数分组。
- 逐个拟合
survfit模型。 - 用
ggsurvplot批量出图。 - 结果保存到list,再统一导出。
批量绘图的关键不是“快”,而是“格式一致、规则统一、结果可追溯”。
5.2 结果筛选要有阈值
批量分析常伴随多重比较问题。知识库示例中会按P值筛选结果,保留有统计学意义的基因再进一步展示。这个思路可以减少无效图像,也便于论文结果组织。
但需要注意,筛选阈值不能替代独立验证。 如果只是探索性分析,结果应在外部队列或独立数据集中复核。
5.3 输出图像时要保留关键信息
批量生存图常见问题是信息不足。建议每张图至少保留。
- 曲线名称。
- P值。
- 风险表。
- 样本量。
- 图例。
如果文章要求更规范,还可加入HR和95%CI,但前提是统计模型确实计算过。不要为了版面完整而补写不存在的数据。
6. 让SCI生存曲线图更专业的细节
6.1 字体、坐标和标题统一
图中字体要统一,标题不要过长。坐标轴建议清楚标明时间单位。比如“Time in months”或“Overall survival time, days”。单位不清会直接影响结果解读。
如果一篇文章中有多张生存曲线,必须保证。
- 同一字体。
- 同一配色逻辑。
- 同一图例格式。
- 同一P值呈现位置。
6.2 避免常见错误
以下问题在投稿中很常见。
- status编码写反。
- 分组顺序错乱。
- 曲线颜色与图例不一致。
- 风险表缺失。
- 图例过长,遮挡曲线。
- 只给图,不解释统计方法。
这些问题不是“小瑕疵”,而是影响论文可信度的关键点。
6.3 用规范化工具减少返工
对于需要高频输出图表的科研工作,最好使用可复现的脚本和统一模板。这样可以避免每次手工修改导致的版本混乱。
对团队协作来说,标准化模板还能显著减少返工时间。
如果你希望把生存曲线图做得更稳定、更统一,使用解螺旋的标准化分析与出图方案,可以把分组、统计检验和图例格式一次性规范好,减少重复修改,让结果更适合直接进入SCI稿件流程。
总结Conclusion
SCI生存曲线图规范的核心,不是“画得花”,而是统计正确、图例清楚、结论可复现 。从数据编码、分组策略、Log-rank检验,到风险表、中位线和颜色顺序,每一步都要严格一致。对于医学生、医生和科研人员而言,掌握这些要点,才能真正提高图表的发表质量与说服力。若你正在准备论文图表,建议直接采用标准化流程,并结合解螺旋的专业支持,快速完成符合投稿要求的生存曲线图制作。
- 引言Introduction
- 1. 生存曲线图在SCI中的核心价值
- 2. 生存分析前的数据整理原则
- 3. SCI生存曲线图规范的绘图要点
- 4. 统计检验与结果解释不能忽略
- 5. 批量生存曲线绘制的实操思路
- 6. 让SCI生存曲线图更专业的细节
- 总结Conclusion