117
 分享
引言Introduction
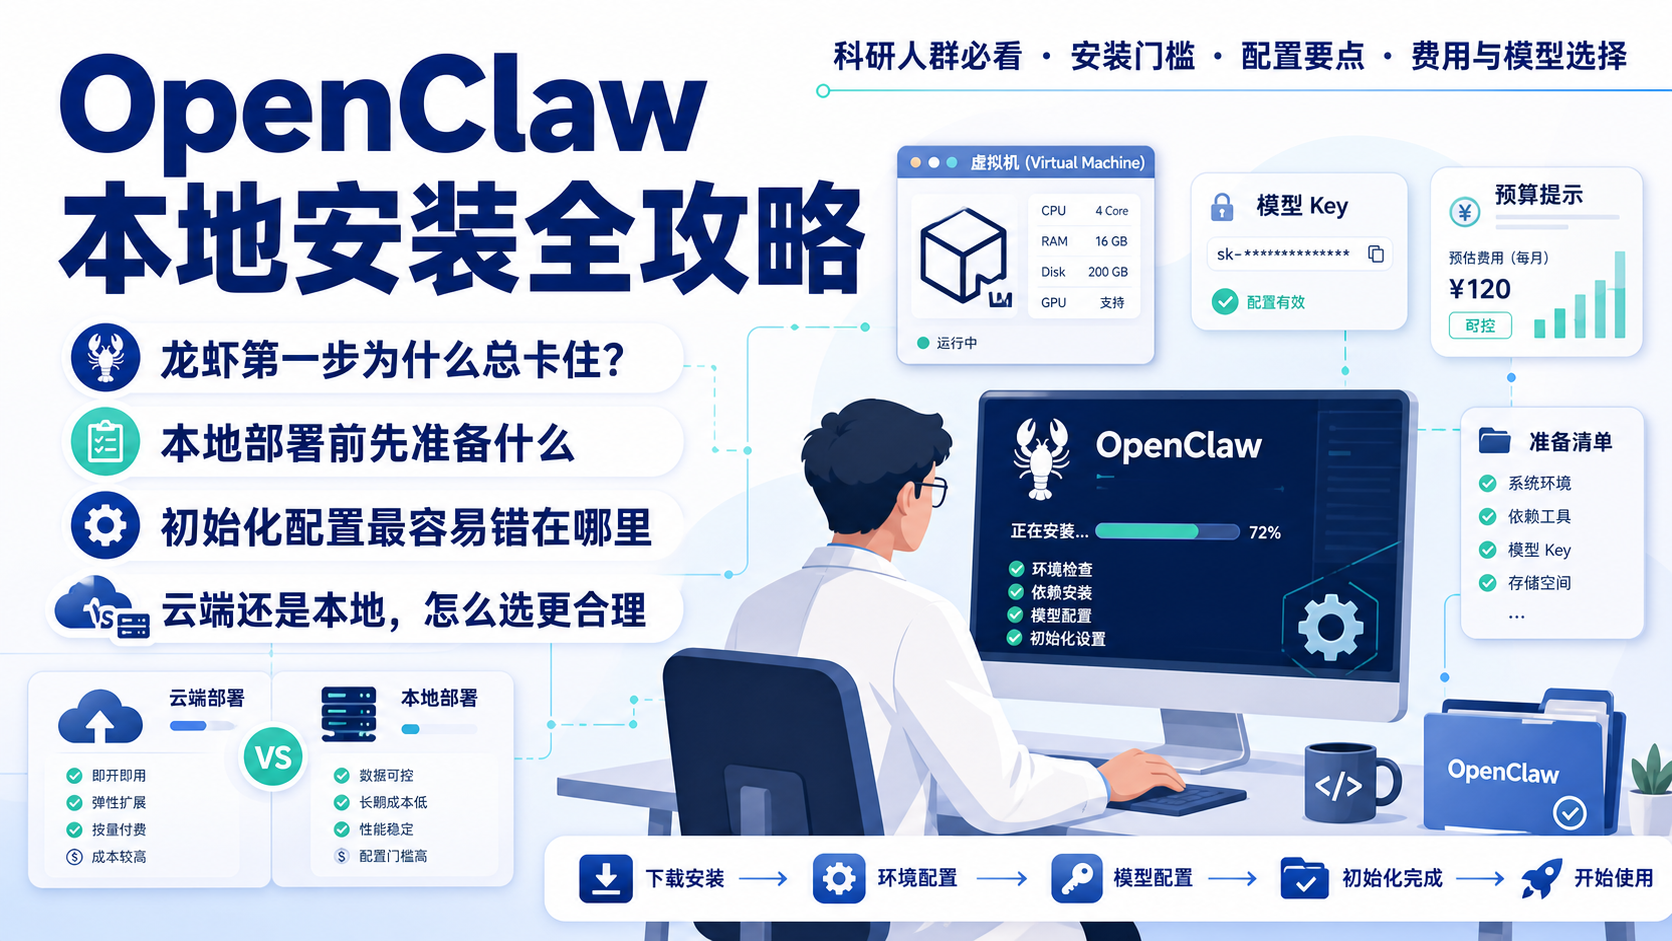
很多医学生、医生和科研人员都想用龙虾 提升综述、标书和文献整理效率,但真到安装时,却常卡在命令行、模型 Key 和初始化配置上。如果你连软件都装不顺,后面的科研自动化就无从谈起。
1. 为什么很多人卡在龙虾的第一步
1.1 OpenClaw 不是“点开就能用”的传统软件
从知识库信息看,OpenClaw 本质上更接近一个面向程序员友好的工具。它在 GitHub 仓库里,适合有代码基础的人上手。但对没有编程经验的人来说,第一关往往不是使用,而是安装。
它的安装方式偏命令行。
这意味着你不能简单地双击完成。
如果电脑基础薄弱,甚至可能出现“找到了官网,却不知道下一步怎么做”的情况。
1.2 为什么科研人群更需要先理解门槛
科研工作者对工具效率要求高,但也更怕折腾。
尤其是需要频繁处理综述、meta 分析、标书和长文本生成的人,工具一旦配置好,收益很明显。但如果安装不稳,时间会被反复消耗在报错和调试上。
知识库也提到,现在已经有公司提供安装好的版本,例如腾讯的 qclaw。
这类客户端可以双击安装后直接使用,但通常仍需配置大模型 key。
所以,“能安装”只是第一步,“能稳定初始化”才是关键。
2. 龙虾本地安装前要先准备什么
2.1 先判断你适合本地还是云端
如果你是高频用户,比如经常做科研写作、持续调用模型,本地安装龙虾更有长期价值 。
如果你只是低频使用,也可以先等别人配好环境,直接使用成熟配置。
知识库给出的建议很明确。
本地推荐用一台闲置电脑专门养虾。
4GB 内存以上即可,不一定需要高性能主机。
2.2 为什么建议用虚拟机或隔离环境
龙虾本质上会和文件、模型接口、工作目录产生交互。
如果你担心影响主机文件,建议用虚拟机把环境“圈起来”。
这样更安全,也便于出问题时回滚。
对于客户端方案,权限一般会限制在绑定文件夹内。
这类方式更适合对系统安全敏感的人。
核心原则是先隔离,再配置。
2.3 先准备好大模型 Key 和预算
知识库明确提到,龙虾需要配置一些大模型 key。
如果不是本地化模型,就会消耗 API token。
这意味着使用成本和调用量有关。
如果你本地部署大模型,就不需要为 token 持续付费。
但知识库也说明了,本地部署成本目前仍然较高,后续会逐步下降。
因此,先评估预算,再决定部署方式,是更稳妥的做法。
3. OpenClaw 本地安装的核心步骤
3.1 先找到正确的安装路径
在官网或 GitHub 仓库确认版本后,先判断安装方式。
知识库提到,OpenClaw 的原生安装偏命令行。
如果你不熟悉终端操作,先不要急着直接硬装。
更适合科研人员的做法是先选择安装好的客户端版本。
例如已经封装好的 qclaw。
这类方案能显著降低第一次部署失败的概率。
3.2 按环境完成基础部署
如果你选择的是本地安装,建议按下面顺序执行:
- 准备一台专用电脑或虚拟机。
- 确认系统可正常联网。
- 按官方或客户端说明完成安装。
- 检查软件是否能正常启动。
- 再进入模型 Key 配置。
这个顺序很重要。
不要一开始就急着配置所有功能。
先保证程序可以打开,再逐步补齐能力。
3.3 安装后先做最小化验证
安装完成后,不要立刻上复杂任务。
先做最小化验证,比如检查:
- 软件是否能正常启动。
- 绑定目录是否可读写。
- 大模型接口是否可调用。
- 基础指令是否有响应。
如果这四项都通过,说明你的基础环境已经成型。
这一步的目标不是跑满功能,而是确认链路通畅。
4. 初始化配置时最容易出错的地方
4.1 大模型 Key 配置不完整
知识库提到,很多安装好的客户端虽然能直接用,但还是要配置大模型 key。
这一步最容易出问题。
常见情况是 key 填了,但模型不可用。
建议你先确认三件事:
- Key 是否有效。
- 账号是否有可用额度。
- 模型名称是否和平台要求一致。
如果你用的是云端模型,token 会持续消耗。
因此,配置前先确认计费逻辑,能避免后续“能跑但一直扣费”的情况。
4.2 工具默认没有 skill,能力有限
知识库有一个很关键的判断。
现在的龙虾还是“素虾”,也就是没有装技能。
这意味着它并不是开箱即用的全能助手。
很多任务需要你先下指令,再逐步优化。
例如文献整理、长文本生成、结构化写作,都需要明确任务提示。
不要期待它默认就会自动完成所有科研流程。
4.3 初始化后要先建立工作目录
对于科研用户来说,目录管理很关键。
建议你一开始就固定好工作目录,避免文件散乱。
特别是文献、输出稿、临时文件和配置文件,最好分开。
常见做法是建立四个文件夹:
- input,用于原始资料。
- output,用于结果稿。
- temp,用于临时文件。
- config,用于配置文件。
这样后续做综述、meta 分析或标书时,路径清晰,出错率也会下降。
养龙虾不是把软件装上,而是把工作流搭起来。
5. 哪些用户更适合现在开始养龙虾
5.1 高频科研用户更容易拿到红利
知识库明确指出,现在进入 OpenClaw 时代,对高频用户是有红利的。
原因在于很多代码问题、工具使用问题,本质上都是可优化的流程问题。
只要你使用频率高,前期投入会很快被效率收益覆盖。
特别是下面几类人,收益更明显:
- 每周都要读大量文献的研究生。
- 经常写综述、系统评价、meta 分析的医生。
- 需要反复整理资料和输出文档的科研人员。
5.2 低频用户可以先观察成熟配置
如果你平时很少用,也不必急着自己从零部署。
知识库提到,现在也有“安装好后直接可用”的客户端方案。
对于低频用户,先用成熟配置更省时间。
这类用户的核心需求不是研究安装,而是尽快完成科研任务。
所以,选对入口比追求最复杂的部署更重要。
6. 费用、模型和使用方式怎么选更合理
6.1 云端模型适合先上手
知识库提到,推荐两款云端性价比好的模型是 MiniMax m2.5 和 Kimi k2.5。
海外模型贵一些,但性能往往更好。
如果你刚开始使用龙虾,云端方案通常更容易起步。
对于非程序员用户,知识库认为,约两百美金的 GPT 套餐基本够用。
这说明初期不一定要追求最重配置。
先让工具跑起来,再谈优化。
6.2 本地部署适合长期高频使用
如果你长期高频调用,成本控制会更重要。
本地部署虽然前期门槛高,但一旦稳定,后续就少了 token 持续消耗的问题。
这对长期科研项目更友好。
不过,知识库也强调,本地部署成本现在仍偏高。
因此最合理的策略往往是:
先用云端验证流程,再决定是否切换本地。
总结Conclusion
OpenClaw 这类龙虾 工具,对科研人群的价值很明确。
它适合高频处理综述、meta 分析、标书和长文本任务的人。
但它的真实门槛也很明确,安装偏命令行,初始化要配 Key,还要管理工作目录和模型能力。
如果你想少走弯路,关键不是“先学会所有功能”,而是先把安装和初始化配置做对。
对于没有编程基础的人,优先选成熟客户端、隔离环境和清晰目录结构,会更稳。
如果你希望直接把龙虾用到科研中,解螺旋提供的龙虾配置、每周更新和云端试用,可以帮助你更快完成初始化,减少试错成本,尽早进入可用状态。
- 引言Introduction
- 1. 为什么很多人卡在龙虾的第一步
- 2. 龙虾本地安装前要先准备什么
- 3. OpenClaw 本地安装的核心步骤
- 4. 初始化配置时最容易出错的地方
- 5. 哪些用户更适合现在开始养龙虾
- 6. 费用、模型和使用方式怎么选更合理
- 总结Conclusion