69
 分享
引言Introduction
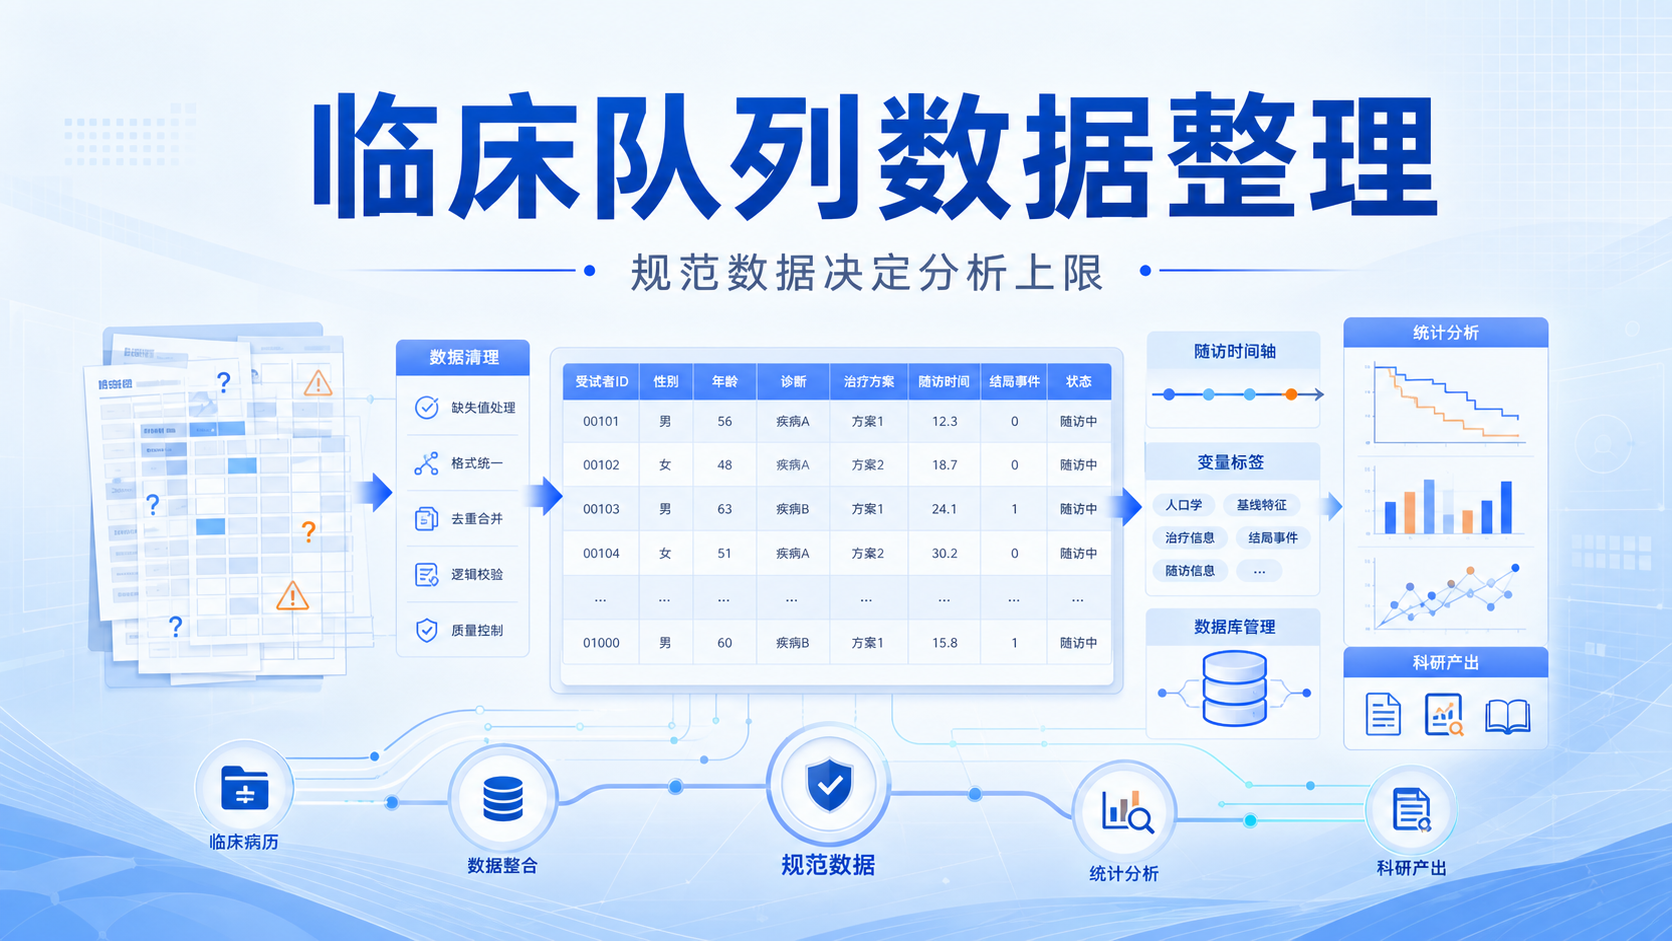
临床研究效率低,常见原因不是不会统计,而是临床数据库整理 不到位。数据分散在病历、Excel、随访表里,重复录入、漏项、难核对,最后直接拖慢分析和投稿。建立规范数据库,才能让数据可追溯、可分析、可复用。
1. 为什么临床数据库会直接影响研究效率
1.1 数据越散,时间成本越高
临床患者信息天然高维、复杂。症状、体征、检查、治疗、随访,任何一项都可能影响结论。如果数据分散在不同表格里,研究者就会把大量时间花在找数据、补数据、核对数据上。
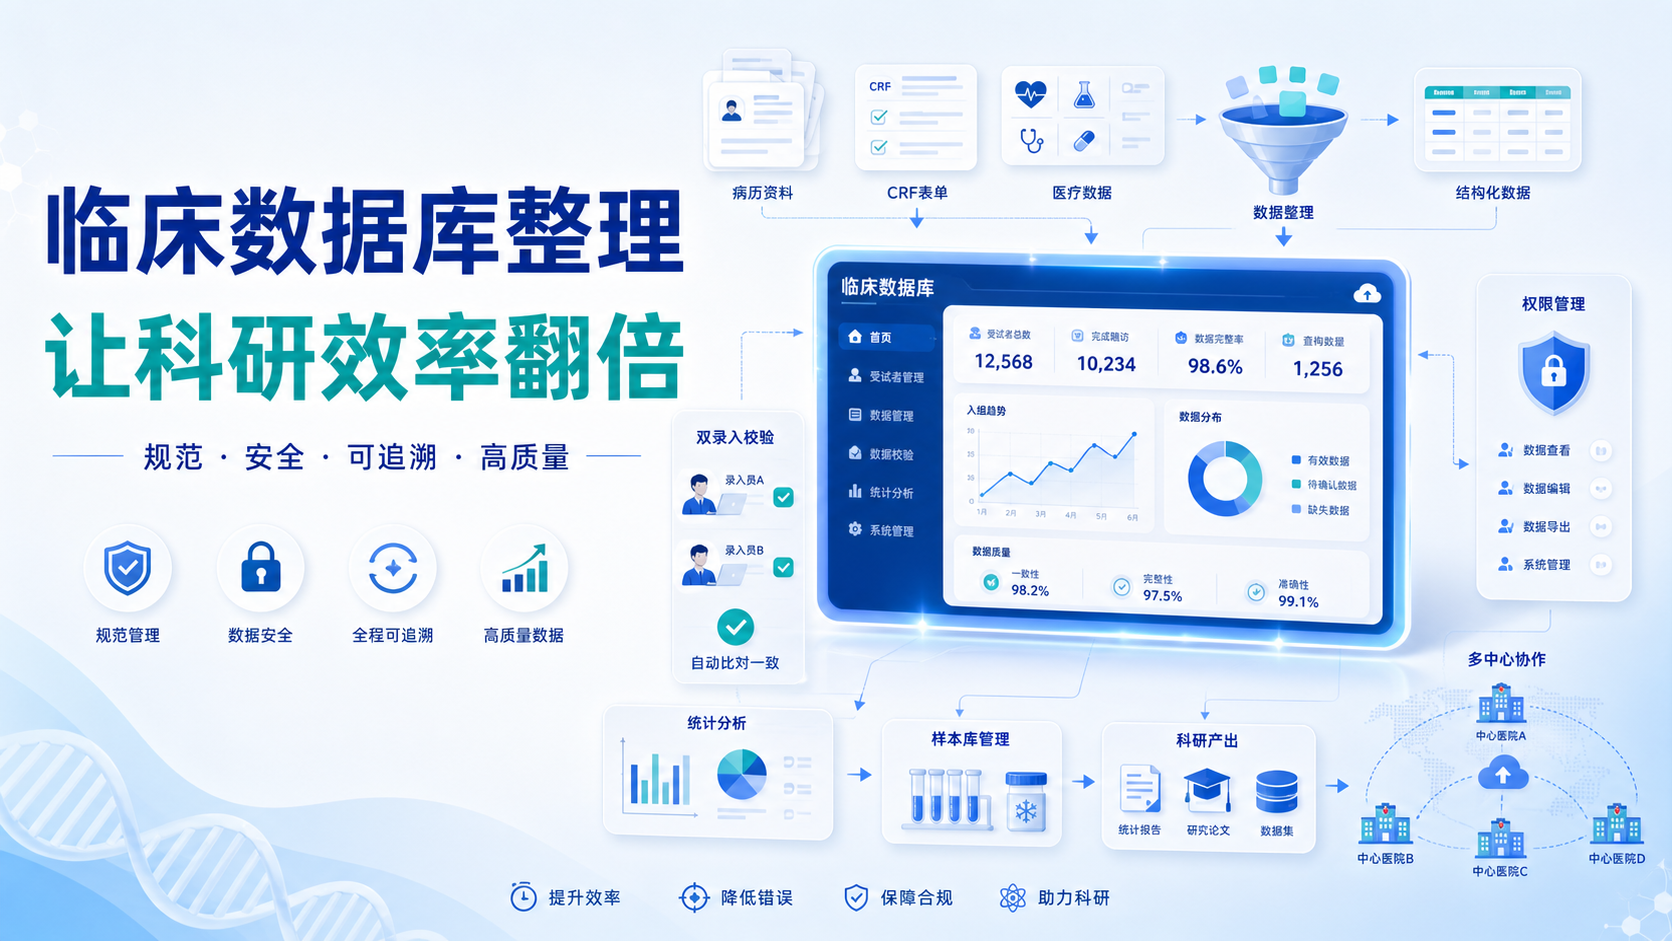
临床数据库整理的核心价值,就是把原始资料变成可直接分析的数据资产。 一旦字段定义统一,后续导出、筛选、统计都会更快。
1.2 规范数据库比“临时表格”更适合科研
很多团队习惯用Excel直接录入,但Excel常见问题也最明显。比如多层表头、重复记录、字段不统一、难以范围核查。对回顾性研究来说,短期看似方便,长期却会增加返工。
相比之下,规范数据库更强调长期存储、统一管理和安全性。对于科室常见病、多发病或优势病种,建立自己的数据库,通常比临时整理表格更高效,也更利于持续积累。
1.3 数据质量决定研究产出质量
数据库不是越大越好,而是越规范越有价值。如果原始数据质量不高,后续统计分析和论文结论都会受影响。 所以数据管理应贯穿研究全过程,而不是收集完后再补救。
在实践中,定期抽查、双人录入、原始病历核对,都是提升质量的关键步骤。高质量数据能显著减少后期清洗时间,这是临床数据库整理最直接的效率收益。
2. 临床数据库整理的关键步骤
2.1 先明确研究目的,再设计变量
建库前必须先想清楚:这个数据库要回答什么问题。是治疗疗效、预后分析,还是随访管理、并发症监测。不同目的,对变量的要求完全不同。
临床数据库整理不是把所有信息都装进去,而是把“必要且可分析”的变量规范化。 一般建议优先覆盖以下内容。
- 基本人口学信息,如ID、年龄、性别。
- 诊断与治疗信息,如分期、手术、用药、实验室检查。
- 补充调查信息,如营养、生活质量、心理状态。
- 随访信息,如复发、并发症、生存结局。
2.2 用CRF把临床问题转成标准字段
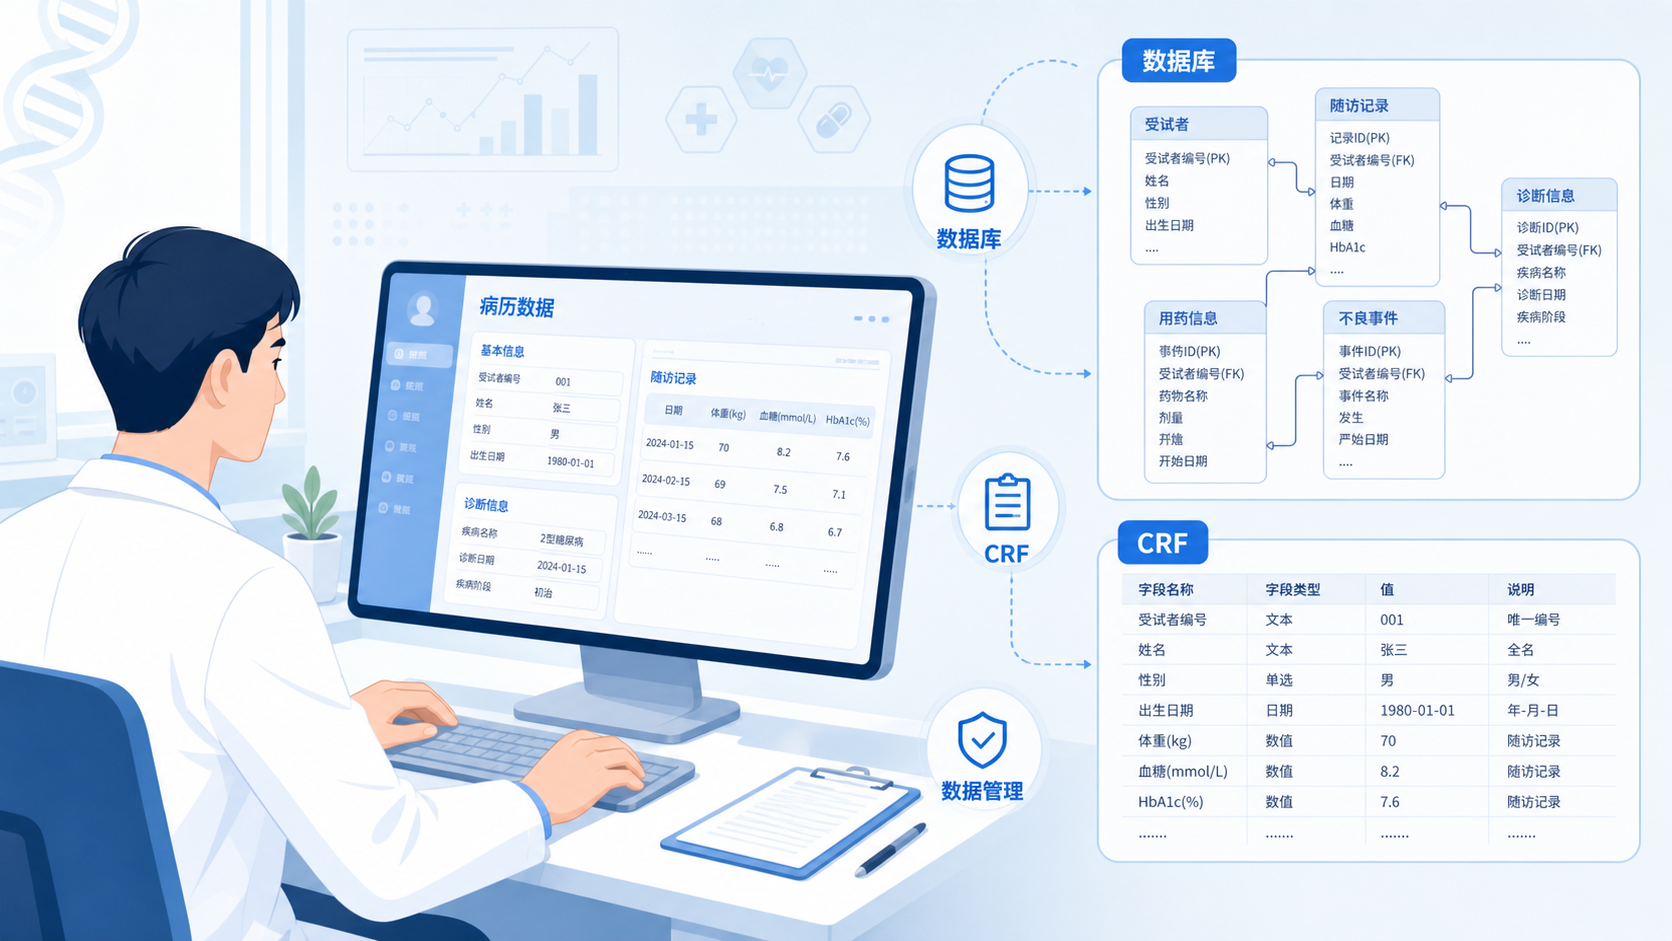
CRF是临床数据库整理中的核心工具。它本质上是把研究方案翻译成可记录、可核查、可统计的表单。设计时要注意变量定义清晰,问题尽量标准化,避免歧义。
一个好的CRF,应满足两个要求。第一,不漏掉关键变量。第二,尽量少收集无关变量。 这样既能保证分析质量,也能减少录入负担。
2.3 从小规模开始,逐步完善
数据库建设不建议一开始就追求“大而全”。更稳妥的方法,是从单病种、小样本、常见病开始,先把流程跑通,再逐步扩展。
实际操作中,可以按下面顺序推进。
- 确定病种和研究问题。
- 设计CRF与字段字典。
- 建立电子数据库。
- 标准化录入和质控。
- 持续随访与更新。
循序渐进的临床数据库整理,更容易形成长期稳定的科研平台。
3. 提升研究效率的四个管理要点
3.1 多人填写,专人管理
数据采集可以多人参与,但管理必须有明确负责人。这样既能提高录入效率,又能保证版本统一、口径一致。没有负责人,数据库很容易出现字段漂移和重复修改。
在团队协作中,建议采用“多人完善、专人审核、定期抽查”的模式。这样能兼顾效率和质量,也是临床数据库整理最实用的组织方式。
3.2 双录入和逻辑核查能减少返工
双录入适合对准确性要求高的研究。两次独立录入后再比对,可以明显减少人为错误。随后进行范围检查和逻辑检查,比如年龄是否异常,手术日期是否早于入院日期,随访时间是否完整。
逻辑核查越早做,后期清洗成本越低。 这一步看似耗时,但实际上能减少统计阶段的重大返工。
3.3 权限管理保证安全与可追溯
临床数据涉及隐私,数据库必须有权限控制。通常可以按角色分级,例如录入者只能填报,负责人才能导出和修改关键字段。这样不仅更安全,也更便于追溯问题来源。
从E-E-A-T角度看,规范的权限管理也体现了研究流程的可信度。对于投稿和多中心合作,这一点尤其重要。
3.4 抽查原始病历,确保电子数据一致
电子数据库和原始病历必须一致。建议定期从数据库中随机抽取记录,与CRF和HIS系统逐条核对。这样可以及时发现漏录、错录和字段理解偏差。
临床数据库整理的真正目标,不是“录进去”,而是“录准确”。 一致性越高,后面统计分析越顺,文章也越容易成稿。
4. 数据库如何真正转化为研究产出
4.1 支持回顾性、随访和观察性研究
有了规范数据库,团队就不只是“存数据”,而是在积累研究样本。它可以支持回顾性分析、队列随访、病例对照研究,也能为前瞻性研究打基础。
对于年轻医生或初入科研的团队来说,回顾性研究通常门槛更低。前提是先把临床数据库整理好,至少保证病例信息完整、随访信息可追踪。
4.2 为多中心合作和样本库扩展留空间
如果条件允许,数据库还可以和生物样本库联动。临床信息加上组织、血液、分子检测数据,数据库价值会显著提升。对肿瘤、慢病和长期随访研究尤其重要。
高质量数据库本身就是可持续的科研基础设施。 它既能总结既往疗效,也能支持未来课题设计,减少重复劳动。
4.3 让统计分析更快启动
统计分析的前提是数据结构清晰。字段定义不统一、缺失值过多、变量类型混乱,都会延长分析周期。反过来,如果前期临床数据库整理到位,统计阶段只需做必要清洗即可直接进入建模。
这也是为什么很多团队越做越快。不是软件更高级,而是前期数据规范更成熟。
总结Conclusion
临床研究效率的差距,往往就体现在数据库管理上。临床数据库整理做得好,研究问题更清晰,录入更标准,核查更高效,统计也更快启动。 对医学生、医生和科研人员来说,真正提升产出的,不是临时补数据,而是从一开始就建立规范的流程。
如果你希望把临床资料变成可持续产出的科研资源,可以优先从标准化CRF、字段设计、权限管理和质控流程入手。借助解螺旋的临床研究内容与工具支持,可以更高效地完成临床数据库整理,把分散病历转化为可分析、可发表、可复用的研究基础。
- 引言Introduction
- 1. 为什么临床数据库会直接影响研究效率
- 2. 临床数据库整理的关键步骤
- 3. 提升研究效率的四个管理要点
- 4. 数据库如何真正转化为研究产出
- 总结Conclusion