135
 分享
引言Introduction
标准正态分布是统计分析中的基础工具,但很多医学生和科研人员在写论文时,仍会混淆正态分布、标准化和标准差。如果你需要快速判断数据是否适合t检验、方差分析或参数估计,先吃透标准正态分布公式就很关键。

1. 标准正态分布是什么
1.1 从正态分布到标准正态分布
正态分布是最常见的连续型分布之一,曲线呈钟形,左右对称。它的核心特征是数据集中在均值附近,越远离均值,出现概率越低 。在临床研究中,身高、血压、BMI等变量常常接近正态分布。
标准正态分布是正态分布的特例。它的均值为0,标准差为1。换句话说,任何符合正态分布的变量,都可以通过标准化转化为标准正态分布 。这一步能让不同量纲的数据放在同一尺度上比较。
1.2 为什么要学标准化
在研究中,我们经常面对不同单位的数据。比如血压是mmHg,BMI是kg/m²,实验室指标可能是U/L。直接比较原始值没有意义。标准化后,变量会变成Z值,便于判断该数值在总体中的相对位置。
标准化的本质是把“原始值偏离均值多少个标准差”表达出来。 这对数据清洗、异常值识别、分位数判断和后续统计推断都很实用。
2. 标准正态分布公式与标准化方法
2.1 公式长什么样
标准正态分布常记为 ( Z \sim N(0,1) )。其概率密度函数为:
[
f(z)=\frac{1}{\sqrt{2\pi}}e^{-z^2/2}
]
这里的含义很明确。(z) 是标准化后的随机变量,曲线在0点达到峰值,左右完全对称。由于均值为0、标准差为1,图形最具“标准参照”意义。
2.2 原始数据如何转成Z值
如果一个连续变量 (X) 服从均值为 (\mu)、标准差为 (\sigma) 的正态分布,则其标准化公式为:
[
Z=\frac{X-\mu}{\sigma}
]
这个公式非常重要。它告诉你某个观测值比均值高或低几个标准差。
例如某项指标的均值是100,标准差是15,某患者结果是130,则:
[
Z=\frac{130-100}{15}=2
]
这表示该值比均值高2个标准差,已经处于相对偏高的位置。
2.3 Z值的临床和科研意义
Z值不是原始单位,而是标准位置。它有三个常见用途:
- 判断数据相对位置。
- 比较不同量纲的变量。
- 为后续查表、估计概率和异常值分析提供基础。
如果一个值的Z值绝对值很大,通常说明它离总体中心较远。 在实际研究里,这类值往往值得进一步核查来源,尤其是录入错误、测量偏差或极端个体。
3. 标准正态分布的核心性质
3.1 对称性与集中性
标准正态分布最显著的性质是左右对称。以0为中心,左右两侧面积完全相等。也就是说,(Z<0) 和 (Z>0) 的概率各占一半。
同时,它具有很强的集中性。大部分概率集中在0附近,离0越远,概率越小。 这也是为什么很多统计方法在正态假设下会表现稳定。
3.2 曲线下面积等于1
标准正态分布是一种概率分布,因此曲线下的总面积等于1。这个性质意味着所有可能结果的概率总和为100%。
临床统计中,这一点很关键。因为我们常常要计算某个区间内的概率,而不是单点概率。对于连续型变量来说,单点概率理论上为0,真正有意义的是区间概率。
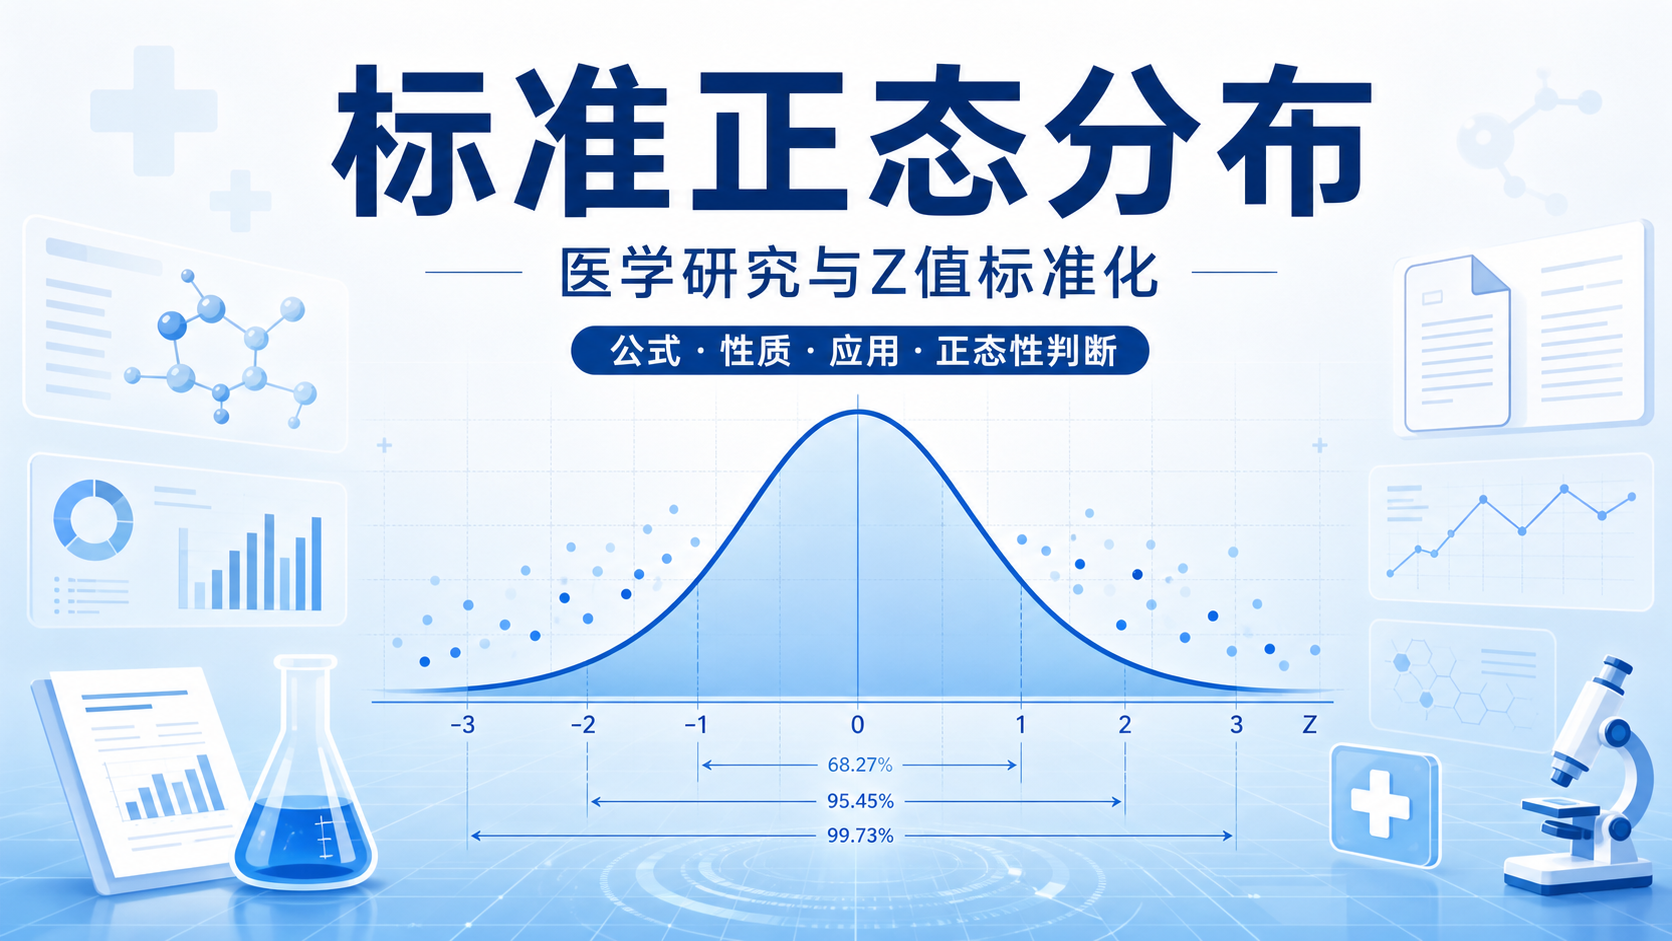
3.3 68-95-99.7经验规则
标准正态分布有一个非常实用的经验规律:
- 约68%的数据落在 (\mu \pm 1\sigma) 内。
- 约95%的数据落在 (\mu \pm 2\sigma) 内。
- 约99.7%的数据落在 (\mu \pm 3\sigma) 内。
在标准正态分布下,对应为:
- (P(-1<Z<1)\approx 68%)
- (P(-2<Z<2)\approx 95%)
- (P(-3<Z<3)\approx 99.7%)
这组数字在质控、异常值筛查和结果解释中非常常用。如果某个观测值超过3个标准差,通常就值得高度警惕。
4. 如何判断数据是否适合使用标准正态分布思路
4.1 先看变量类型
标准正态分布只适用于连续型变量的理论分析。离散变量、计数资料和等级资料,不应直接套用。
因此第一步不是看公式,而是看数据类型。
连续变量再进一步判断正态性。只有接近正态分布时,才适合用均数±标准差描述,或在参数检验中使用相关方法。
4.2 正态性检验怎么做
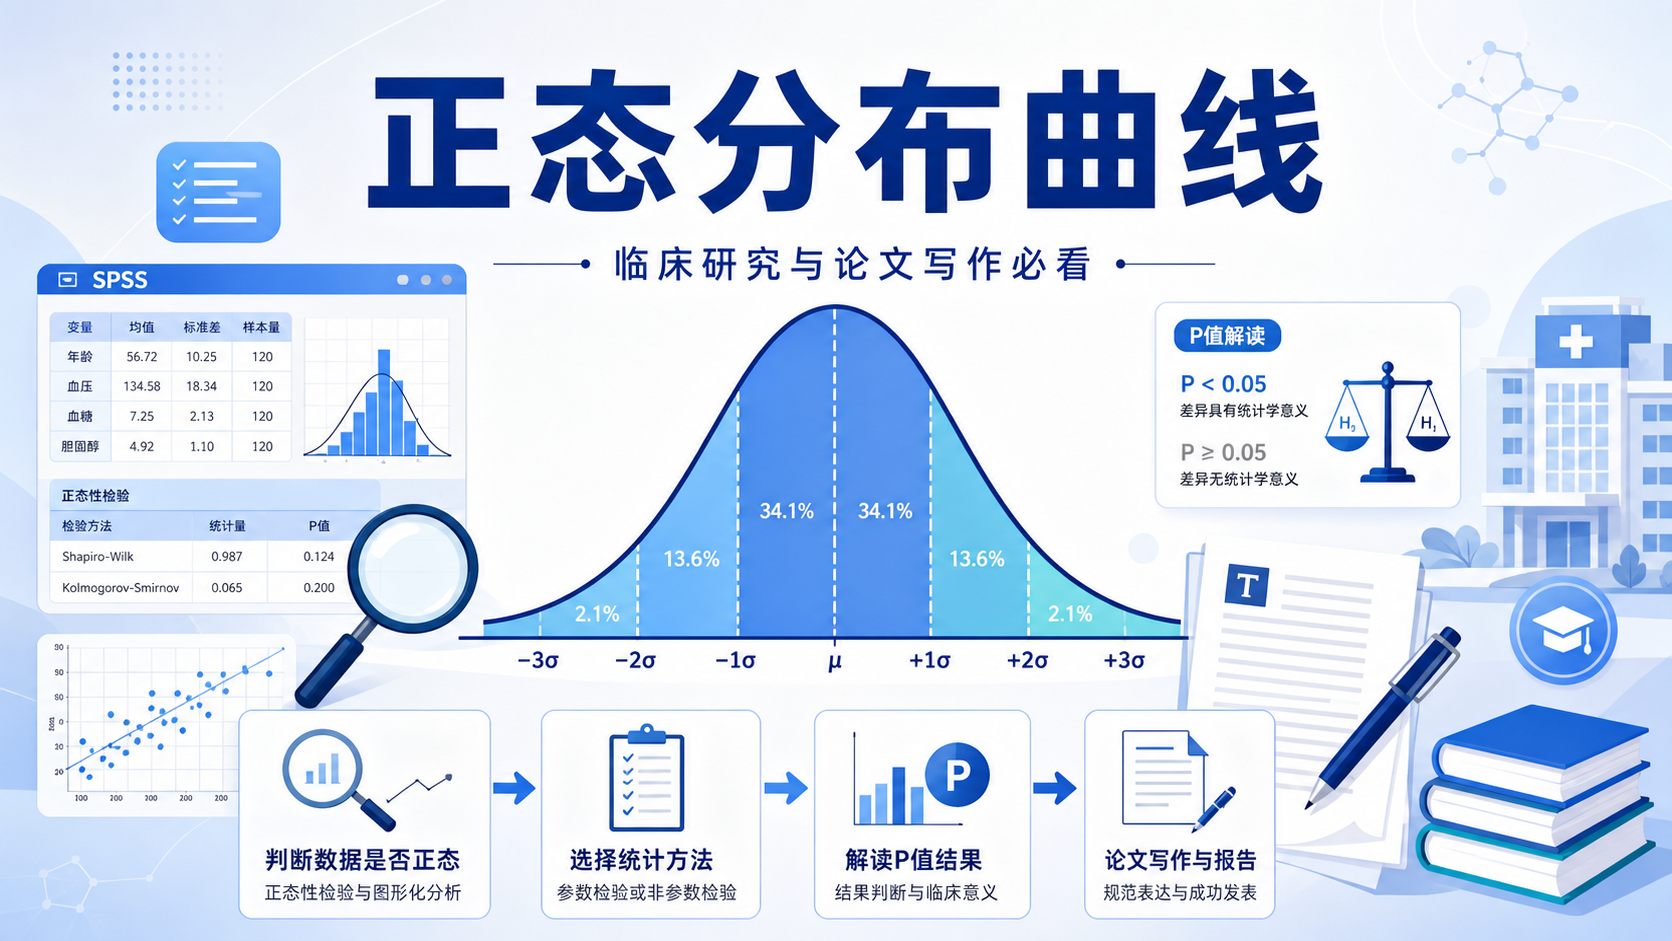
常用方法包括图示法和假设检验法。图示法可看直方图、Q-Q图、P-P图和茎叶图。假设检验法则常用Shapiro-Wilk检验和Kolmogorov-Smirnov检验。
需要注意的是,样本量较小的时候,SW检验更常用;样本量较大时,KS检验更常见。 但统计检验不能只看P值。样本量过大时,轻微偏离也可能显著;样本量过小时,检验又可能不敏感。
4.3 样本量大于30不等于自动正态
这是常见误区。样本量大于30,常常是因为中心极限定理开始发挥作用,样本均值的抽样分布更接近正态。但这不等于原始数据本身就是正态分布 。
统计分析中,不能把“抽样分布近似正态”误解为“原始资料已经正态”。 这也是很多论文方法学写作中容易出错的地方。
5. 标准正态分布在医学研究中的常见应用
5.1 参数检验前的基础判断
t检验、方差分析等参数检验,通常要求数据来自正态或近似正态总体。此时,先判断分布,再决定方法,是规范流程。
如果数据不满足正态性,可考虑非参数检验,或者进行适当的变量转换后再分析。这一步直接影响结论是否可靠。
5.2 异常值识别
Z值是异常值筛查的重要工具。一般来说,若某个值距离均值超过2个标准差,就值得关注;若超过3个标准差,更应优先核查。
不过,异常值不等于错误值。临床上,极端值可能是真实个体差异,也可能是测量误差。判断时要结合原始记录、入排标准和临床背景。
5.3 结果解释与标准化比较
在科研写作中,标准化结果便于比较不同变量的影响大小。尤其在多因素分析、量表研究和跨队列比较中,Z值能显著提升解释效率。
标准正态分布的价值,不只是算概率,更是建立统一的统计语言。 这对规范论文表述和增强可比性都很重要。
6. 写论文时最容易混淆的几个点
6.1 均数、标准差和标准误不是一回事
均数描述集中趋势。标准差描述离散程度。标准误描述样本均数对总体均数的抽样误差。
用标准正态分布思维做统计时,一定要区分这三个概念。 否则在结果表、图表和方法部分都容易出错。
6.2 标准化不等于改变研究结论
标准化只是换一种尺度表达数据,不会改变变量之间的真实关系。它的作用是便于比较和推断,不是“美化数据”。
6.3 不是所有数据都要硬套正态
如果数据明显偏态,强行使用均数±标准差和参数检验,可能会误导结论。此时应根据数据分布选择合适的描述和分析方法。
总结Conclusion
标准正态分布公式的核心很简单:(Z=(X-\mu)/\sigma)。但它背后的统计意义很重要。它帮助我们统一不同尺度的数据,判断观测值位置,识别异常值,并为参数检验提供基础。 对医学生、医生和科研人员来说,真正掌握标准正态分布,不只是会背公式,而是会把它用在数据描述、正态性判断和论文分析中。
如果你希望把这类统计概念转化为论文方法学能力,建议结合系统化工具和模板学习。解螺旋品牌 可以帮助你更高效地梳理统计思路、规范写作表达,减少常见方法学错误。
- 引言Introduction
- 1. 标准正态分布是什么
- 2. 标准正态分布公式与标准化方法
- 3. 标准正态分布的核心性质
- 4. 如何判断数据是否适合使用标准正态分布思路
- 5. 标准正态分布在医学研究中的常见应用
- 6. 写论文时最容易混淆的几个点
- 总结Conclusion