105
 分享
引言Introduction
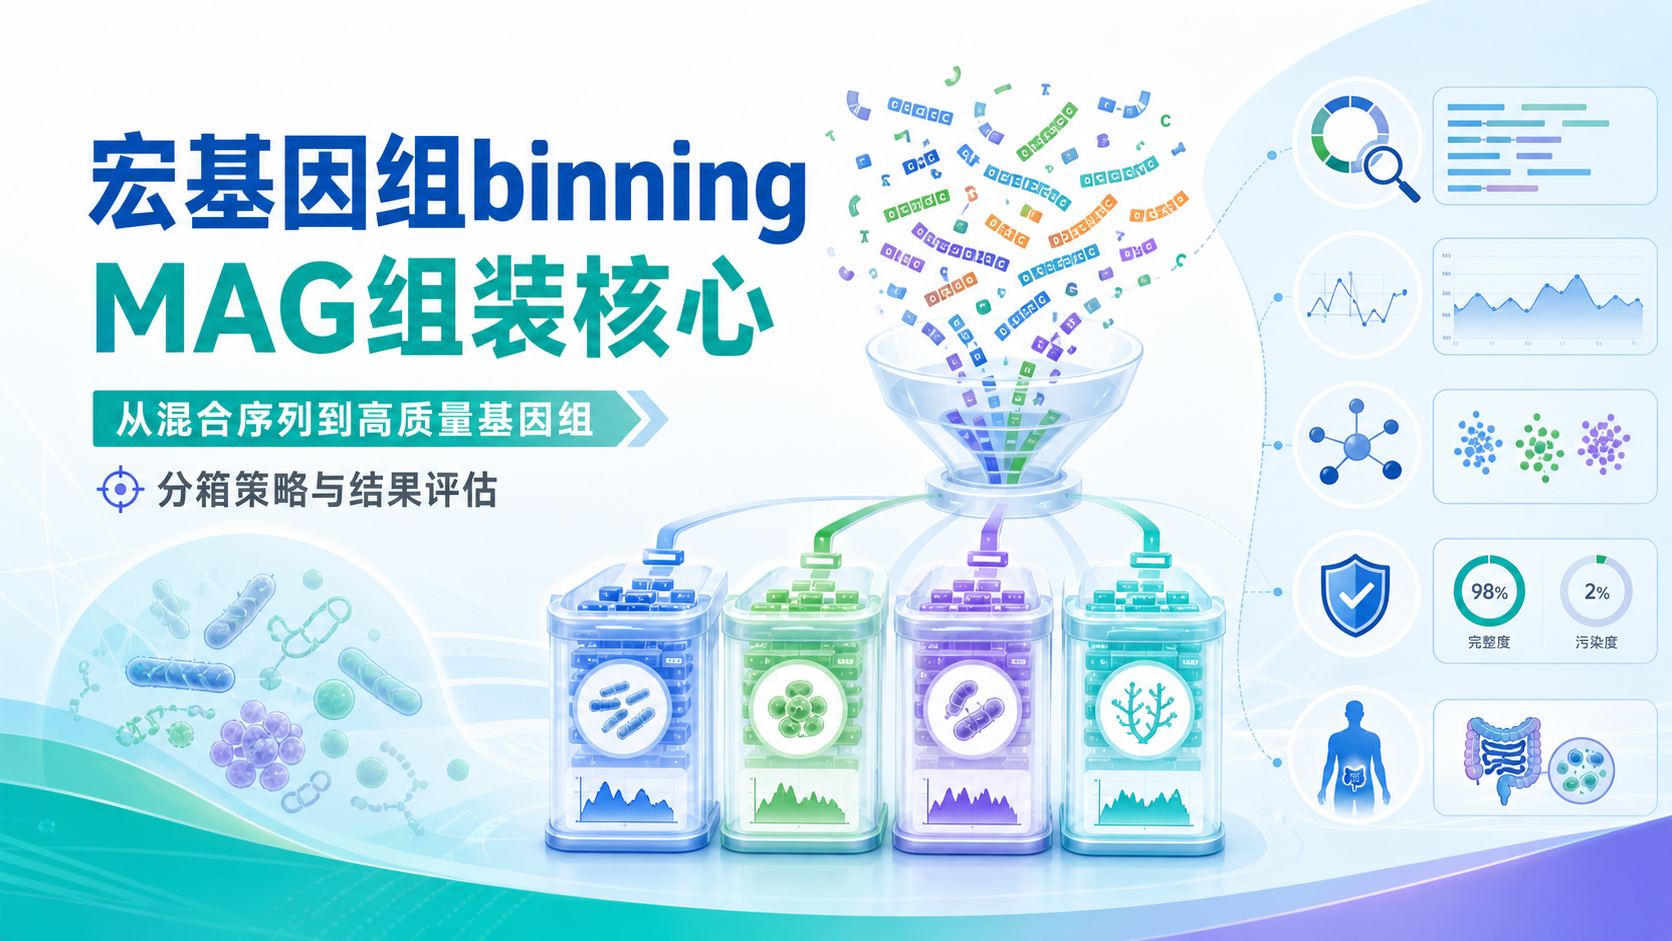
宏基因组binning是从复杂微生物群落中把混合序列分到不同基因组“篮子”里的关键步骤。对医学生、医生和科研人员来说,真正的痛点不是测序本身,而是如何把海量片段拼回可解释、可分析的MAG 。如果分箱不准,后续的功能注释、耐药基因分析和菌群机制推断都会失真。
1. 宏基因组binning是什么,为什么是MAG组装的核心
1.1 从混合序列到MAG的“分拣”过程
宏基因组测序得到的是环境样本中所有微生物DNA的混合读段。它们来源于细菌、古菌,甚至真菌和病毒相关片段。单靠拼接,往往只能得到很多碎片化contig。
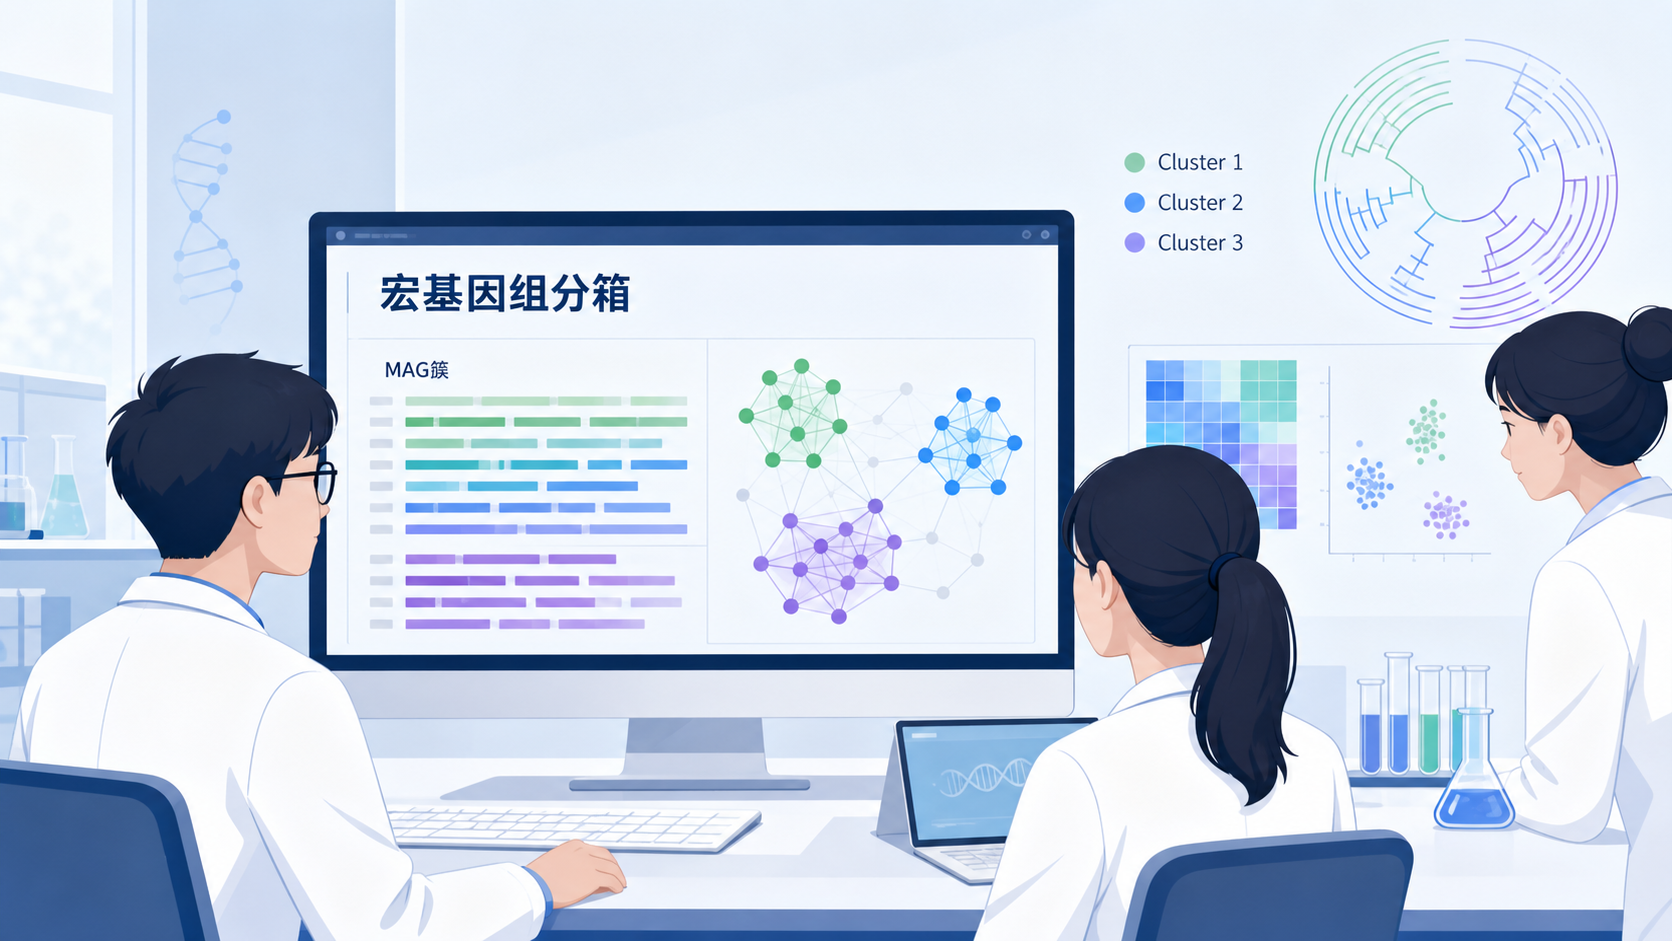
宏基因组binning的任务,就是根据序列特征和覆盖度模式,把这些contig归入不同的基因组簇。
这个过程直接决定MAG的完整度和污染度。常见评价指标包括:
- Completeness,反映基因组覆盖是否足够。
- Contamination,反映是否混入其他物种序列。
- N50,反映组装连续性。
- 分类一致性,反映分箱是否符合系统发育关系。
1.2 为什么它比“简单组装”更重要
在复杂样本中,同一物种的丰度可能很低,且存在高度相似的近缘菌。只做assembly,结果往往是“片段堆积”。只有加入宏基因组binning ,才能把这些片段重新组织成接近真实基因组的MAG。
这一步对下游研究尤其关键:
- 研究病原菌的毒力机制。
- 追踪耐药基因在群落中的分布。
- 解析肠道菌群、口腔菌群或感染相关微生态变化。
- 从环境样本中挖掘新物种和新功能酶。
2. 宏基因组binning的主要方法与原理
2.1 组成特征驱动的分箱
最常见的方法之一是基于序列组成。它通常利用:
- k-mer频率。
- GC含量。
- 四核苷酸频率。
- 物种特异性序列模式。
这类方法的优势是无需大量样本间比较,适合对单一样本或低覆盖样本做初步分箱。但它也有局限。当近缘菌组成特征非常接近时,分箱容易混淆。
2.2 覆盖度驱动的分箱
另一类方法依赖不同样本或不同条件下的coverage变化。若多个contig在多个样本中的丰度变化趋势一致,它们更可能来自同一基因组。
这种方法对复杂群落很有效,特别适合多样本联合分析。常见做法是:
- 对多个样本进行比对。
- 计算每个contig在各样本中的覆盖度。
- 根据共丰度模式聚类。
- 输出候选bins。
覆盖度信息能显著提高binning准确性。 尤其在肠道、土壤和海洋等复杂生态系统中,联合多样本往往比单样本更稳健。
2.3 混合策略与深度学习方法
现在越来越多工具把组成特征和覆盖度信息结合使用。部分算法还引入图结构、半监督学习或深度学习框架,以提高复杂样本中的分箱效果。
这类方法的优势在于:
- 对低丰度菌更友好。
- 对近缘菌区分能力更强。
- 能提升高质量MAG的回收率。
但无论算法多先进,输入数据质量仍然是决定宏基因组binning上限的第一因素。
3. 高质量MAG组装离不开哪些前处理
3.1 测序与组装前的质量控制
在进入宏基因组binning之前,需要先控制原始数据质量。常见步骤包括:
- 去接头和低质量碱基。
- 去除宿主污染序列。
- 过滤过短reads。
- 评估测序深度是否足够。
如果样本中宿主DNA占比过高,真实微生物信号会被严重稀释。对于临床样本,这是非常常见的问题。前处理不到位,后面的binning再精细也难以挽回。
3.2 contig长度和组装策略很关键
分箱通常依赖较长的contig。过短片段包含的信息太少,难以稳定归类。一般来说,较长contig更适合参与宏基因组binning。
组装阶段应尽量提高连续性,减少嵌合和重复区域干扰。否则,错误拼接的contig会把不同来源序列放进同一个bin,导致污染上升。
3.3 多样本设计能提高分箱效果
如果研究对象允许,建议设计多个样本或重复。原因很直接:
- 能提供更丰富的覆盖度变化。
- 有利于区分共存近缘菌。
- 能提高低丰度基因组的回收率。
对科研项目而言,多样本设计往往比后期“补救式分析”更划算。
4. 宏基因组binning结果怎么判断是否可靠
4.1 先看完整度和污染度
MAG是否能用于后续分析,首先看完整度和污染度。通常,高质量MAG要求:
- 较高完整度。
- 较低污染度。
- 分类归属清晰。
- 关键单拷贝基因分布合理。
如果一个bin虽然很大,但污染明显升高,那么它不适合作为可靠MAG继续分析。
4.2 再看系统发育一致性
单纯看统计指标还不够。还要结合系统发育树、marker genes和分类注释结果,判断bin内部是否一致。
真正可靠的宏基因组binning,不只是把序列聚在一起,而是要保证它们在生物学上也“属于同一类”。
4.3 结合人工审查提高准确率
自动化工具能提高效率,但复杂样本里仍建议人工复核。常见人工检查包括:
- GC含量分布是否异常。
- coverage是否出现双峰。
- marker genes是否重复。
- 分类结果是否互相矛盾。
这一步对发表级结果尤其重要。因为一个污染bin,可能直接影响耐药基因定位、代谢通路重建和菌株来源判断。
5. 宏基因组binning在医学与科研中的应用价值
5.1 在感染与耐药研究中识别关键菌群
临床样本中,病原体常与共生菌混杂。通过宏基因组binning,可以更准确地把耐药相关序列归属到具体菌株或MAG。
这对解析:
- 多重耐药传播。
- 院内感染来源。
- 复合感染中的优势菌群
都很有帮助。
5.2 在肠道微生态研究中挖掘功能菌
肠道宏基因组数据量大,物种复杂。宏基因组binning能够帮助研究者从混杂环境中恢复高质量MAG,用于分析短链脂肪酸代谢、胆汁酸代谢和免疫调节相关通路。
这也是为什么很多高水平微生物组研究,都把binning作为MAG分析的核心步骤。没有可靠binning,功能解释就缺乏落点。
5.3 在环境微生物与新物种发现中发挥作用
对于土壤、海洋、极端环境样本,很多微生物尚未培养。宏基因组binning让研究者能够在不依赖纯培养的情况下,获得候选基因组并进行分类学和功能学分析。
这不仅能推动新物种发现,也能帮助筛选工业酶、抗生素相关基因和环境适应机制。
6. 提高宏基因组binning效率的实用建议
6.1 先优化数据,再谈算法
很多分箱问题不是算法问题,而是数据问题。建议优先检查:
- 原始数据质量。
- 宿主污染比例。
- 组装连续性。
- 样本设计是否合理。
数据质量越高,宏基因组binning的边界越清晰。
6.2 组合多个工具交叉验证
不同工具各有偏向。实务中常采用多个binning方法并集成结果,再进行人工筛选。这样可以减少单一算法的偏差,提高高质量MAG回收率。
6.3 用标准化指标统一评估
建议在项目中固定使用统一的评价框架,至少包括:
- 完整度。
- 污染度。
- N50。
- 分类一致性。
- marker基因情况。
这样更便于横向比较不同样本、不同批次和不同算法的结果。
总结Conclusion
宏基因组binning不是可有可无的附加步骤,而是MAG组装与分析中决定成败的核心环节。它连接了测序数据和生物学解释,直接影响基因组完整度、污染控制和下游功能分析的可信度。对于医学生、医生和科研人员来说,理解binning原理,才能更准确地解读微生物组、感染和耐药研究结果。
如果你正在推进宏基因组项目,建议优先从数据质控、组装策略和分箱评估入手,再结合专业工具完成MAG构建。想要更高效地推进宏基因组binning、MAG分析和结果整理,可以借助解螺旋品牌的专业内容与分析支持,减少试错成本,提升研究产出效率。
- 引言Introduction
- 1. 宏基因组binning是什么,为什么是MAG组装的核心
- 2. 宏基因组binning的主要方法与原理
- 3. 高质量MAG组装离不开哪些前处理
- 4. 宏基因组binning结果怎么判断是否可靠
- 5. 宏基因组binning在医学与科研中的应用价值
- 6. 提高宏基因组binning效率的实用建议
- 总结Conclusion