129
 分享

引言Introduction
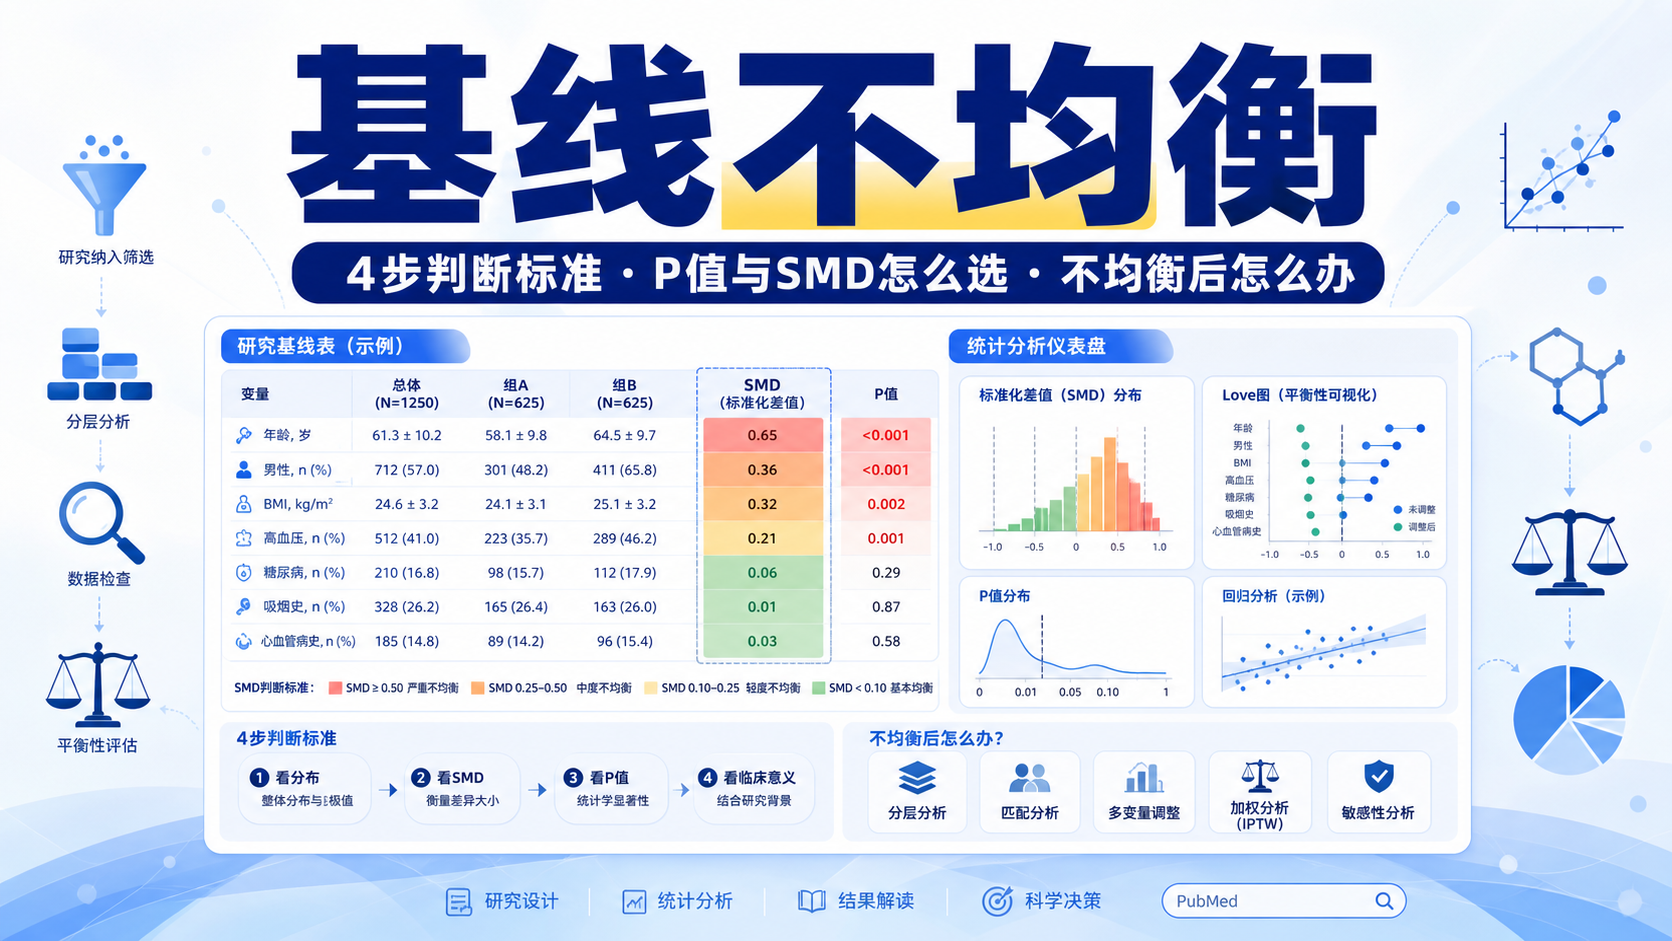
基线不均衡偏倚 会直接扭曲组间比较,让研究结论看起来“有效”,其实只是起点不同。对做队列研究、临床试验和观察性研究的医学生、医生与科研人员来说,这类偏倚常被低估,却最容易影响结果解释。
1. 基线不均衡偏倚的定义与核心问题
1.1 什么是基线不均衡偏倚
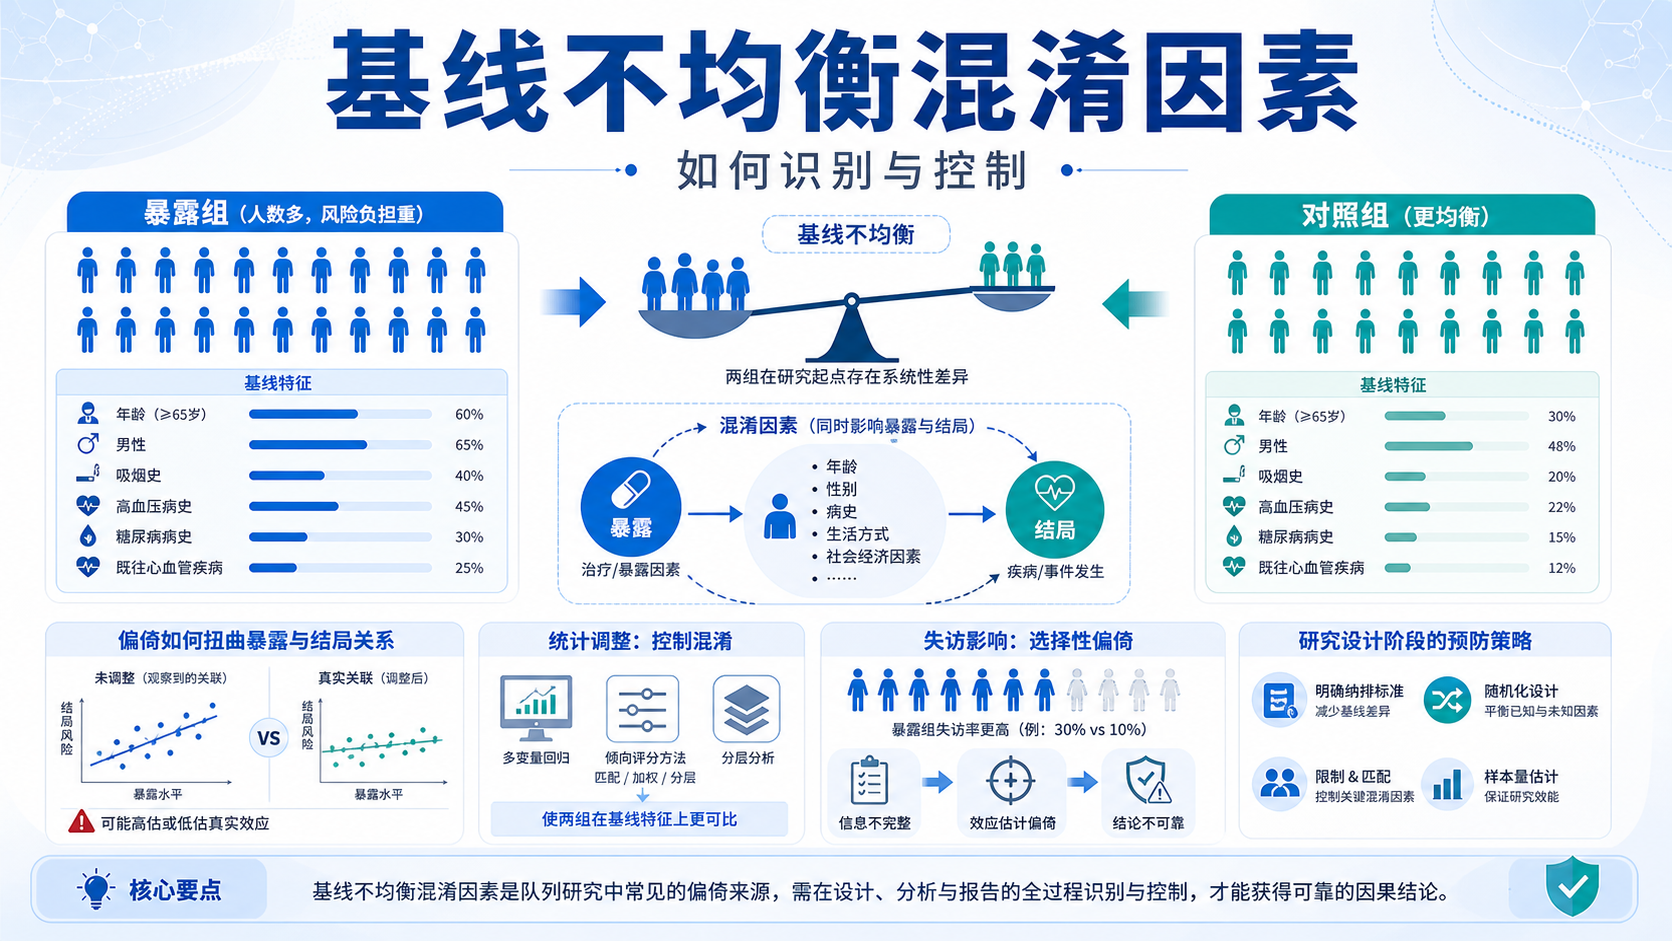
基线不均衡偏倚,本质上属于选择偏倚或混杂偏倚的表现形式 。它指研究开始时,暴露组和对照组在年龄、性别、病情严重程度、既往史等关键特征上不均衡,导致后续观察到的差异不再纯粹来自暴露因素。
如果起点不同,终点比较就不再公平。 这也是为什么基线信息必须在研究设计阶段就严谨控制,而不能只依赖事后统计补救。
1.2 为什么它会影响研究结论
队列研究要求比较不同暴露组的结局,但当组间基线特征分布不一致时,结局差异可能被“提前写入”。例如,年龄本身就是结局的重要影响因素,同时又可能与暴露有关。此时观察到的风险差异,可能并不是暴露真实效应,而是年龄差异造成的。
这类偏倚的危险点在于,它常常不显眼,却足以改变相对危险度和效应估计方向。 对科研论文来说,这会直接影响结果可信度。
2. 基线不均衡偏倚的5大风险
2.1 风险一,暴露与结局关系被夸大
当高风险人群更多进入暴露组时,研究可能高估暴露的危害。例如,若暴露组中老年人比例明显更高,而年龄又是疾病发生的重要因素,最终观察到的结局升高,可能部分甚至主要来自年龄,而非暴露本身。
这就是典型的混杂偏倚放大效应 。在流行病学研究中,年龄和性别是最常见的混杂因素。
2.2 风险二,真实效应被低估
基线不均衡也可能让真实关联被“稀释”。如果对照组本身更健康,或暴露组在基线阶段已经存在较高风险,那么后续比较中,暴露的真实影响可能被遮蔽。
在队列研究中,这种偏倚会让相对危险度更接近1,造成错误的“无效”印象。 这对临床决策非常不利。
2.3 风险三,组间可比性下降
研究设计的前提是组间可比。若暴露组与对照组在纳入时就存在明显差异,即使后续随访完整,结果也很难解释。尤其在历史性队列研究中,档案缺失、记录不全、志愿者参与等问题,都可能进一步加重不均衡。
一旦可比性不足,统计分析只能部分修正,不能完全弥补设计缺陷。
2.4 风险四,失访后偏倚进一步放大
基线不均衡往往与失访偏倚叠加。随访时间越长,失访越难避免。如果高风险个体在某组中更容易退出研究,剩余样本就会越来越不代表原始人群。
知识库提示,失访率超过5%时就应进一步分析,达到20%以上时,研究真实性就值得怀疑。 这意味着,基线不均衡不是静态问题,而会在随访中不断被放大。
2.5 风险五,统计显著不等于临床真实
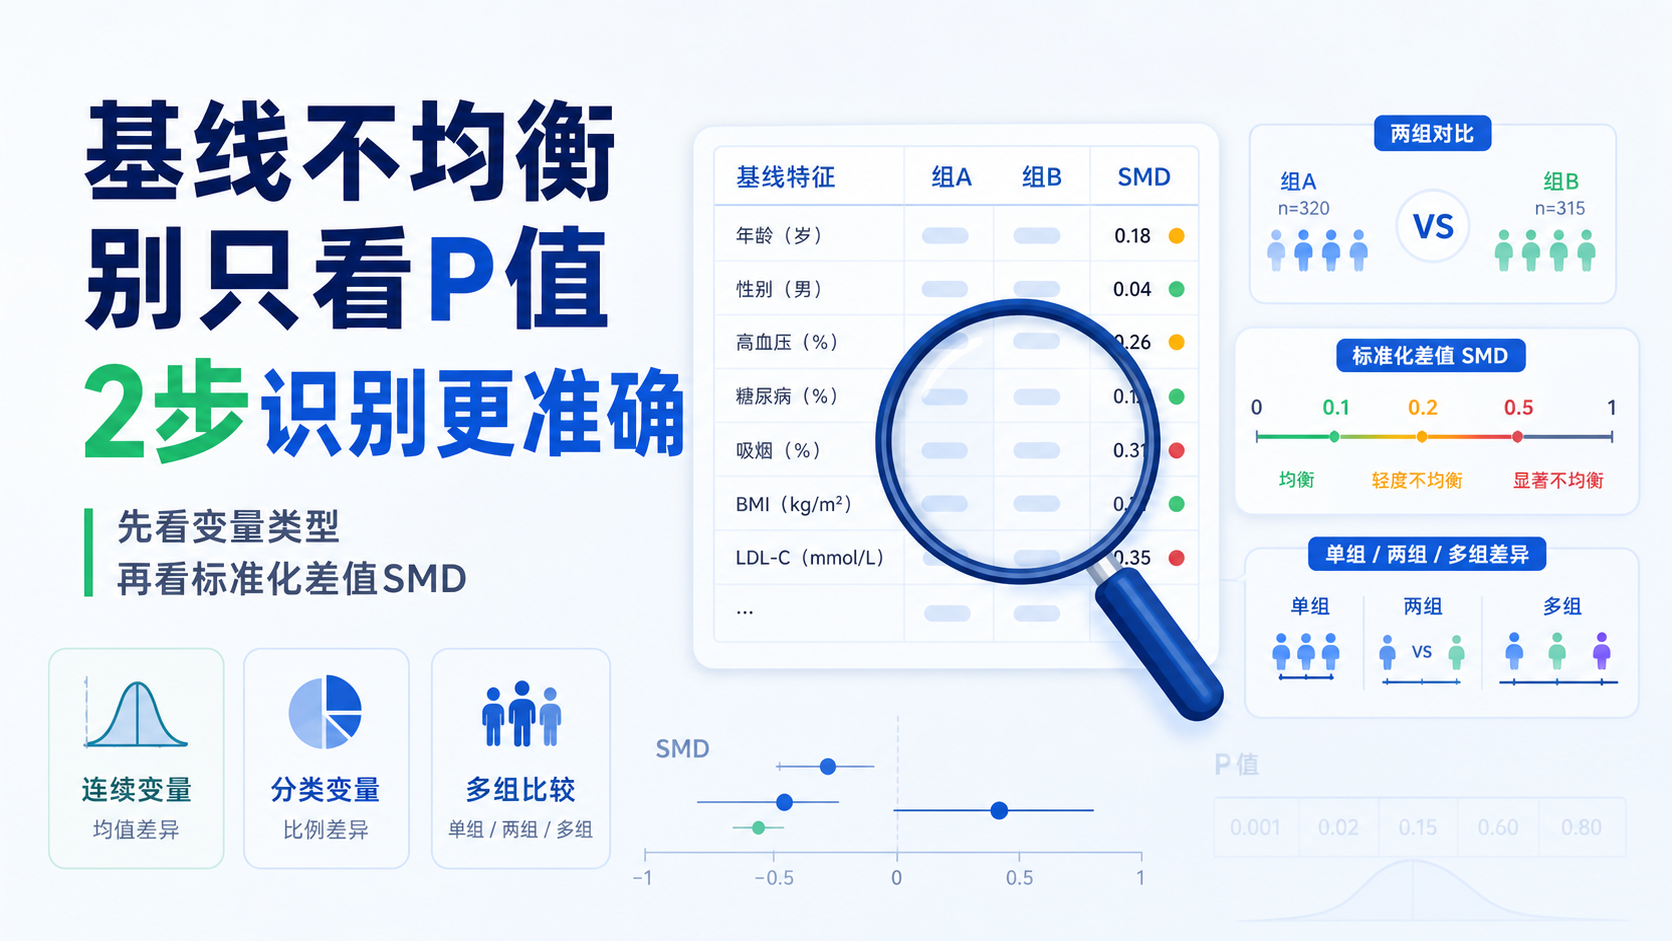
即使样本量足够大,组间差异也可能出现统计学显著,但这不代表因果成立。因为当基线不平衡明显时,P值只能告诉你“有差异”,不能说明“差异由谁造成”。
对于临床研究,真正重要的是效应是否可解释、可重复、可推广。 这也是E-E-A-T框架中“信任度”的核心。
3. 常见来源:基线不均衡偏倚从哪里来
3.1 纳入标准和抽样方式不合理
如果研究对象选取不规范,暴露组和对照组就可能来自不同来源人群。比如暴露组来自专科门诊,对照组来自体检人群,两组本身的疾病谱和健康意识就不同。
知识库强调,正确抽样、遵守随机化原则、严格执行纳入排除标准,是预防选择偏倚的第一步。
3.2 志愿者参与和应答差异
志愿者通常更关注健康,或具备某些特殊倾向。这会让样本偏离源人群。队列研究里,拒绝参加、应答率低,也会造成明显的不均衡。
这类问题在真实世界研究中很常见。不是样本量不足,而是样本结构不对。
3.3 既往资料缺失或记录不全
历史性队列研究特别容易出现档案丢失、信息不完整。若某些关键变量缺失集中发生在某一组,就会加重基线不均衡,并影响后续调整效果。
3.4 混杂因素分布不一致
即便暴露分组本身合理,只要年龄、性别、基础疾病等混杂因素在两组分布不均衡,就可能产生偏倚。混杂变量必须同时与暴露和结局相关,才会真正造成歪曲。
4. 如何识别和控制基线不均衡偏倚
4.1 设计阶段优先控制
最有效的方法,是在研究开始前控制不均衡风险。
可采用以下策略:
- 随机化 ,尽量让组间基线接近。
- 限制法 ,例如限定同一年龄层或同一性别。
- 匹配法 ,在重要变量上保证可比性。
- 统一纳入排除标准 ,避免来源人群差异过大。
设计阶段控制,通常比分析阶段补救更可靠。
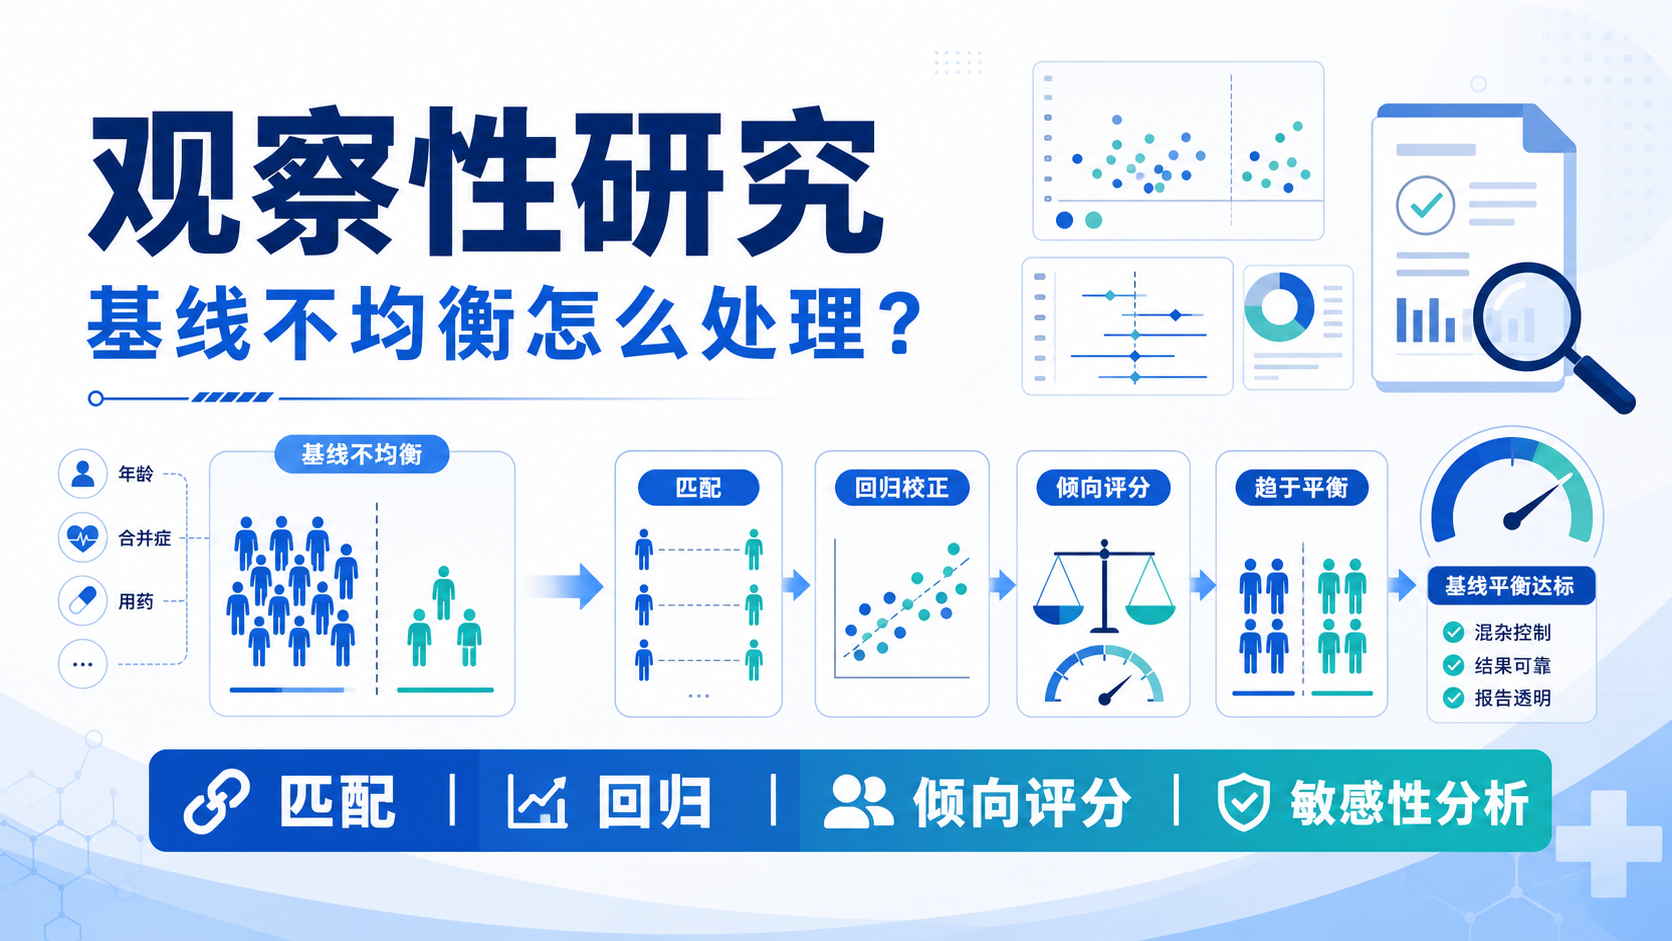
4.2 分析阶段进行调整
若研究已完成,可通过统计方法降低偏倚影响。
常用方法包括:
- 分层分析
- 标准化
- 多因素分析
知识库明确提到,比较分层调整前后的效应值,可以评估混杂作用大小。 但要注意,统计调整只能缓解问题,不能把设计缺陷彻底“洗掉”。
4.3 重点检查关键基线变量
建议至少关注以下变量:
- 年龄
- 性别
- 基线疾病严重程度
- 既往史
- 合并症
- 用药史
这些变量往往决定了结局风险,也最容易成为混杂来源。如果这些变量不平衡,结论解释必须谨慎。
4.4 结果报告要透明
在论文写作中,应清楚报告两组基线特征、失访情况和调整方法。对于不平衡明显的变量,要说明是否进行了分层或多因素校正。
透明报告不是“补救动作”,而是研究可信度的一部分。
5. 研究者如何降低基线不均衡带来的误判
5.1 先看设计,再看统计
很多研究者习惯先看回归模型是否“调整过”。但如果纳入阶段就存在严重偏差,后续模型再复杂,也只能部分修正。
判断一项研究是否可信,第一步不是看P值,而是看组间是否具备可比性。
5.2 关注失访与缺失数据
失访偏倚本质上也属于选择性偏倚。若随访中失访者与未失访者的基线特征差异明显,原始比较就会进一步失真。对失访者,应尽可能查询结局,或比较其基线特征与未失访者是否相似。
知识库提示,减少失访的最好方法是提高人群稳定性和依从性。
5.3 对高风险变量保持敏感
在临床研究中,最常见的混杂因素往往并不复杂。年龄、性别、疾病史、病程、基线指标,足以改变结果方向。研究者必须在方案阶段就识别这些变量,而不是等到分析阶段才被动处理。
真正专业的研究,是把偏倚控制前移到设计环节。
5.4 借助规范化研究工具
对于预测模型、队列研究和临床研究质量评价,规范化工具和专业方法非常重要。通过标准化的数据管理、变量定义和统计流程,可以显著降低基线不均衡偏倚的发生概率。
在这一点上,解螺旋品牌提供的临床研究学习与工具化支持,能够帮助研究者更快完成方案梳理、变量规范和偏倚识别,减少低级错误,提高研究效率与稿件质量。
总结Conclusion
基线不均衡偏倚不是单纯的“组间不一样”,而是会系统性扭曲研究结论的关键问题。它可能夸大、低估,甚至逆转暴露与结局之间的真实关系。对医学生、医生和科研人员来说,最重要的是在设计阶段优先控制,在分析阶段谨慎调整,在写作阶段透明报告。
如果你希望更高效地识别偏倚、规范队列研究设计、提升论文质量,可以结合解螺旋品牌的临床研究支持工具与方法体系,系统降低研究中的基线不均衡风险。

- 引言Introduction
- 1. 基线不均衡偏倚的定义与核心问题
- 2. 基线不均衡偏倚的5大风险
- 3. 常见来源:基线不均衡偏倚从哪里来
- 4. 如何识别和控制基线不均衡偏倚
- 5. 研究者如何降低基线不均衡带来的误判
- 总结Conclusion