

 42
 分享
引言Introduction
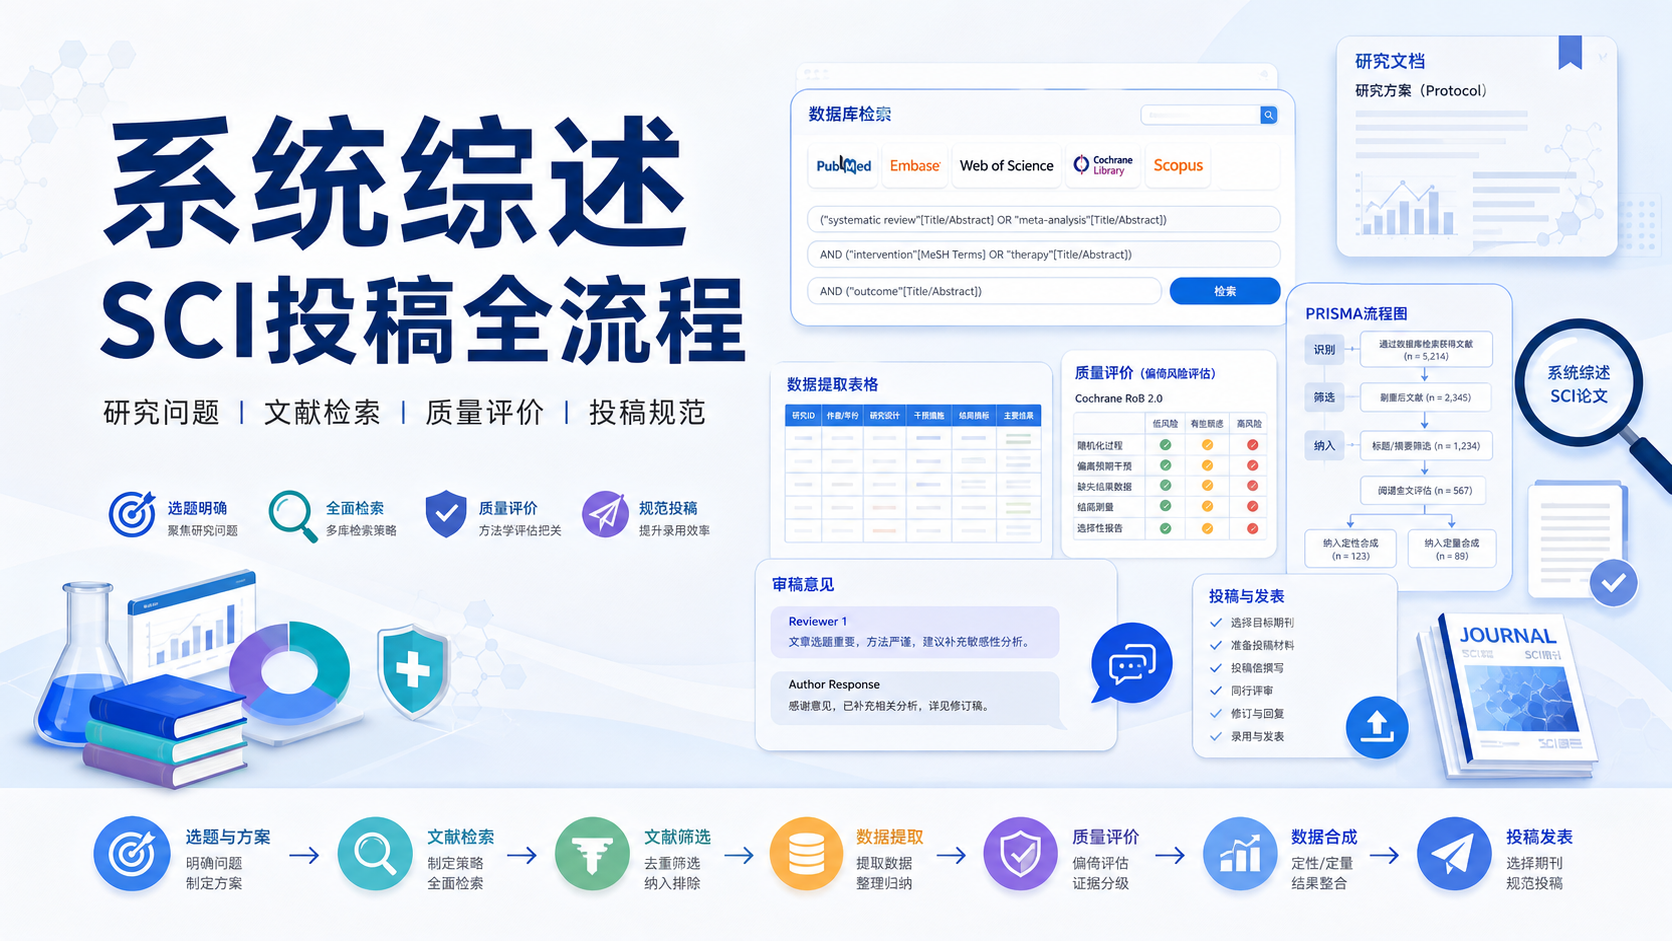
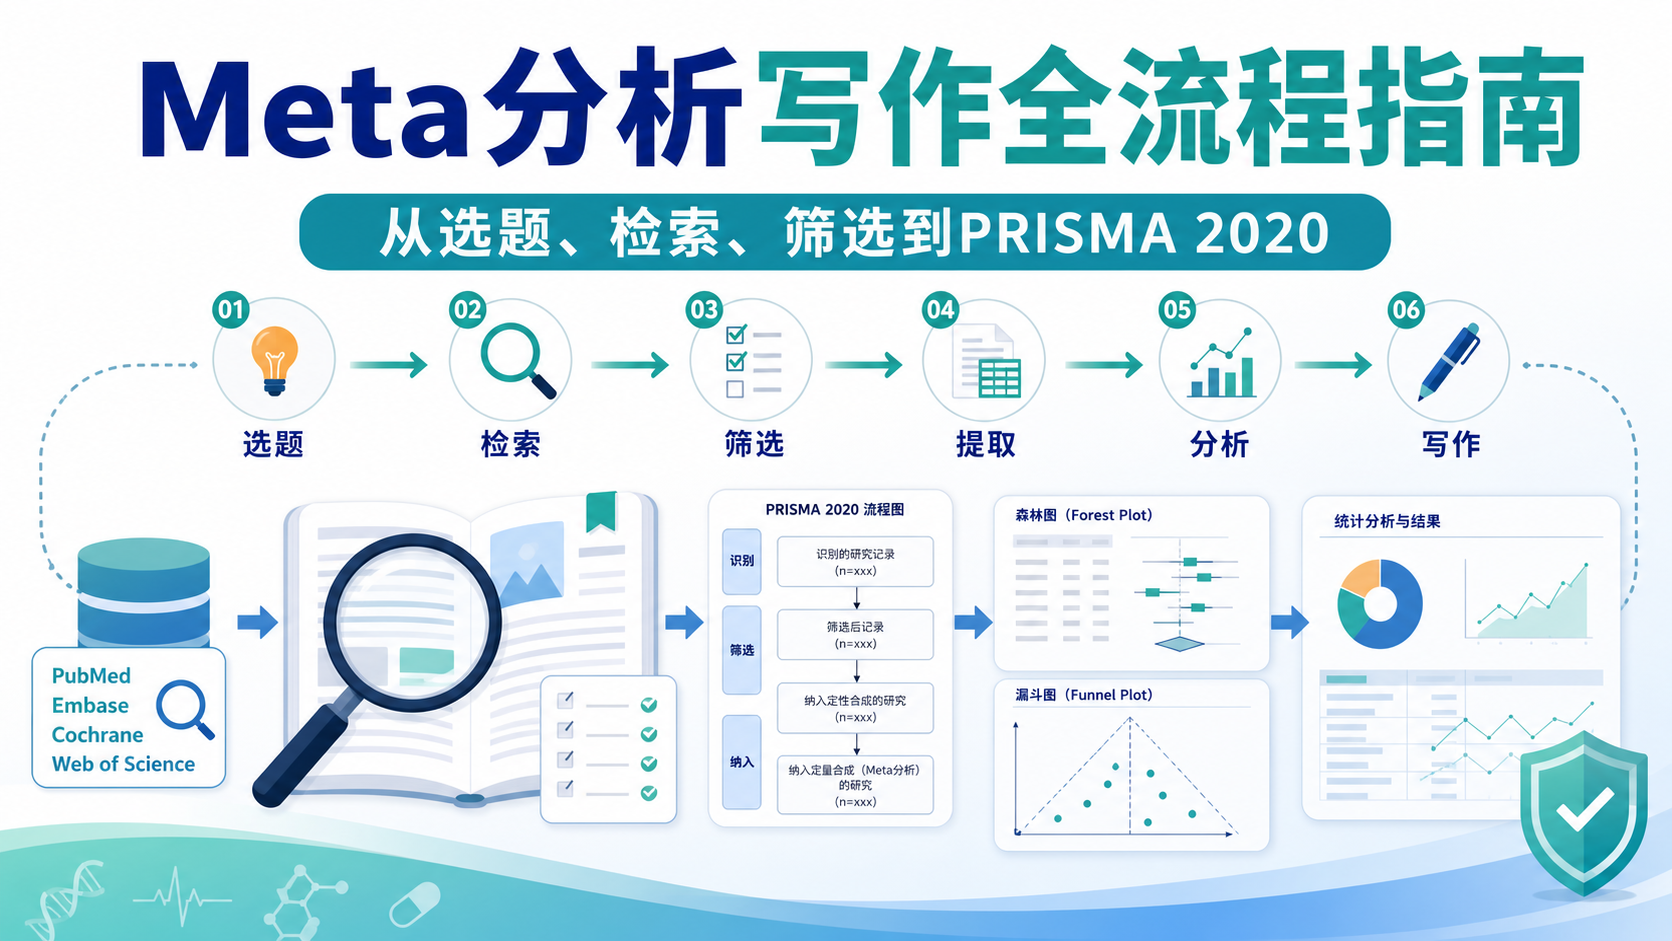
Meta分析看似是“合并数据”,实际更像一套严格的SCI写作工程。从选题、检索到统计和成文,每一步都影响能否发表。 对医学生、医生和科研人员来说,真正的难点不是软件操作,而是流程是否规范、证据是否可靠。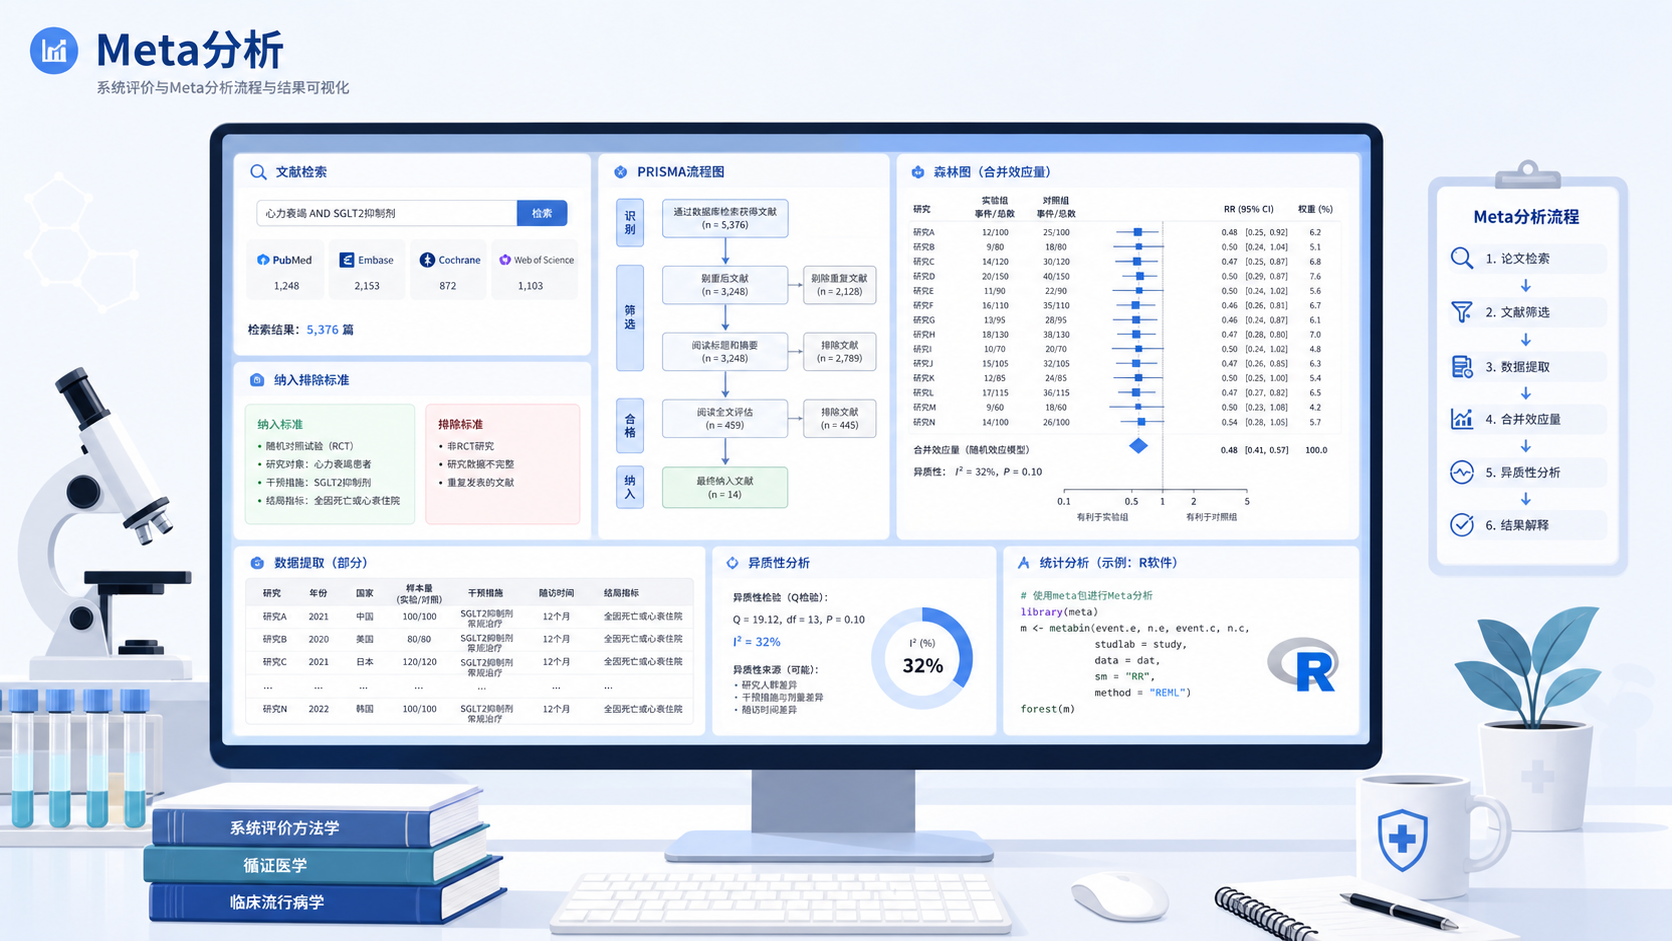
1. 先把选题做对
1.1 选题来自临床问题,而不是“为了发文”
Meta分析的起点不是软件,而是问题。好的题目通常来自临床未解问题,或同一主题研究结果存在冲突。 如果一个问题已经高度一致,或近一两年已有高质量Meta分析且新增研究很少,再做的价值就有限。
从实操角度看,选题至少要满足三点。
- 有明确临床意义。
- 存在结论分歧。
- 能找到足够数量、质量相近的原始研究。
如果题目过大,后续检索会噪音过多。如果题目过窄,可能纳入研究太少,无法合并。选题阶段决定了后面80%的工作是否顺利。
1.2 先判断研究类型,再决定是否适合做Meta
不同问题对应不同Meta类型。常见的包括连续性资料、二分类资料、诊断性研究、生存资料、率、剂量反应、网络Meta分析等。
你需要先明确:
- 结局是连续变量还是分类变量。
- 研究设计是RCT、队列研究,还是病例对照研究。
- 是否适合做定量合并。
不是所有系统评价都必须做Meta分析。 如果研究间临床异质性太强,或结局指标差异太大,可能更适合做定性系统评价。
2. 检索策略决定结果质量
2.1 检索式不是越大越好,先聚焦再放开
检索是Meta分析的核心环节之一。检索策略会直接影响最终纳入文献的范围。 常见错误是一次性把关键词放得太宽,结果得到大量无关文献,筛选成本极高。
更稳妥的做法是先聚焦,再逐步扩展。
- 先用核心疾病词和干预词组合。
- 再加入同义词、MeSH词和缩写。
- 最后根据检索结果微调范围。
这种方式更容易控制噪音,也更利于复现。
2.2 数据库要覆盖全面,避免遗漏
SCI写作不能只依赖单一数据库。至少应覆盖PubMed、Web of Science、Cochrane Library等。 如果研究涉及临床试验,Cochrane尤其重要。若主题与中文研究相关,也应考虑CNKI、万方、维普等数据库。
检索时建议同步记录以下信息。
- 数据库名称。
- 检索日期。
- 检索式全文。
- 限制条件,如语言、时间范围、研究类型。
这些信息不仅影响可重复性,也是后续写Methods的基础。
3. 筛选文献要有流程
3.1 初筛和精筛必须分开
文献筛选不是“看标题觉得像就留”。标准做法是两步筛选。
- 初筛:根据题目和摘要排除明显不相关研究。
- 精筛:阅读全文,核对纳排标准。
筛选阶段最好由两人独立完成。 这样可以减少主观偏差,也符合规范化写作要求。
3.2 争议要记录,不能直接跳过
实际操作中,冲突很常见。比如一篇文章到底算不算重复发表,或者结局指标是否符合标准。此时应记录争议点,由第三方裁定。
建议建立筛选记录表,写清楚每篇文献的排除原因。常见排除理由包括:
- 研究对象不符。
- 结局指标不符。
- 研究类型不符。
- 数据不完整。
- 重复发表或数据重叠。
筛选流程越透明,PRISMA图就越有说服力。
4. 数据提取要精确到结局层面
4.1 只提“有用数据”,不要把全文信息都搬进来
数据提取的目标,是为后续统计服务,不是整理笔记。通常需要提取研究基本特征、样本量、干预措施、随访时间和关注的outcomes。
如果是连续性资料,需要提取均数和标准差。如果是二分类资料,需要提取事件数和总例数。若涉及生存分析,则常需要HR及其95%CI。
提取数据前,先明确主要结局和次要结局。 否则很容易在写作时反复返工。
4.2 双人提取并核对是最低标准
高质量Meta分析通常采用双人提取,之后交叉核对。这样可以减少录入错误和理解偏差。对于原文中未直接给出SD、HR或事件数的情况,要先判断是否可以通过公式、图表或作者信息补足。
常见做法包括:
- 从图表中读数。
- 根据P值和区间估算。
- 联系原作者补充缺失信息。
数据不全时不要草率替代。统计前的错误,后面很难补救。
5. 统计分析要让结果站得住
5.1 先判断异质性,再决定模型
统计分析不是一键出图。首先要判断研究间是否同质。常用指标包括I²和Q检验。一般来说,I²越高,研究间异质性越明显。
统计策略通常包括:
- 异质性低时,考虑固定效应模型。
- 异质性较高时,考虑随机效应模型。
- 异质性过大时,先分析来源,再决定是否合并。
不要为了出一个“显著结果”强行合并。 这会削弱文章可信度。
5.2 森林图、漏斗图和偏倚评估缺一不可
Meta分析结果展示通常包括森林图。它能直观看到各研究效应量及合并效应。偏倚评估则常见于“红绿灯图”或ROB工具,目的是判断研究质量。
发表偏倚评估常见于漏斗图。若研究数量足够,也可进一步做统计检验。对证据强度要求更高时,还可加入GRADE评级,评估证据等级。
建议在结果部分至少交代以下内容。
- 合并效应量。
- 95%置信区间。
- P值。
- I²和异质性判断。
- 偏倚风险。
- 发表偏倚情况。
只有把统计讲清楚,结论才有说服力。
6. 按PRISMA 2020规范完成写作
6.1 PRISMA不是形式,而是SCI写作骨架
PRISMA 2020包含27条报告规范,是系统评价和Meta分析最常用的写作框架之一。它不是“附录”,而是整篇文章的结构指南。
写作时通常对应以下部分:
- Title和Abstract。
- Introduction。
- Methods。
- Results。
- Discussion。
- Funding和其他声明。
其中Methods最关键,要能让别人复现你的研究流程。如果方法写不清,结果再漂亮也很难过审。
6.2 写作时要把流程和证据链串起来
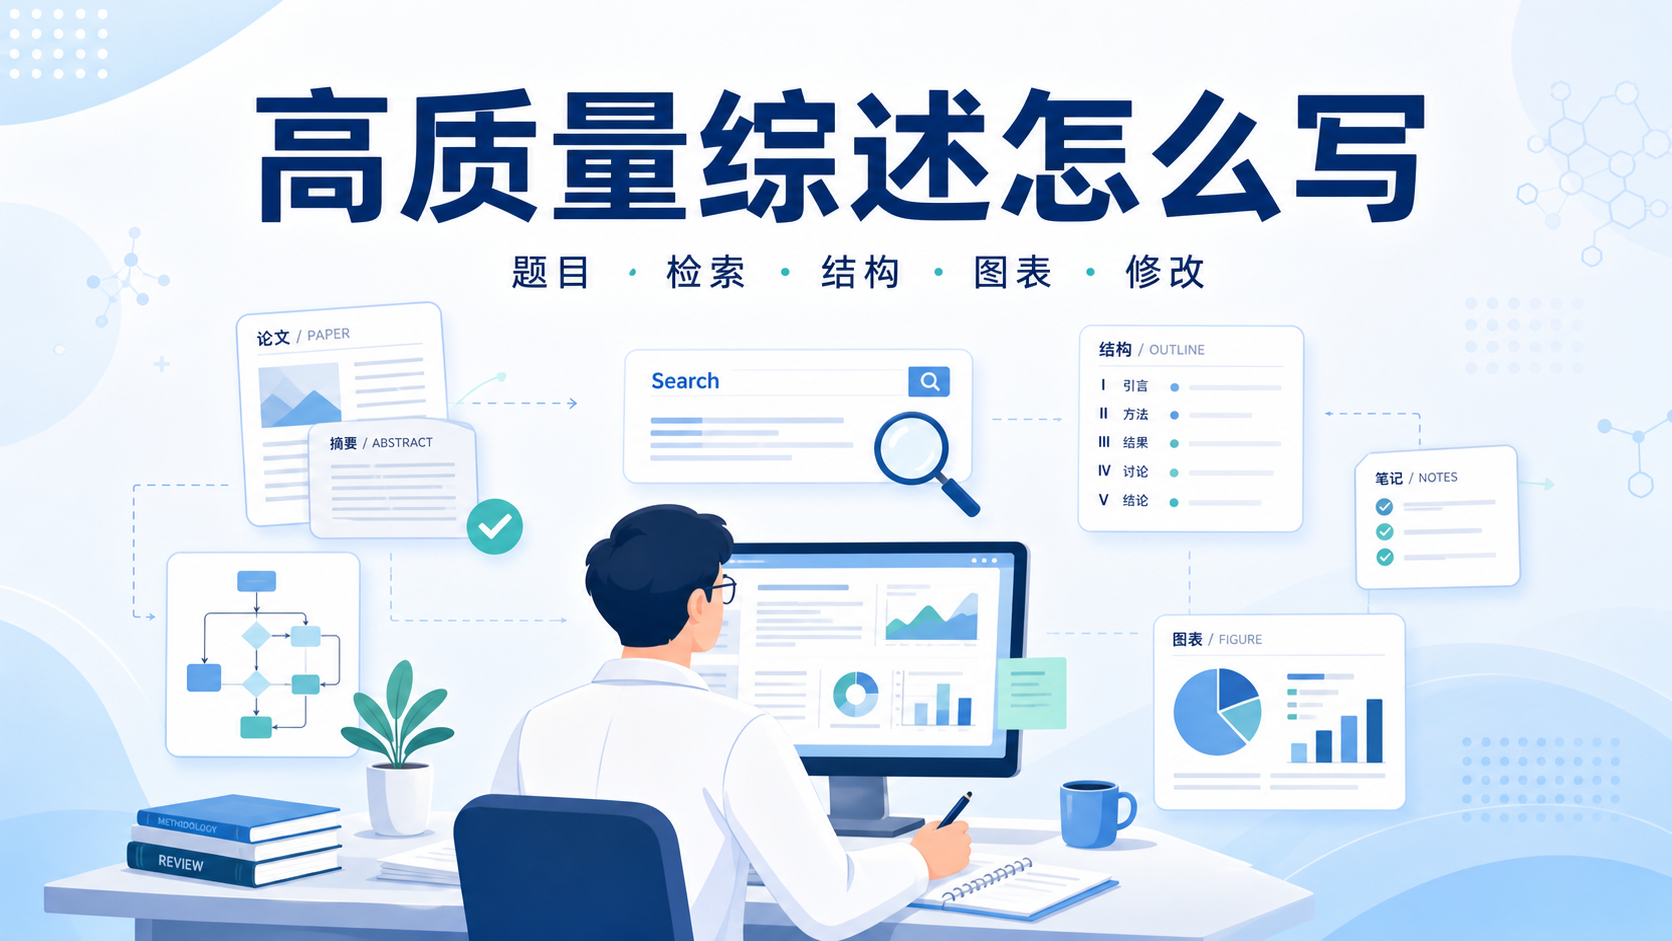
一篇合格的Meta分析,不是把图表堆在一起,而是把证据链写完整。推荐写作顺序如下。
- 先写Methods,固定检索、筛选和统计流程。
- 再写Results,按流程图、特征表、森林图依次展开。
- 最后写Discussion,解释异质性、局限性和临床意义。
讨论部分不要只重复结果。要回答三个问题:
- 为什么会得到这个结果。
- 这个结果对临床意味着什么。
- 研究还存在哪些局限。
遵循PRISMA,能显著提升文章的规范性和可发表性。
总结Conclusion
Meta分析SCI写作的关键,不在于“会不会跑软件”,而在于是否把六步走通:选题、检索、筛选、提取、统计、写作。 只要前四步扎实,后面的统计和成文就会顺很多。对科研新手来说,最大的风险往往不是不会做,而是流程不规范、证据链不完整。
如果你正在准备SCI论文meta分析写作,建议从选题和检索式开始就建立标准化流程。想更高效地完成文献筛选、数据提取和PRISMA写作,可以借助解螺旋 的专业支持,把复杂流程拆成可执行步骤,让你的Meta分析更规范,也更接近发表标准。
- 引言Introduction
- 1. 先把选题做对
- 2. 检索策略决定结果质量
- 3. 筛选文献要有流程
- 4. 数据提取要精确到结局层面
- 5. 统计分析要让结果站得住
- 6. 按PRISMA 2020规范完成写作
- 总结Conclusion