

 9
 分享
引言Introduction
SCI论文写作与数据处理,常卡在两个点。第一,题目有了,却不知道数据怎么整理。第二,数据整理好了,文章却写不顺。对临床医生和硕博生来说,真正的难点不是“不会写”,而是缺少一条可落地的实战路径。
1. 为什么SCI论文写作离不开数据处理
1.1 数据不是附属品,而是论文骨架
SCI论文的核心不是“写得像论文”,而是让数据支持你的结论 。无论是回顾性研究、横断面研究,还是meta分析,数据处理决定了结果是否可信,也决定了审稿人是否愿意继续看下去。
对临床医生而言,最常见的误区是先写结果,再回头补数据。这样很容易出现变量定义不一致、缺失值处理混乱、统计方法与研究设计不匹配等问题。对于硕博生,问题常出现在数据来源不清、分组逻辑不严、结局指标不统一。
简单说,数据处理做不好,写作再好也只是包装。
1.2 研究类型决定数据处理方式
不同文章类型,数据处理逻辑完全不同。常见类型包括:
- 回顾性研究,重点在病例筛选、变量提取、混杂因素控制。
- 前瞻性研究,重点在随访设计、结局定义、脱落处理。
- 横断面研究,重点在样本代表性和关联分析。
- RCT,重点在随机化、盲法和意向性分析。
- Meta分析,重点在文献筛选、数据提取和异质性评估。
如果研究设计不清,后面的统计就会失真。比如,回顾性研究常见的是单中心、样本量有限,这时更要重视变量预设、分层分析和敏感性分析 。这也是很多临床SCI论文能否顺利发表的分水岭。
1.3 医生和硕博生最容易忽略的前置工作
在真正开始写之前,至少要先完成三件事:
- 明确研究问题。
- 定义主要结局和次要结局。
- 制定数据字典,统一变量命名和编码。
很多人把这一步省略,直接导出Excel就开始做图,最后发现年龄、性别、分组、时间点的命名都不一致,无法分析。这类问题一旦进入统计阶段,返工成本非常高。
2. SCI论文数据处理的实战步骤
2.1 第一步:先建数据框架,再收集数据
临床科研最有效的方式,不是“先收多少算多少”,而是先建立数据框架。数据框架至少包括:
- 纳入排除标准。
- 基线特征。
- 暴露因素或干预因素。
- 主要终点。
- 次要终点。
- 随访时间点。
- 缺失值处理规则。
如果是临床回顾性研究,建议在正式提取前先做一版“试运行”。抽取10到20例样本,检查变量是否完整,是否有定义冲突。这个步骤能提前发现不少问题。
2.2 第二步:清洗数据,比建模更重要
数据清洗决定了后续结果是否稳定。常规要做的包括:
- 检查重复病例。
- 统一单位和量纲。
- 修正明显录入错误。
- 处理异常值。
- 标记缺失值来源。
比如实验室指标可能出现不同单位,影像指标可能来自不同系统,手术时间可能记录成分钟或小时。不统一,统计结果就没有可比性。
对于科研人员来说,数据清洗不是简单删掉异常值。更规范的做法是先判断异常值是否来自录入错误、测量误差,还是临床真实波动。不同情况,处理策略不同。必要时要保留原始记录,便于审稿时解释。
2.3 第三步:统计方法要和问题匹配
统计不是越复杂越好,而是要和研究问题匹配。常见的基本原则是:
- 连续变量先看分布。
- 分类变量优先做组间比较。
- 相关性分析不等于因果推断。
- 多因素分析用于控制混杂。
- 生存结局要用生存分析方法。
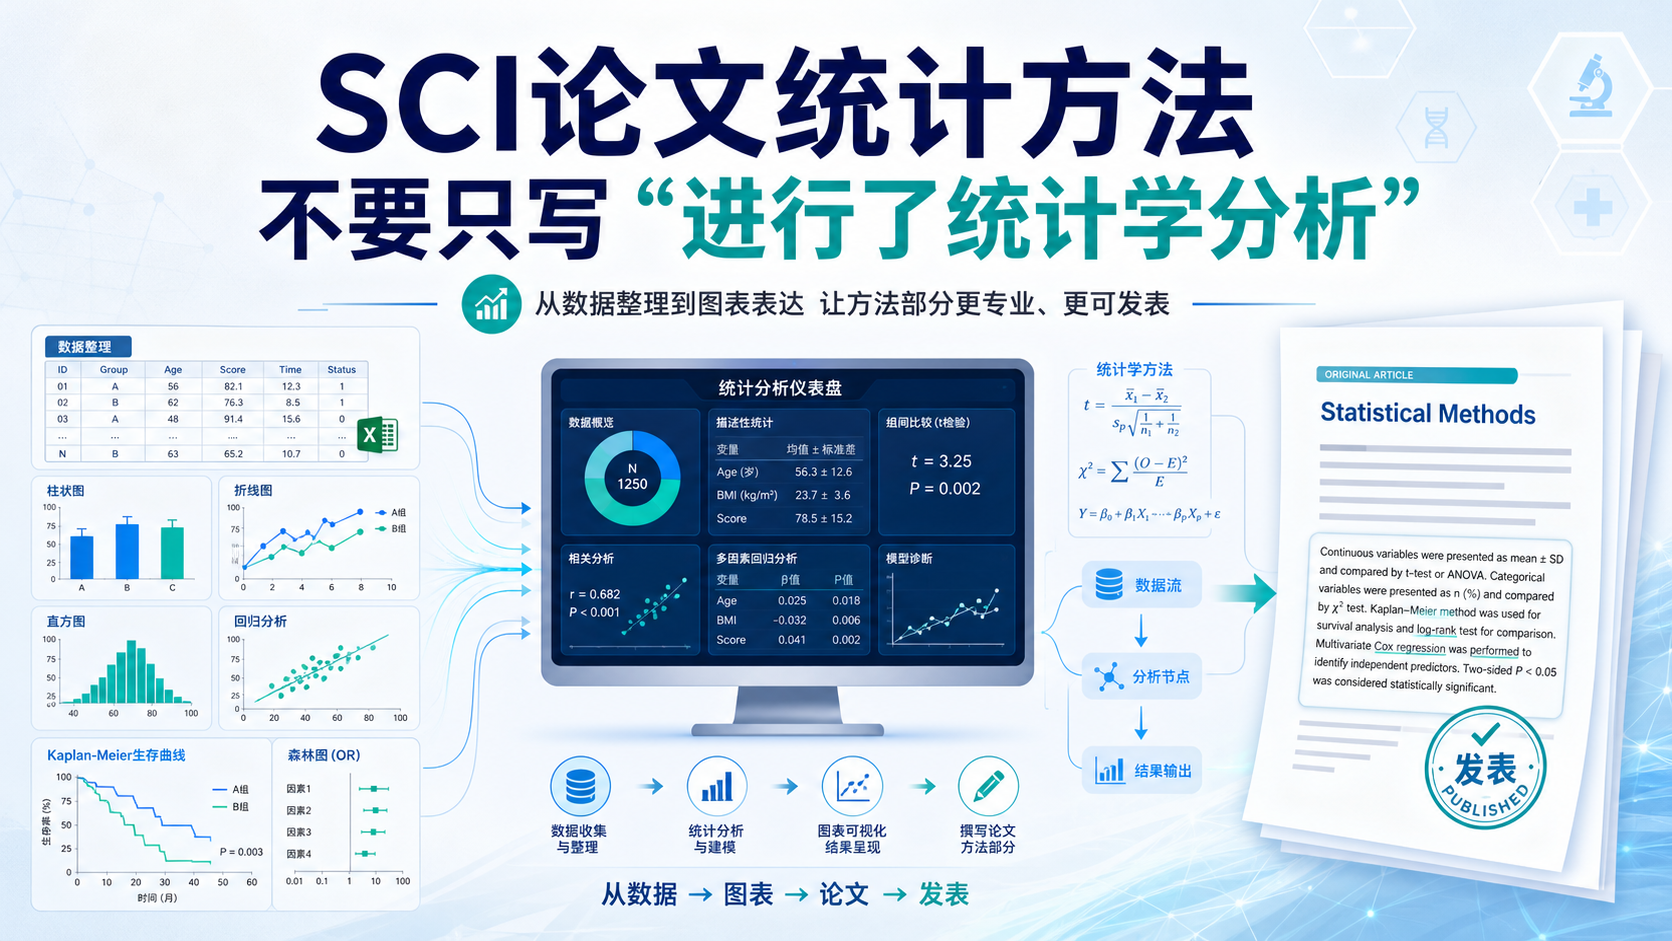
例如,若结局是生存时间,不能只做t检验或卡方检验。应考虑Kaplan-Meier曲线、log-rank检验,必要时使用Cox回归。若是多组比较,也要注意方差齐性和事后检验方法。
统计方法写错,是SCI论文最常见的硬伤之一。 审稿人往往一眼就能看出来。
2.4 第四步:把统计结果转成论文语言
很多人会做统计,却不会写结果。其实结果部分的写作逻辑很固定。
建议按这个顺序写:
- 先写样本来源和最终纳入人数。
- 再写基线特征。
- 然后写主要结局。
- 最后补充次要结局和亚组分析。
结果部分要避免两种错误。第一,堆数字,不解释重点。第二,只写显著性,不写临床意义。SCI论文更看重“结果意味着什么”,而不是“P值是多少”。
3. 写作环节如何把数据优势变成文章优势
3.1 方法部分要写清楚可重复性
方法部分不是“流水账”,而是让别人能够复现你的研究。必须交代清楚的内容包括:
- 研究设计类型。
- 数据来源和时间范围。
- 纳入排除标准。
- 变量定义。
- 统计软件和版本。
- 显著性水平设定。
如果是多中心研究,还要说明各中心数据是否统一口径。若使用SPSS、GraphPad或Stata,也应写清版本号。对审稿人来说,这些细节直接影响可信度。
3.2 结果部分要服务于结论,而不是复制表格
结果表格很重要,但论文不是表格汇总。作者需要做的是提炼主线。比如:
- 哪个变量与结局相关。
- 哪些因素在多因素分析中仍然显著。
- 效应量有多大。
- 结果是否稳定。
真正高质量的结果写作,是把数据中的“变化”变成“故事线”。 这也是很多临床医生文章能脱颖而出的关键。
3.3 讨论部分要回到临床问题
讨论部分不能只引用文献。要回答三个问题:
- 你的结果和既往研究是否一致。
- 如果不一致,原因是什么。
- 这个结果对临床实践有什么意义。
临床医生和硕博生都容易犯一个错,就是把讨论写成文献拼接。实际上,讨论的核心是解释你的数据,并把它放回真实临床场景中。没有临床指向的讨论,论文很难体现价值。
4. 不同阶段的人,应该怎么走这条路
4.1 临床医生:优先选择可落地的研究
对临床医生来说,最现实的起点通常是回顾性研究或病例系列。原因很简单,门槛低,数据可得,能快速形成闭环。若科室已有病种队列,最好围绕单病种持续积累。
实战中,可以优先选择:
- 单中心回顾性分析。
- 病例对照研究。
- 围绕临床痛点的小规模前瞻性观察。
- 质量改进相关研究。
先完成一篇,再迭代一篇。 这是临床医生提升SCI产出的高效路径。
4.2 硕博生:优先建立规范化数据能力
硕博生的优势在于学习能力强,时间相对集中。建议把重点放在:
- 学会整理原始数据。
- 学会理解变量类型。
- 学会基础统计逻辑。
- 学会用图表表达结果。
如果能在课题早期就建立标准化数据库,后续写作效率会明显提升。对于需要答辩和发表双重目标的学生来说,这一步尤其重要。
4.3 工具可以提升效率,但不能替代方法
现在很多人依赖Excel、SPSS、GraphPad和Stata,但工具只是工具。真正决定质量的,仍然是研究设计和数据逻辑。工具能加快处理速度,却不能替你判断变量是否合适、模型是否合理、结论是否过度延伸。
因此,不要把“会软件”误认为“会科研”。
5. 如何借助解螺旋提升SCI论文数据处理写作效率
如果你已经有选题,但卡在数据整理、统计分析和写作衔接,最需要的不是再堆文献,而是一套能直接执行的方法。解螺旋提供的价值,就在于把临床研究的关键步骤拆开讲清楚,让你少走弯路。
对于医生和硕博生来说,真正高效的路径是:
- 先规范数据收集。
- 再完成基础统计。
- 然后按论文结构写作。
- 最后根据审稿逻辑修订。
当数据处理和写作能够同步推进,SCI论文就不再是“卡住的任务”,而是一条可复制的流程。 如果你希望把研究思路、统计方法和论文表达真正串起来,解螺旋会是很实用的选择。
总结Conclusion
SCI论文写作与数据处理,本质上是一体两面。数据决定论文的下限,写作决定论文能否被看见。对医生和硕博生而言,最重要的不是追求复杂,而是把研究设计、数据清洗、统计分析和结果表达做扎实。只有把每一步做对,论文才有机会稳、准、快地推进。 如果你正在做临床科研或准备发表论文,可以系统了解解螺旋,把数据处理和SCI写作真正落到实战中。
- 引言Introduction
- 1. 为什么SCI论文写作离不开数据处理
- 2. SCI论文数据处理的实战步骤
- 3. 写作环节如何把数据优势变成文章优势
- 4. 不同阶段的人,应该怎么走这条路
- 5. 如何借助解螺旋提升SCI论文数据处理写作效率
- 总结Conclusion