

 12
 分享
引言Introduction
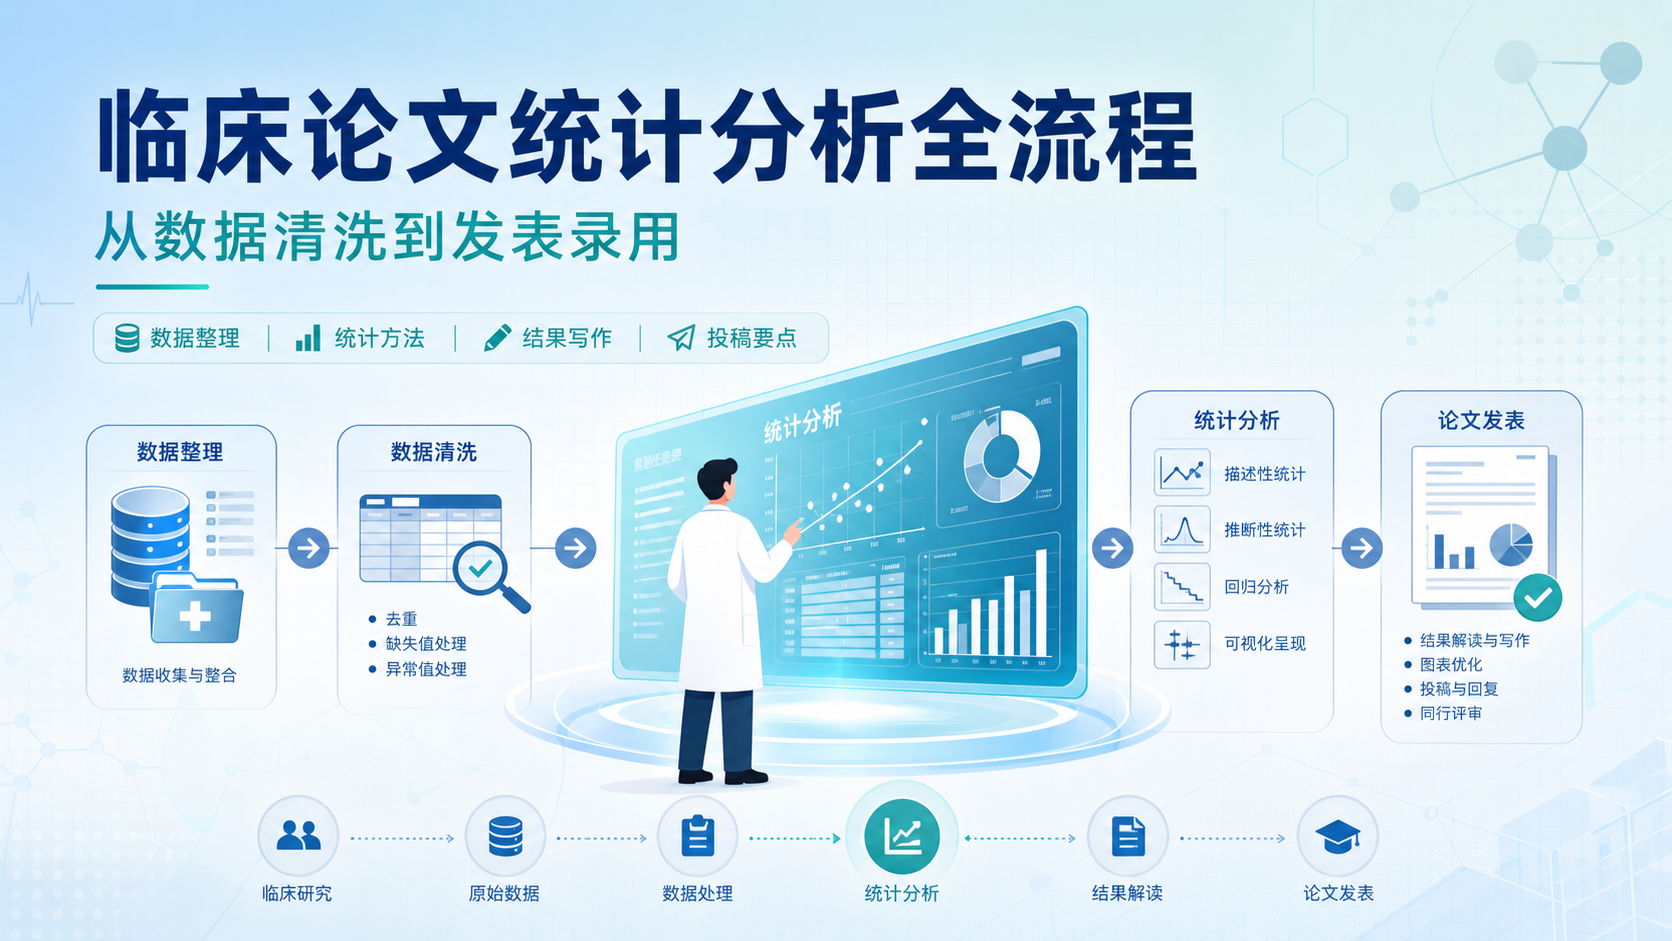
临床研究不缺数据,缺的是把数据变成可发表结果的能力。很多医生卡在数据清洗、统计分析和写作衔接上,最后论文质量不稳,投稿也容易被退回。想发统计源期刊临床论文,核心不是“有数据”,而是“数据能否支撑清晰、可重复、可发表的结论”。 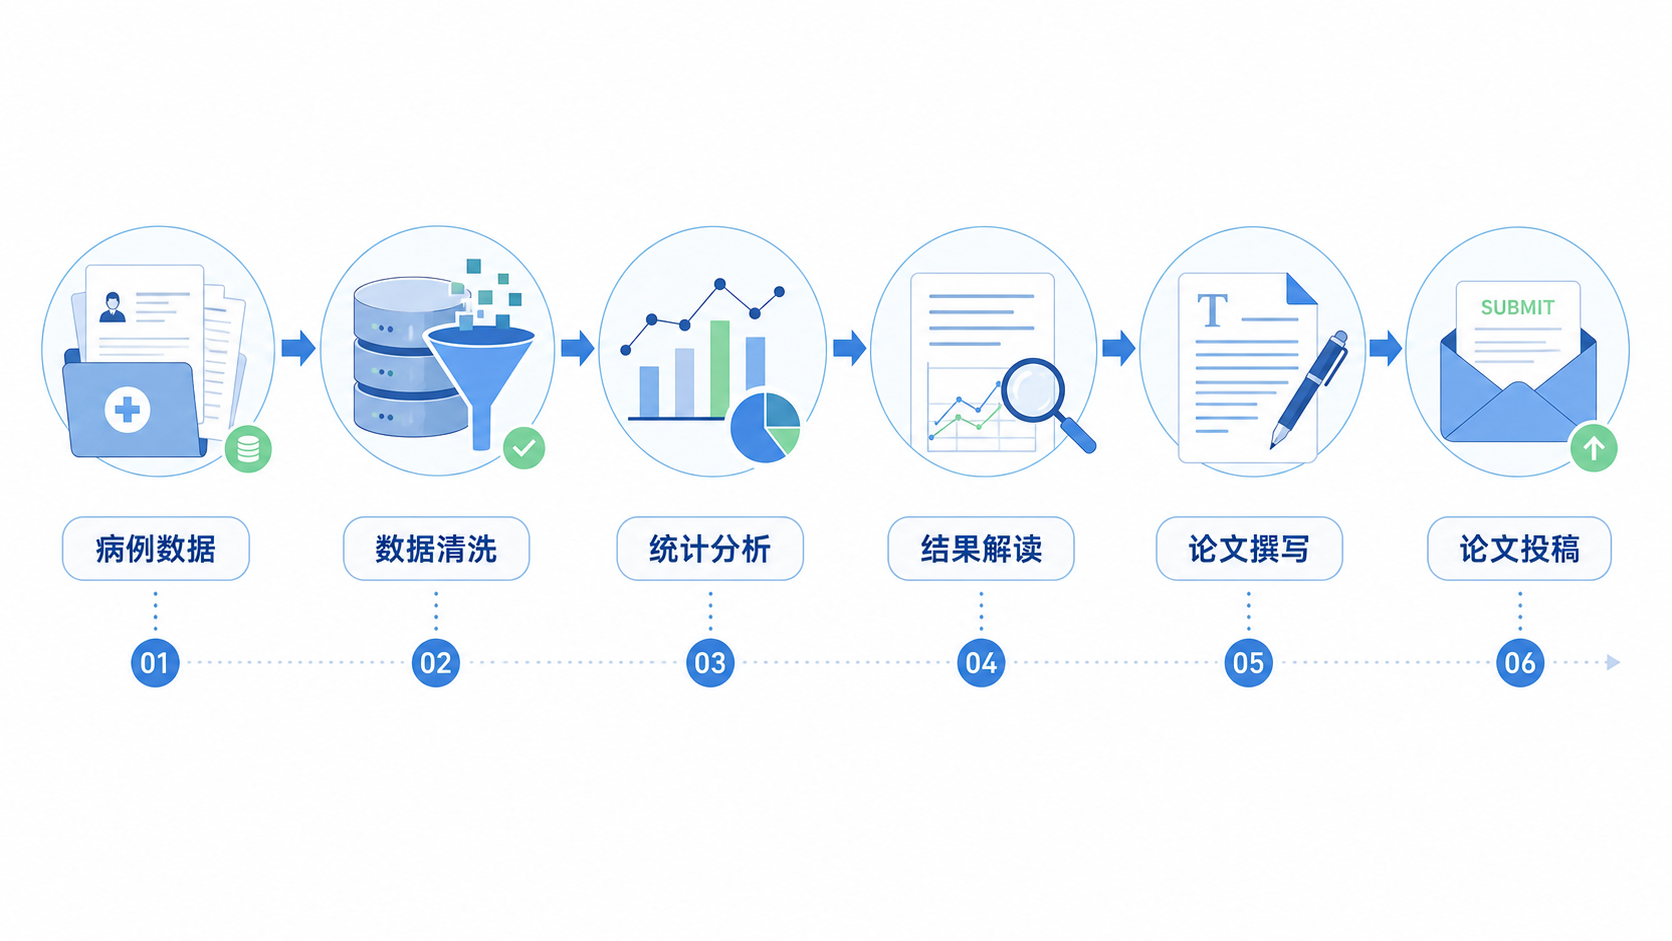
1. 临床论文发表前,先把数据变成“可分析数据”
1.1 数据获取不是终点,整理才是开始
临床论文的第一步,是拿到真实、完整、可追溯的数据。常见来源包括病案系统、随访系统、检验数据库、影像系统和科室自建数据库。数据拿到后,不能直接分析,必须先完成整理。
最常见的问题有三类。
- 变量命名不统一。
- 时间节点不一致。
- 结局指标定义不清。
如果这些基础问题不处理,后续统计结果再漂亮,也很难通过审稿。尤其是统计源期刊临床论文,更强调数据逻辑完整、方法透明、结论可信。
1.2 变量说明表,是后续分析的基础
整理数据时,建议先做变量说明表。内容至少包括:
- 变量名称。
- 变量定义。
- 取值范围。
- 缺失值编码。
- 统计用途。
这一步看似简单,但非常关键。因为变量说明表能帮助团队统一口径,减少分析偏差,也方便后续复核。很多临床论文返工,根源都不是统计方法,而是变量定义前后不一致。
1.3 数据导入统计软件前,要先做结构化处理
数据整理完成后,再导入SPSS、R或Stata等统计软件。导入前最好完成以下处理:
- 去除重复记录。
- 统一日期格式。
- 规范分类变量。
- 标记缺失值。
这样做的目的很明确,就是让原始临床数据变成可分析数据库。只有完成这一步,才谈得上真正进入科研分析阶段。
2. 数据清洗决定结果质量,不能跳过
2.1 先识别重复值、异常值和缺失值
临床数据最常见的质量问题,就是重复变量、异常值和缺失值。临床论文中,这些问题如果不处理,会直接影响统计结论。
建议按顺序检查:
- 重复病例。
- 逻辑冲突值。
- 极端异常值。
- 关键变量缺失。
比如,年龄为负数、手术日期早于入院日期、随访时间为0但结局已发生,这些都属于典型逻辑错误。这些问题不是“统计细节”,而是论文可信度的底线。
2.2 缺失值不能一概删除
缺失值处理要根据研究设计决定。常见方法包括:
- 完全病例分析。
- 均值或中位数填补。
- 多重插补。
- 将缺失作为独立组处理。
但要注意,不能为了“凑数据”随意填补。对于统计源期刊临床论文,审稿人通常会关注缺失值处理是否合理,是否影响结果稳健性。缺失值处理必须写清楚方法,也要说明为什么这样处理。
2.3 清洗后要做验证,避免带着错误进入分析
清洗完成后,不要直接出结果,必须做验证。验证重点包括:
- 抽查原始病历与数据库是否一致。
- 复核异常值是否被正确处理。
- 检查关键结局是否被遗漏。
- 确认变量编码是否统一。
这一步相当于“质控”。如果前面清洗错了,后面的生存分析、回归分析、分层分析都会被带偏。临床论文的可靠性,往往就体现在这最后一道验证上。
3. 从数据库到统计结果,方法选择要和问题匹配
3.1 先明确研究问题,再决定统计方法
统计方法不是先选再套,而是根据研究问题倒推。常见临床研究问题可分为四类:
- 描述人群特征。
- 比较组间差异。
- 分析影响因素。
- 评估预后结局。
不同问题对应不同方法。比如:
- 分类变量比较可用卡方检验。
- 两组连续变量比较可用t检验或秩和检验。
- 多因素影响分析常用Logistic回归。
- 生存结局常用Kaplan-Meier和Cox回归。
方法选错,结果再显著也没有说服力。
3.2 生存分析是临床论文高频模块
很多统计源期刊临床论文都会涉及生存分析。因为它能回答“患者能活多久”“什么因素影响预后”这类核心问题。常见步骤包括:
- 画Kaplan-Meier曲线。
- 做log-rank检验。
- 进行单因素和多因素Cox回归。
- 检查比例风险假设。
如果研究对象是肿瘤、慢病或术后随访人群,生存分析尤其重要。一篇临床论文能不能站住,往往取决于终点设置是否合理,生存模型是否规范。
3.3 亚组分析和敏感性分析能提高结果稳定性
如果研究样本量允许,可以考虑亚组分析和敏感性分析。它们的作用不是“增加图表”,而是验证结论是否稳定。比如:
- 不同性别。
- 不同分期。
- 不同治疗方式。
- 不同年龄层。
但要注意,亚组不能无限制拆分,否则容易出现假阳性。临床论文中,统计越复杂,不代表文章越好,关键是分析是否服务于研究问题。
4. 临床论文写作,要把结果写成“审稿人看得懂的证据链”
4.1 结果部分要先讲主结论,再讲细节
结果部分建议按“总体特征—组间比较—回归分析—验证分析”的顺序来写。不要一上来堆数字。因为临床论文的核心,是让读者迅速看到你的研究发现。
常见写法包括:
- 研究对象的基线特征。
- 主要终点事件发生情况。
- 单因素和多因素分析结果。
- 图表对应的关键结论。
结果部分不是数据仓库,而是证据展示区。
4.2 讨论部分要解释“为什么”,而不只是“是什么”
很多论文的问题不在结果,而在讨论。讨论部分要完成三件事:
- 解释结果的临床意义。
- 对照既往研究。
- 说明局限性。
比如,如果某个指标与预后显著相关,就要解释它可能的机制、临床可操作性以及是否能用于风险分层。对于统计源期刊临床论文来说,讨论部分最怕空泛。没有机制解释和临床落点,论文容易显得浅。
4.3 图表要少而精,服务核心结论
图表不是越多越好。临床论文常用图包括:
- 流程图。
- 基线特征表。
- 森林图。
- 生存曲线。
- 校准曲线。
如果是数据规范、结果清楚的研究,通常5到8个核心图表就够了。图表的任务,是把复杂结果讲清楚,而不是堆砌视觉效果。高质量临床论文的特点,是图表少但逻辑强。
5. 从投稿到录用,统计源期刊更看重哪些点
5.1 期刊关注的不只是创新,还有规范
统计源期刊临床论文投稿时,审稿人通常会重点看:
- 研究设计是否清楚。
- 数据是否真实完整。
- 统计方法是否正确。
- 结论是否被数据支持。
- 写作是否符合指南。
如果是回顾性研究,最好明确纳入排除标准、伦理审批、随访方式和终点定义。规范性不足,是很多临床论文被退稿的主要原因。
5.2 常见退稿点,往往集中在三个环节
很多临床论文反复修改,通常问题出在:
- 数据质量差,清洗不彻底。
- 统计方法与研究问题不匹配。
- 结果和讨论脱节。
这些问题看似分散,其实都指向同一个核心,就是证据链不完整。临床研究不是单点突破,而是从数据、统计到写作的连续工程。
5.3 让论文更容易通过的实用建议
如果目标是统计源期刊临床论文,建议优先做到以下几点:
- 提前设计变量和结局。
- 保留完整原始数据备份。
- 做好数据字典和版本管理。
- 统计前先锁定数据库。
- 按指南写作,如STROBE等。
研究越早标准化,后期修改成本越低。
6. 用解螺旋,把“临床数据”变成“可发表结果”
6.1 适合临床医生的,是可落地的数据处理流程
很多临床医生有病例、有随访、有课题想法,但缺的是一套从数据整理到统计分析的完整路径。尤其在时间紧、任务重的情况下,最需要的是稳定、规范、可执行的支持。
这也是为什么临床论文写作不能只靠经验。你需要的是标准化流程,而不是临时拼凑。从数据清洗、变量定义到统计分析,每一步都要可追踪、可复核。
6.2 解螺旋的价值,在于把复杂流程拆成可执行步骤
如果你正在做统计源期刊临床论文,解螺旋可以帮助你把科研流程拆开处理。包括:
- 数据整理与质控。
- 统计分析思路梳理。
- 图表和结果结构化呈现。
- 论文写作框架优化。
这样做的好处很直接。你不用在每个环节反复试错,可以更快把临床数据转化为标准化结果。对医生和科研人员来说,节省时间,就是提高发表效率。
总结Conclusion
统计源期刊临床论文的本质,是把真实临床数据转化为可信证据。路径很清楚。先整理数据,再做清洗和验证,然后匹配统计方法,最后完成规范写作与投稿。只要数据库干净、方法合理、结论清晰,论文就具备发表基础。
如果你正在推进临床课题,但卡在数据处理、统计分析或写作衔接,建议尽早建立标准流程。也可以借助解螺旋的科研支持,把复杂环节拆解成可执行步骤,让你的统计源期刊临床论文更快走向发表。
- 引言Introduction
- 1. 临床论文发表前,先把数据变成“可分析数据”
- 2. 数据清洗决定结果质量,不能跳过
- 3. 从数据库到统计结果,方法选择要和问题匹配
- 4. 临床论文写作,要把结果写成“审稿人看得懂的证据链”
- 5. 从投稿到录用,统计源期刊更看重哪些点
- 6. 用解螺旋,把“临床数据”变成“可发表结果”
- 总结Conclusion