15
 分享
引言Introduction
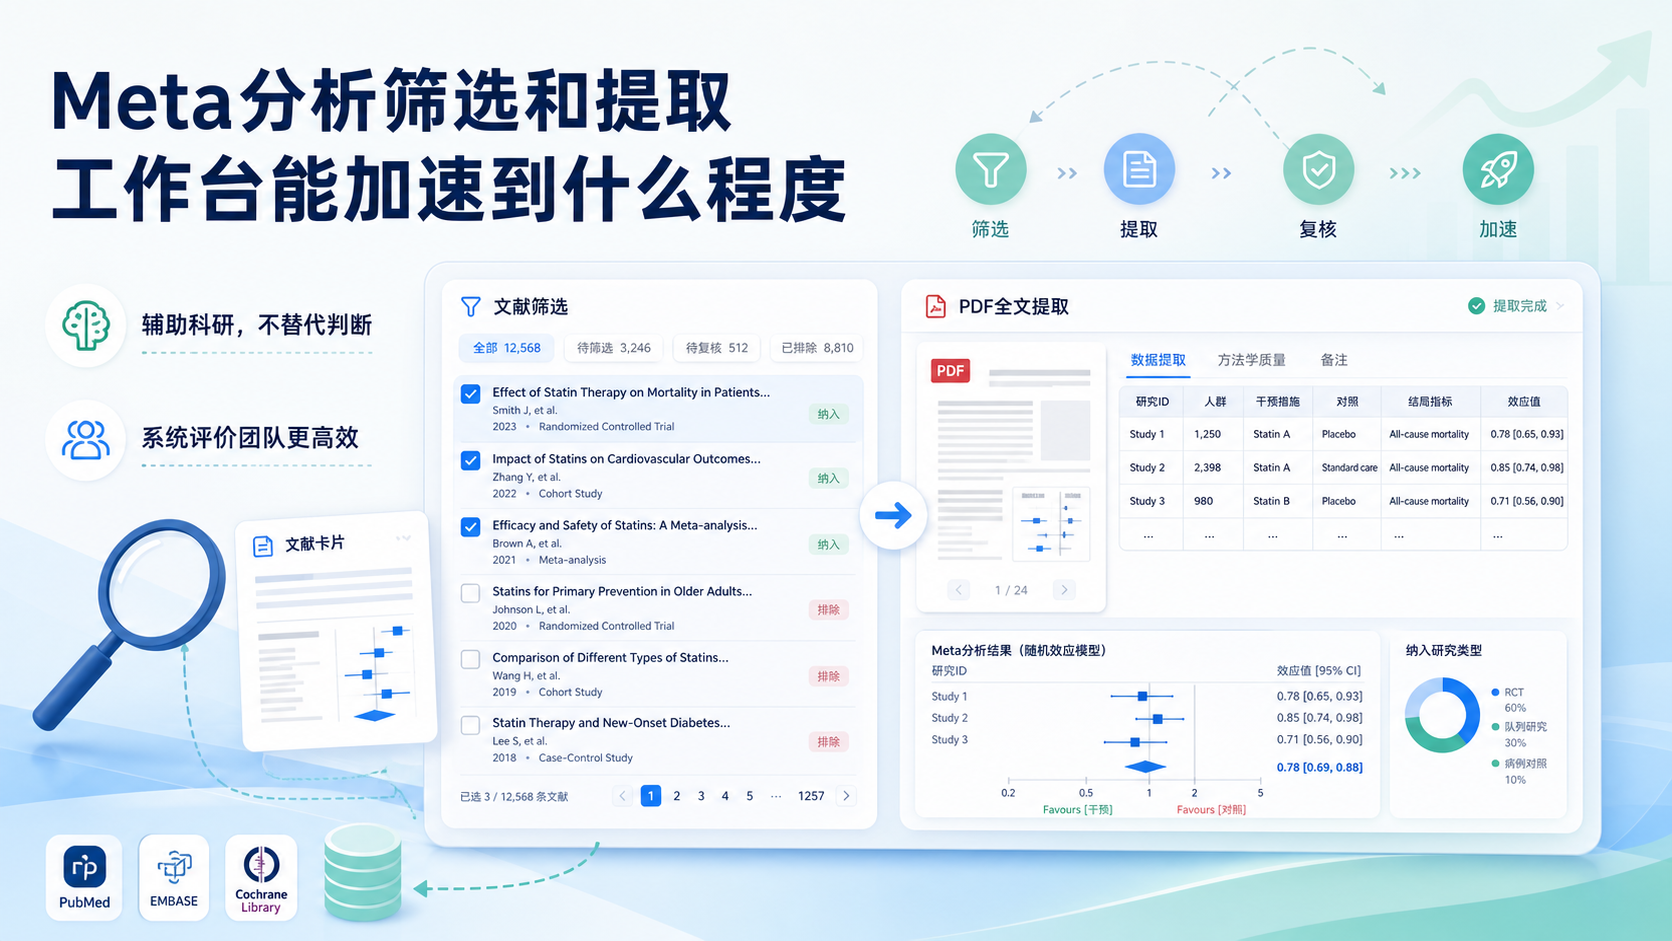
做Meta分析,最耗时的往往不是写论文,而是文献筛选和数据提取。初筛看标题摘要,精筛看全文,数据还要逐篇整理,效率低,且容易出错。如果你正在做系统评价或Meta分析,AI工作台能否真正提速,是最现实的问题。
1. 为什么Meta分析最卡在筛选和提取环节
1.1 论文筛选本身就是高负荷任务
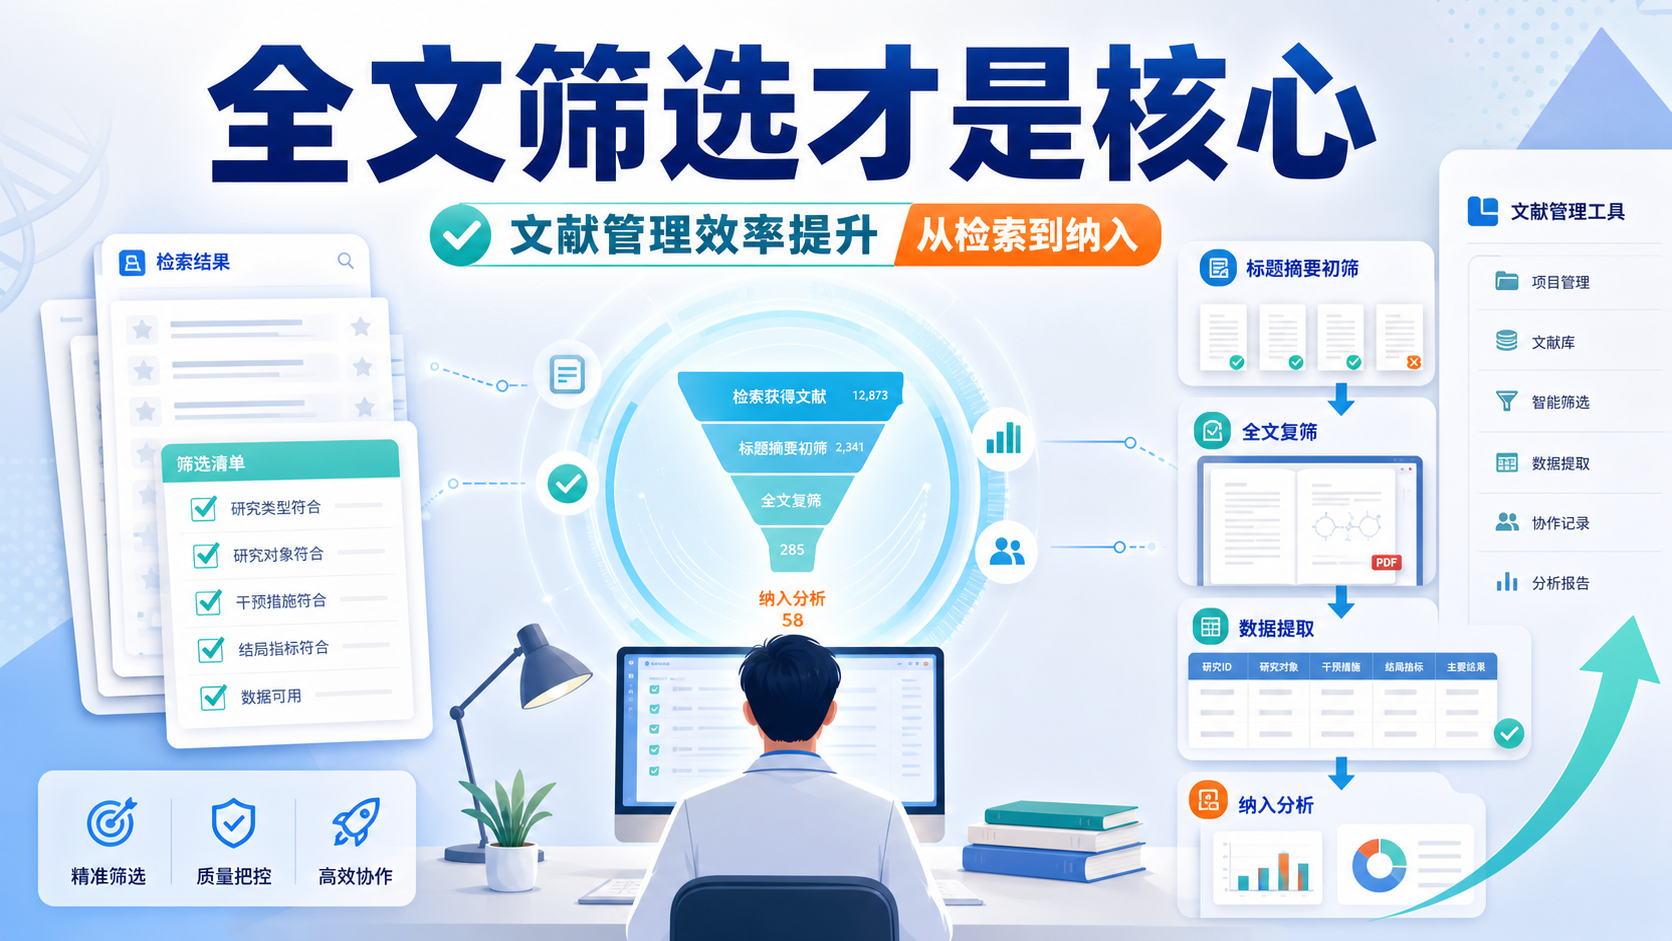
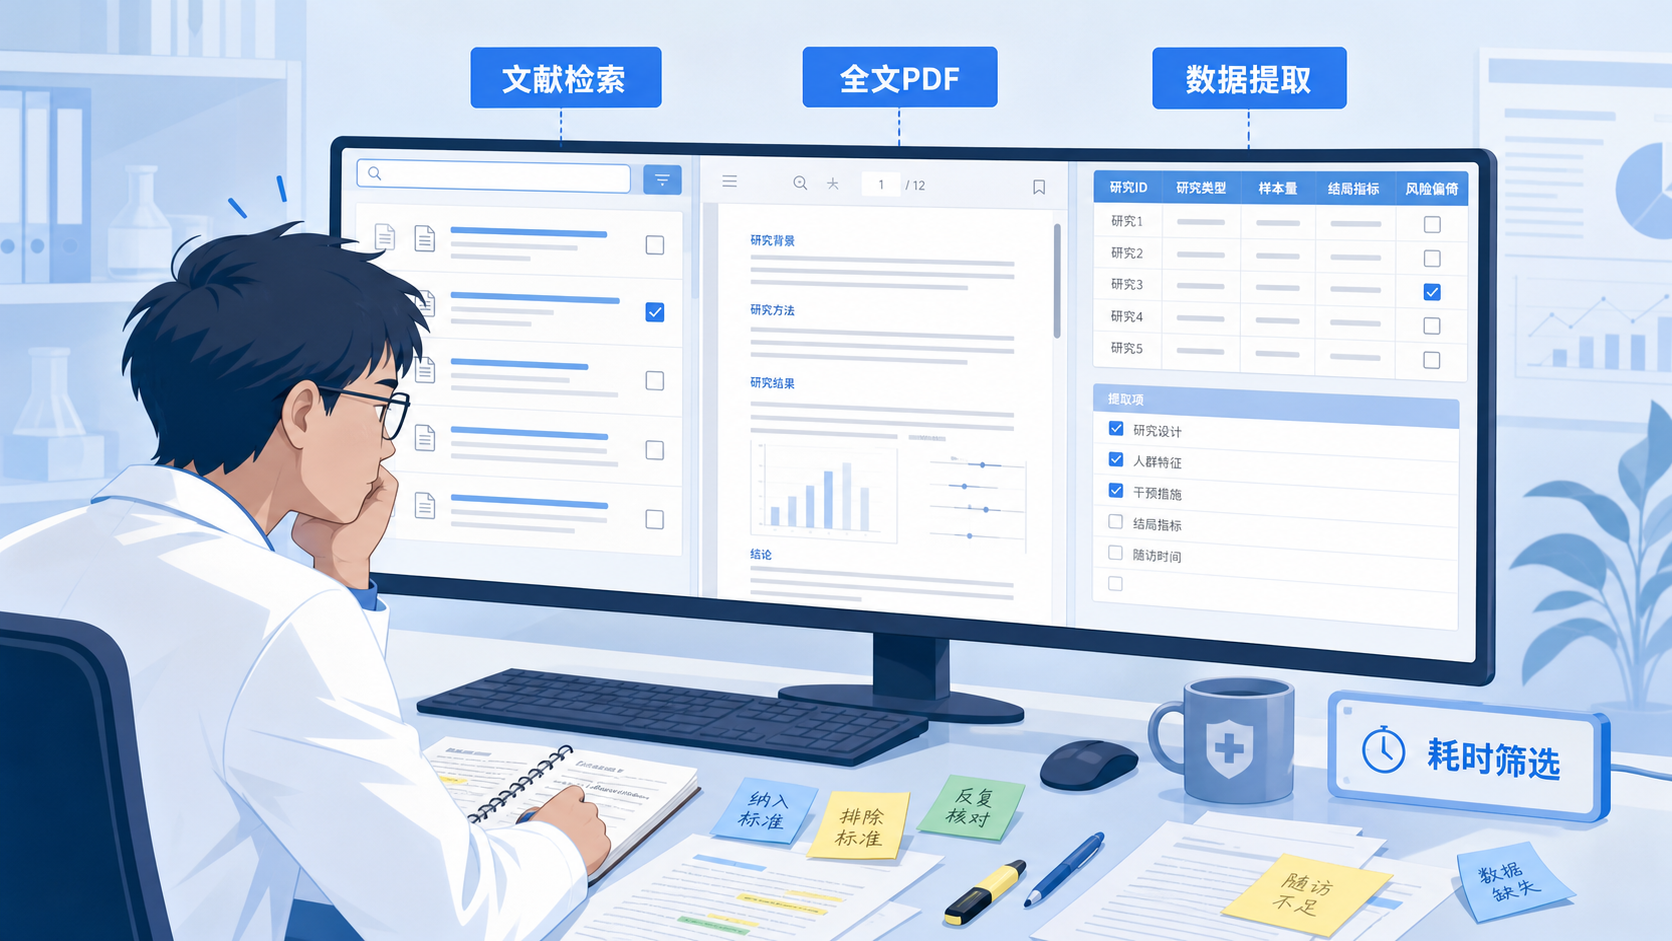
Meta分析通常先做标题和摘要初筛,再做全文精筛。这个过程看似简单,实际很耗精力。尤其是检索量较大时,单靠人工逐篇判断,时间成本会迅速上升。
双人独立筛选和冲突解决,是规范流程。 这意味着并不是“看一眼就完”,而是要记录排除理由、保留依据和一致性结果。对医学生和研究生来说,这一环常常是最容易拖慢进度的地方。
1.2 数据提取比筛选更细、更容易出错
筛完文献后,还要从全文里提取所有关键outcomes,整理成可分析的数据表。这个过程比很多人想得更复杂,因为不仅要找数值,还要核对干预、对照、随访时间和结局定义。
经验丰富的人,提取一篇文章可能也要接近1小时。如果文献数量多,数据提取会成为最明显的瓶颈。 而且,提取错误会直接影响后续统计结果和结论可靠性。
1.3 传统流程对时间和一致性要求都很高
传统Meta分析强调规范,但规范也意味着工作量大。筛选阶段要尽量减少漏检,提取阶段要尽量减少误录。只要其中一个环节不稳,后面的统计和结论都会受影响。
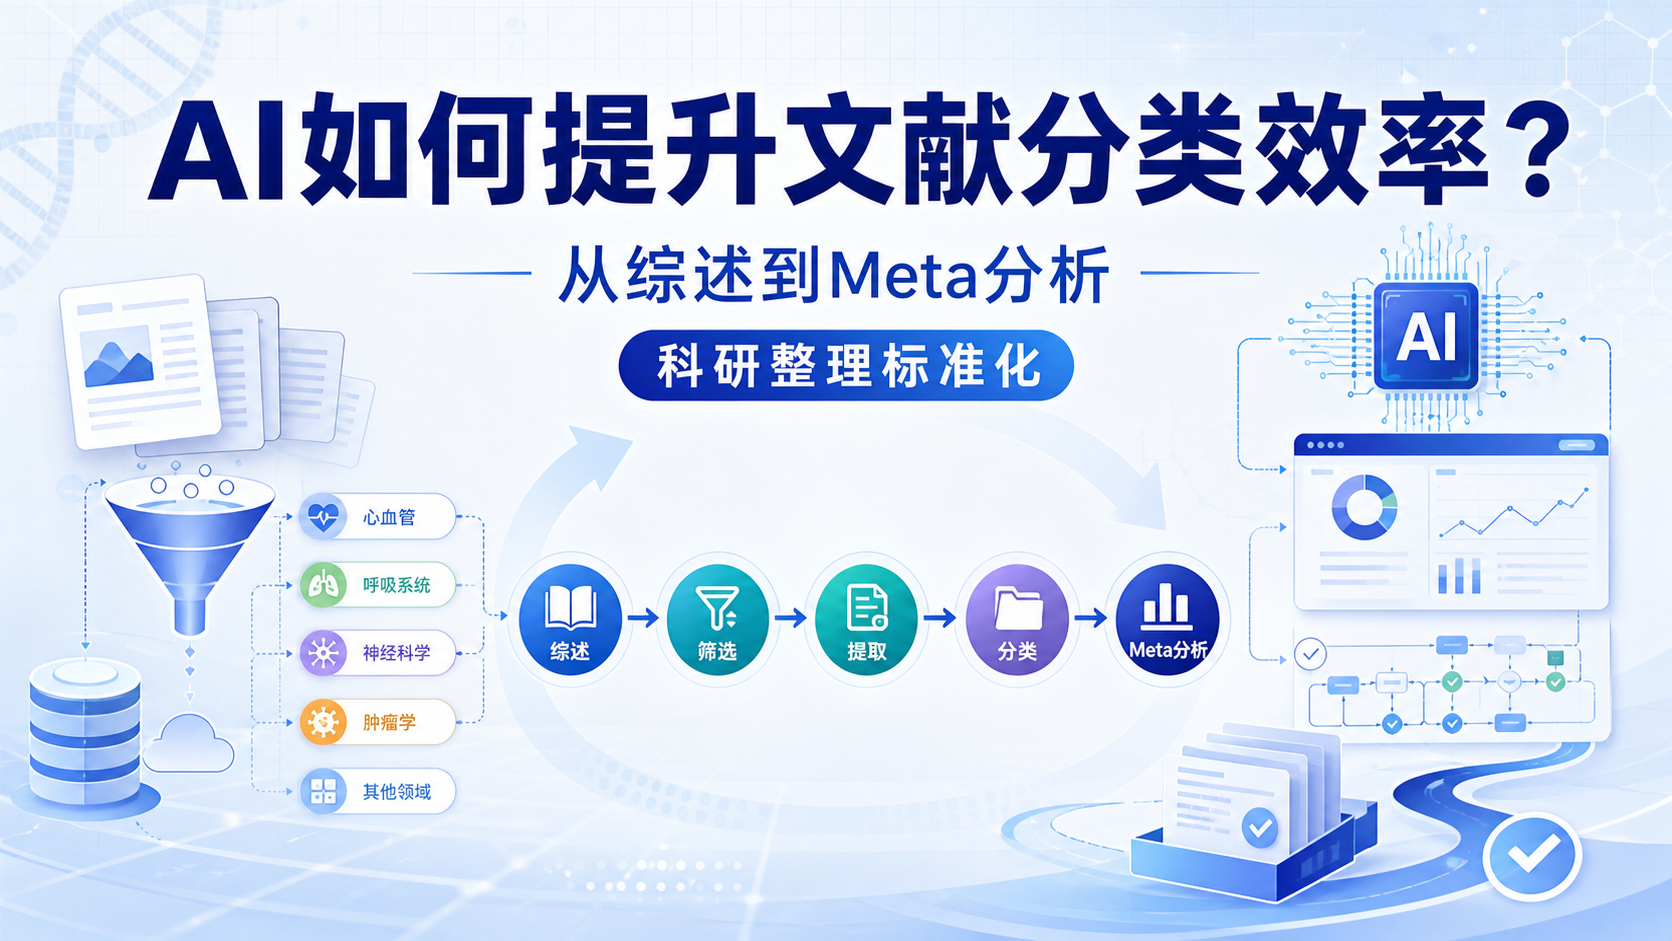
因此,越来越多团队开始尝试AI辅助工具。核心问题不是“AI能不能替代人”,而是AI能否在不破坏方法学严谨性的前提下,减少重复劳动。
2. 工作台能做什么,不能做什么
2.1 选题后可自动生成PICOS、纳排标准和检索式
根据实测类工具逻辑,meta工作台可以在输入选题关键词后,自动生成PICOS框架、纳入排除标准和检索式。对刚起步的人来说,这一步能明显节省方案搭建时间。
但要注意,AI生成内容必须人工校对和修改。 尤其是纳排标准,虽然可以提高效率,但它本身具有主观性,不能照单全收。只要出现明显临床原则错误,后续全部流程都会偏。
2.2 不同数据库的检索式需要分别适配
工作台对不同数据库会生成不同格式的检索式,这是合理的,因为数据库语法本来就不一样。对于做系统评价的人来说,这一点很重要,避免把同一条检索式直接复制到所有平台。
不过,工作台当前纳入的是4个数据库检索结果,暂不支持中国知网、万方等无开放API的中文数据库。 这意味着如果你的课题高度依赖中文文献,仍需要手动补充检索。
2.3 它能辅助流程,但不能替代科研判断
工作台不是“自动出Meta结果”的黑箱。它能帮你减少机械劳动,但不能替代纳排判断、偏倚识别和结果解释。尤其是涉及RCT、非RCT、结局定义不一致等问题时,仍需要研究者自己把关。
作者对结果负责,方法部分也应注明使用了哪些AI工具。 这是当前规范使用AI做科研的基本要求。
3. 实测中最有价值的两个加速点
3.1 初筛提速,前提是检索结果结构清晰
文献一旦很多,初筛就会明显变慢。AI工作台的优势在于可以批量处理标题摘要,先做第一轮过滤,再由研究者复核。这个模式对大样本检索尤其有价值。
但如果检索结果杂乱、重复文献多,或者纳排标准设得太宽,初筛依然会慢。AI提速的前提,是输入质量足够好。 换句话说,前端设计越规范,后端效率越高。
3.2 PDF全文转换后,数据抽取效率提升更明显
工作台支持手动补充文献,也支持上传全文PDF,用于全文复筛和数据提取。上传后,系统需要把PDF转成文本或markdown,再提取数据。这个过程通常比较耗时,尤其是一次性上传文献较多时。
但从效率角度看,AI可以同时处理多篇文章,这是人工难以做到的。真正的价值不在于“完全自动”,而在于批量提取后让人工集中做复核。 这对需要处理大量结局指标的研究尤其实用。
4. 真实使用中的限制与风险点
4.1 文献越多,两个节点越慢
实测逻辑里有两个明显慢点,第一是初筛,如果检索量大,时间会拉长。第二是数据抽取,尤其在上传全文并做格式转换时,耗时更明显。
这说明AI工作台不是无限加速器。它可以把人从重复劳动中解放出来,但不能消除大样本Meta本身的工作量。 如果课题本身文献多、结局多、全文质量参差不齐,效率提升会受限。
4.2 非RCT会被策略性排除,但前提是纳排标准要设置清楚
工作台对非RCT类型研究当前有排除策略。也就是说,如果你的纳入标准只保留RCT,系统会把非RCT排除掉。这个功能对临床试验型Meta比较有用。
但前提是你必须明确研究设计。纳排标准写得不清楚,系统就可能“自动排错”。 这也是为什么AI生成内容只能作为起点,不能作为最终版本。
4.3 人工复核仍然不可省
无论是筛选还是提取,AI都可能出现遗漏、识别错误或结局提取偏差。尤其是PDF格式不统一、表格复杂、图表信息多的时候,错误概率会上升。
因此,规范流程仍应保留:
- 双人独立筛选。
- 双人独立数据提取。
- 冲突由第三人或共识解决。
- 结果保留审计痕迹。
AI提升的是速度,不是替代质量控制。
5. 适合谁用,怎么用才更稳妥
5.1 更适合做系统评价、Meta分析的入门和中级团队
对于刚入门的医学生、规培医生、研究生,AI工作台最大的价值是降低起步门槛。它可以帮助快速搭建PICOS、生成初版纳排和检索式,让团队更快进入正式流程。
对于已有Meta经验的研究者,它更像一个批量处理工具。熟练用户会把它当作“提效器”,而不是“代替器”。 这类定位更符合实际科研场景。
5.2 推荐的使用流程
更稳妥的做法是把AI工作台放进标准流程,而不是替代流程。
可按以下步骤使用:
- 先明确研究问题和PICOS。
- 用工作台生成初版纳排和检索式。
- 人工校对后再正式检索。
- 初筛和精筛仍保留双人复核。
- 上传全文后批量提取数据。
- 对关键结局逐项人工核查。
- 在方法中说明AI参与范围。
这样做的好处是,既保留规范性,也减少重复劳动。效率和可信度可以同时兼顾。
5.3 对中文数据库依赖高的课题要提前规划
如果课题需要覆盖知网、万方等中文数据库,就不能完全依赖当前工作台。因为这类数据库没有开放API,系统暂不支持直接接入。
这类课题更适合“AI辅助 + 手动补充”的混合模式。也就是说,英文数据库走工作台,中文数据库单独补检索,再统一去重和筛选。这样更贴合实际,也更不容易漏文献。
6. 解螺旋能帮你解决什么问题
如果你在做Meta分析,最头疼的往往不是“有没有工具”,而是“工具能不能真正嵌入流程”。解螺旋的价值,就在于把筛选、提取和复核这些高耗时环节,尽量标准化、流程化。 对于需要频繁处理文献、整理结局指标和核对全文的团队来说,这类支持能明显降低试错成本。
更重要的是,使用解螺旋相关工具时,你仍然可以保留科研判断权。AI负责加速,研究者负责把关。这才是适合医学生、医生和科研人员的正确工作方式。
总结Conclusion
Meta分析最耗时的环节,始终是文献筛选和数据提取。AI工作台确实能提效,尤其在PICOS生成、检索式初稿、批量筛选和全文提取方面优势明显。但它不能替代人工校对、双人复核和科研判断。
如果你正在做系统评价或Meta分析,建议把AI当作流程工具,而不是结论机器。需要更稳妥地推进文献筛选、数据提取和流程规范化时,可以结合解螺旋的支持,建立更高效、更可靠的科研工作流。

- 引言Introduction
- 1. 为什么Meta分析最卡在筛选和提取环节
- 2. 工作台能做什么,不能做什么
- 3. 实测中最有价值的两个加速点
- 4. 真实使用中的限制与风险点
- 5. 适合谁用,怎么用才更稳妥
- 6. 解螺旋能帮你解决什么问题
- 总结Conclusion