8
 分享
引言Introduction
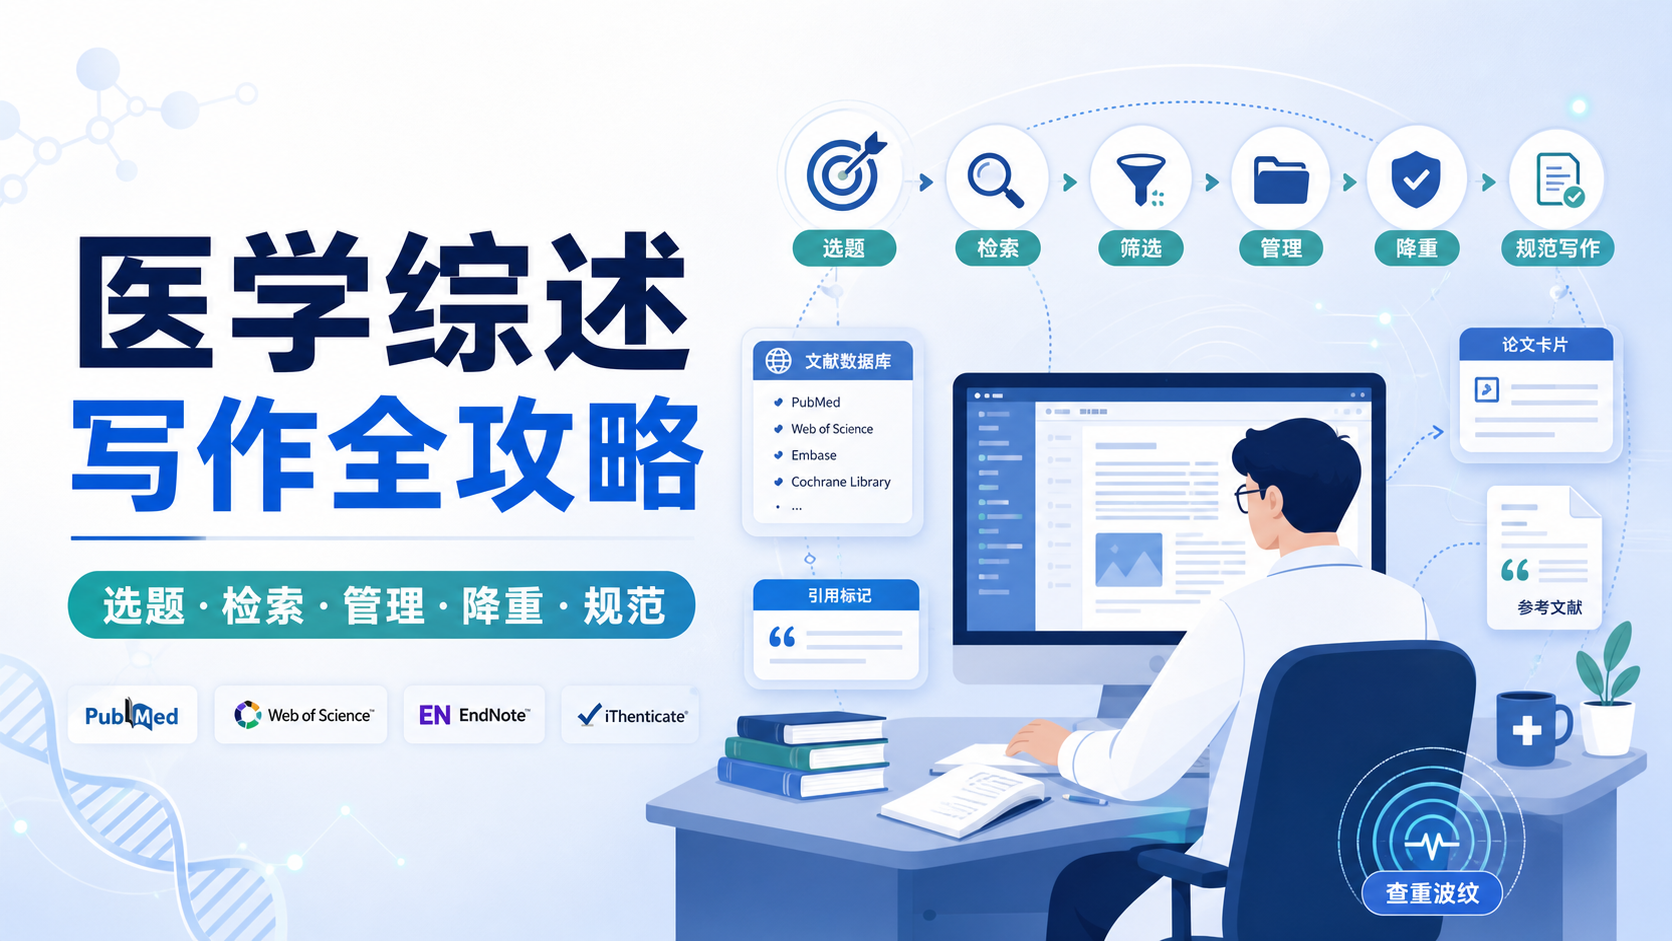
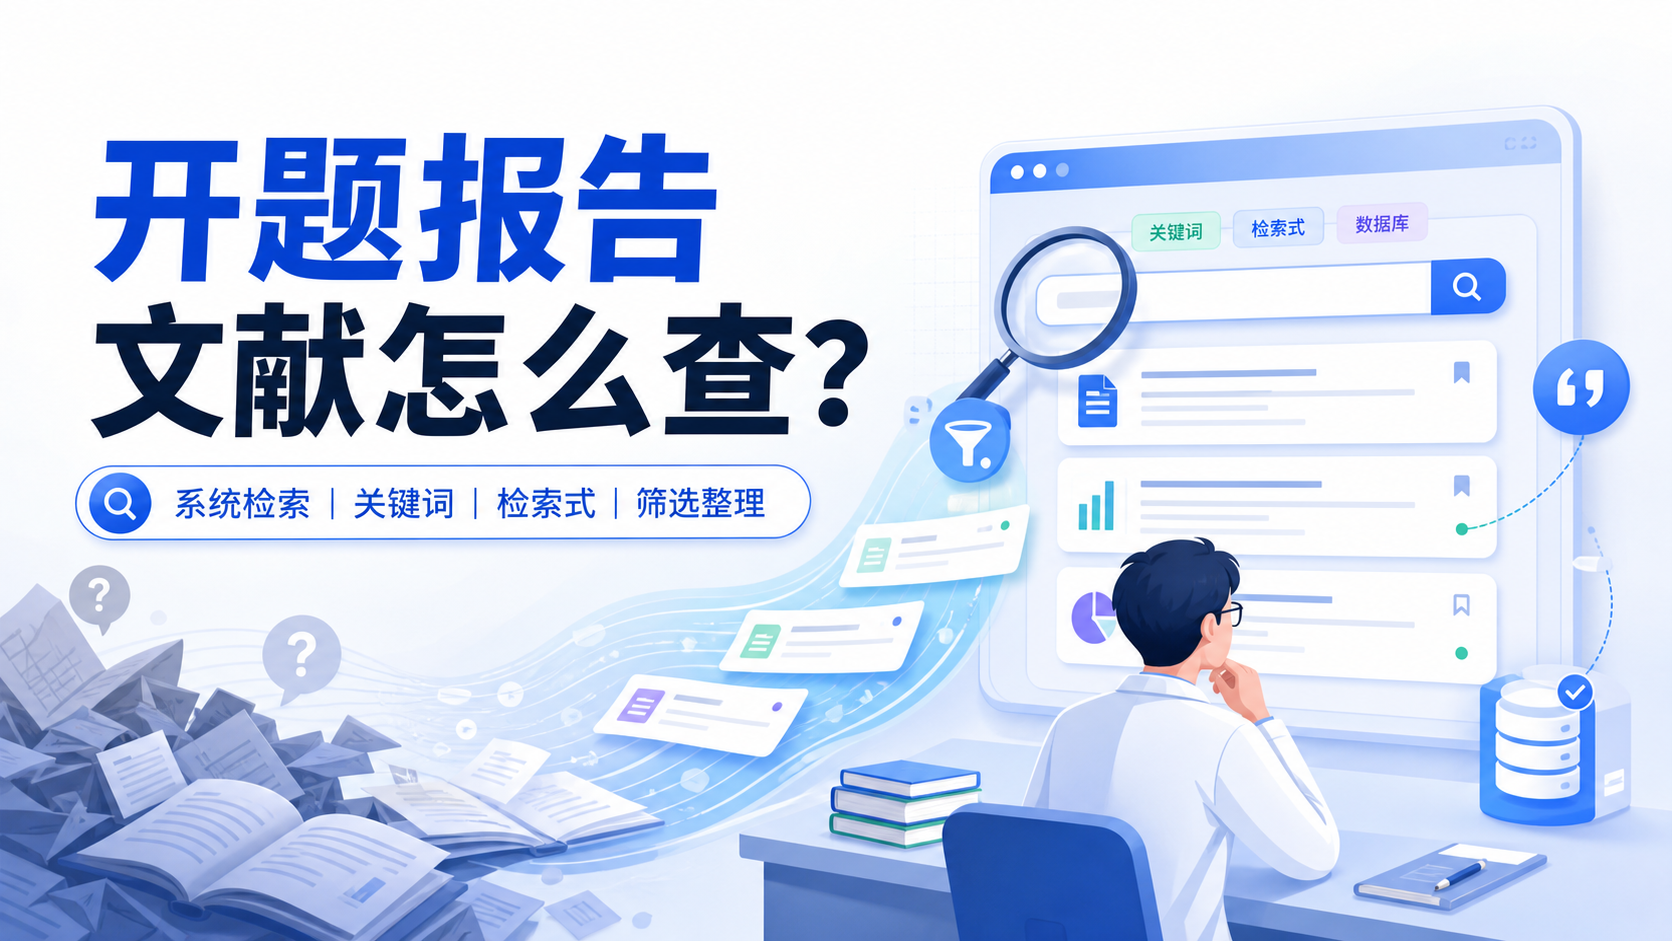
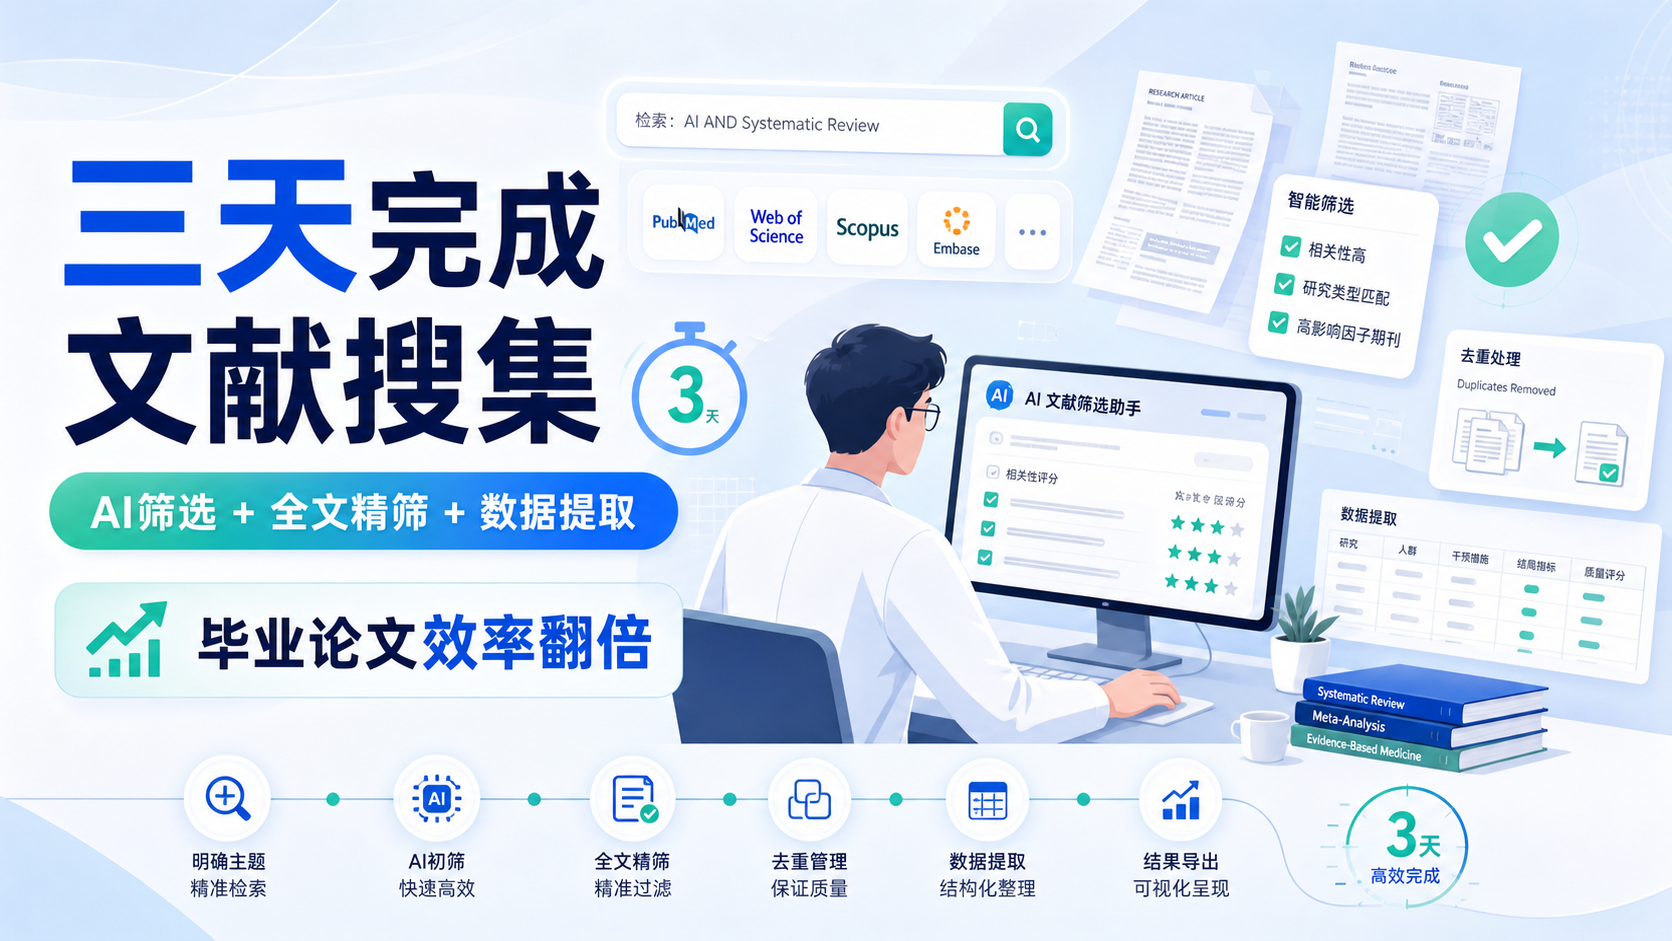
毕业论文最耗时的,往往不是写作,而是文献搜集和筛选。题目一改,成百上千篇文献涌来,标题看不完,摘要分不清,全文更难逐篇核对。如果没有标准化流程,效率会被筛选环节拖垮。 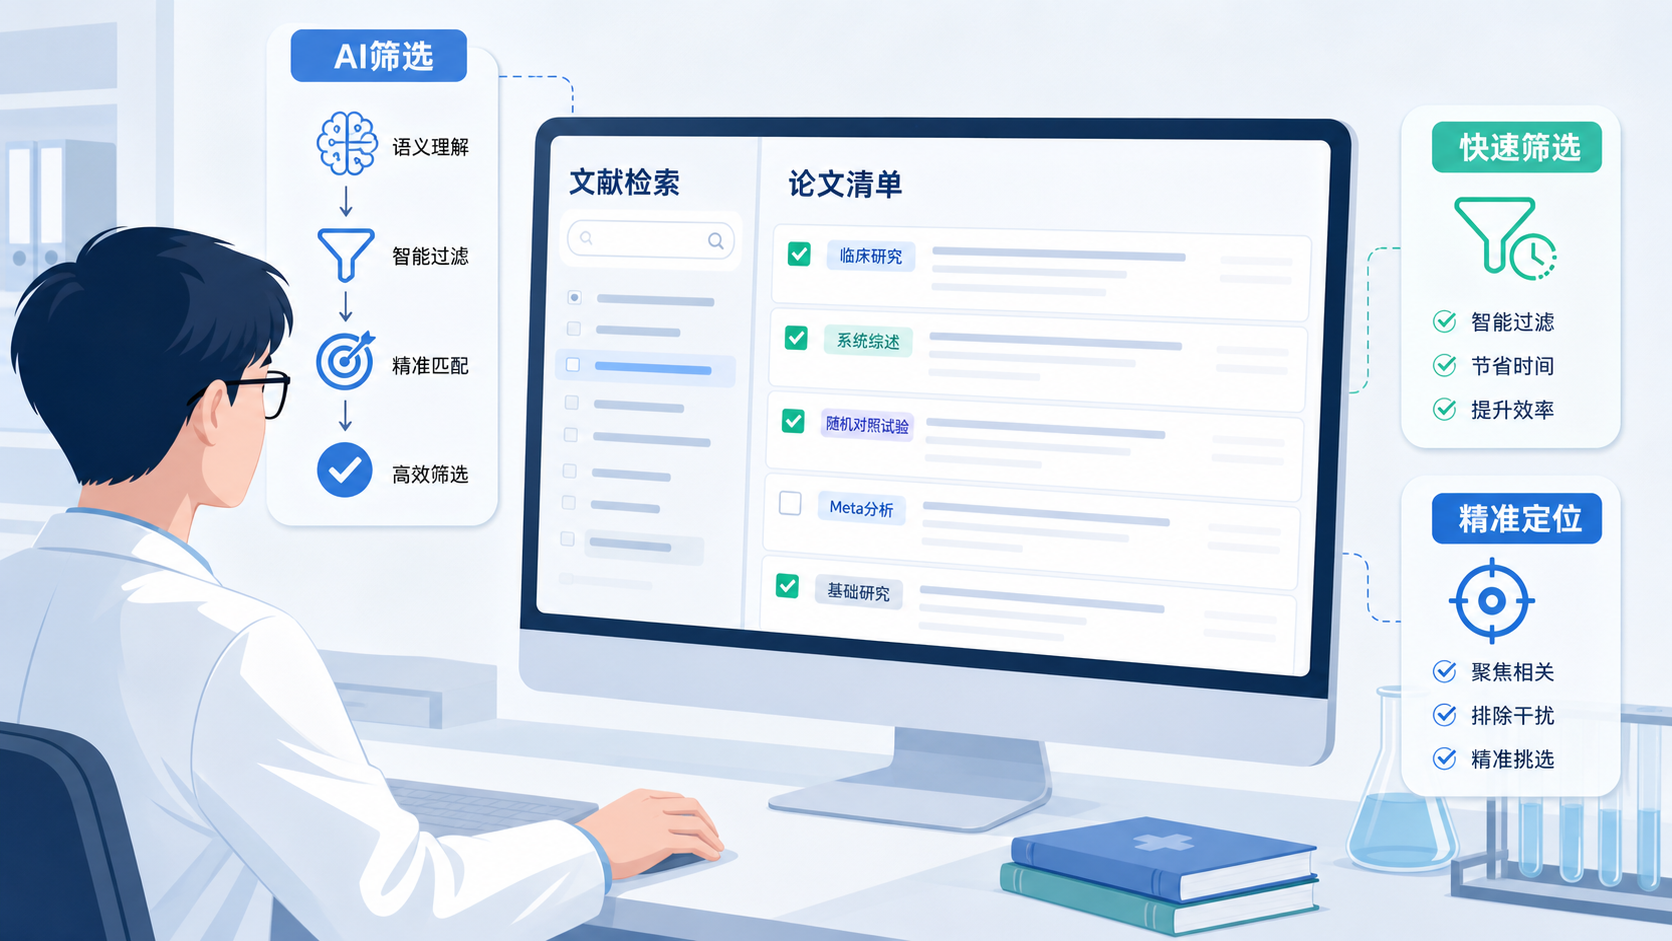
1. 为什么文献搜集总是拖慢毕业论文进度
1.1 文献筛选本身就是最耗时的环节
在系统性综述、Meta分析或高质量毕业论文中,文献筛选不是“看几篇文章”这么简单。通常需要先做初筛,再做精筛。初筛主要看标题和摘要,排除明显不相关研究。精筛则要阅读全文,确认是否符合纳入标准。
这一步之所以慢,是因为它本质上是重复性高、判断要求高的工作。 尤其在医学领域,同一研究问题可能对应不同人群、不同终点、不同设计,任何一项不匹配都可能影响最终纳入。
1.2 经验上,筛选和提取都远比想象中费时
在实际操作中,文献筛选常常比写作更费力。筛选一篇文章,常需要核对研究对象、干预措施、结局指标、随访时间和统计方法。数据提取也同样耗时。比如从全文中提取所有关注的 outcomes,再整理成表格,经验丰富的人也可能需要接近 1 小时处理一篇。
对于医学生、医生和科研人员来说,真正的痛点不是“找不到文献”,而是“找到后无法快速筛净”。 这正是 AI 可以介入的地方。
2. 三天完成文献搜集的核心逻辑
2.1 第一天:先定框架,再搜文献
第一天不要急着下载全文。先把研究问题定义清楚。建议按 PICO 或类似结构拆解。
可先明确以下内容。
- 研究对象是谁。
- 干预或暴露因素是什么。
- 对照组是什么。
- 主要结局是什么。
- 纳入时间范围和研究类型是什么。
框架越清楚,后续 AI 筛选越准确。 否则模型很容易“找得很多,但不对题”。
2.2 第二天:用AI完成初筛和去重
初筛建议从标题和摘要开始。AI的作用不是直接替代判断,而是快速标记“高度相关”“可能相关”“明显排除”。这样可以显著缩短人工浏览时间。
可先让AI根据你的纳入标准,对检索结果做三类判断。
- 纳入。
- 待定。
- 排除,并说明原因。
这种做法的关键,不是让AI直接下结论,而是让它给出可追溯的筛选理由。 这比单纯输出“相关或不相关”更适合科研场景。
2.3 第三天:全文精筛与数据提取
全文精筛阶段,重点不是“快”,而是“准”。AI可以辅助你从全文中定位关键信息,例如样本量、研究设计、结局指标、主要结果和局限性。
但必须注意,全文精筛和数据提取都应保留人工复核。 尤其是纳入与排除冲突、终点定义不一致、统计口径不同的情况,不能只靠机器判断。
3. AI筛选实操流程怎么做
3.1 先建立双人独立筛选思维
无论是否使用AI,规范化的文献筛选都建议双人独立进行。原因很简单,单人筛选容易产生主观偏差。双人独立筛选后,再记录冲突并解决,可以明显提高可信度。
常见流程如下。
- 两位研究者分别独立筛选标题摘要。
- 对纳入和排除结果进行比对。
- 对冲突条目回看全文。
- 必要时由第三方裁决。
- 记录冲突解决流程,便于论文方法部分写作。
AI最适合做的,是把“重复劳动”前置,把人类判断保留在关键节点。
3.2 标题摘要初筛的提示词要具体
提示词越笼统,输出越不稳定。建议直接把纳入标准、排除标准和输出格式写清楚。
可用这样的思路。
- 研究对象。
- 研究设计。
- 结局指标。
- 排除条件。
- 输出格式,例如“保留/排除/待定 + 理由 + 对应字段”。
这样做的好处是,AI不会只给你泛泛的“这篇文章可能有关”,而是能按规则工作。科研场景最需要的是可复核,而不是模糊建议。
3.3 全文精筛时重点核对这些字段
全文精筛时,建议优先关注以下信息。
- 是否真正符合研究对象。
- 研究类型是否匹配。
- 终点指标是否可提取。
- 统计方法是否清晰。
- 数据是否重复发表。
- 是否存在严重偏倚风险。
如果文献中有多个结局,最好将所有关注的 outcomes 单独列成表格。这样后续无论是Meta分析还是结果汇总,都更清晰。
AI的价值在于批量识别和快速整理,但最终纳入决定必须由研究者负责。
4. 数据提取为什么适合AI辅助
4.1 数据提取是典型的高重复劳动
数据提取通常包括作者、年份、样本量、分组、干预、结局和主要结果。每篇文章都要重复做,且经常需要回到原文核对具体数值。
这类工作很适合AI批量处理。尤其在文献数量较多时,AI可以同时处理多篇,快速输出结构化表格草稿。
4.2 AI提取后仍要人工复核
这一点非常关键。AI虽然能提速,但不能替代研究者的学术判断。常见问题包括:
- 结局名称识别错误。
- 数值单位提取不完整。
- 组别对应关系混淆。
- 从图表中提取的数据存在偏差。
因此,最稳妥的方式是“AI先提取,人工再核对”。 这能兼顾速度和准确性。
4.3 最实用的提取策略
建议把数据提取拆成两步。
- 先让AI提取主表字段。
- 再人工逐条核对高风险字段。
高风险字段包括。
- 样本量。
- 主要结局。
- HR、OR、RR、SMD等效应量。
- P值和置信区间。
- 随访时间。
这样处理后,效率通常会明显提升,同时减少低级错误。
5. 三天完成任务的执行清单
5.1 第一天做什么
第一天的目标是定题和建库。
- 明确研究问题。
- 完成检索式。
- 导出文献结果。
- 去重。
- 建立筛选表。
第一天不追求完美,追求的是把工作流搭起来。
5.2 第二天做什么
第二天集中做初筛。
- 标题摘要筛选。
- AI辅助分层标记。
- 双人独立复核。
- 整理冲突条目。
如果文献量很大,优先筛掉明显不相关的文章,把精力留给高价值文献。
5.3 第三天做什么
第三天处理全文和提取。
- 全文下载。
- 按纳入标准复核。
- 提取关键数据。
- 统一格式。
- 生成结果表。
如果流程设计合理,三天完成“从检索到可写作材料”的目标是可行的。 但前提是标准明确,执行规范,复核到位。
6. 使用解螺旋,如何把文献搜集做得更稳
6.1 从“找文献”变成“可管理的科研流程”
很多人卡在文献搜集,不是因为不会检索,而是没有流程。解螺旋的价值,在于帮助你把筛选、提取和整理变成标准化步骤,而不是零散操作。
当工具能辅助你完成批量筛选、结果整理和格式归档时,文献工作就不再是纯体力劳动。
6.2 让AI提效,但保留科研严谨性
解螺旋适合用于文献初筛思路梳理、提取模板建立和写作材料整理。你可以把更多时间放在研究设计、结果解释和论文逻辑上,而不是反复复制粘贴。
对于医学生、医生和科研人员来说,这种提效最有价值的地方是:把原本被筛选消耗掉的时间,重新还给研究本身。
总结Conclusion
毕业论文文献搜集的核心,不是“多看”,而是“高效筛、准确提、规范存”。AI最适合介入的,是标题摘要初筛、全文信息定位和数据提取草稿。 但最终纳入判断、冲突解决和关键数据核对,仍然需要人工把关。按照“第一天建框架,第二天初筛,第三天全文精筛和提取”的节奏,三天完成文献搜集是有现实可行性的。若你希望把这套流程真正落地,可以借助解螺旋,把文献工作做成更标准、更高效的科研流程。

- 引言Introduction
- 1. 为什么文献搜集总是拖慢毕业论文进度
- 2. 三天完成文献搜集的核心逻辑
- 3. AI筛选实操流程怎么做
- 4. 数据提取为什么适合AI辅助
- 5. 三天完成任务的执行清单
- 6. 使用解螺旋,如何把文献搜集做得更稳
- 总结Conclusion