5
 分享
引言Introduction
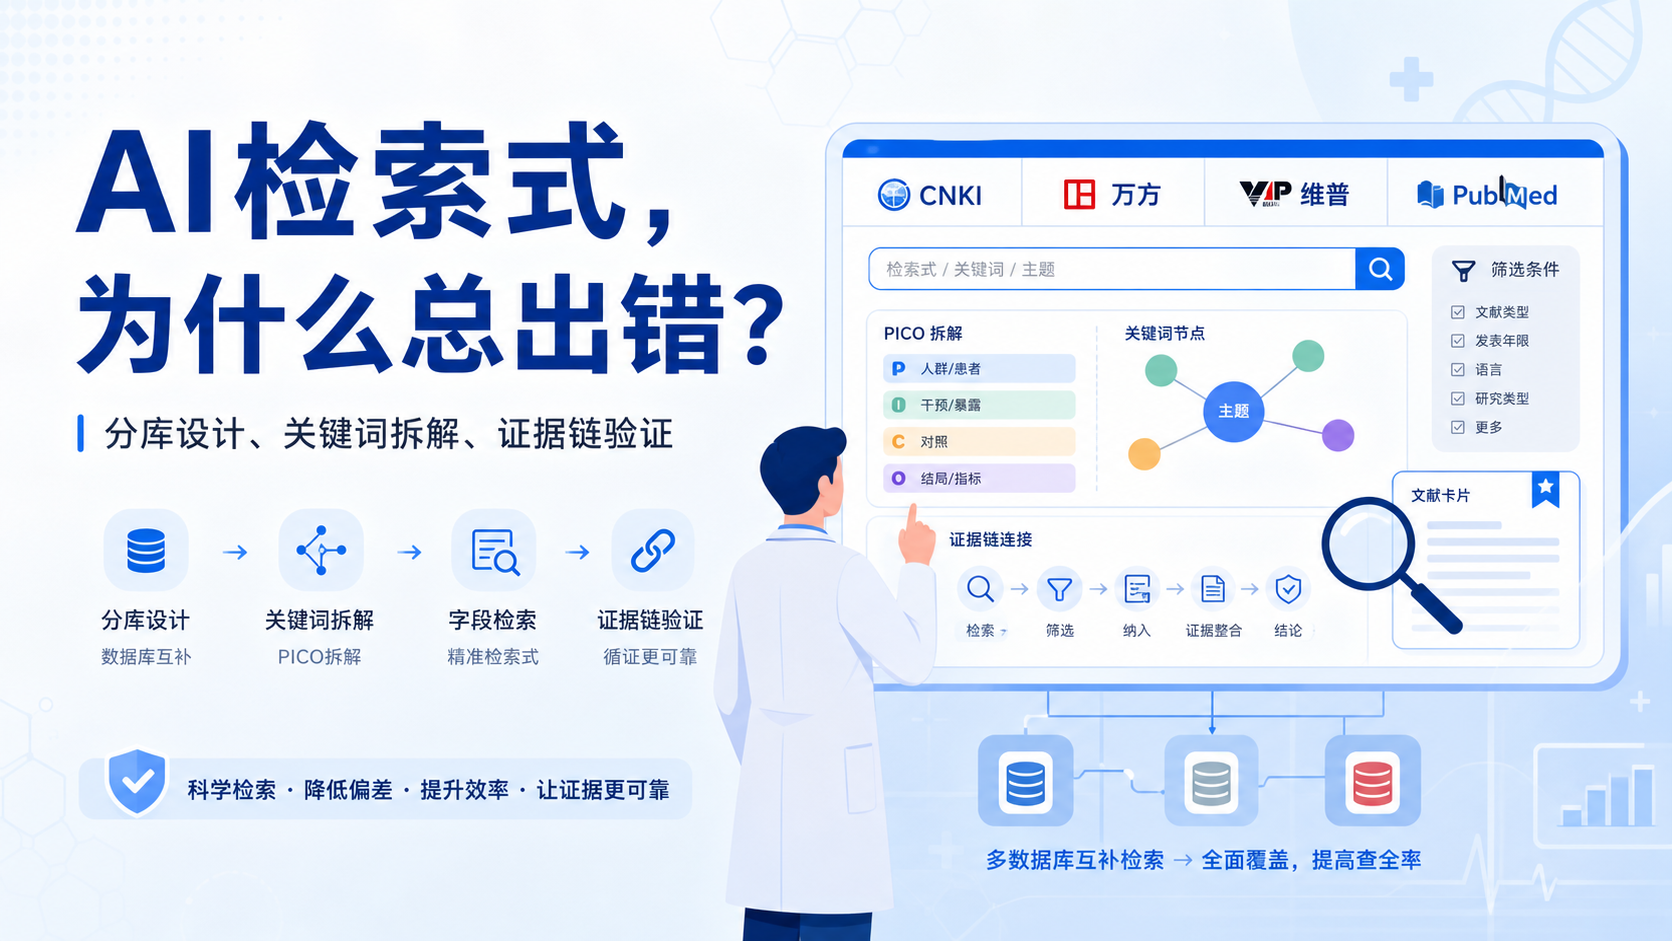
AI可以快速生成检索式,但也最容易漏掉同义词、字段和逻辑优先级。对医学生、医生和科研人员来说,这会直接影响检索结果的完整性,甚至让后续证据链失真。真正可靠的文献检索,必须经过人工校正、数据库适配和逐步收紧。
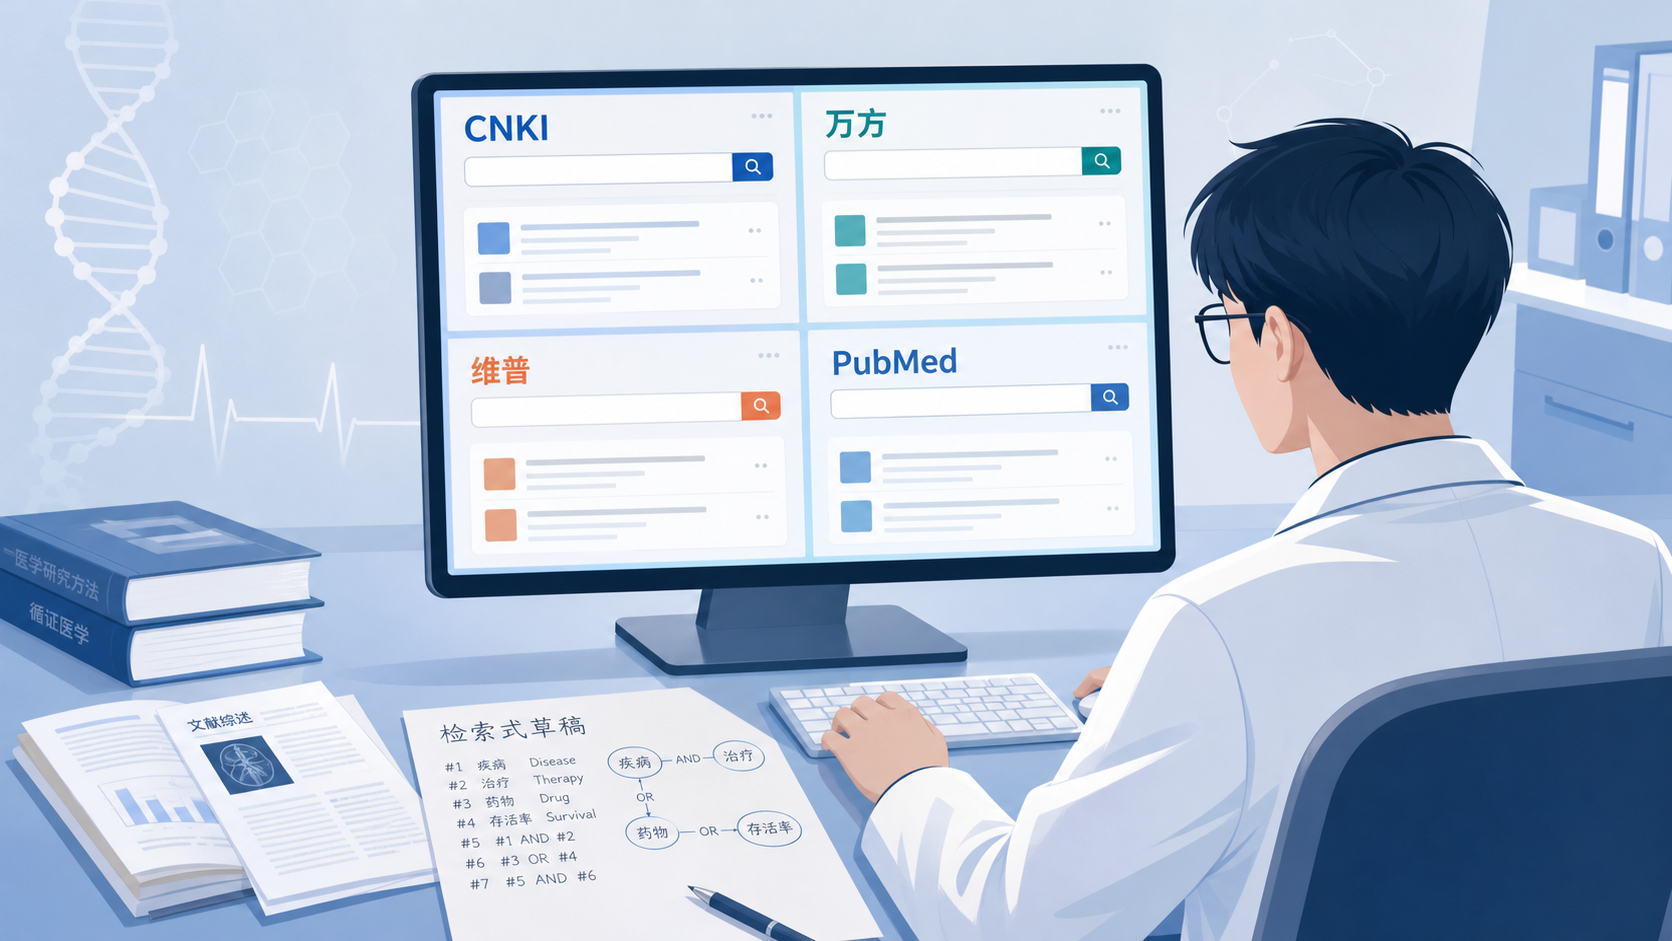
1. 为什么AI生成的检索式容易出错
1.1 同义词覆盖不全,导致漏检
AI生成检索式时,常见问题不是“不会写”,而是“写得太快”。它可能只给出核心词,却忽略专业同义词、缩写和上位词。比如同一个概念,在中文文献里可能同时出现疾病全称、简称、治疗方式和学科术语。只用单一检索词,检索召回率会明显下降。
对于做综述、系统评价或选题的人来说,漏检的代价很大。因为你引用的不是“全部相关证据”,而是“AI猜到的一部分证据”。这会直接影响你对研究现状、研究空白和论点支撑力度的判断。
1.2 逻辑关系和优先级容易写错
检索式里最容易被忽视的是 AND、OR、NOT 以及括号。不同数据库都遵循逻辑优先级,但表达式稍有偏差,结果就会完全不同。比如把“疾病A OR 疾病B AND 治疗C”写成没有括号的形式,实际含义可能被数据库自动解析,导致结果偏向某一端。
检索式不是自然语言,必须按数据库语法精确表达。
AI常见错误包括:
- 把“并且”“或者”混用
- 忽略括号嵌套
- 把排除词写得过宽,误删相关文献
- 把字段检索和自由词检索混在一起
这些问题看似细小,实际上会显著改变检索结果的结构。
2. 多数据库检索为何必须分开设计
2.1 CNKI、万方、维普的语法并不完全相同
中文数据库不能用同一套模板直接复制。CNKI、万方、维普在字段标识、逻辑符号和检索范围上都有差异。同一个研究问题,在不同数据库里要分别调整检索式。
例如:
- CNKI常用字段包括 SU、KY、FT、TI、AB
- 维普常用字段包括 M、K、R、T
- 万方更强调主题字段和层级筛选
如果直接把AI生成的一条检索式原样复制到所有数据库,常见结果有两种。要么检不出来,要么结果太散。两者都会浪费时间。
2.2 中文数据库和外文数据库的检索思路不同
中文数据库更依赖主题词、关键词和摘要字段,适合发现国内研究趋势、临床经验和学位论文。外文数据库则更强调规范术语、MeSH词和结构化摘要。文献如何支撑论点,首先取决于你是否在正确的数据库中找到了足够完整的证据。
如果你的论点要体现国内临床实践、真实世界研究或中医药证据,中文数据库尤其重要。CNKI、万方、维普互补性很强,不能只依赖其中一个。
如果你的目标是系统评价、RCT证据或国际共识,外文数据库必须同步纳入。否则证据链会偏窄。
2.3 不同数据库负责不同层面的证据
多数据库检索不是重复劳动,而是分工。建议这样理解:
- CNKI适合看研究热点、学位论文和综合性中文证据。
- 万方对中华医学会等医学期刊覆盖更完整。
- 维普在核心期刊覆盖和学科广度上有优势。
当你要验证一个论点是否站得住时,不能只看单一数据库的“高相关结果”,而要看多库交叉后是否仍然成立。这样得到的论点更稳,也更容易在论文答辩、基金申请和投稿中经得起追问。
3. 一个可执行的检索式设计流程
3.1 先从PICO或研究问题拆分关键词
设计检索式前,先把问题拆成可检索的核心概念。通常至少包括:
- 研究对象
- 干预或暴露
- 对照
- 结局
如果不是干预研究,也可以改成疾病、机制、检测指标、方法学四类词。检索式的质量,取决于你对研究问题的拆解是否准确。
建议先列出每个概念的:
- 中文全称
- 常用简称
- 英文缩写
- 近义词
- 学科术语
这一步决定了后面的召回率。不要急着写复杂表达式,先把词表做完整。
3.2 先聚焦,再放开
很多人一开始就把检索式写得很宽,结果出现成千上万条记录。正确做法是先聚焦,再逐步放宽。先用较精确的词组定位,再逐步加入同义词和上位词。
推荐顺序:
- 先用最核心的2到3个概念组合
- 检查前几十条结果是否相关
- 再补充同义词、缩写、变体词
- 最后根据结果量决定是否扩大年份、文献类型或字段范围
这样可以减少无效噪音,也更便于人工筛查。
3.3 利用字段检索提高准确性
字段检索能显著提升效率。不同字段的作用不同:
- 题名TI或T:更精准,适合限定主题
- 关键词KY或K:适合抓取作者标注的核心概念
- 摘要AB或R:适合补充漏收文献
- 主题SU或M:适合平衡召回率和准确率
如果研究问题明确,优先使用题名和关键词。
如果题目较宽泛,先用主题或摘要,再逐步收紧。
字段选择本身就是证据质量控制的一部分。
4. 如何验证检索式是否真的能支撑论点
4.1 看结果是否覆盖核心文献
检索式设计完,不是看“检出多少篇”,而是看“是否找到了该找的文献”。建议先选出3到5篇已知高质量文献,作为种子文献测试检索式。
如果这些文献检不出来,说明检索式有问题。常见原因包括:
- 关键词不完整
- 字段设置过窄
- 同义词没有覆盖
- 逻辑关系写反
一个能支撑论点的检索式,必须先通过核心文献回收测试。
4.2 看结果是否形成证据链
文献不是越多越好,而是要能串成链。你最终要回答的是“文献如何支撑论点”。这意味着结果至少要覆盖以下层次:
- 机制研究,解释为什么会发生
- 临床研究,说明是否真实存在
- 比较研究,说明与其他方案相比如何
- 系统评价或Meta分析,说明总体证据水平
如果检索式只能找到零散病例报告,却找不到更高层级证据,就说明检索策略还不够完整。反过来,若能同时找到基础、临床和综述文献,论点的说服力会更强。
4.3 看数据库间结果是否互补
同一主题在不同数据库中,往往会出现不同的高频关键词、不同的作者群和不同的期刊分布。这个差异本身就是信息。
建议你比较:
- 各库检出的总量
- 重复文献比例
- 高被引文献是否一致
- 主题分布是否偏向某一方向
如果多个数据库都支持同一结论,论点的稳健性会明显提高。
如果只有某一个数据库里有结果,就要警惕证据偏倚。
5. 常见陷阱与修正方法
5.1 陷阱一,过度依赖AI的默认表达
AI经常会给出看似完整、实际上过于通用的检索式。问题是,它不知道你的研究目标是综述、临床问题还是机制研究。
修正方法很简单:
- 明确研究类型
- 明确纳入文献类型
- 明确时间范围
- 明确是否需要中文或英文文献
不要把AI当成最终答案,而要把它当作初稿。
5.2 陷阱二,忽略数据库特色
有些研究者会在一个数据库里调通后,直接复制到另一个数据库。这样做通常会失败。因为每个数据库的字段和语法不同,检索习惯也不同。
修正方法是按数据库单独优化,并保留一份标准化检索记录。建议记录:
- 检索日期
- 数据库名称
- 检索式原文
- 限定条件
- 命中数量
这一步不仅利于复现,也符合论文写作的规范要求。
5.3 陷阱三,只看数量,不看相关性
检索结果上千条,不代表策略好。真正有效的策略,是让前20到50条结果中有较高比例的相关文献。
如果前几页充满无关内容,说明:
- 概念太宽
- 逻辑词设置不合理
- 字段选得不对
- 排除词使用过度
检索策略的目标不是“搜得最多”,而是“搜得准、搜得全、可复现”。
5.4 陷阱四,文献没有形成论证结构
很多人下载了大量文献,却不知道怎么用来支撑论点。建议按“问题—证据—结论”整理:
- 你的论点是什么
- 哪类文献支持它
- 证据强度如何
- 是否存在相反证据
- 结论应当如何表述
这样写出来的综述、开题和论文讨论部分,才是有证据基础的,而不是堆砌引用。
总结Conclusion
AI可以提高效率,但不能替代检索设计。多数据库检索式设计的核心,不是生成一条漂亮的公式,而是确保文献能够真实、完整、可复现地支撑论点。 你需要做的,是拆分问题、适配数据库、验证核心文献、逐步放开检索范围,并持续人工修正。
如果你想更高效地完成中文与外文文献检索、整理证据链、验证“文献如何支撑论点”,可以借助解螺旋的专业工具和方法支持,减少漏检和误检,把时间更多用在研究本身。

- 引言Introduction
- 1. 为什么AI生成的检索式容易出错
- 2. 多数据库检索为何必须分开设计
- 3. 一个可执行的检索式设计流程
- 4. 如何验证检索式是否真的能支撑论点
- 5. 常见陷阱与修正方法
- 总结Conclusion